TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

自述 15 歲的開發者 Negix 公開 Windows 與 Linux 變聲器 Koeiro,以 MeanVC2 與 LavaSR 在本機做即時聲音轉換,標榜 Intel N150 等無 GPU 環境也能執行。「近零 token 費」指的是開發階段靠免費 AI 服務寫程式,軟體本身仍要自建 8GB 環境、模型另行下載,使用前要分清楚這兩筆帳。
用 AI 摘要這篇文章:
2026 年 10 月 12 日晚間,一位在 X 上自述「15 歲、正在做軟體開發」的日本開發者 Negix 公開了 Windows 與 Linux 變聲器 Koeiro,推文開場寫著「AI 的 token 費幾乎 0 日圓做出來的」。這則推文到次日已累積一千九百多個讚,故事也開始在網路上流傳。不過「近零成本」說的是開發階段用的免費 AI 服務,跟軟體下載後能不能跑、跑得順不順,是三筆不同的帳。拆開來看,這個專案真正該記住的部分有兩個:上游研究模型已經把即時變聲的算力需求壓到單一 CPU 核心就能負荷,而免費的 AI 寫程式額度讓一個學生開發者把它包成了有安裝包、有文件、有版本線的桌面軟體。
事件本體發生在 2026 年 10 月 12 日 13 時 22 分(UTC,台北時間同日 21 時 22 分)。Negix 在主推文自我介紹「15 歲、正在做軟體開發」,說明 Koeiro 可以把麥克風輸入即時轉換成事先登錄的聲音,並附上 27 秒示範影片。他的 GitHub 個人檔也自述自己是「正在學 AI 的國三生」,開發方向是「沒有 GPU 也能動的本機 AI 軟體」。這兩個身分描述都出自作者本人,目前沒有第三方核實的管道。
推文串接下來的三則回覆把重點講完:軟體放在 GitHub 的 heynegix/koeiro;傳統 AI 變聲器幾乎都需要 GPU 環境,Koeiro 用很輕量的本機模型,在 Intel N150 這種低功耗處理器上也能跑出自然的聲音,而且作者承諾今後會繼續以自己手上的 N150 機器為前提開發;最後一則澄清成本,「幾乎 0 日圓」主要來自 Qodar 的免費推廣活動和 Freebuff 這個服務,之所以說「幾乎」、不說「完全」,是因為開發最最初期用過 Codex。
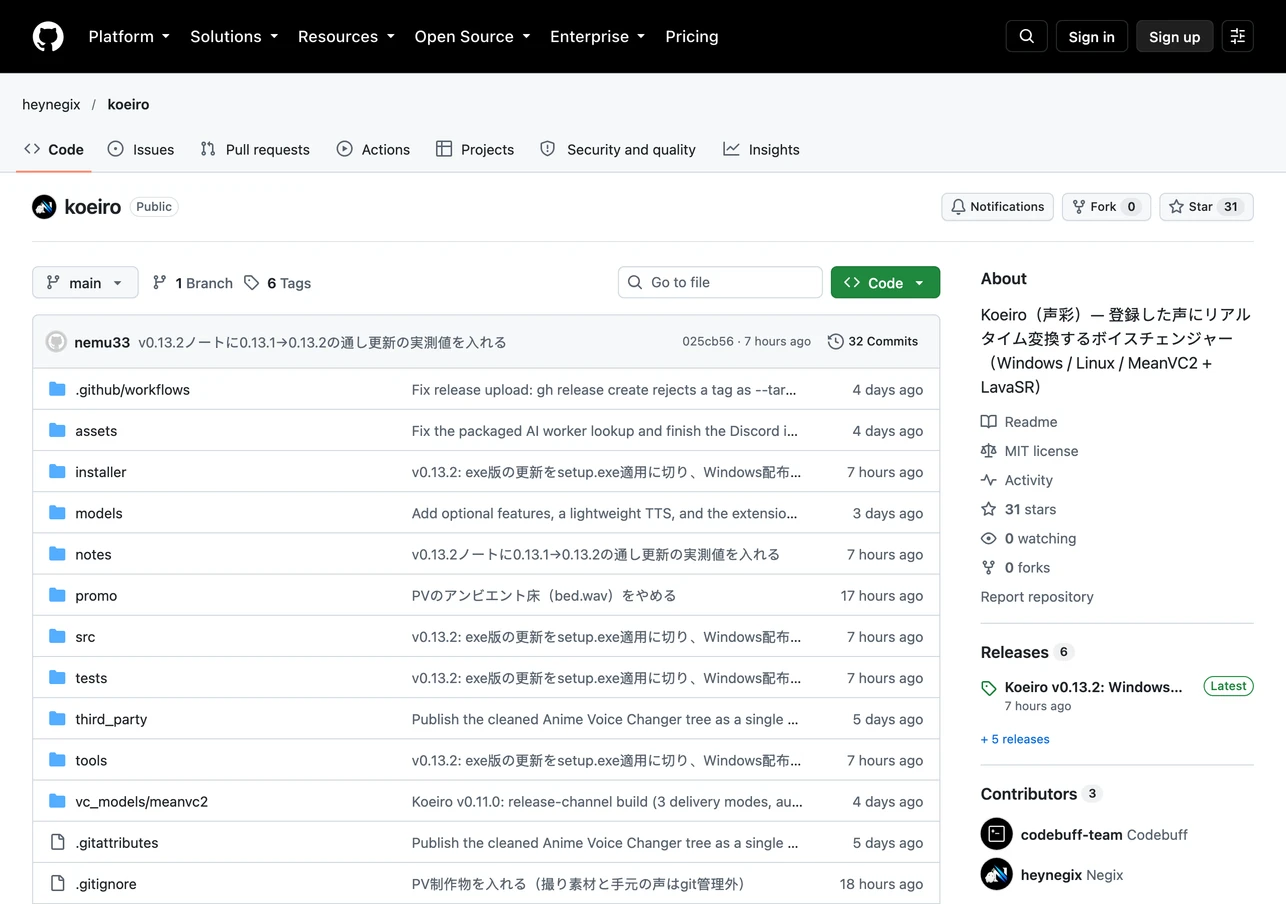
倉庫本身的時間軸也對得上這則故事的節奏。GitHub 帳號建立於 2026 年 7 月 10 日,專案倉庫 10 月 8 日建立,之後五天內連發六個版本:10 月 9 日兩個、10 月 11 日一個、10 月 12 日當天三個,其中 v0.13.1 在發布推文前六分鐘剛上架,當天深夜(UTC,台北時間已是 13 日上午)再補上 v0.13.2 的 Windows 安裝器。到 10 月 13 日為止,倉庫有 31 個星標。示範影片的片尾字幕顯示的仍是 v0.12.0,也就是說影片是在發布當天更早的版本上錄的。
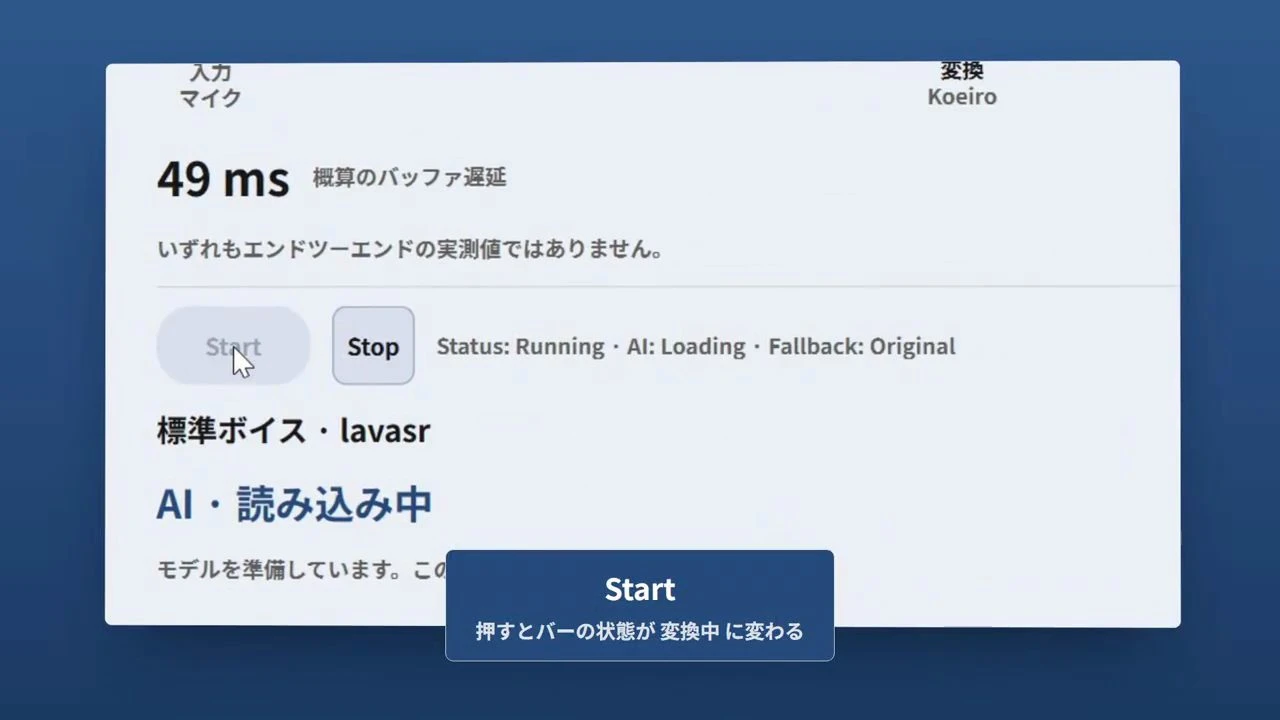
示範影片拍的是軟體介面本身。開場字幕卡寫著「把自己的聲音即時轉換成登錄的聲音」,接著鏡頭帶過主畫面:麥克風、轉換、輸出三個節點串成的流程圖,旁邊標著概算的緩衝延遲數字;右側是聲音清單與預設聲音卡,狀態列顯示 AI 模型載入中、以及載入完成前暫時走原聲的備援狀態。影片從頭到尾沒有出現任何測試圖表或量測畫面,變聲的實際聽感只能靠自己的耳朵驗收,這是評價這類作品時要先放在心上的前提。
要讀懂成本宣稱,得回到作者自己的說法。在發布推文的同一天稍早,Negix 先發過一則列出手上免費 AI 服務的推文:Freebuff 的模式是畫面常駐廣告,換取免費用 DeepSeek、GLM 等新一代低價模型寫程式,以 DeepSeek v4.1 flash 來說一天有 2 到 3 小時的免費額度。換句話說,「近零」的內容是:主要開發期靠免費推廣活動與廣告支援的服務,最早期用過一小段 Codex。
這筆帳的意義有兩個層面。它描述的是開發工具的使用成本,而不是軟體的執行成本:Koeiro 的變聲流程在本機跑模型,本來就不按對話 token 計費,把開發帳的「近零」延伸成「用這套軟體變聲零成本所以效果說了算」,兩頭都是誤讀。另外,免費額度有時效與資格條件,這是作者當下碰得到的活動,並非隨時可重現的價格承諾;想跟著做的人,該把自己會用到的付費期間與免費額度一起算進成本。
但這筆開發帳仍然是故事裡真正新的東西。語音轉換模型開源已久,缺的是把它們接成有人用的桌面軟體的那一層工程:圖形介面、音訊接線、安裝流程、版本管理。當 AI 寫程式工具的免費額度把這層工程的成本壓到接近零,個人開發者能端出來的就從「一段 Python 腳本」變成「有安裝包、有更新機制的產品」。Koeiro 的 README 甚至內建了一段給 Claude Code 或 Codex 用的自動設定提示詞,貼上就能讓代理指令碼把環境建好,開發靠 AI、安裝也靠 AI,這個迴圈本身就說明了門檻降到哪裡。
「Intel N150 也能跑」聽起來像行銷話術,但往上追一層會發現它有技術依據。Koeiro 的核心是 ASLP-lab 實驗室開源的 MeanVC2 串流語音轉換模型(論文編號 arXiv 2606.09050):它的設計目標正是低延遲串流與 zero-shot 轉換,官方數字是 40 毫秒切割粒度下端到端首包延遲 110 毫秒,完整流程在單一 CPU 核心上的實時間率(RTF)低於 0.633,也就是說不需要獨立顯示卡就能追上說話速度。Koeiro 再接上 LavaSR 做高頻復元,把轉換過程中漏掉的高頻段補回來,再由 Vocos 神經聲碼器還原成音訊,這一步決定了批次高音質模式的聽感。把語音轉換留在本機的變聲器並不少見,Supertone Shift 就是點數制的商用例子,Koeiro 走的則是開源加無顯示卡的路線。
Koeiro 提供三種 AI 轉換模式讓使用者在延遲與品質之間選擇:逐次串流模式邊說邊轉,適合通話與遊戲;高音質批次模式用約 0.8 秒靜音切分語句,整句轉完再復原高頻,單段上限 60 秒;最速批次把判定等待壓到約 0.6 秒;另外保留了完全不經 AI 的原聲直通與 DSP 音高共振調整兩種模式。有 NVIDIA 顯示卡時可以切到 CUDA 加速,沒有就自動退回 CPU,軟體還刻意關閉 TF32 以維持輸出的可重現性。
軟體周邊的功能也是照著直播與通話場景設計的。Discord 的狀態欄可以顯示「正在用 Koeiro 變聲」與目前選用的聲音名稱;常用的麥克風、聲音與加工組合能存成設定檔一鍵切換;快捷鍵直接換轉換模式,或在原聲與 AI 變聲之間來回切;測試版還加入喊出喚醒詞「コエイロ」(Koeiro 的日文讀音)就能下指令的語音操作,背後跑的是本機日語辨識,不用把聲音送到雲端。
說話方式的微調也做成了一套開關。抑揚預設提供 Calm、Gentle、Energetic、Sad 與動畫風格等選項,在原本的語氣上疊加修正,預設停留在 Anime Light;光譜式降噪標明實驗性、預設關閉,用來壓風扇與電流底噪;音量自動均一化把小聲說話抬到轉換模型抓得住的音量,但靜音段不跟著放大;輸出端有最多 3dB 的收尾處理壓掉拼接噪聲與刺耳氣音;AI 輸出的共振調整只動共振、不動音高,代價是低延遲設定下再多約 43 毫秒。這些預設幾乎全數關閉,要什麼自己開,作者把「每一步加工都有代價」直接寫進了介面。
介面本身的紀律也值得記一筆。常設畫面只留一個「舞台」:輸入音量、三節點接線、延遲數字、Start 鍵,以及 AI 狀態與目前聲音名的大字顯示;所有設定收進右上角的「調整」抽屜,追加功能收進「實驗」抽屜,抽屜打開也不會蓋住舞台,聲音清單常駐右側、一鍵收合,抽屜裡還附搜尋與分類目錄。第一次啟動有聚光燈式導覽,只把當下要操作的部位打亮。對一個五天擠出六個版本的個人專案來說,這些取捨顯示作者想得很清楚:直播進行中最重要的資訊,永遠不能被設定面板蓋掉。
不過「N150 跑得順」的範圍是主流程,作者自己畫出了邊界。README 對可選的文字轉語音功能(Kokoro-82M,先前介紹過的 Kokoro TTS 是同一個模型家族)附了一組 N150 實測:載入約 6 秒,合成 2.4 秒的音訊要花約 23 秒,實時間率約 10,官方自註「低階硬體上不保證實用速度」;這個模型採 int8 量化後約 110MB、只支援英語語音,挑它圖的是輕,擋不住慢。實驗室裡的東西更前衛:延遲治理器會實測現況後「建議」品質調整,套不套用隨使用者;耳語模式自動偵測氣音說話並補上週期成分;分散推論把合成與翻譯丟給區域網路上有 GPU 的機器;多說話者自動分流按音高與亮度把同一段音訊裡的人聲分開,還附自我識別測試。全部預設關閉、不影響主轉換。同一份文件也把即時口譯語音標為實驗功能,目前只有辨識加英語朗讀的骨架,翻譯模型還沒實作、需要使用者自備。這些自我標註是判斷專案成熟度最可靠的線索:功能表列得長,不等於每一項都到位。
還有一個小細節可以看出作者的誠實程度:示範影片與軟體介面上顯示的延遲數字,都標註為「概算的緩衝延遲」,並明寫這些都不是端到端的實測值。從麥克風到對方耳機的實際等待,還要加上輸入緩衝、語句判定與輸出裝置的時間,UI 上的毫秒數只是其中一段。
實際要跑起來,需求是這樣的:Windows 10/11 或 Linux(建議 Ubuntu 22.04 以上)、Python 3.12、約 8GB 的磁碟空間給環境與模型,另外要裝 FFmpeg、git 與 uv。發布包裡放的是原始碼樹與安裝器,推論環境加模型合計約 8GB,遠超過 GitHub 單一附件 2GB 的上限,因此不隨附,初次設定要跑一次 setup_release.py 把模型抓下來、建好兩套虛擬環境(圖形介面與 AI 推論各自獨立)。這種把介面與推論拆成兩個程序的設計,用意是讓畫面操作不因為模型忙碌而卡住,低階硬體上尤其有感。要把聲音送進 Discord 或 OBS,還需要 VB-CABLE 這類虛擬音訊裝置把輸出接給通話軟體。整體是「願意照文件逐步做就會通」的等級,跟下載一支可攜軟體雙擊就跑,仍有一段距離。
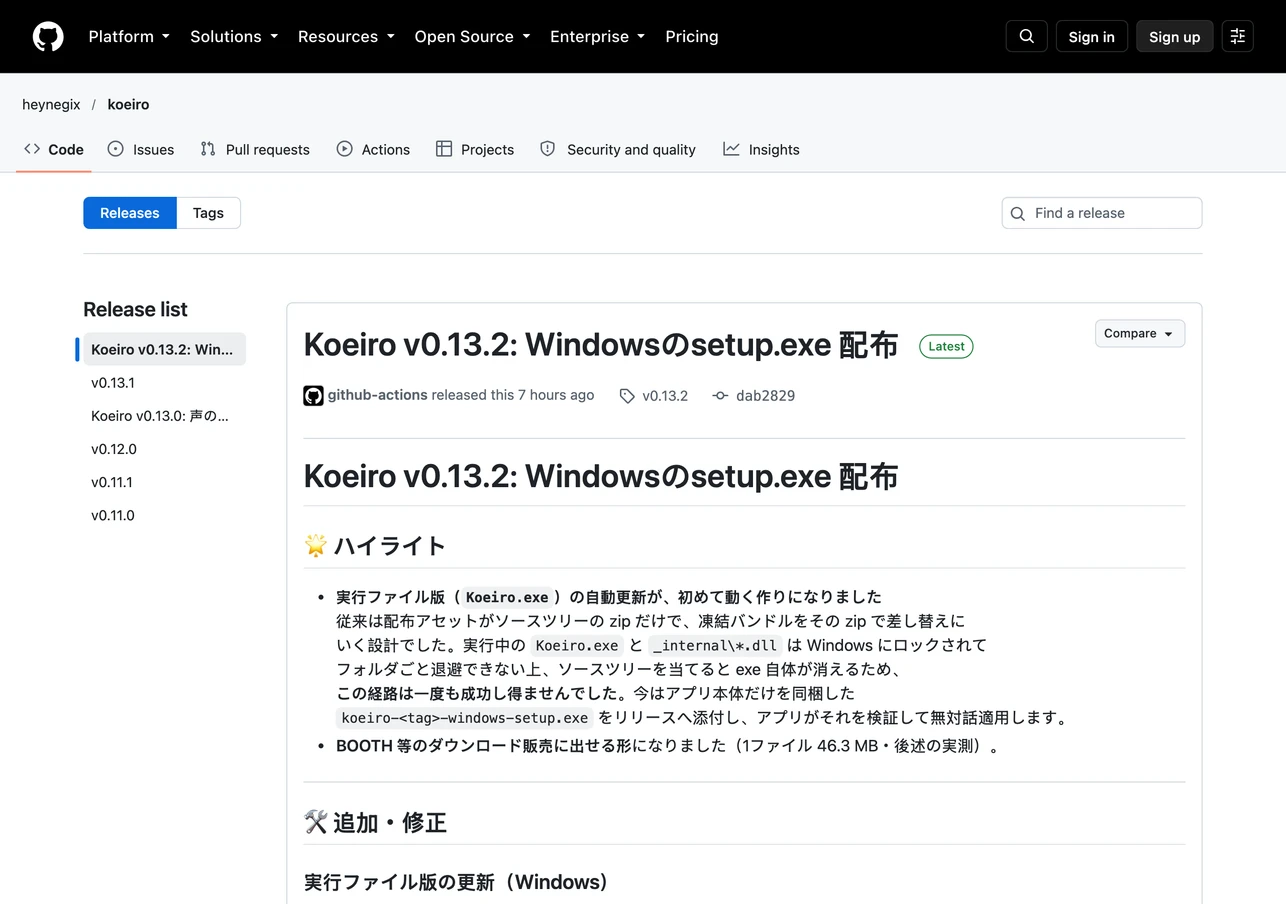
發布與更新的工程細節同樣有值得看的地方。Windows 執行檔版的更新走安裝器重刷:應用程式從 GitHub Releases 同時抓新版安裝器與對應的雜湊檔,SHA-256 驗過才免對話自動換版,缺檔或驗不過就停在原地,作者在文件裡把理由寫得很直白,不讓無法驗證的執行檔被靜默執行。這套機制其實是發布當天深夜的 v0.13.2 才第一次真正動起來:作者在該版說明自曝,先前用原始碼樹直接差替的更新路徑,在 Windows 鎖定執行中檔案的機制下從來不可能成功。安裝位置放在使用者目錄、不進 Program Files,為的就是免除每次更新都要跳出的管理員同意;模型與虛擬環境跨版本沿用,換版不必重抓那 8GB。同一版的重點還有把 Windows 版包成單一 46.3MB 的安裝器,形態上可以放上 BOOTH 這類日本下載銷售通路;但依發布文件的規劃,市集單檔上限 1.2GB,實測 torch 環境 2.2GB、MeanVC2 檢查點就超過 1.8GB,所以在獨立的 AI 包做出來之前,走市集的安裝器只能跑原聲直通與 DSP 兩種非 AI 模式。開源本體免費、市集通路反而功能殘缺,這個落差本身就是「AI 環境不隨附」最具體的註腳。
登錄聲音需要幾十秒到幾分鐘的參考音檔,這也是動手前最該想清楚的一步:登錄的素材最好是自己本人的聲音,或取得當事人同意的材料;拿別人的聲音去登錄,效果再好也是建立在別人的聲音權利上,直播或商業使用時的風險都在使用者這邊。
授權結構倒是乾淨。Koeiro 本體採 MIT,上游的 MeanVC2 與 LavaSR 都是 Apache-2.0,可選的 Kokoro-82M 語音合成模型也是 Apache 系授權,作者在發布文件裡逐項清點了要履行的事:研究用模型(約 70GB)不進發布包、帶非商業條款的 encodec 元件因為授權不相容直接排除、Qt 的 LGPL 義務以附文件處理。唯一的小瑕疵是 README 對 LavaSR 的致謝連結指向一個不存在的 GitHub 帳號,實際上游是 ysharma3501/LavaSR(六百多星、Apache-2.0 授權),照著致謝連結點過去會得到 404,找模型來源時要以實際倉庫為準。
整則故事可以分成兩層來看。能核對的層:倉庫與版本線、README 的需求與自我標註、上游模型的論文與授權、發布推文的逐字內容,這些都有公開文件可查,而且彼此對得上。只能信作者的層:15 歲與國三生的身分、N150 上主流程的流暢度、示範影片中的變聲效果,都是單方陳述,沒有第三方實測或身分查證可佐證。此外還有兩個會隨時間變動的變數:免費 AI 服務的額度條件隨時可能調整,而專案倉庫 10 月 13 日時才 31 個星標,後續維護節奏要看接下來幾週的更新頻率,這兩點也是觀察專案走向的指標。
想動手試的人,條件很清楚:有 Windows 或 Linux 電腦、願意花一次功夫建 8GB 環境、而且自己的使用情境(直播或通話)容許對應模式的延遲特性,那就照官方文件裝一遍,先用原聲模式確認音訊路徑通,再開 AI 轉換。只是想看趨勢的人,記住兩件事就夠:即時變聲的算力門檻已經降到不需要獨立顯示卡,而把研究模型變成產品的那段工程,成本正在被免費的 AI 開發工具快速吃掉。至於「近零 token 費」,那是開發者的帳單,不是使用者的。