TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

26 位跨領域學者發表 210 頁工作論文,評估用硬體手段讓前沿 AI 訓練暫停至少十年的可行性:停產可訓練晶片、逐步換成推論專用晶片、以全球普查掌握既有存量;四個條件成立就撐得住十年,政治意願則被明確放在分析之外。
用 AI 摘要這篇文章:
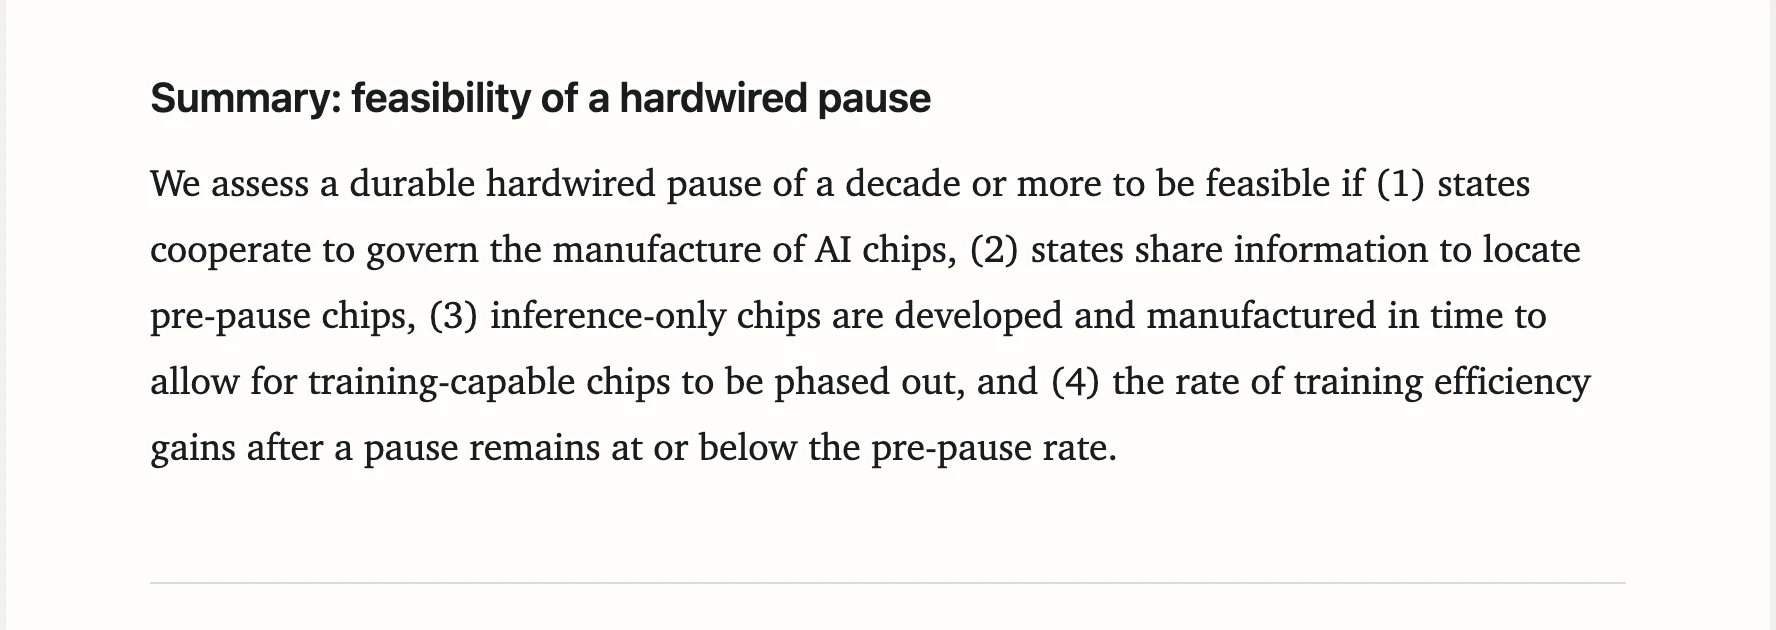
先講結論:一份 210 頁的工作論文評估,用硬體手段讓前沿 AI 訓練暫停至少十年,技術上做得到,前提是四個條件同時成立:各國合作治理 AI 晶片的製造、共享資訊找出暫停前就已存在的晶片、推論專用晶片及時量產讓可訓練晶片退場,以及訓練效率的進步速度不超過暫停前的水準。論文明確把政治意願放在分析之外,當成假設處理。
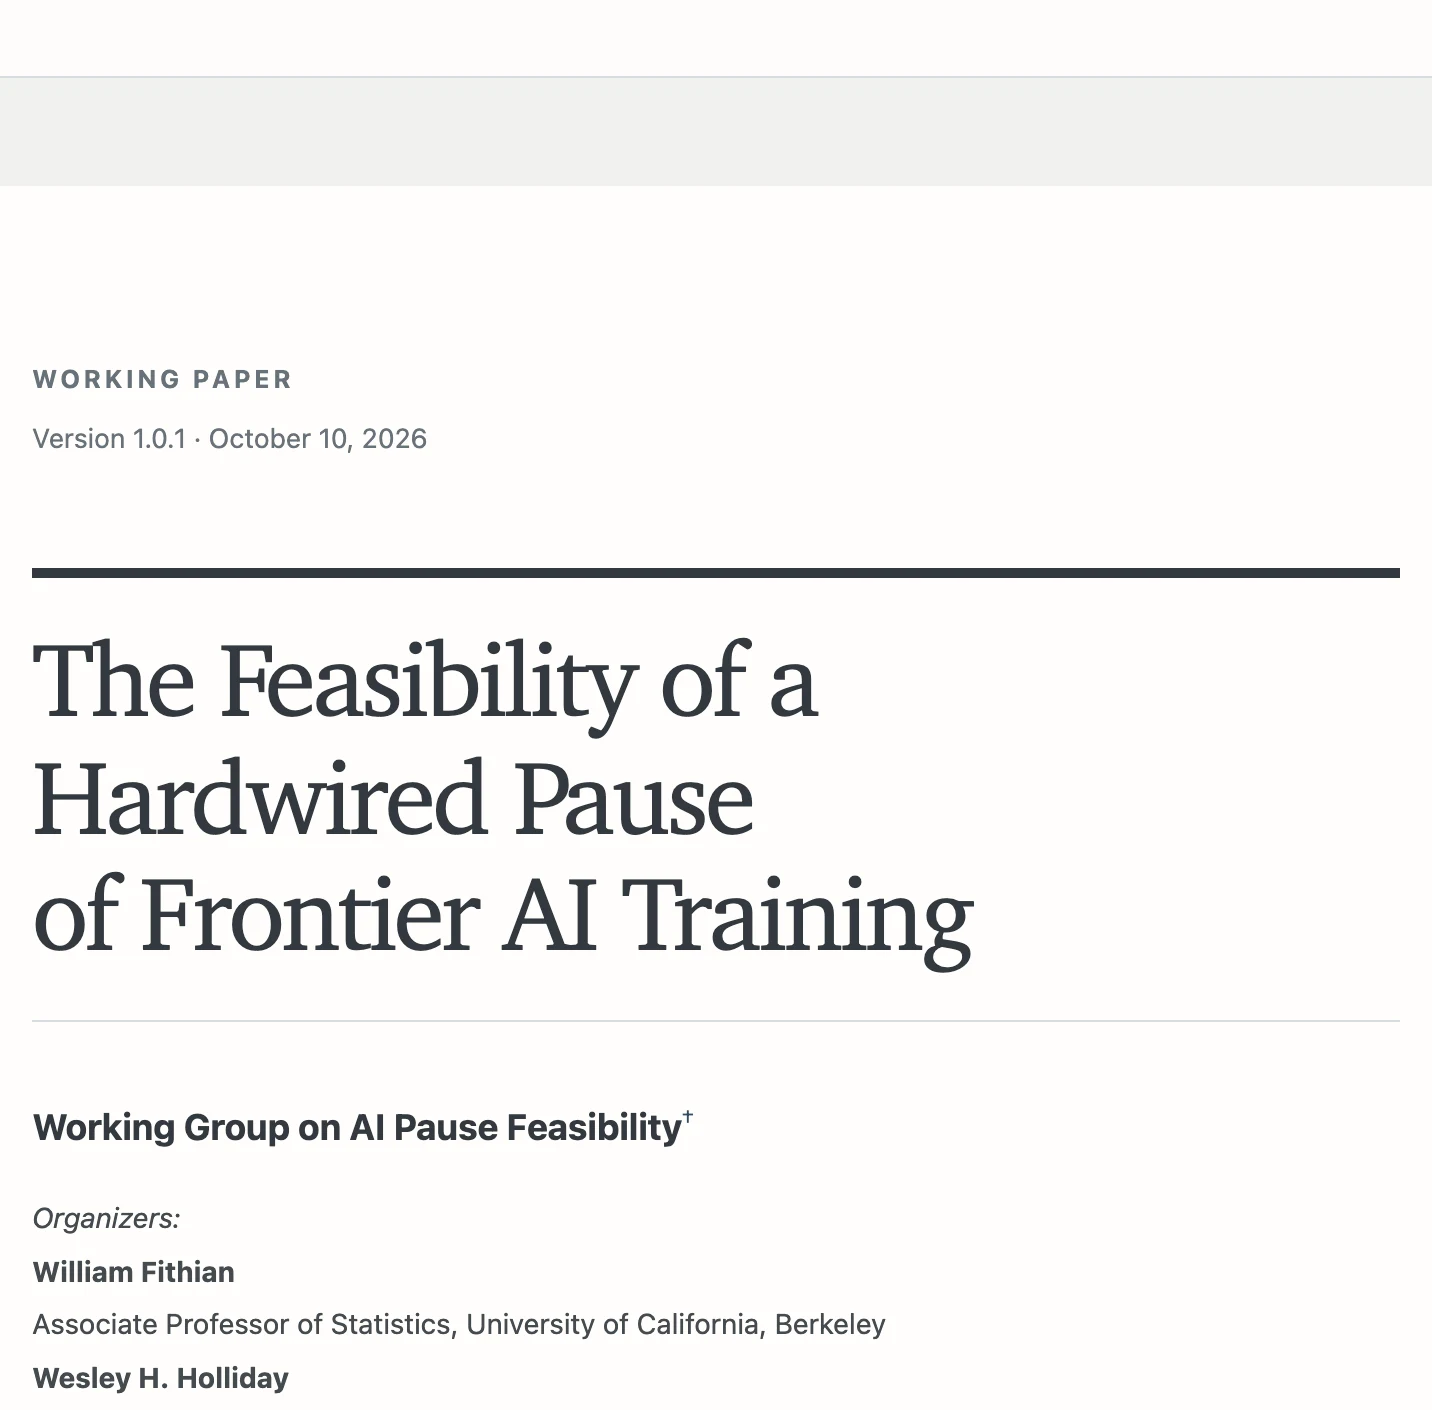
這份論文《The Feasibility of a Hardwired Pause of Frontier AI Training》由 26 位跨領域學者以「AI 暫停可行性工作小組」名義共同發表,10 月 9 日對外公布,隔天更新到 1.0.1 版。作者群橫跨統計、哲學、經濟、國際關係與電機工程,包括柏克萊電腦科學教授 Stuart Russell、經濟學家 Barry Eichengreen,以及史丹佛國際安全與合作中心研究學者 Rose Gottemoeller。兩位召集人是柏克萊統計學副教授 William Fithian 與哲學教授 Wesley Holliday。論文開宗明義畫出界線:它只研究「能不能停」,不研究「該不該停」,也不預測各國領袖會不會真的選擇停。
方案名稱裡的 hardwired 指的是把治理點焊在硬體上。兩個核心設計:禁止訓練新的前沿模型,但白名單上的既有模型可以繼續提供推論服務(訓練是用大量算力打造新模型,推論是用做好的模型回答問題);同時停止生產能拿來訓練的晶片,把現有存貨逐步換成推論專用晶片。後者出廠時就把特定模型的結構與權重刻進電路,跑那一個模型又快又省電,就算被偷走、被搶走,也難以用來訓練新模型。
推論專用晶片不是紙上構想,市場已經在經濟誘因下先動了。論文引述新創公司 Taalas 的自報數字:第一代原型晶片 HC1 實作客製化版本的 Llama 3.1 8B 模型,單一使用者每秒約 17,000 個詞元,對照的 B200 加速器是 353 個。論文隨即補上但書:這是單人序列速度的優勢,總吞吐量通用加速器會追平差距。AMD 已同意收購 Taalas;論文正文還列了另外兩個例子:Etched 的推論硬體在 2026 年 7 月交付第一個機架,OpenAI 自家的 Jalapeño 晶片打算在年底部署,論文並特別註明它屬於推論優化、還不是推論專用。換句話說,在任何暫停協議出現之前,換軌就已經開始:市場為了省成本,本來就在把推論工作往專用晶片搬。
換晶片的理由也寫在耐久性這一章。如果暫停期間可訓練晶片的存量繼續累積,等於在世界各地堆放論文所說的「乾柴」,任何一方退出協議,就能立刻點燃新一輪競賽。逐步把推論工作交給專用晶片,相當於一邊維持對消費者的服務、一邊拆除燃料。報告把整個換軌分成四個階段:協議簽署前市場基於成本自行搬移推論工作、協議生效後展開普查與專用晶片設計、專用晶片進入量產並啟動以舊換新,最後是多數推論由專用晶片承接,可訓練晶片大量退場。既有晶片在過渡期可以繼續做推論生意,但要拿授權,授權額度隨專用晶片供給增加而遞減,到期就得把可訓練晶片拿去以舊換新,或由官方買回。
這份研究把驗證處理成數量問題。用一台電腦偷偷訓練小模型幾乎抓不到;但前沿級訓練需要數十萬顆、甚至百萬顆晶片持續運轉數月到數年,想瞞過查核極為困難。作者的估計是,前沿訓練的算力預算過去五年大約每 18 個月成長十倍,要沿這條軌跡走到 2028 或 2029 年,所需晶片數量會遠超現有存量;想在暫停後明顯超越前沿,違規者得動用全球總算力裡相當可觀的比例,同時假裝這些晶片在做吃重的推論服務。
作者把違規分成兩型,防線也不同:
| 違規型態 | 情境 | 主要風險源 | 防線 |
|---|---|---|---|
| 暗中迴避 | 表面遵守查核,私下偷訓新模型 | 未申報的既有晶片 | 晶片普查+過渡期授權查核,短期內合理有效的驗證就夠用 |
| 公開毀約 | 囤積大量晶片後直接退出協議,加速趕出一個決定性模型 | 留在商業體系裡做過渡推論的既有晶片 | 查核擋不住,只能讓總訓練容量本身變小:晶片離岸保管、科學保育區、斷電封存 |
作者群評估,毀約艦隊的規模必須大於今天全球晶片總存量,所以公開毀約不是立即威脅;但若放任存量繼續成長,威脅會自己長出來。對應的設計包括:把大部分既有晶片移到境外或交給中立國家保管,一旦某國毀約,其他國家就阻止它再拿到這批容量;把一部分晶片放進國際治理的科學保育區,跑經過宣告、透明的科研工作負載;或者以斷電封存的方式放進受監控設施,裝在密封袋裡定期檢查。
停得住,接下來的問題是停得久。演算法持續進步的話,同樣的算力能訓練出更強的模型,暫停的效力會一點一點流失。論文給出量化門檻:對暫停時前線等級的模型而言,訓練效率的進步不能快於每五年一個數量級;這個速率大約相當於摩爾定律 18 個月翻倍的進度,換句話說,摩爾定律等級的進步速度就是這份方案能夠消化的上限。報告的判斷是,只要全球普查與推論晶片量產這兩件事在效率前進一個數量級之前完成,暫停就能再承受第二個數量級的增益,因此及早實施的話,撐十年以上是可能的。至於歷史紀錄,受控實驗下的效率增益大約在或低於這個速率,兩次大幅躍進(transformer 架構與 Chinchilla 配平)都與快速規模化互補,而規模化在暫停後也會停下來,研究者也無法再在前線規模上測試新想法。
掌握既有存量靠全球普查。背後的邏輯很直接:加速器伺服器是單價數十萬美元的資本財,從製造、銷售、進口、運轉到報廢都會留下文件痕跡,包括銷售紀錄、買方稅務資料、機房庫存、電費單、晶片租賃紀錄;中國的海關與稅務紀錄也能追溯被轉運繞過美國出口管制的硬體。政府可以搭配收購方案與檢舉賞金,並對繞過管制的空殼公司提供大赦、換取補交歷史紀錄。普查還有一層商業誘因:想繼續用既有晶片做過渡推論生意,就得先申報;工作小組評估,執行得當的普查有機會找出協議國境內絕大多數的既有晶片。報告也明言普查需要美中合作,任一方拒絕就很難成功,這是把政治難題誠實寫進技術條件裡。
製造端的治理點同樣集中。荷蘭 ASML 在 DUV 微影設備市場占主導地位,在更先進的 EUV 則是獨家供應商;論文引述喬治城大學 CSET 報告的形容,一台 EUV 機器由 5,000 家供應商提供 10 萬個零件,出貨要動用 40 個貨櫃。條約的設想是登記並追蹤世界上每一台 EUV 與 ArF 浸潤式 DUV 微影機,並在機器報廢時驗證實體銷毀。訓練藏得住,蓋一座先進晶圓廠藏不住,這是整份論文把治理點放在製造端的物理基礎。
論文假設的初始參與管轄區,包括美國、中國、歐盟(特別是德國與荷蘭)、英國、台灣、南韓與日本,理由是這些經濟體目前在先進 AI 晶片製造與前沿模型訓練兩端近乎集體壟斷。論文接著單獨點名:台灣的參與因其半導體製造角色至關重要,但正式條約地位可能受中華人民共和國爭議;可行的處理方式是比照台灣的 WTO 會籍或 IAEA 保障措施的參與先例,讓名稱與正式地位的問題留給外交解決。在這份設計裡,台灣不是順帶提及的名單成員,而是沒有它就很難成立的必要參與者,連最敏感的地位問題都先想好了出路。
論文花了一整節列出方案要付出的代價。硬體暫停需要新的硬體生產與部署監測機制;可能鞏固領先企業的市場地位,需要把 AI 開發商當成政府創造出來的寡占加以監管;模型的安全漏洞無法再用大規模重訓修補;知識截止日固定,可能讓價值觀與偏見跟著固化。經濟面的評估則相對樂觀:既有模型的推論擴散可以支撐 AI 相關支出與生產力成長,AI 公司估值下跌可由貨幣政策緩衝,資料中心的債務融資隱憂則無論暫停與否都該處理;專用晶片把推論成本壓低後,省下的錢至少有一部分會讓利給消費者,論文也把這筆讓利列為換軌的政治紅利。
作者名單頁還有一行容易被忽略的聲明:共同作者對論文有想法或文字貢獻,但不代表同意論文裡每一項主張,機構列名僅供識別。這行聲明有實際例子:共同作者、Mila 的 David Krueger 在論文發布當天寫道,這會是多數人眼中最好的計畫,但他仍傾向更激進的做法,直接拿掉晶片與晶圓廠。論文把這類主張定位為更激進的路線,硬體暫停走的是容許推論繼續運作的中間路線,接受在有限時間內留下有限數量的乾柴。
這份論文出現的時間點,正好接在產業討論「放慢」的一串事件之後:Dario Amodei 提出為前沿 AI 設速的具體規格,OpenAI 跟進承諾讓外部評估者進駐,三大實驗室開始談誰來當安全標準機構的裁判,Anthropic 則公布自家研發步調的量測方式。這些討論的共同前提是訓練照常進行、只是配上治理;硬體暫停論文給的是另一個方向的完整工程圖,把治理點從模型開發移到晶片製造與存量。它會不會獲得認真對待,取決於論文自己排除在外的變數:各國領袖在什麼情況下會寧願停,也不願繼續跑。