TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

TurboSeek 是 2024 年走紅的開源 AI 搜尋引擎,開源版 Perplexity 的元老級示範品,整個專案只有 51 個檔案。實測打開官網輸入問題:來源搜尋正常帶回九筆結果,答案生成卻回傳空白,追問建議也是空的;舊模型 2026 年 3 月從 Together 下架後,修復計畫開了七十多天沒人合併,期間最後被合併的改動是轉介連結更新。本篇整理實測紀錄、三管線架構拆解、無授權條款的法律現實,以及現在還能用的替代選擇。
用 AI 摘要這篇文章:
在「開源版 Perplexity」這條路上,TurboSeek 算得上元老。它出現在 2024 年 5 月底,比後來更多人知道的 Scira(前身 MiniPerplx)還早了兩個多月,作者 Hassan El Mghari 正是模型供應商 Together AI 的開發者體驗主管。把這些背景加起來,它比較像一份會動的教學教材:用一個極小的網頁應用,示範「問句、搜尋、生成答案、追問」這四步怎麼串起來。倉庫在 2024 年 6 月就走紅,一個月內擠滿了功能討論與改善建議,star 數從此停在千級,再沒有往上翻過。
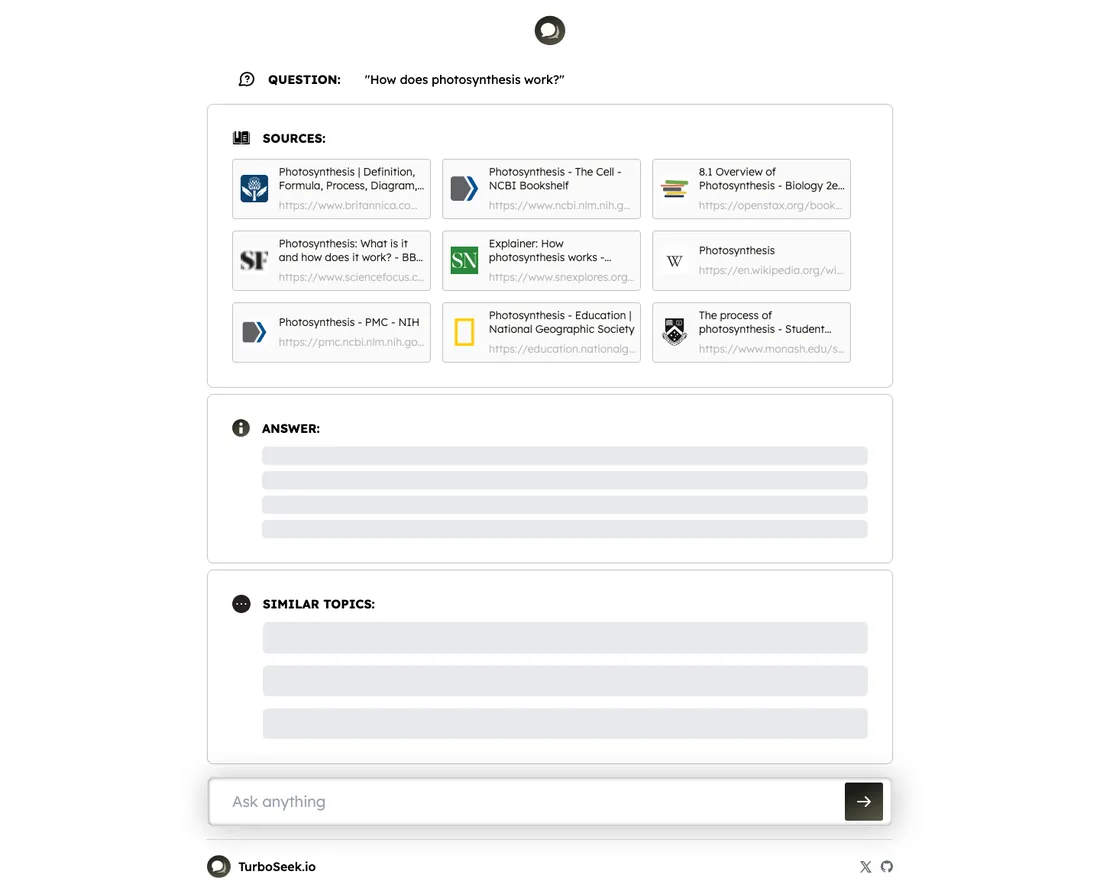
兩年後的今天,我實際打開 turboseek.io 輸入問題,得到的畫面是這樣的:來源列表認真列出九個網頁,答案欄停在載入動畫,等到最後也沒有出現半個字,追問建議同樣是幾條永遠填不上內容的佔位橫條。搜尋那半邊活著,生成答案那半邊停擺了。
Perplexity 一類的 AI 搜尋引擎,背後是一整套檢索、排序、引用、快取的工程。TurboSeek 反其道而行:整個倉庫只有 51 個檔案,扣掉圖示與設定檔,真正的程式碼集中在三個結果介面與三支後端路由上。它在 GitHub 上累積了約 1,657 顆星、261 次 fork,發布紀錄是零,套件版號從頭到尾停在 0.1.0,從來沒有出過一個正式版本。
這不是缺陷,而是定位。README 裡「啟發來源」那一欄寫得坦白:Perplexity、You.com、Lepton Search。同樣打著開源旗幟的後進裡,Scira 已經長成功能完整的多引擎搜尋系統,Gemini Search 則是另一個極簡複刻的變體。TurboSeek 佔的位置從一開始就是「給開發者看內部構造」的那一格,連 Together 的官方教學文件都直接以它為範例,教你怎麼用自家模型拼出同款搜尋引擎。
理解這個定位,後面發生的事就比較好讀。
我在 2026 年 10 月 10 日做了兩種測試。用瀏覽器實際走一遍官網流程:輸入「光合作用怎麼發生」,來源區塊很快載入,答案區塊從頭到尾空白。再直接呼叫它網站背後的三個介面,結果一致:
| 介面 | 功能 | 實測結果 |
|---|---|---|
| getSources | 搜尋來源 | 正常,回 9 筆含內文的結果 |
| getAnswer | 生成答案 | HTTP 200,本體 0 字元,五次全空 |
| getSimilarQuestions | 產生追問 | 回空陣列 |
getSources 的回應其實相當扎實,一次帶回約七萬字元,九個來源各附一段可用的正文,涵蓋百科、教科書與科普媒體。也就是說,負責找資料的部份沒有偷工減料。不過來源品質有個值得一提的癖性:我拿一檔美股去問,搜尋服務 Exa 自家內容庫的頁面也擠進了前幾位,券商與財經媒體被擠到後面。搜尋供應商把自家內容混進前排,對答案的廣度多少是個折扣。
但答案生成是另一回事。getAnswer 在半秒內就回傳,狀態碼是成功的 200,內容卻是 0 字元。這種「成功但空白」的回應重複了五次,瀏覽器與直接呼叫都一樣。追問建議的介面同樣只給了一個空陣列。
順帶一提,這些介面完全不設防:不用登入、沒有額度限制,任何人都能直接呼叫。專案的待辦清單上躺著「加上快取與速率限制」這一條,兩年來始終是待辦。這無所謂,它本來就沒打算當一個要營運的產品。
有個值得留意的細節:就算答案正常生成,它也不會告訴你哪句話出自哪個來源。原始碼裡的提示詞明確要求模型「絕對不要輸出引用與參考資料」。讀者拿到一段無法核對的文字,這是它與 Perplexity 體驗差距最大的一點,而「把引用標好」這件事,也一樣躺在那份待辦清單上。
所以網站今天實際剩下的功能,比較接近一個附帶摘要文字的來源列表器:九張來源卡片還是會認真渲染出標題與網址,你想自己點開來讀,它都幫你找齊了;只是「幫你讀完並整合成答案」的那一步,目前交不出來。
另一個對照可以看出時間的痕跡。2024 年 6 月的網頁存檔裡,首頁寫的是「Powered by Together AI」;現在的首頁變成「Powered by Together 與 OpenAI gpt-oss」,搜尋供應商也換了名字。介面兩年幾乎沒動,底下的引擎已經換過一輪。
TurboSeek 的流程拆開來是三支各自獨立的後端路由,這個邊界乾淨的切法本身就是它的教學價值。
搜尋那支最單純:把問句丟給 Exa 的搜尋介面,一次要 9 筆結果,並且在程式碼裡寫死了三個排除網域,youtube.com、nytimes.com、x.com 一律不採用。這裡有個文件對不上的小插曲:README 的運作原理寫「取前 6 筆」,程式碼實際要的是 9 筆,文件停在舊版本沒跟上。
答案那支把每個來源的內文截斷後連同問句一起送給 openai/gpt-oss-20b,推理等級設成 low,最長跑 45 秒,以串流方式回傳。提示詞裡甚至還留著一句「照做對我的職業生涯非常重要」,模型時代的工程師求生欲,就這樣寫進了開源教材。
追問那支用的是 meta-llama/Meta-Llama-3.1-8B-Instruct-Turbo,要求固定回三個問題,還加了每小時的結果快取減少重複請求。
三支管線裡,純粹呼叫搜尋服務的那支活得好好的;需要 Together 模型的兩支,一支回空本體、一支回空陣列。換句話說,故障點出在它依賴的雲端模型,不在這個網站本身的程式碼。社群修復者引述的正式環境紀錄寫得很直白:Llama 3.1 8B Instruct Turbo 已經在 2026 年 3 月 6 日從 Together 的服務裡移除,最近一百筆請求裡有二十四筆因此收到 400 錯誤。至於答案端用的 gpt-oss-20b 是否也遇到同樣狀況,從外部無法完全確定,只能從「五次全空」的行為合理推論模型層出了問題。
還有一個背景讓這件事更諷刺:把整套原始碼搬回家自己架,處境只有好一半。環境設定檔要求三把金鑰,分別給 Together、Exa 與觀測服務 Helicone,成本取決於你在這幾個服務的用量。自架者改一行程式碼就能換掉答案模型,這是彈性;但追問那支管線在主線分支上寫死的就是那個已下架的 Llama 模型,照著 README 裝起來,這個功能從第一次啟動就是壞的。修復程式碼存在,只是沒被合併,你得自己動手搬。
把 82 個提交的歷史攤開,可以看到一條清楚的生命線。走紅之初,2024 年 5 月底到 6 月這一個月裡湧入了十一張工單與 PR,內容從更快的搜尋後端、Docker 打包到本地模型支援都有人提,熱度是真的;但對照後面的時間線會發現,十一張裡有八張從未進到主線,五張被直接關掉,三張至今還開著。
| 時間 | 事件 |
|---|---|
| 2024 年 5 月底 | 倉庫建立,一個月內湧入大量討論 |
| 2025 年 8 月 | 模型換成 gpt-oss,搜尋後端換成 Exa |
| 2025 年 12 月 | 依賴更新與安全修補 |
| 2026 年 3 月 6 日 | 舊 Llama 模型從 Together 下架,追問功能開始報錯 |
| 2026 年 7 月 | 最後兩個被合併的改動,都是 Together 轉介連結的更新 |
| 2026 年 7 月 31 日 | 社群貢獻者開出修復計畫,至 10 月 10 日仍未合併 |
最後一欄是整個故事的核心。修復計畫的內容很完整:把下架的模型換成可用的、把觀測服務搬家到新的方案、附上正式環境的驗證紀錄與成本量測,甚至連相依套件裡一條已知漏洞的版本都鎖到修好的那一版,還特別註明追蹤資料不會記錄來源正文與金鑰。寫這份計畫的是兩年來貢獻度第二高的社群成員,先前幾次模型與搜尋後端的搬遷也是他做的。這不是隨手一拉的路人草稿,而是長期協作者的認真修復。它從 7 月底開到 10 月,超過七十天沒有人合併。
而在修復卡住的同一個月,被合併進主線的是什麼?是把首頁與文件裡的 Together 推薦連結換上新的行銷參數。那個連結就掛在首頁最顯眼的「Powered by」徽章上,點下去帶著推薦碼導向供應商的註冊頁,追蹤參數寫著 utm_campaign=example-app,供應商自己都把它歸類為範例應用。
維護優先級這件事,有時候不用聽任何人解釋,看提交紀錄就夠了。
官網首頁掛著一行字:完全開源,歡迎去 GitHub 按星。但整個倉庫沒有 LICENSE 檔案。GitHub 也明確標示這個專案沒有授權條款。
這在法律上的意義很簡單:預設保留所有權利。沒有授權條款的程式碼,別人原則上沒有重製、改作或商用的權利,「開源」只是形容詞,不是許可。倉庫裡 261 次 fork 照樣發生,大家照抄不誤,但想拿它當底子改產品的團隊,這一條比答案生不生成還要優先處理,起碼先找作者補一份授權。
文件的漂移也值得記一筆。同一份 README 對搜尋後端有三種說法:運作原理說用 Bing,安裝教學說去申請 SERP 或 Bing 的金鑰,技術棧清單卻說用 Exa。環境設定檔則只認 Exa。真實的答案只有一個,另外兩個是歷史留下來的化石,兩年來沒有人清。
這些細節拼起來的圖像很一致:功能隨外部依賴漂移、文件過期、授權從來不是重點,因為它的目的本來就是展示「怎麼做」,而非「拿去用」。
先說結論:想找一個能日常使用的開源 AI 搜尋引擎,現在不要選 TurboSeek。Scira 是功能與維護都完整的那個選擇;想完全本地跑、不依賴任何雲端模型的,看本地深度研究工具;想自架一套帶介面的深度研究系統,u14 的深度研究工具更貼近這個任務。純粹想理解 Perplexity 類產品怎麼運作的讀者,Gemini Search 那篇的極簡複刻解析與本篇對照著看,剛好湊成兩種不同的最小實作。
TurboSeek 剩下的價值在反面。它是一份 51 個檔案、一個下午讀得完的完整參考實作,適合想理解「AI 搜尋引擎拆開來長什麼樣」的開發者。如果你想讓它離線跑、完全不碰雲端模型,這條路 2024 年 6 月就有人開了需求票,到今天還開著,沒有人做。讀它的程式碼比用它得到的東西多,這句話在它全盛時期就成立,現在更是如此。
如果你是因為看到「開源 Perplexity」的介紹找上門的,把期待調整成「開源 Perplexity 的骨架標本」,體驗會合理很多。
無 LICENSE 檔案,法律上保留所有權利。專案狀態以 2026 年 10 月 10 日實測為準:官網搜尋功能正常,答案生成與追問功能失效;模型修復計畫自 7 月底開立至實測當日未合併,日後若被合併,功能狀態可能翻盤,值得回來再看一眼。