TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

OnnxOCR 把 PaddleOCR 的 PP-OCRv5 模型轉成 ONNX 並直接附在原始碼裡,clone 下來就能離線跑通整份文件,一行指令把它起成 HTTP 服務。本機實測一張文件 0.5 秒完成,繁中在辨識端可用、偵測端卻對字體敏感;服務要開到內網以外之前,鑑權與安全設定得自己補。
用 AI 摘要這篇文章:
開源 OCR 這個圈子裡,PaddleOCR 是模型的源頭,RapidOCR 則是最多人直接安裝的套件庫,在 GitHub 上累積了 8,071 顆星。同一家族裡還有一個角色常被忽略:OnnxOCR,1,874 顆星,做的是另一件事:它把 PP-OCRv5 辨識模型轉成 ONNX 格式,連同模型檔一起放進原始碼倉庫,再包上 API 服務與瀏覽器介面,做成一個 clone 下來就能部署的工程。我把整個倉庫抓到一台 Mac 上跑了一遍:模型完全不用另外下載,官方測試文件 0.532 秒辨完整張,自製的繁中測試卡在黑體渲染下五行全對、信心值 0.94 起跳;不過偵測端藏著一個會讓繁中使用者誤判的字體陷阱,而把它起成對外服務之前,安全設定幾乎要從零自己補。
OnnxOCR 是中國開發者 jingsongliujing 從 2023 年 7 月開始維護的專案,Apache-2.0 授權,定位寫得很明白:基於 PaddleOCR 重構、脫離 PaddlePaddle 訓練框架的部署型辨識工程。它支援 ARM 與 x86 架構,推理引擎統一走 ONNX Runtime,通用辨識這條主線只有 inference_engine.py 一個檔案直接呼叫 ONNX Runtime,下游廠商要讓它跑在自家 GPU 或 NPU 上時只需要改那一處(後來加入的 Qwen 擴充模組自帶另一套獨立呼叫);原始碼裡連華為昇騰的 CANN 執行提供者都預留好了,這是它鎖定中國國產硬體部署市場的痕跡。
實際把倉庫抓下來驗證的結果是:通用辨識這條主線完全通。擴充功能(車牌、表格、版面分析、文件轉 Markdown、接本地小模型抽欄位)的模型得再自行下載,這次沒有實測;對外服務的安全預設要自己補;維護節奏是陣發式的批次改版。它適合的人很明確:想在自有機器上快速擁有一個離線 OCR 服務、文件來源以印刷字體為主、而且有能力自己顧介面安全的人。
多數開源辨識專案的安裝流程都有個共同斷點:程式裝好了,模型還要自己找地方下載,網址過期或權限擋住就卡死。OnnxOCR 把這一步直接取消:倉庫裡的 onnxocr/models/ 目錄內建了 PP-OCRv5 的偵測、辨識與方向分類三個模型(約 22MB),連同隨附的方向修正模型合計約 28MB,clone 完成的那一刻就已經是可用狀態。
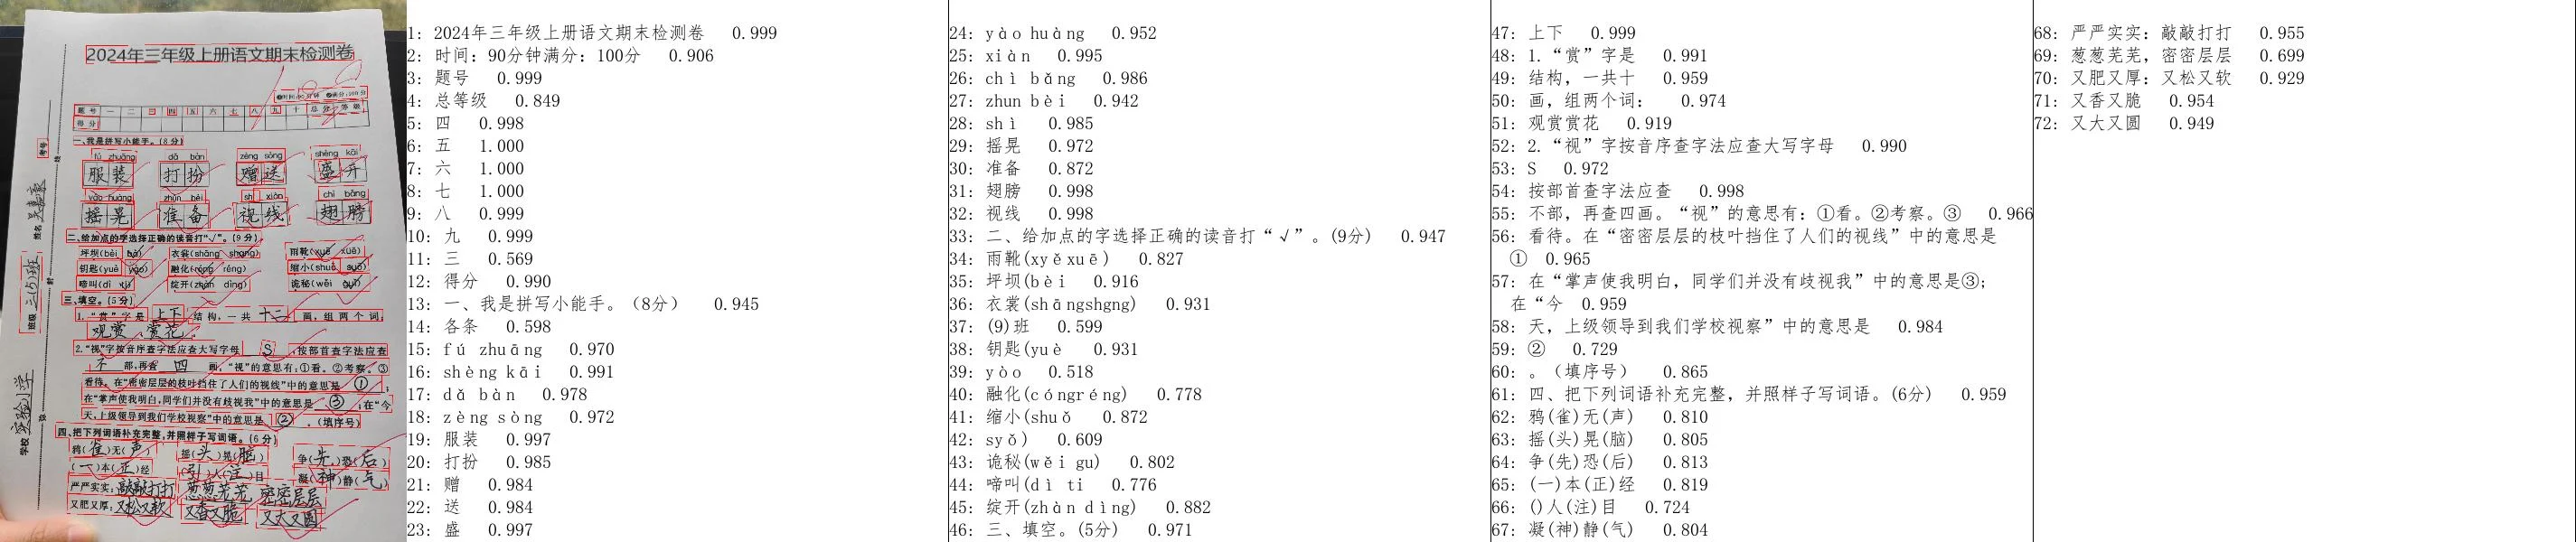
跑官方的 test_ocr.py,第一次嘗試就完整通過。測試圖是一張中國小學語文期末考卷,模型把整卷逐行辨出,從題目、括號裡的漢語拼音到漢字答案全數正確,整張耗時 0.532 秒(Apple M4 Max、CPU 推理),連題目裡標注漢語拼音的題組(例如要求學生選出正確讀音打勾的那種)都逐音節辨了出來,拼音附上聲調符號的部分也正確。比較弱的地方也很一致:裝訂線附近與低對比區域的信心值會掉到 0.6 以下,這種位置的辨識結果需要人工再核。
「輕量級」這個專案自述的形容詞,要看拆到哪一層。它指的是脫離了 PaddlePaddle 這個深度學習訓練框架,部署時不用連框架一起裝,這點成立;但完整的需求清單列了 34 個 Python 套件,包含下載模型用的 modelscope、huggingface_hub,甚至還有雲端儲存用的 boto3。如果只跑內建通用辨識,實測裝齊 OpenCV、ONNX Runtime 與幾個影像處理套件就能動,其餘是擴充功能在吃的。
版本演進集中在三個時間點:2025 年 5 月換上 PP-OCRv5 模型,官方說法是單模型支援簡中、繁中、中文拼音、英文、日文五種文字,且辨識效果與 PaddleOCR 3.0 保持一致(作者宣稱,未獨立驗證);2026 年 5 月 1 日一次加入車牌辨識、表格還原、版面分析與文件轉 Markdown,同時把 HTTP 端點補齊;將近一個月後再加進 Qwen3.5-2B ONNX 小模型,讓 OCR 結果可以直接抽成發票、身分證之類的結構化欄位。這條路的模型要從 ModelScope 自行下載,官方文件寫得完整,但這次沒有抓模型實測,先當作者宣稱看待。
台灣使用者最關心的問題直接實測。我用繪圖程式產了一張繁中測試卡,五行文字涵蓋發票號碼、地址與中英混合的金額。用黑體字型渲染時,五行全部辨識正確:「統一發票號碼:AB-12345678」「臺北市大安區復興南路一段」這些行的信心值落在 0.94 到 0.999,整張耗時 0.105 秒。就「把找到的文字讀出來」這一端而言,繁中是可用的。
換成宋體字型渲染同樣五行程式碼,結果立刻變樣:整行文字只剩繁簡同形的部分被讀出,例如「統一發票號碼」只剩「一票」兩個字,「臺灣」直接消失。掉落的字元有明確規律,全部集中在繁簡寫法不同的那些字,而繁簡同形的字(一、票、科技、中文)都安然無恙。
為了定位問題在哪一端,我把偵測模型單獨拉出來重現。同一種宋體、同一個尺寸:灣這個字用簡體寫法渲染,能得到一個完整的偵測框;換成繁體寫法,連一個框都沒有;把偵測門檻從預設的 0.6 降到 0.3,結果不變,代表模型對那個區域輸出的機率本身就趨近於零,問題不在後段過濾。換成黑體或 Arial Unicode 渲染「臺灣」,整個詞立刻有框。再查辨識字典,18,383 行的字表裡這些掉落的字全都在。也就是說,辨識模型認得它們,是「找文字在哪裡」的偵測模型在特定字體的繁體字形上失明了。
這個發現的實務意義比「支援或不支援繁中」更重要:它對文件的外觀敏感。實際要導入的人應該拿自己真實的文件樣本先跑一輪,印刷體的黑體系文件多半能直接過,宋體系的印刷品、尤其掃描件,就要預期會有漏字,可能需要調整解析度或先做銳化,再評估要不要換偵測模型。
OnnxOCR 與套件庫路線最大的差異在 app-service.py 這支檔案。執行它,數秒內就有一個 Flask 服務聽在埠上,端點涵蓋健康檢查、通用辨識、車牌、表格、版面與文件轉 Markdown,支援 multipart 上傳也收 JSON base64,預設單檔上限 200MB。實測把繁中測試卡用 multipart 丟給 /ocr,伺服器輸出的 JSON 帶著每段文字的外框座標、信心值與辨識結果,五行全對,處理時間 0.103 秒。倉庫裡另附 Dockerfile(Python 3.10-slim 基底)與 webui.py 瀏覽器介面,等於把「部署」本身當成產品功能在做。
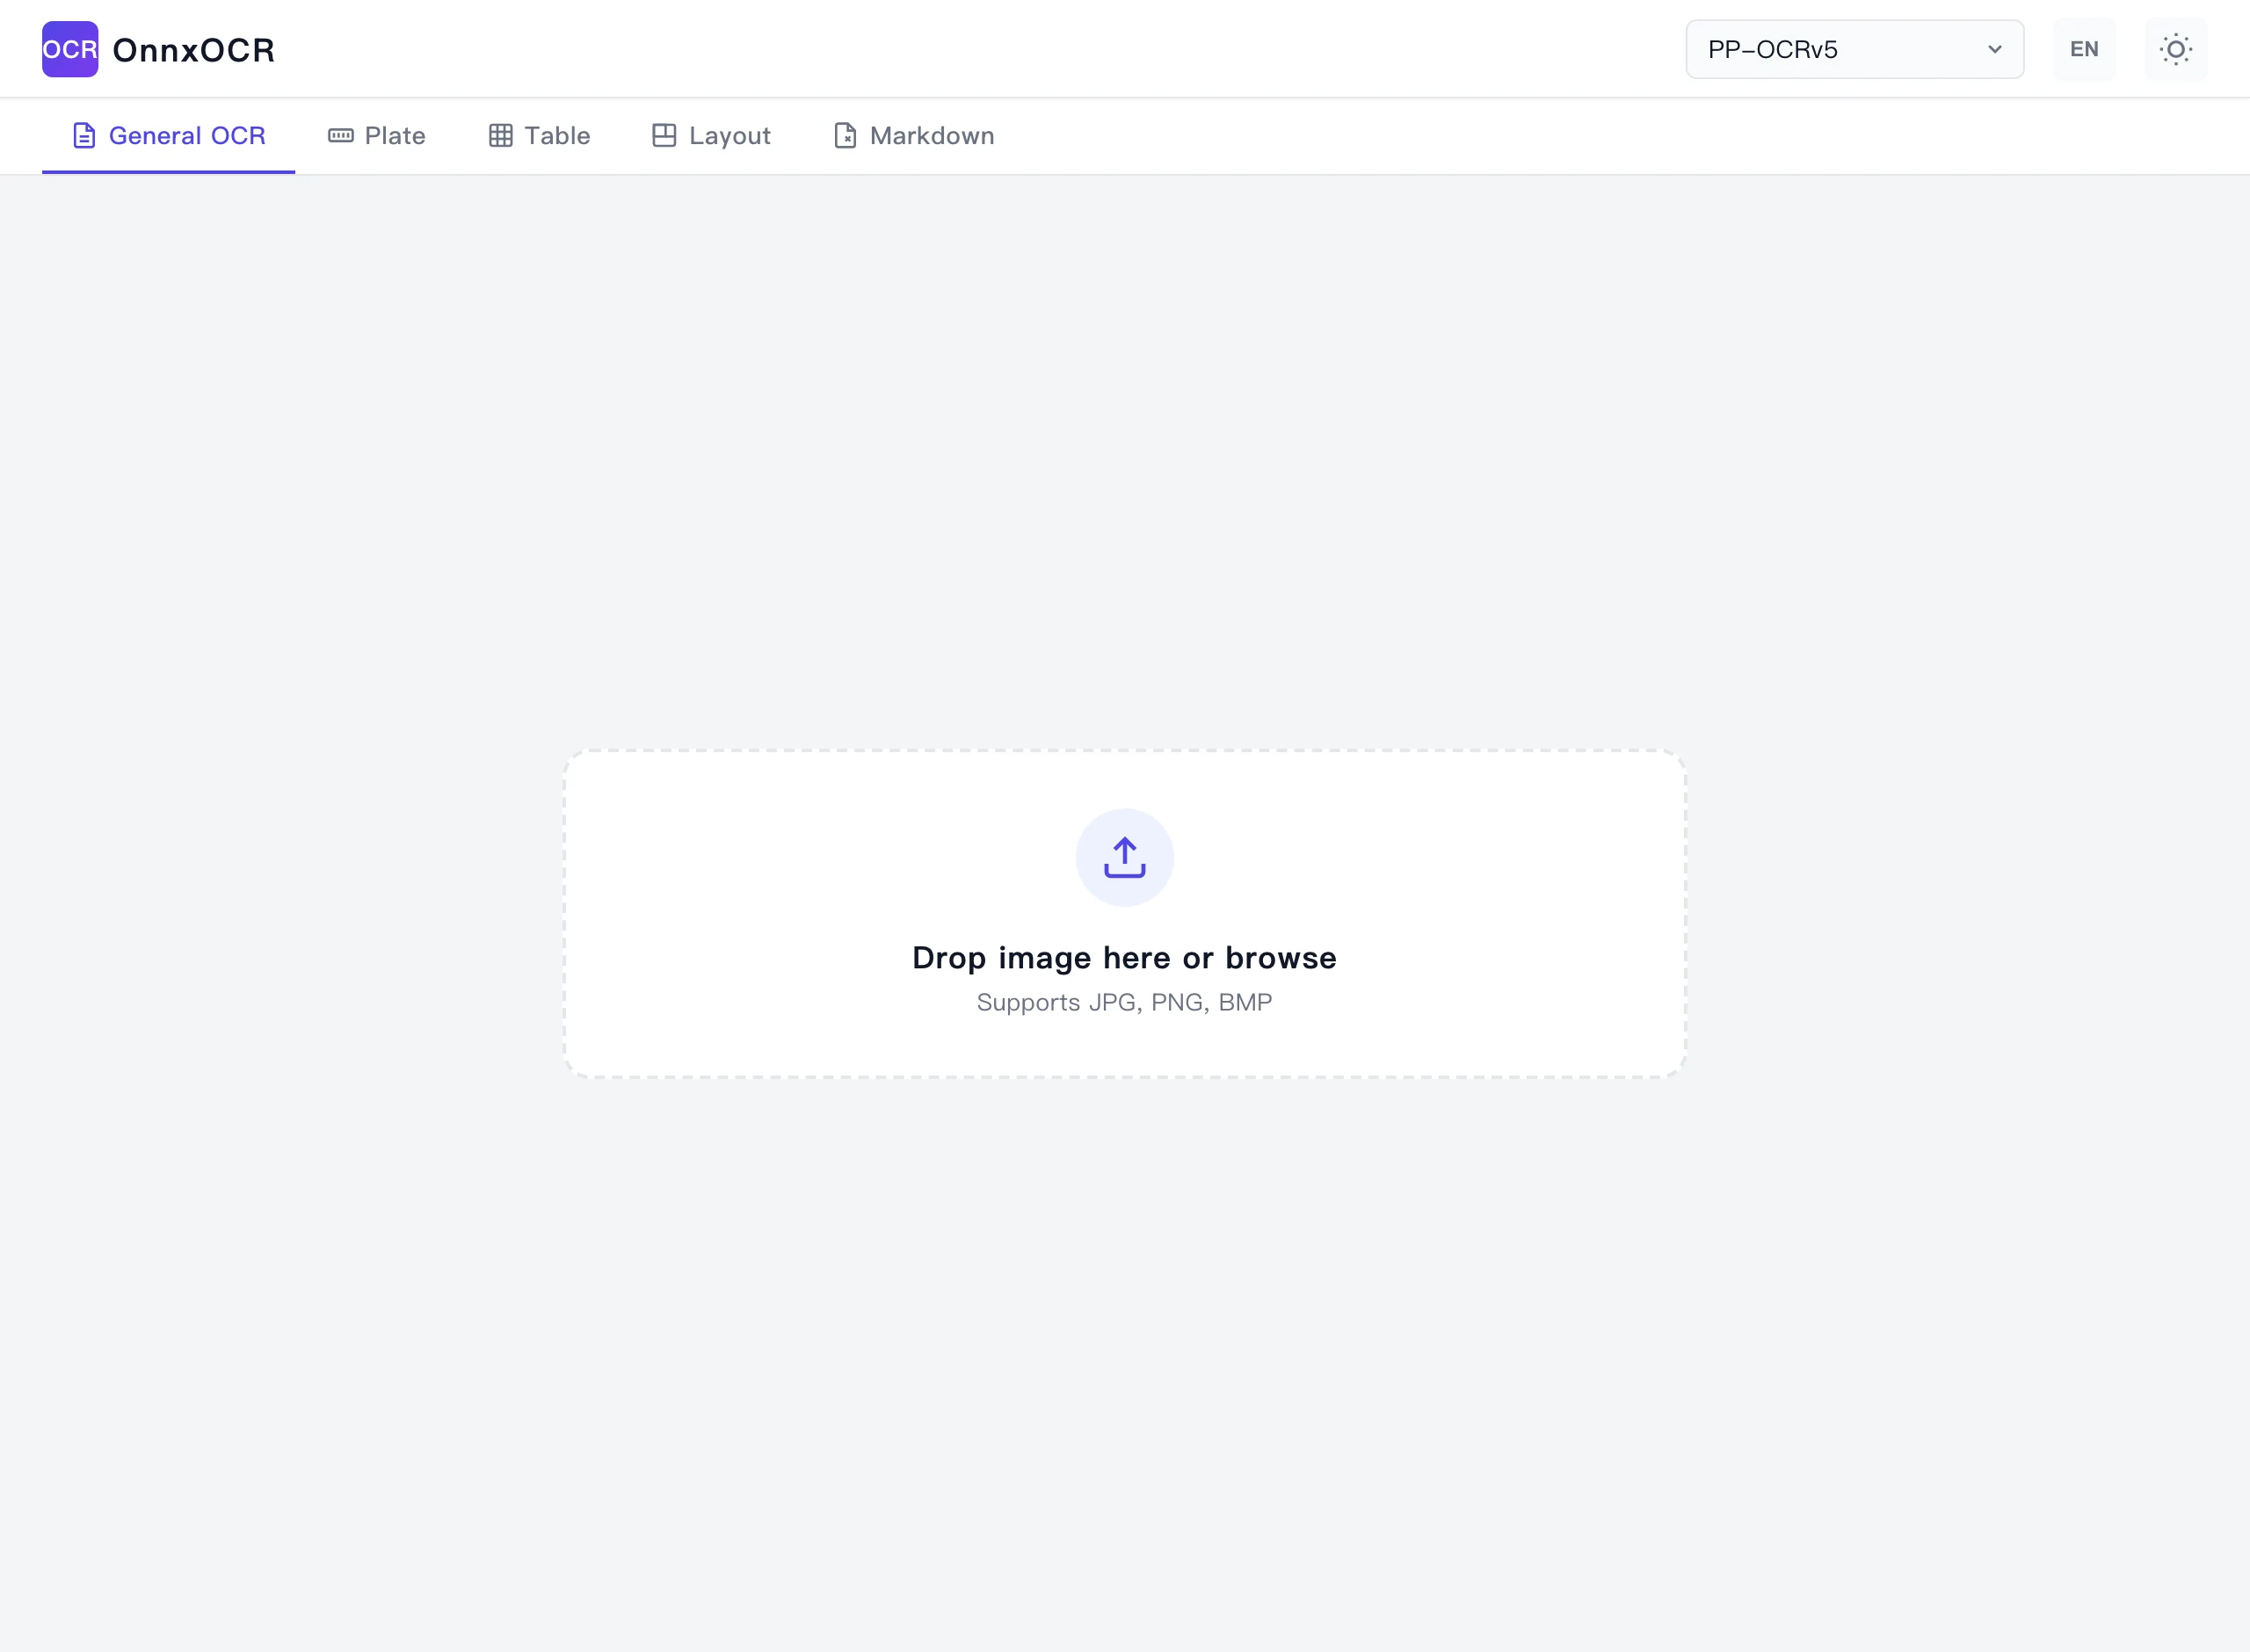
有兩個小細節值得記下。一個是函式庫層級的 use_gpu 參數預設是開的,在沒有 CUDA 的機器上(例如這台 Mac)會先嘗試 CUDA 執行提供者再退 CPU,功能正常但日誌會刷警告(官方測試腳本與 API 服務範例則明確把它設為關);而 issue 裡剛好有人反映 PP-OCRv5 在 CUDA 上部分捲積運算落入極慢的 fallback 模式,GPU 路線看來還有實務上的地雷。另一個是瀏覽器介面 webui.py 把監聽位址與埠號寫死成 0.0.0.0:5005,與 API 服務同一個埠,兩者無法同時啟動,要改得動程式碼。
同樣是「PaddleOCR 模型搬進 ONNX」,兩個專案賣的東西不同。對照如下(資料基準 2026 年 10 月):
|維度|OnnxOCR|RapidOCR|
|—|—|—|
|定位|部署型工程(模型、服務、介面整套)|辨識套件庫(裝進你自己的程式)|
|規模|1,874 星、200 fork|8,071 星、740 fork|
|模型|PP-OCRv5 隨倉庫附上,擴充模型另下載|安裝即用,支援多種推理後端|
|服務|內建 Flask API、WebUI、Docker|不附,自己包|
|維護|主要分支凍在 2026 年 5 月,打包線 10 月仍活動|2026 年 10 月仍有提交|
|授權|Apache-2.0|Apache-2.0|
|關係|直接整合 RapidAI 的表格、版面、文件模組|那些模組的發源地|
兩者是互補而非替代。OnnxOCR 的表格還原與版面分析,底層直接整合自 RapidAI 的 RapidTable、RapidLayout、RapidDoc,致謝清單也寫得清楚;RapidOCR 那篇實測我們先前寫過,走的是 pip install 裝進程式裡呼叫的路線。要寫程式把辨識嵌進既有系統,套件庫比較順;要在內網快速長出一個大家都能呼叫的辨識服務,OnnxOCR 這種把服務都備好的工程省事得多。
內網自用與對外開放,是兩種完全不同的安全等級,而 OnnxOCR 的預設值只照顧前者。三個要自己補的洞:所有 API 端點都沒有鑑權,任何連得上那個埠的人都能丟圖片進去;瀏覽器介面寫死 debug=True,Flask 的除錯模式開在 0.0.0.0 對外是長年被點名的風險;需求清單裡的 OpenCV 沒有釘版本,裝到舊版 wheel 檔時解碼器帶著已知的記憶體漏洞。
專案其實被安全研究盯過。2026 年 5 月 28 日,一個名為 Hinotoi-agent 的帳號一次繳了三份報告,分別指向未釘版本的影像解碼依賴、文件解析鏈的條件式風險,以及瀏覽器介面的表格預覽直接把辨識產出的 HTML 塞進 innerHTML 而沒有逃逸。作者的答覆很 2026:感謝之餘反問對方「不確定你是真人還是 AI」。三份報告都以關閉收場,但在 2026 年 10 月的主要分支裡,innerHTML 那個注入點與未釘依賴都還在原處。要把它開到內網以外的人,反向代理、鑑權、釘版本這三件事得自己來。
程式與隨附模型都是 Apache-2.0,商業使用在授權條款上是允許的;構成服務的每個模型(PaddleOCR、RapidAI 系列)授權同理,接 Qwen 小模型那條擴充線的模型授權則要自行核對,這次未驗證。
維護節奏看提交紀錄最準:主要分支 76 次提交,2024 年 6 月一波、2025 年 5 月一波、2026 年 5 月一口氣 28 次,之後就一路靜到 2026 年 10 月,47 個 issue 開著(行動版計畫、ARM 機器安裝失敗、批次推論都有人問)。不過 PyPI 上的 onnxocr 套件 2026 年 10 月 2 日還有新版 4.0.0 上架,由另一個打包倉庫維護;有趣的是官方 README 的安裝章節完全沒提這條 pip 路線,而 Python 版本地板出現三個數字:README 寫 3.8 以上、Dockerfile 用 3.10、PyPI 要求 3.11 以上。照官方 README 走原始碼安裝最穩。
文件漂移還有一處值得點名:2024 年版的英文 README 明寫支援超過 80 種語言、推理速度快 4 到 5 倍,這兩句在現行文件已經移除,換成 PP-OCRv5 單模型五種文字的說法。網路上仍找得到掛著舊規格的介紹文,看的時候請以倉庫現行 README 為準。
想在自有機器快速長出一個離線 OCR 服務、又不想自己包 API 與介面的人,OnnxOCR 是這個需求裡摩擦最低的選項之一:模型隨原始碼進門、服務一行指令就緒、Apache-2.0 沒有商用疑慮。反過來,需要穩定的長期維護承諾、要 GPU 大量吞吐,或文件來源字體很雜(尤其宋體系繁中掃描件)的人,要先做小規模試行,或者考慮把它的偵測模型換成自己驗過的組合。把它定位成「部署的起點」而非「成品」,期待會最準確。
### 繁體中文可以直接用嗎?
辨識端可以,實測黑體渲染的繁中卡五行全對、信心值 0.94 以上。偵測端在宋體渲染下會漏掉繁簡寫法不同的字元,實際導入前請先用真實文件抽測,必要時調解析度或換偵測模型。
### 可以商業使用嗎?
程式與隨附模型採 Apache-2.0,條款允許商業使用。接 Qwen 小模型抽取欄位那條擴充線的模型授權需自行核對,未包含在這次驗證範圍。
### 跟 RapidOCR 選哪個?
要寫程式嵌入選套件庫(RapidOCR),要快速起一個內部服務選部署工程(OnnxOCR)。兩者的 Apache-2.0 授權相同,模型血緣也同源,差別在你要的是零件還是整機。