TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
openai-captcha-detection 用 46 行 Python 把一張扭曲文字驗證碼丟給視覺模型,同一張圖 tesseract 八種組合全錯、視覺模型一次讀出正確答案;README 宣稱的 GPT-4 與 100% 準確率,對上原始碼與檔案各有四處落差,安裝指令還指向已消失的倉庫。
用 AI 摘要這篇文章:
GitHub 上有一個 213 顆星的倉庫 openai-captcha-detection,README 第一句自我介紹是「使用 OpenAI 進行驗證碼識別的工具」,後面還掛了「目前驗證碼識別準確率 100%」的宣稱。我把倉庫 clone 到本機、逐行讀完兩支 Python 程式、再拿倉庫自帶的樣本驗證碼圖跑了一輪對照,先給兩個直接答案。
其一,它不是一個下載就能用的工具。主程式扣掉空行與註解只有 46 行,把一張本機圖片縮圖、轉成 base64、送去 OpenAI 的 API、印出結果,這樣就結束了;連 README 的安裝指令,clone 的都是一個已經消失的倉庫。其二,它順手示範的事實比工具本身重要得多:把一張扭曲文字驗證碼丟給視覺模型,只需要一次 API 呼叫。同一張樣本圖,我用傳統辨識引擎跑了八種組合全部讀錯,視覺模型一次就讀出正確答案。
這篇文章把兩件事攤開講:這個倉庫在 README 之外的真實樣貌,以及這份不到百行的範例,對依舊靠扭曲文字擋機器人的網站傳達了什麼訊息。
先看倉庫的履歷。openai-captcha-detection 由資安工具作者 XiaomingX 於 2024 年 11 月建立,至今 213 顆星、32 次 fork,累積只有 5 個 commit。程式碼的最後一次實質更動停在 2024 年 11 月 12 日,也就是倉庫誕生當月;之後兩次更新都只改了 README,最近一次是 2025 年 8 月 31 日。以專案生命週期來說,這是一次性寫完就凍結的概念展示。
主程式 src/gpt4_ocr_demo.py 的結構,拆開來是四個動作。讀入圖片後先縮到 300×100 以內,再把圖片編碼成 base64 字串,接著組一條提示詞連同圖片送進 chat.completions 端點,最後把模型輸出裡的破折號清掉、印出來。失敗時重試最多 3 次,每次間隔 2 秒。整個 OCRClient 類別加上示範用的 main 函式,就是倉庫的全部主流程。
提示詞本身有個小設計值得一提:它要求模型「以項目列表格式直接輸出識別出的結果,不要輸出其他內容」,然後程式再把輸出裡的破折號刪乾淨。強迫列表格式是為了壓住模型廢話(不然它可能先禮貌性描述一番圖片內容才給答案),刪破折號則讓輸出可以直接拿去用。這類擠牙膏式的小技巧在 API 應用裡很常見,在 46 行裡放進去,看得出作者寫過生產程式碼。
兩個細節值得停下來看。建構子的出廠預設寫的是 model=”gpt-4o-mini”,而 README 從標題到內文賣的都是 GPT-4;內部函式名稱 invoke_gpt4o_ocr 反而比行銷文字誠實。另外,示範流程把圖片路徑寫死成 img/226md.png,換一張圖就得改程式碼,倉庫裡也沒有命令列參數、批次處理或瀏覽器整合。它連「指定一張自己的圖」這個最基本的需求都沒有介面。真想在瀏覽器裡把這類辨識做成順手的功能,站內先前介紹過 做成 Chrome 擴充 與 油猴腳本 的兩種完整實作,工程完成度都高得多。
倉庫裡另一支 local_ocr_demo.py 是本地對照組,用 pytesseract 搭配灰階、中值濾波、自動對比、二值化一連串影像預處理,示範傳統 OCR 路線怎麼做。這也解釋了 requirements.txt 的長相:pytesseract 是對照組要用的,opencv-python 更是整個倉庫沒有任何一支程式 import 過,這份清單是照實驗環境抄來的,不是照最小依賴整理的。
判定很單純:這是一份概念驗證程式,證明「視覺模型 API 讀驗證碼」這件事成立,而「工具」兩個字是包裝。
這個倉庫最值得記錄的,是宣稱與實作之間的距離可以拉到多開。以下四處落差都看得到檔案層證據。
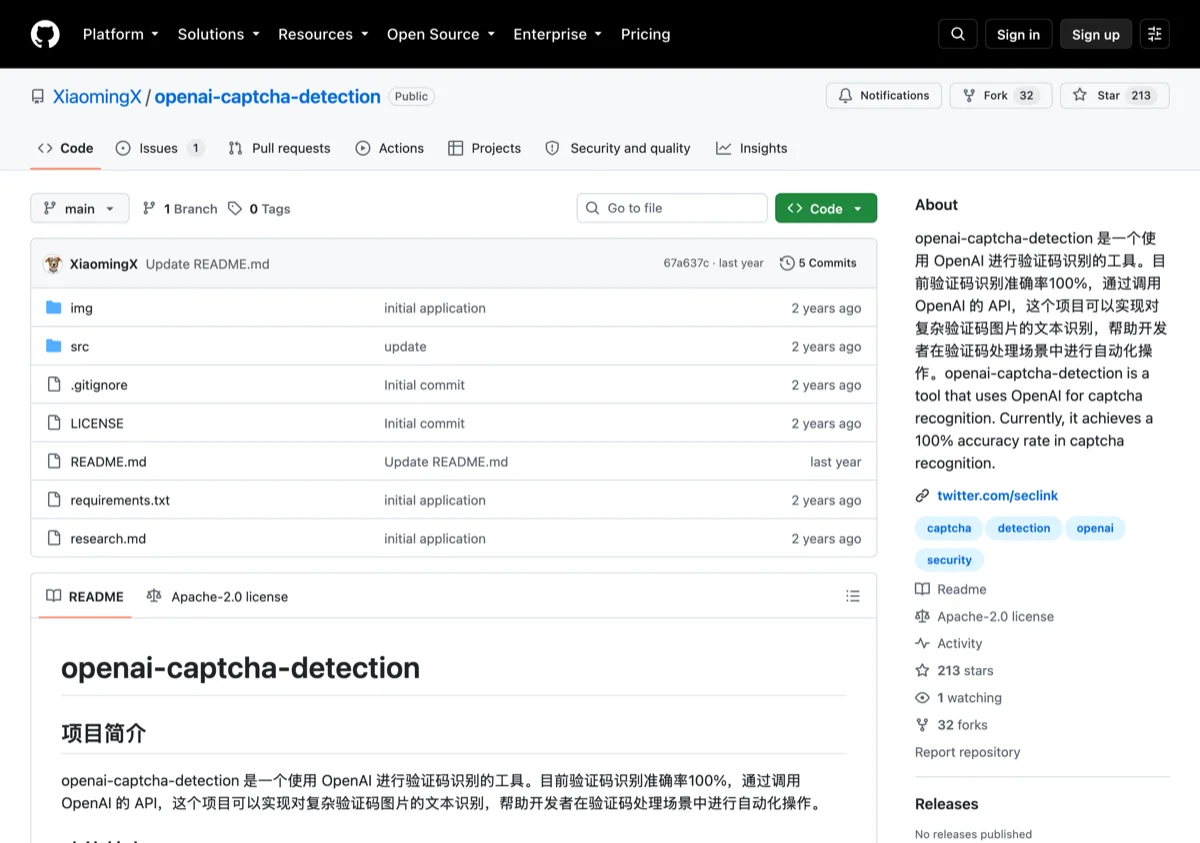
最先露餡的是模型名。README 通篇以 GPT-4 為賣點,程式出廠預設卻是最便宜的 gpt-4o-mini。兩者在 2024 年底的價差從數十倍到百倍量級,對一份示範「驗證碼識別多簡單」的程式來說,用哪個模型其實不改結論,但宣稱層和實作層不該各說各話。
準確率的宣稱同樣經不起翻。我在倉庫裡找不到任何測試腳本、資料集或結果截圖可以支撐這個數字。repo 裡唯一像研究材料的檔案是 research.md,內容是文獻筆記:提到有研究團隊改造 YOLO 模型做到 100% 識別 Google reCAPTCHA v2,也提到 CNN 方法在部分資料集上超過 96%。注意這些數字的主詞全是別人的研究、別人的驗證碼類型;把文獻裡的 100% 貼成自己專案的商標,讀者引用時就會出事。
安裝來源照樣出包。README 的安裝段教你 git clone 一個叫 zgimszhd61/openai-capcha-detection 的倉庫(拼字還是 capcha)。這個倉庫現在打開是 404,已經不存在了;而 XiaomingX 這份在 GitHub 上並不是 fork 關係,上游刪掉之後,照官方文件走的人第一步就會撞牆。從 README 指令與程式風格推測,這份程式碼的源頭可能就是那個消失的上游,作者搬一份過來重新包裝成自己的系列工具之一;這一層是推測,檔案層能確認的事實只有:指令是死的。真的要跑,直接 clone XiaomingX 自己的倉庫就好,這是 README 沒有寫、但兩秒鐘就能想到的替代方案。
授權欄位也各說各話。LICENSE 檔案是完整的 Apache-2.0 條文,GitHub 也自動偵測為 Apache-2.0,README 末段卻寫「此項目遵循 MIT 許可證」。這對想重用程式碼的人有實際差別:Apache-2.0 要求保留授權聲明與專利條款,MIT 沒有專利條款。以檔案為準是基本原則,但一個倉庫同時宣稱兩種授權,嚴謹度就露了底。
社群側的安靜也說明同件事。唯一的實質提問是 2025 年 2 月的 issue #1:「所以調用 OpenAI API 本身還是付費的?」到今天沒有任何人答。2025 年 10 月另一則用粗話批評倉庫灌水的 issue 被關掉了,同樣一行說明都沒有。213 顆星收得再多,也不構成維護承諾。
把話說公平:這些落差不代表程式是假的。46 行的結構完整、能跑、邏輯清楚,它展示的能力(視覺模型讀驗證碼)也是真的。它欠缺的是把「能跑的範例」經營成「可信的專案」的那一層。
倉庫附了一張樣本驗證碼 img/226md.png:白底、手寫塗鴉風格的幾個字元,一條斜向干擾線畫過文字區,字元大小參差。這張圖就是兩代辨識技術的公平測試場。
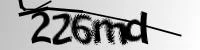
我先跑了倉庫自己的 local_ocr_demo.py,在本機裝好 pillow 與 pytesseract 之後執行,輸出是 err,三個字母,連字數都不對。這條路不是隨便送圖:程式先做了一整套針對驗證碼的影像預處理,把彩色圖轉成灰階(丟掉顏色干擾)、用中值濾波抹掉細碎噪點、拉開對比、再用門檻值把灰階壓成純黑白二值,最後才交給辨識引擎。該做的清理都做了,結果依然離譜。
接著加碼對照。tesseract 的辨識模式(psm)會影響它怎麼理解版面:psm 6 把整張圖當一段文字、psm 7 當單行、psm 8 當單一詞、psm 13 是針對彎曲文字的原始行模式。我把預處理過的圖和原始彩色圖各自用這四種模式送進 tesseract,八種組合的輸出依序是 ierid、ord、err、err、76rd、Sire、2 7err、2 7err。有些輸出像 ierid 和 76rd,勉強看得出它試圖把幾個字元的形狀猜出來,但沒有一次接近正確答案,多數連字元數都湊不對。八比零。
然後我把同一張原圖丟給一個視覺語言模型(用的是 GLM-5.3-flash,不是 gpt-4o-mini,所以這裡不替後者的成功率背書)。它一次讀出 226md,與檔名一致,順帶把圖片特徵描述了一輪:白底、一條斜向干擾線、字元輕度扭曲。附帶說句公道話,傳統 OCR 引擎在乾淨的文件場景依然稱職,站內先前實測的 RapidOCR 就把繁體中文文件逐行讀對;輸給視覺模型的是「為難機器而生的圖」這個特定場景。
要把這個結果講得誠實,得先畫好邊界。樣本只有一張,對照模型也只有一個,這不是統計,是方向。但方向足夠清楚:tesseract 這類先把圖切成單一字元、抽特徵、再與模板比對的引擎,在干擾線和扭曲面前潰敗得徹底;視覺模型則把整張圖當普通的場景文字來讀,手寫風格與斜線對它幾乎不構成阻礙。README 宣稱的那個 100% 在倉庫裡查無實據,而這場八比零是我親眼看到的。
要理解防線為什麼塌得這麼快,得先知道傳統驗證碼的防禦設計在對付誰。
tesseract 這一世代 OCR 的流程是切分再比對:先把圖像切成一個個字元的小方塊,抽出每個字元的輪廓與筆畫特徵,再和模板庫比對出最接近的字。扭曲、連體字、干擾線、噪點,全部都是衝著這條管線的弱點設計的:讓字元切不乾淨、讓特徵抽不穩。二十年來驗證碼的軍備競賽,大半精力花在把這條管線的錯誤率往上推。
視覺語言模型走的是另一條路。整張圖先被切成小塊、編碼成一串模型能讀的數字表示,模型在海量自然影像上預訓練過,見過路牌、菜單、手寫便條、海報上的藝術字。它讀圖的方式與接話是同一種能力:看過前面的內容,預測接下來最可能出現什麼。一張輕度扭曲的驗證碼圖,對它來說就是一張有字的圖,干擾線是雜訊,不是結構性的障礙。識別驗證碼與讀懂一張傾斜拍攝的招牌,對模型是同一種任務;這套讀圖能力放到文件場景,就是站內先前介紹的 Zerox OCR 拿視覺模型把 PDF 轉 Markdown 的同源方法。
還有一層時間因素讓這件事更不是新鮮事。這個倉庫凍結在 2024 年 11 月,而它當時寫死的模型名到今天仍然有效(後面成本段會給證據),也就是說一份快兩年前寫好的 demo,現在照跑不用改一行;這兩年視覺模型只會更便宜、更強。防線的失效不是某個版本的曇花一現,是單向的趨勢。
所以問題出在前提。文字驗證碼的安全性建立在「機器切字很難」這個假設上,而視覺模型 API 讓任何人不寫演算法、不訓練模型、只花一次 HTTP 請求的功夫,就能繞過這個假設。防禦設計沒有變弱,是它防的對象換了物種。
這個倉庫對一般讀者的價值,在於把攻防現實擺到檯面上:現在判斷文字驗證碼還能不能用,不需要讀論文,自己測一次就知道。
先給一個淘汰清單。純扭曲文字驗證碼、簡單的加減算術題、無行為分析的旋轉選字,這些以「讓機器讀不懂」為唯一防線的設計,都屬於被這類幾十行程式碼淘汰的世代。它們擋下的自動化流量,可能還不如造成的使用者流失多。
還站得住的方向有幾類。行為式評分(reCAPTCHA v3、Cloudflare Turnstile 這類不彈題目的風險評估)把驗證從「讀對圖片」換成「累積行為訊號」:滑鼠移動軌跡、停留時間、請求節奏都是分數來源,正常使用者無感通過,自動化程式分數上不去才被攔下,讀圖能力再強也用不上。互動式挑戰(拼圖拖曳、點選指定物體)把攻擊成本從識別一張圖換成模擬一連串擬人互動,腳本要造假的不只是答案,還有過程。脈絡驗證(手機號碼一次性密碼、付款時的銀行驗證)讓讀對驗證碼不再是通行證,因為通行權握在另一個管道手裡。而在驗證碼之外,服務端的頻率限制與異常流量偵測才是根本防線:同一 IP 每分鐘能送出幾次嘗試、失敗幾次後鎖定,這些規則與驗證碼長什麼樣子無關,也就不受模型能力進步影響。
成本視角把這件事講得更白。以 gpt-4o-mini 的牌價換算(輸入每百萬 token 0.15 美元,2026 年 10 月官方定價),攻擊者讀一張 300×100 的小圖,花費落在千分之一美元以下。防線如果建立在「攻擊很貴」上,這個前提已經不成立;能站住的設計只有一種,讓讀對了也沒有用,例如單次有效的 token、嚴格的頻率限制、與行為評分掛鉤的風控。
給站長的具體動作很簡單:截一張自己網站現在用的驗證碼,丟給任何一個視覺模型(不必是 OpenAI 的,手上有的都行),看它讀得乾不乾淨。如果它讀得七七八八,這套驗證碼就該排進退役時程,這個測試成本是零,而它給你的答案比任何供應商的行銷文案都準。
如果把這個倉庫當學習材料,有幾件事先說清楚,其中一條正好就是那個沒人答的 issue 的答案。
費用方面,它是自帶金鑰(BYOK)的設計:程式只負責呼叫,你要自己在環境變數放 OPENAI_API_KEY,費用計在自己帳上。gpt-4o-mini 到 2026 年 10 月仍列在 OpenAI 的模型清單、未列入除役表(同家族多個衍生版本已排定時程),輸入牌價每百萬 token 0.15 美元、輸出 0.60 美元,跑這種小圖的金額可以忽略:一張 300×100 的圖換算下來不到千分之一美元,就算跑一百張,帳單上的數字也小於一枚硬幣。所以 issue #1 的答案是:對,API 本身要付費,但跑這個 demo 的錢少到不成話題;真正要擔心的從來不是費用,是用途。
用途方面,正當與危險的邊界畫得清楚。拿它測自己網站的驗證碼強度、在內部測試環境跳過驗證碼做自動化 QA、做無障礙相關研究,這些都站得住。把識別結果拿去自動註冊帳號、爬別人的網站、繞過他人系統的人機驗證,則同時踩兩條線:OpenAI 的使用政策明文禁止惡意或濫用性的網路活動、禁止欺騙與冒充,違者帳號不保;而未經授權存取他人系統在多數司法管轄區是法律問題。2026 年一篇探討網頁代理指紋的研究論文也記錄,OpenAI 的內部安全準則會擋下繞過 CAPTCHA 的請求,平台層面對這類用途早有設防。換句話說,這份 demo 的「免費」只存在於不拿去做壞事的前提上。
授權與維護方面,重用程式碼以 LICENSE 檔的 Apache-2.0 為準,記得保留授權聲明;而程式碼自 2024 年 11 月後零更動,把它放進任何正式流程之前,先想清楚沒有人會修它。
openai-captcha-detection 作為一個專案,亮點不在交付了什麼功能,46 行的範例連換一張圖都要改程式碼,安裝指令還指向一個已經不存在的倉庫。它真正演示的是一個攻防現實:視覺模型讀一張扭曲文字驗證碼的難度與成本,已經低到不值得再當防線,而這件事用任何一家廠牌的模型都能在家驗證。
所以收斂成一個行動:如果你顧的網站還在用文字驗證碼,今天就去截圖測一次。讀得懂,就換;讀不懂,也別放心太久,因為下一個模型隨時會更便宜。而如果你是抱著找一個現成破解工具的念頭點進這個倉庫的,這裡沒有你要的東西,README 指的路一開始就是斷的,而真正能用的路,都通向你不該去的地方。