TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
PDFMathTranslate(pdf2zh)是把英文論文 PDF 翻成繁中雙語對照檔的開源工具,公式與排版完整保留。實測發現 2026 年 10 月照官方文件安裝會直接撞上依賴錯誤,修法是兩行指令把騰訊雲 SDK 降版;預設的 Google 翻譯服務會被免費端點限流到看起來像當機,換 Bing 可用但批次偏慢;官網免費版不需帳號,但實測排隊停在第十一順位逾四分鐘,且 PDF 是整檔上傳伺服器。本文整理三道關的實測過程、修法與五種取得管道的版本時間差。
用 AI 摘要這篇文章:
先說結論:想把一篇英文論文變成繁體中文的雙語對照檔,PDFMathTranslate(指令名 pdf2zh)確實是目前開源世界裡最完整的答案,公式、圖表、排版都能保留,一個指令吐出純譯文與雙語對照兩個檔案,GitHub 上三萬七千顆星、還有一篇 EMNLP 2025 的展示論文背書。但我這次從裝到跑完整走了一遍,2026 年 10 月的今天,照官方文件的第一條路安裝會直接撞牆:套件一裝好就報錯,修好之後預設的翻譯服務又被 Google 擋下來。這兩道關加上官網免費版的排隊,是三個各自獨立的問題,解法都存在,只是散在 issue 與文件的角落裡。這篇把三道關與解法一次說清楚,照著走可以少繞不少遠路。
我照 README 的建議,在一個乾淨的 Python 3.11 虛擬環境裡執行 pip install pdf2zh,安裝過程正常結束,裝完後執行 pdf2zh –help,最先報的錯誤是 ImportError,訊息寫著無法匯入 TextTranslateRequest 這個名稱。換 Python 3.12、改用官方文件另一條建議的 uv 工具安裝,同樣的錯誤再現一次。
問題出在一個它沒有釘住版本的依賴。pdf2zh 宣告依賴 tencentcloud-sdk-python-tmt(騰訊雲翻譯的 SDK 子套件)但沒有寫版本上限,而這個 SDK 在新版裡把 TextTranslateRequest 這個類別拿掉了,於是每一個新安裝的使用者都會裝到「已經沒有這個類別」的最新版,然後在程式啟動的第一步就崩潰。這不是我環境的問題:GitHub 上編號 1167 的 issue 在 2026 年 7 月就通報了同一件事,9 月初維護者把這個依賴釘在還保有該類別的 3.1.70(對應 issue 編號 1180),但修復一直沒有跟著新的安裝包發布。
修法很簡單,兩行指令:
pip install pdf2zh
pip install "tencentcloud-sdk-python-tmt==3.1.121" "tencentcloud-sdk-python-common==3.1.121"
第二行把闖禍的 SDK 降到還有這個類別的版本,之後指令列工具就正常了。這個版本是我實測可用的其中一個,原則上任何 3.1.129 以前的版本都行。
安裝前先確認 Python 版本:它在 3.11 與 3.12 上測過,3.13 裝不起來,終端機裡打 python3 –version 就能查。確認沒問題再照上面的兩行走。
要理解「修好了卻不發布」這件事,得先看這個專案的發行全景。五個取得管道的版本時間戳各不相同,五個入口活在五個不同的時間點:
| 取得管道 | 版本 | 最後更新 |
|---|---|---|
| GitHub 主分支 | 無版本號 | 2026-10-01 機器人提交仍日更;人工修改止於 09-08 |
| PyPI 安裝包 | 1.9.11 | 2025-07-11 |
| Docker 映像檔 latest 標籤 | 1.9.11 | 2025-07-11(dev 標籤更新到 2025-11) |
| 官網免費版 | 自報 1.9.6 | 頁面仍活著,版本字串較 PyPI 更舊 |
| HuggingFace 示範站 | 無版本號 | 2025-04-30 |
主分支的動態要分兩層看:倉庫裡的星數歷史機器人每天自動提交,使用者開的問題單到九月底都還很密集,但人工的程式修改最後一次落在 2026 年 9 月 8 日;而打進安裝包的發行管道停在了十五個月前。這表示專案不是死了,而是「修好的程式碼」與「你裝到的程式碼」之間有一條沒有補上的發行線。依賴爆炸的修復就卡在這條線上:它在主分支裡,不在你 pip 裝到的 1.9.11 裡。
對使用者的實際影響是:同一個工具,走不同入口會拿到不同時代的產物。拉 Docker 的 latest 標籤拿到的是與 pip 同日的版本,只有開發標籤多走了四個月;走官網拿到的是更舊的 1.9.6;而這些都落後主分支一年以上。
裝好之後,我用一篇十六頁的 arXiv 論文當測試素材,執行最基本的指令:pdf2zh 論文.pdf。預設的翻譯服務是 Google,走的是 Google 翻譯網頁版的免費端點,不需要任何金鑰。
結果是程式跑了四十五分鐘,一個字的譯文都沒有產出。翻譯快取資料庫裡的條目數是零,行程一直在背景轉。直接用一小段文字測試翻譯模組,錯誤這才現形:HTTP 429,伺服器送出的是 Google 的「sorry」驗證頁,也就是說這個 IP 已經被免費端點限流了。更麻煩的是程式的重試設計:翻譯工作執行器掛著每次間隔一秒、沒有次數上限的自動重試,被限流之後它不會告訴你「我被擋了」,只會永遠安靜地重試下去,表現出來就是進度條不動、沒有錯誤訊息、看起來像當機。
換成 Bing 服務(同樣免金鑰)再測,單一段落立刻成功:「Hello world, this is a test.」變成「你好,世界,這是一個測試。」,繁體中文輸出正常。但整篇論文的批次翻譯仍然快不起來,原因在程式碼裡:Bing 譯者的實作是每翻一段之前,都先連一次 Bing 翻譯首頁抓取當次的權杖,再送出翻譯請求。一篇論文有幾百個段落,等於幾百次首頁請求配幾百次翻譯請求,十六頁的檔案跑了四十分鐘以上還在排。急件不適合這條路,但它的輸出品質是可用的。
所以服務層的結論是:免金鑰的兩條路都有代價,Google 會被限流(可能要等冷卻或換 IP 才會解),Bing 可用但慢。要穩定跑長文件,正解是帶金鑰的服務:它支援 DeepL、OpenAI 相容端點、Gemini、智譜、ModelScope、SiliconCloud 等十餘種,環境變數填一填就能換;不想讓文字出門的人,可以在本機跑 Ollama 或 Xinference 推論服務再指過去,翻譯整條鏈路都在自己機器上。這也是它與單純網頁工具最大的不同:翻譯引擎是可替換的消耗品,版面處理才是它的核心價值。
不想安裝的人,官方網站 pdf2zh.com 提供免費的線上版,打開就是上傳介面:檔案上限 5MB、可以貼連結、選翻譯服務與語言、限定只翻前幾頁,全程不需要帳號。
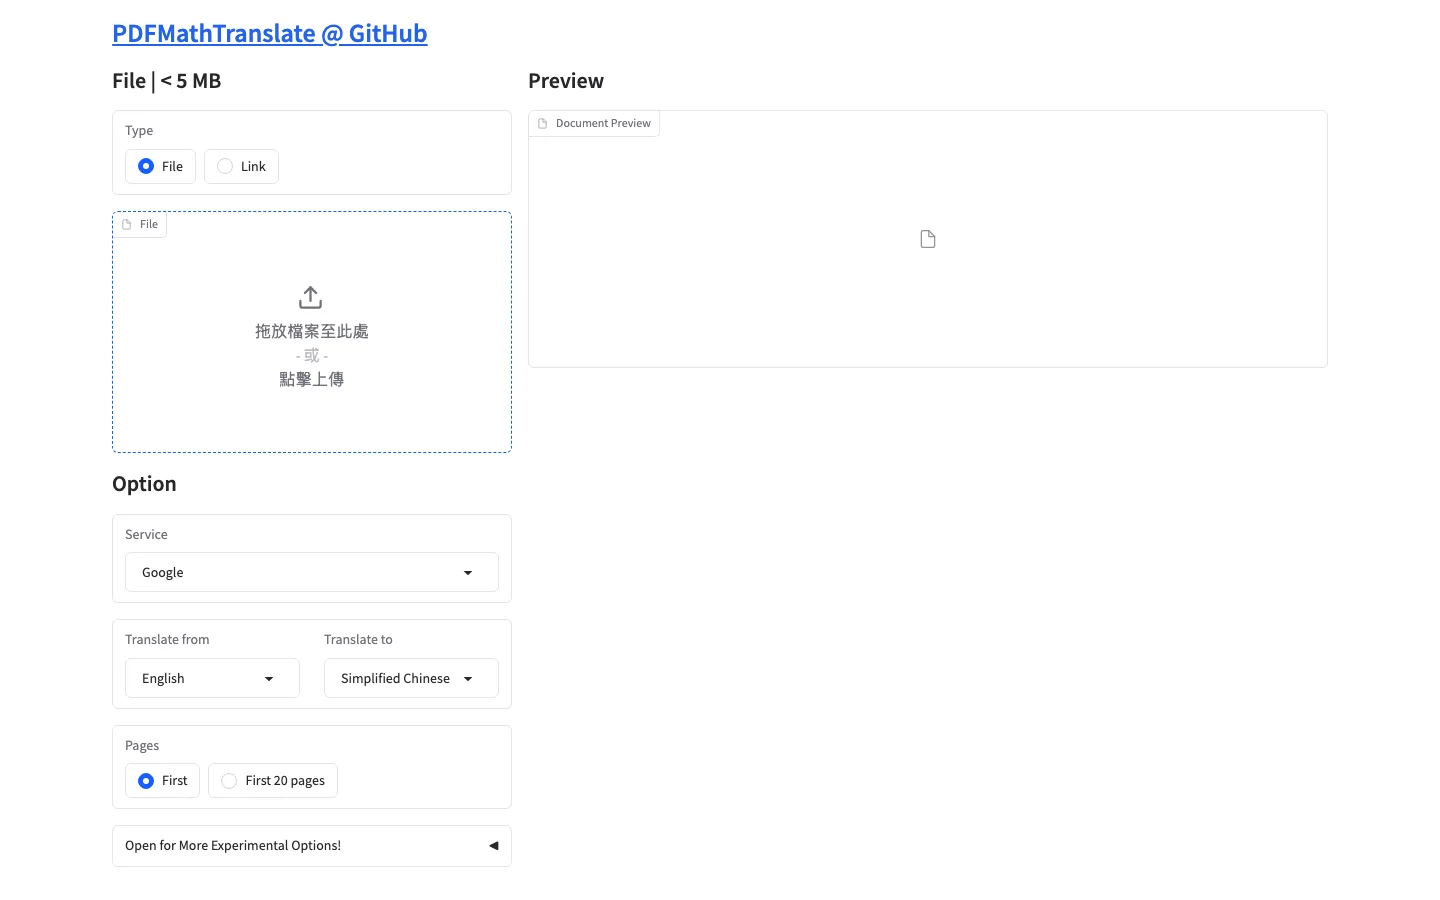
我用同一篇論文實測了上傳流程。檔案拖進去、按下翻譯,網頁顯示的佇列狀態是第十一順位,四分鐘後再看,仍然是第十一順位,隊伍沒有前進。免費公共實例就是這樣:尖峰時段就是得等。我沒有繼續等下去,但「急著要的文件別指望官網」這個結論已經足夠清楚了。
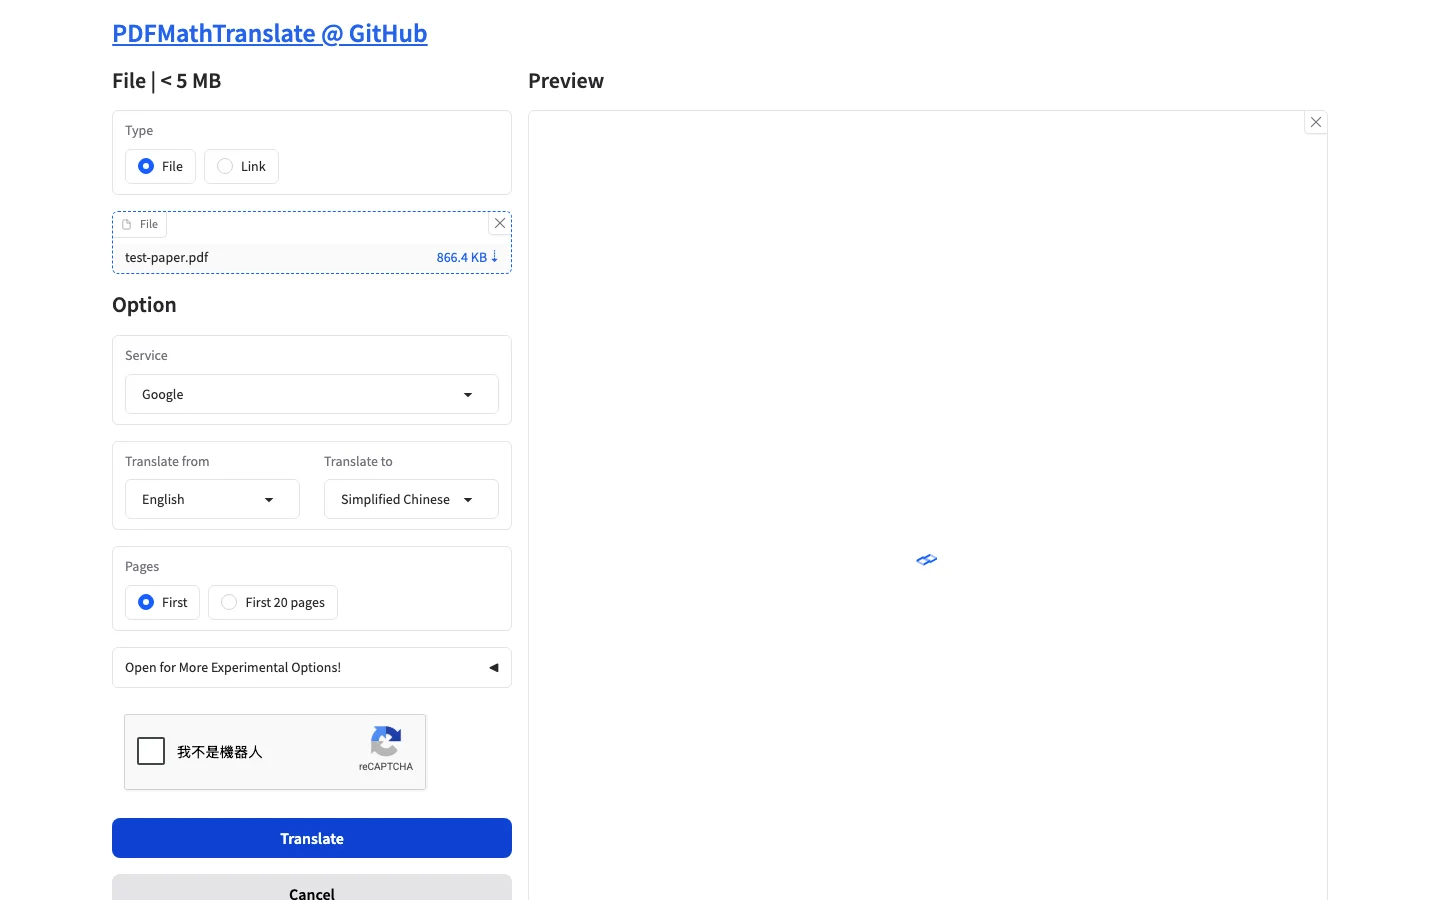
另外兩個從網路紀錄看到的事實值得知道。第一,你的 PDF 是整檔上傳到伺服器處理的(上傳請求明確出現在紀錄裡),這與本機版「檔案不出門、只有文字段落送翻譯服務」的資料流向完全不同,機敏論文要考慮這一點。第二,頁面載入了 Cloudflare 的連線統計與 Google 的驗證碼腳本,沒有廣告、沒有帳號系統,但「站方完全不知道你來過」這種事在任何網頁服務上都不成立。順帶一提,官網跑的版本是 1.9.6,比安裝包更舊,所以官網能用的功能不代表新版行為,反之亦然。
度過前面兩道關之後,工具本體的使用出乎意料地簡單。基本指令就一句:
pdf2zh paper.pdf -li en -lo zh-tw -s bing -p 1-3這會翻第一到第三頁(-p 可以指定頁碼範圍),來源語言英文、目標語言繁體中文,用 Bing 服務。依官方文件的說明,跑完之後目前目錄會出現兩個檔案:paper-mono.pdf 是純繁中譯文,paper-dual.pdf 是逐頁原文譯文對照的雙語版,排版、公式、圖表位置照原樣。雙語對照檔是為精讀設計的那個:讀到譯文拿不準的段落,抬頭就是原文。
幾個值得知道的細節。目標語言的代碼要照翻譯服務的慣例填,繁中是 zh-tw,Bing 在我這次的實測裡繁中輸出正常。版面分析用的偵測模型與內建字型第一次執行會自動下載,在我的機器上合計佔了約 81MB 的快取空間,其中附了一套繁中宋體字型,譯文排版走內建字型,不依賴讀者機器有沒有裝中文字型,雙語檔因此不容易缺字。翻譯結果存在本機的快取資料庫,同一個段落重跑不會再打一次翻譯服務,想強制重翻有對應的參數。懶得記參數的人可以跑圖形介面(pdf2zh -i),瀏覽器會打開本機的網頁操作畫面;要一次處理整個資料夾的論文,加 –dir 參數就能批次跑。
它的能力範圍不只指令列:官方文件還列了 Docker 部署、給 Zotero 文獻管理器用的第三方外掛、以及把它當 MCP 工具伺服器接給 AI 助手用的模式。這幾條路我這次沒有實測,需要的人照官方文件走即可。
用起來一句指令的背後,有兩件它做得比多數同類工具徹底的事,值得在選工具時拿出來比較。
第一是公式與排版的保留。它對每一頁先做版面元素偵測,把文字段落、公式、圖表、表格各自標記出來,翻譯只動文字,其他元素原位不動,譯文再以補丁的方式貼進原版面。這就是「論文翻譯」與「把 PDF 文字抽出來翻」的差別:後者會把雙欄排版、行內公式、表格全部絞碎。這套流程也正是它那篇 EMNLP 2025 展示論文的主題,學術會議展示軌的背書在開源工具裡不算常見。
第二是引擎可替換。翻譯品質的好壞可以透過換服務解決,版面處理才是它不可替換的部分,這個分工讓它不會因為某家翻譯服務漲價或限流而整個失效。TechMoon 先前介紹過的 BabelDOC 就是從這個專案獨立出去的翻譯引擎,兩者現在是「引擎與前端」的姊妹關係,要自架引擎層的人可以讀那篇。
Python 版本限定 3.11 或 3.12,3.13 裝不起來,這在安裝前就要確認。PyPI 版本停在 2025 年 7 月,依賴爆炸的修復要先自己處理(前面給過兩行解法),或者等上游發下一版安裝包。免金鑰翻譯兩條路各有配額風險,長文件建議自備翻譯服務金鑰或本機模型。掃描版的圖片式 PDF 沒有文字層,這類工具都幫不上,它有一個標 OCR 的實驗功能但我沒有實測,需要的人自己驗證。授權是 AGPL-3.0,自己用、幫同事裝都沒有問題,但把它包進對外提供使用的網路服務(不論收費與否),依這條款就有以同授權開放對應原始碼的義務,這是比 MIT 嚴格許多的條款,商業整合前值得讓法務看過。
整體判斷:如果你固定要讀英文論文、願意花十分鐘做一次性設定,本機版是值得的,尤其雙語對照檔對精讀的幫助很大;如果只是偶爾一兩頁,官網免費版等一下也無妨;機敏文件則一律走本機,把翻譯服務指向自己信任的對象。安裝那道關看起來嚇人,但兩行指令就能度過,不該因此錯過它真正擅長的事。
TechMoon 寫過幾個翻譯相關工具,位置剛好錯開。讀網頁與電子書的即時雙語,看 FluentRead 與 Read Frog;要自架一個通用翻譯 API 給各種軟體呼叫,看 LibreTranslate 或 MTranServer;PDFMathTranslate 的位置是「學術論文 PDF 專用」,靠版面偵測做出別的工具做不了的排版保留。論文讀者的工作流裡,它與前述工具是互補而不是互斥。