TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

騰訊 Hy Frontier 團隊的 Terminal-RSI 論文把終端機代理四項 Terminal-Bench 測試的平均成功率從 20.68% 推到 50.58%,權重以 Apache 2.0 開源。論文與模型卡顯示:模型自己產生並重寫驗證過的成功紀錄,但任務池、驗證器、獎勵與檢查點挑選都由研究者設計,「零人類介入」是貼文用語,論文全文沒有這個說法。
用 AI 摘要這篇文章:
11 月 8 日下午(台北時間),X 帳號 Superman 貼出一段話,大意是:中國破解了遞迴自我改進,騰訊丟出一個 27B 模型,它會自己改寫、重新訓練、自我精煉,全程「零人類介入」。這則貼文把一份 10 月 15 日就送上 arXiv 的論文,重新包裝成 AI 已經能無人自我進化的證據,開始在社群流傳。
把貼文對回原始材料,結論可以先講:Terminal-RSI 確實讓模型自己產生並重寫訓練資料,四項 Terminal-Bench 測試的平均成功率也真的從 20.68% 一路推到 50.58%,權重以 Apache 2.0 開源,任何人都能下載。但「零人類介入」這個說法在論文全文裡一次都沒有出現:3,000 題的任務池、判定成敗的驗證器、兩種獎勵公式、每個階段的學習率,以及最後保留哪個檢查點,全部由研究者設計與執行。它是一套把「自我改進」做成可核對步驟的訓練配方,離無人自主進化還有明確距離。
這篇論文的九位作者中,七位隸屬騰訊 Hy Frontier(其中三人同時掛馬里蘭大學、喬治亞大學與印第安納大學),未掛騰訊的兩位都在新加坡國立大學,通訊作者是新加坡國立大學的 Shuicheng Yan。模型卡把出處寫成「Terminal-RSI 專案」,論文裡騰訊只出現在作者隸屬欄,沒有把它定位為騰訊的產品線模型,底座則是阿里巴巴的 Qwen3.8-27B。「騰訊釋出」是從作者隸屬推導的說法,截至 11 月 9 日,騰訊官方帳號也沒有對這個專案的任何公告。
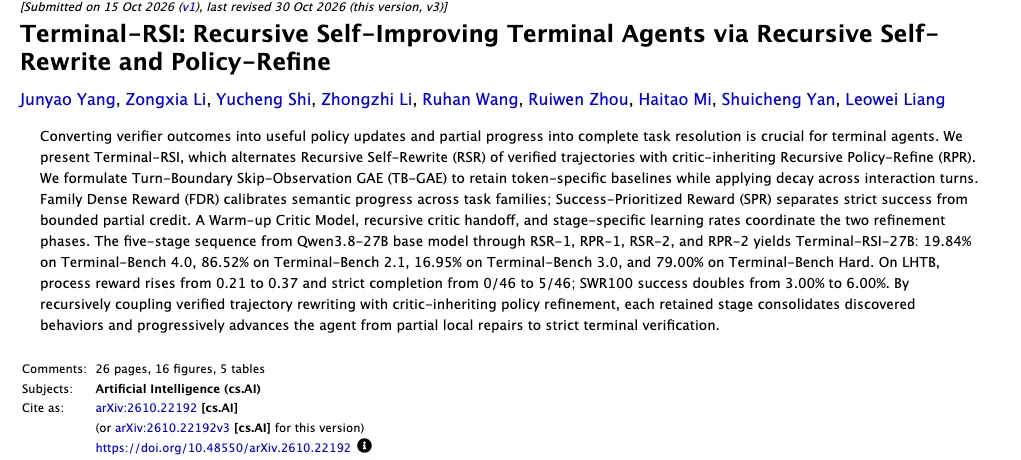
時間軸可以對得很整齊:GitHub 儲存庫 10 月 13 日建立,論文 v1 在 10 月 15 日送上 arXiv(26 頁、16 張圖),Hugging Face 模型卡 10 月 21 日更新,10 月 25 日與 10 月 30 日各改了一版,最終的 v3 就是現在公開的版本。換句話說,這份研究已經完整公開三週多,病毒式擴散發生在 v3 定稿之後第九天,貼文沒有揭露任何論文以外的新資訊,改變的只有包裝方式。
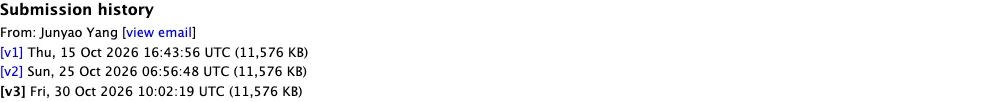
「zero human in the loop」是貼文的用詞。論文 v3 全文裡,zero human、human in the loop 與 human-in-the-loop,任何一種拼法一次都沒有出現。論文對流程的實際描述是:研究者先準備好 3,000 題的終端機任務池,其中 2,400 題附有語意驗證器、600 題是補充任務;模型在幾種代理框架下嘗試任務,只有通過驗證器的成功紀錄會被保留,後續所有訓練都繞著這些「有官方答案可對」的資料打轉。
在資料處理端,論文設計了三個角色接力:規劃角色把成功紀錄改寫成操作手冊,審查角色只看公開任務與手冊、專門檢查有沒有洩漏驗證答案,執行角色再拿到全新的沙箱照手冊重跑一次,重跑也通過驗證的紀錄才會成為訓練資料。這套設計很講究,但它示範的正好是「人怎麼把模型的自由探索收斂成乾淨資料」,與無人介入是相反方向的證據。而且自我改寫並非這篇論文的原創:部分相同作者的前作(10 月 2 日送上 arXiv)已經用單一 Qwen-3.8-27B 在約 3,000 個自建終端機任務裡找出成功解法,三種代理框架合計解出 759 題,Terminal-RSI 是把那套資料方法接上強化學習的延伸。
獎勵與訓練設定同樣是人定的。論文設計了兩種獎勵:家族密集獎勵把各任務家族的部分進度換算成分數,成功優先獎勵則把嚴格成功排在部分進度之前,避免失敗紀錄拿到過高分數。第二輪強化學習的 actor 學習率被降到第一輪的五分之一(5e-7 降到 1e-7),論文的理由是避免模型被突然的大幅改動傷到。這些是需要判斷力的工程決策,每換一組設定,結果就可能長得完全不同。
先說任務形態。終端機代理是在命令列環境裡工作的 AI:檢查一個程式庫、修好壞掉的依賴、執行指令,然後讓驗證程式檢查環境的最終狀態。這類任務沒有僥倖空間,計畫寫得再流暢,環境沒有被真正修好就是失敗,這也是論文堅持用「受保護的驗證器」當成敗裁判的原因。
Terminal-RSI 的核心是兩種步驟交替。自我改寫(Recursive Self-Rewrite,RSR)做的是「把模型自己的成功經驗變成教材」:蒐集通過驗證的終端機操作紀錄,改寫成手冊,篩掉洩漏與不相容的內容,重跑驗證後拿去做監督式微調。這一步只更新負責做決策的 actor,負責評估好壞的 critic 原封不動帶去下一階段。
重訓(Recursive Policy-Refine,RPR)接手「用強化學習繼續推」:先把繼承來的 critic 重新校準四個更新(actor 凍結),再用 PPO 同時訓練 actor 與 critic。論文另外提出跨回合的優勢估計方法(TB-GAE),讓價值估計保留在 token 層級、只在互動回合之間衰減,解決終端機任務一跑幾十回合、信用分配被稀釋的問題。
整條流程是 Base、RSR-1、RPR-1、RSR-2、RPR-2 五個階段,「遞迴」在這裡的具體意思很樸素:同一套步驟跑兩圈,上一圈保留下的模型是下一圈的起點,第二圈換上成功優先獎勵、學習率減到五分之一。最終釋出的 Terminal-RSI-27B,是第二輪重訓第 18 步的檢查點。
成績單本身相當整齊。四個 Terminal-Bench 測試集的等權平均成功率,從底座模型的 20.68% 依序走到 34.25%、44.50%、48.75%,到第五階段的 50.58%。這個平均只把四個 Terminal-Bench 測試集等權相加,不含 LHTB 與 SWR100,也不按任務數加權,引用時口徑要跟著寫清楚。
| 階段 | 四測平均 | Terminal-Bench 2.1 | Terminal-Bench 3.0 | Terminal-Bench 4.0 | Terminal-Bench Hard |
|---|---|---|---|---|---|
| Base(Qwen3.8-27B) | 20.68% | 51.70% | 0.00% | 0.00% | 31.00% |
| RSR-1 | 34.25% | 70.10% | 6.80% | 6.10% | 54.00% |
| RPR-1(第 20 步) | 44.50% | 77.53% | 14.29% | 16.67% | 69.50% |
| RSR-2 | 48.75% | 86.52% | 15.00% | 17.46% | 76.00% |
| Terminal-RSI-27B(RPR-2 第 18 步) | 50.58% | 86.52% | 16.95% | 19.84% | 79.00% |
兩個長程測試也一起報告:LHTB 考的是依賴鏈拉得很長的修復任務,嚴格完成題數從 0 題變 5 題(滿分 46 題,過程獎勵 0.21 升到 0.37);科學工作流重建測試 SWR100 的成功率從 3.00% 翻倍到 6.00%,而且從第一輪重訓之後就停在 6.00% 不再變動。SWR100 與訓練題庫沒有任何重疊,是最接近「出題範圍外」的證據,6% 這個數字連同它的停滯,一起勾勒出這套配方目前的邊界。
每個數字都綁著條件。評測是三次獨立推論的平均(Mean@3),設定為溫度 0.60、每回合最多生成 8,192 個 token、每次呼叫最多 96,000 個輸入 token、明確思考模式關閉。模型卡特別提醒:這些成績依賴特定的代理框架、工具、提示詞與時間預算,單獨的聊天範例無法重現代理評測。換句話說,把權重載下來接上自己的框架,數字不會自動對上。
與前沿模型的對照更要小心。論文表列 GPT-6 Sol 在 Terminal-Bench 2.1 拿 85.40%、Kimi K3 拿 85.00%,低於 Terminal-RSI-27B 的 86.52%;在 Terminal-Bench 4.0 上它也高於 Gemini 3.8 Flash 的 19.70% 與 DeepSeek V4 Pro 的 14.60%。但論文自己寫明:這些對照分數直接引自各家官方報告,不是用同一套框架重測,而且對比是測試集特定的,GPT-6 Sol 在 4.0 上更高、Gemini 3.8 Flash 在 2.1 上更高。模型卡因為評測來源與協定尚未對齊,索性省略了外部模型比較。「超越前沿模型」只能理解成特定測試集上的特定對照。至於先改寫再重訓這個順序,論文宣稱在局部第 20 步領先直接跑 PPO 達 12.86 到 30.50 個百分點,但也標注這是該設定內的結果,兩者運算資源與評測順序並不對等。
這份論文最誠實的部分,是它把「模型會倒退」寫得很清楚。第一輪重訓如果在保留點之後繼續練到第 35 步,Terminal-Bench 4.0 會從 16.67% 掉到 11.11%,同一時間 Terminal-Bench 2.1 升到 78.95%,不同測試集之間出現明顯取捨。第二輪重訓的一般分支也一樣:第 6 步還有 17.46%,第 10 步掉到 11.11%;被保留下來的反而是成功優先獎勵的 Long-Reward 分支,第 18 步達到 19.84% 與 86.52%。兩輪重訓各自停在局部第 20 步與第 18 步,這兩個數字就是「什麼時候收手」的人為決定。
論文的圖把這件事畫了出來:藍色是被保留的路線,灰色是被捨棄的替代分支。也就是說,Terminal-RSI-27B 這個名字對應的是多次嘗試中挑出來的檢查點,挑選標準是研究者設定的。論文在限制一節也自我提醒:挑檢查點需要受保護的驗證集,如果反覆依最終測試的回饋去挑,會把學習成果與對測試集的適應混在一起。
GitHub 儲存庫(jyyang26/Terminal-RSI,10 月 13 日建立,Apache 2.0 授權)放出的是完整的重訓配方:兩輪 RPR 的啟動腳本、獎勵實作、跨回合優勢估計的程式碼,以及底層的 slime 訓練框架。這套框架不是從零寫的:它建構在 THUDM 的 slime 之上,與同批作者更早的終端代理強化學習工作 T1 共用同一套基礎設施,訓練與推論分別交給 Megatron 與 SGLang。但 README 明講,自我改寫階段的資料管線沿用前作論文,不在這次釋出範圍;對照完整檔案列表,3,000 題任務池與中間檢查點也都不在儲存庫裡。想完整重現論文,這幾塊要自己補。
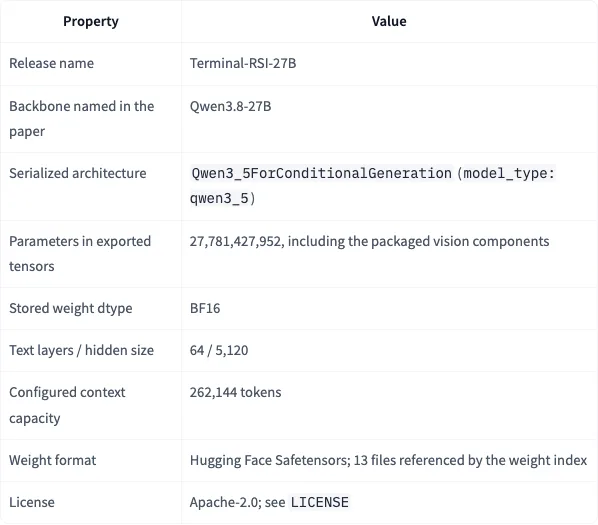
Hugging Face 上的權重(模型 ID 為 Teriminal-RSI/Terminal-RSI-27B,組織名就是這個拼法,下載時別以為連結打錯)總參數約 277.8 億、以 BF16 儲存共 55.56 GB,設定的上下文長度是 262,144 個 token,截至 11 月 9 日下載約 2,300 次。13 個權重檔中有兩個檔名帶著「missing-from-origin」字樣,模型卡特別聲明這兩個是檢查點的一部分、少一個都載不齊。模型卡還有兩句話值得先讀:封裝時沒有測過完整載入與 GPU 推論,只以 Transformers 5.17.0 檢查過設定檔載入;也沒有做新的評測或獨立安全評估。儲存庫倒是附了把訓練格式轉回 HF 格式的腳本與 SGLang 服務指令,部署路徑是通的。要拿它上生產,先在自己的框架裡跑小規模驗證是唯一穩當的路。
論文的限制一節列了四個問題,每一項都直接限制「自我改進」能推到多遠。因果歸屬上,各階段的學習率、獎勵與初始化同時改變,目前的對照沒辦法拆出進步到底來自哪個設計,作者明說還需要運算量相同的對照實驗。統計上,三次評測不能取代獨立訓練種子,也無法證明統計優勢。驗證覆蓋上,測試只能證明被檢查到的要求,論文附的 Rust 與 C 案例裡,模型第一次嘗試把運算交給 Python 處理、只用 C 介面過連結測試,通過檢查並不等於真的走原生路徑。適用範圍上,一個 27B 骨幹的五個階段,既不能建立規模定律,也不能證明每一步都會單調進步。
拿這篇論文去回答「誰在遞迴自我改進上領先」,答案會超過證據能支撐的範圍。2026 下半年這個名詞出現的頻率確實變高,但被改進的對象各不相同:Google DeepMind 的 Dream-RSI 改的是外層探索策略,模型本身零梯度零微調;智譜的報告是讓 GLM 調校自己的推論基礎設施;同月還有一個叫 DiscoveryRSI 的 27B 開源模型做科學假說生成。Terminal-RSI 屬於其中證據攤得最開的一類,論文、程式碼、權重三者互相對得上,但每一家都還在「單一模型、單一場景」的階段。
接下來值得追蹤的訊號很具體:作者會不會補上獨立訓練種子與運算量相同的對照實驗、自我改寫的資料管線與任務池會不會釋出、更大骨幹的結果會不會出現,以及騰訊官方是否把這條線收進正式產品。在那之前,把它當成一份寫得異常清楚、可以逐段核對的訓練研究來讀,收穫會比轉貼一句「零人類介入」多得多。做終端機代理或程式代理訓練的團隊,可以直接從食譜與獎勵實作省下大量試錯;只想看熱鬧的人,記住 50.58% 的前後都是研究者的手,就不會被下一則貼文帶著走。