TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
Resume Matcher 是兩萬八千顆星的開源履歷工具,2026 年 1 月整包重寫成 1.0 之後,網路上的中文教學大多還停在已封存的舊版。這篇講清楚斷代差異、現在的履歷生成工作台長什麼樣,以及安裝當天最重要的決定:AI 要走雲端 API 還是 Ollama 本地模型。出廠預設指向 OpenAI 雲端,履歷全文會不會出機器,答案是自己選的。
用 AI 摘要這篇文章:
一個累積兩萬八千顆星的開源專案,在 2025 年中把五年多的成果整包封存,然後從零重寫,這種事在開源圈並不常見。Resume Matcher 就是這個案例:儲存庫早在 2020 年 4 月就建立,2023 年以 ATS 履歷關鍵字分析工具的身份走紅,2025 年 5 月作者為舊版程式碼發出封存版,2026 年 1 月推出翻掉重寫的 1.0,到 2026 年 9 月已經迭代到 1.3。名字沒變,星數照漲,但名字底下的東西已經換過一輪。
這對台灣的求職者有兩個實際影響。最直接的:網路上流傳的 Resume Matcher 教學與介紹,有很大一部分還在講舊版,照著舊教學的指令走,拿到手的已經是另一個軟體。更深一層:重寫後的版本把「AI 在哪裡處理你的履歷」變成安裝時就要自己拿主意的問題,而它的出廠預設值,跟它在 README 裡強調的本地形象之間有一段距離。這篇把斷代史、現況功能與安裝決策講清楚。判斷來自儲存庫程式碼、發布紀錄與官方文件,我沒有實際安裝執行這套工具。
判斷自己看到的是哪一代,最可靠的是時間線。Resume Matcher 的發布紀錄是這樣走的:2023 年 8 月與 9 月各有一個 alpha 版,那一代是純 Python 專案,核心是解析履歷與職缺描述、用 FastEmbed 做向量相似度計算,算出你的履歷跟職缺的關鍵字重疊程度,再列出該補哪些詞。2025 年 5 月 26 日,作者發布了一個版本代號直接叫 0.1.2-old-resume-matcher 的封存版,發布說明寫得很直白:把舊程式碼留在這裡給想繼續用的人,指定了 old-resume-matcher-2025 這個分支(它後來也從倉庫消失,舊碼如今只剩這個發布標籤可取)。七個多月後的 2026 年 1 月 6 日,1.0 正式版上線,技術棧整個換掉,之後的版本依序以法國電子二人組的曲名命名:1.1 Voyager、1.2 Nightvision、最新的 1.3 Crescendolls(2026 年 9 月 6 日發布)。
兩代的功能面幾乎沒有交集。舊版做的是「分析與評分」:把履歷丟進去,得到關鍵字覆蓋率與補詞建議,產出的是一份體檢報告。新版做的是「生成與編輯」:上傳一份母版履歷(PDF 或 DOCX 都吃),貼上目標職缺描述,AI 生成針對該職缺調整過的履歷草稿、求職信,還能產生以你履歷內容為本的面試準備題,最後用四種內建模板把成品排成 PDF 匯出。舊版告訴你哪裡不合格,新版直接把改好的版本做出來讓你編。
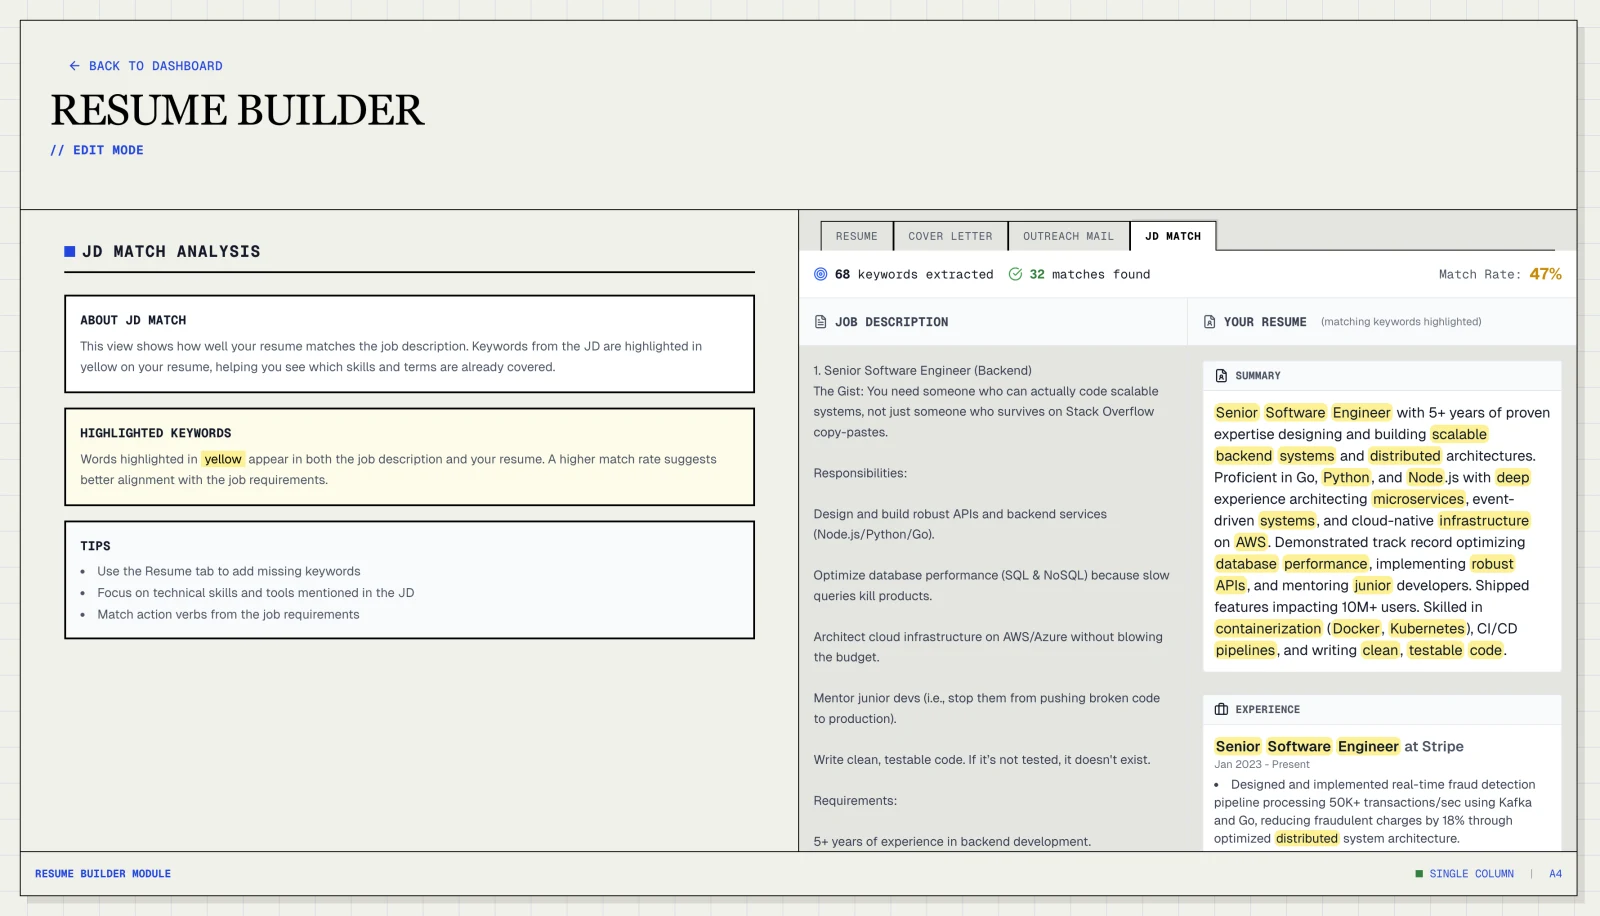
這條斷代線對中文讀者特別有用。搜尋 Resume Matcher 教學,排在前面的大量內容還在描述 FastEmbed、向量相似度、用 Python 指令跑分析那套流程,這些都是舊版的特徵。看到這幾個關鍵字,那份教學對應的就是舊版,跟你從主要分支裝到的 1.3 不是同一個軟體。判斷版本還有一個更快的辦法:新版安裝需要 Node.js 22 以上與 Python 3.13 以上兩套環境,任何只教 Python 的安裝指引,講的都是舊版。
重寫後的架構分成前後兩段:後端是 FastAPI 加上 LiteLLM 這個多模型路由層,前端是 Next.js 16 加 React 19,資料存在單一 SQLite 檔案裡,PDF 排版交給無頭瀏覽器處理。官方同時提供 Docker 映像,在 ghcr.io 與 Docker Hub 都有,一個容器就把前後端包完,開一個 3000 埠就能用,映像同時支援 Intel 與 Apple 晶片的 Mac,對不想分開裝兩套環境的人是阻力最小的路。
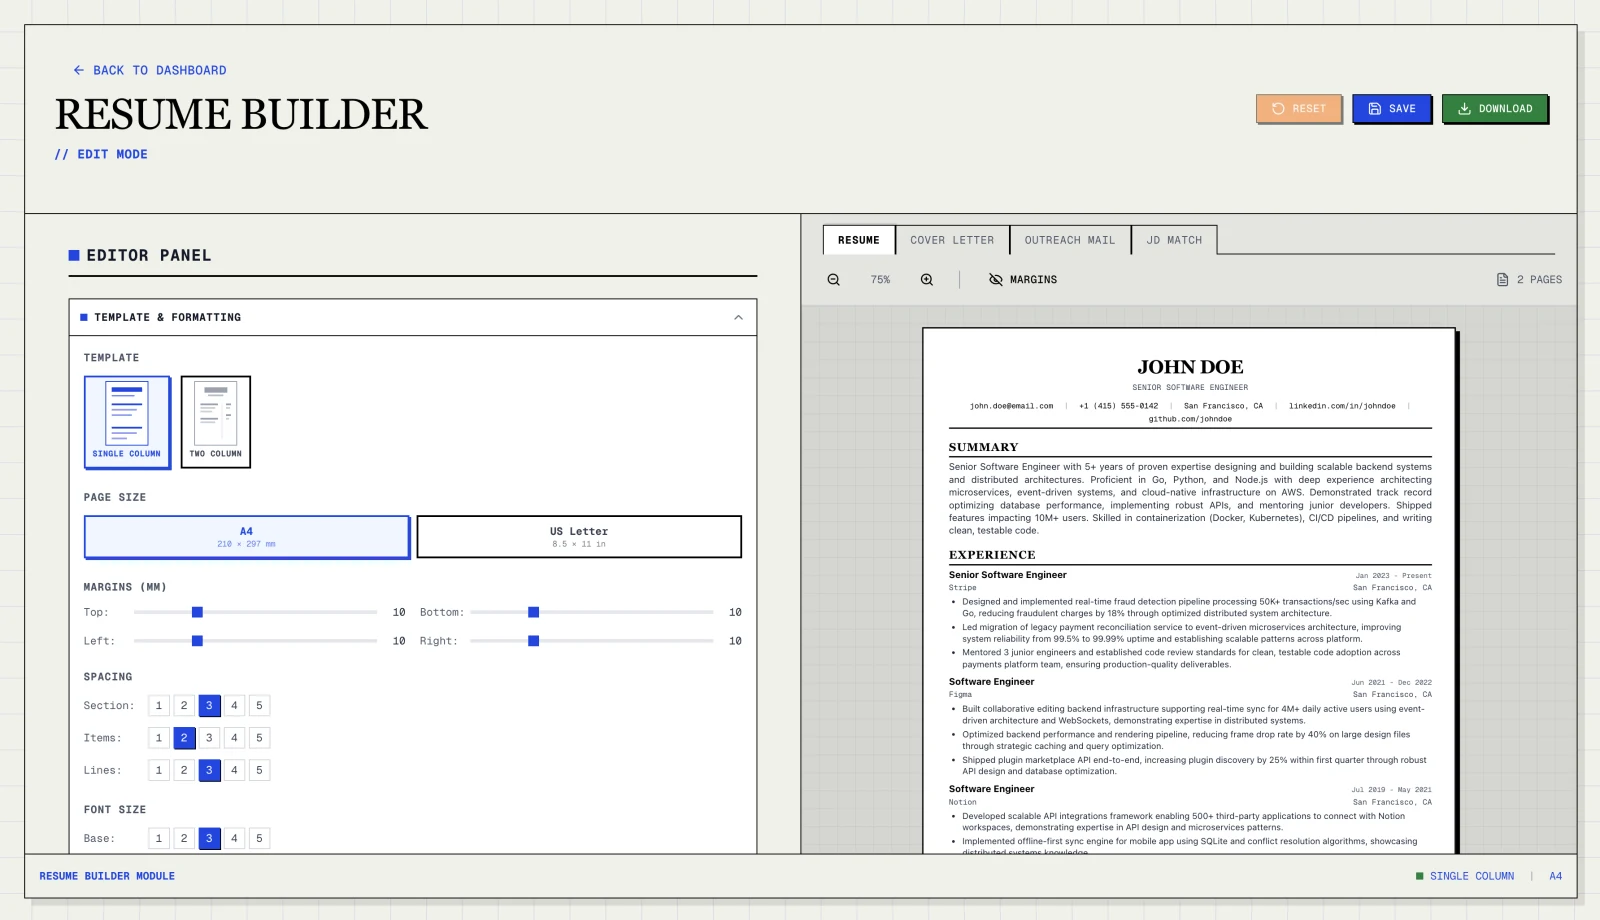
實際的工作流程是這樣設計的:先建立一份涵蓋全部經歷的母版履歷,之後每投一個職缺,就貼上那個職缺的描述,讓 AI 以母版為素材產出一份調整過的履歷。生成結果不是終點而是起點:你可以逐條修改 AI 建議的內容、增刪段落、用拖曳調整區塊順序,四種模板(傳統單欄、現代單欄、傳統雙欄、現代雙欄)決定最終排版,匯出成 PDF。求職信在同一條流程線上生成,可以指定輸出語言,所以繁體中文的求職信也做得出來。
工具裡還有一個容易被忽略的申請狀態追蹤。每個職缺可以標記成已保存、已投遞、無下文、有答覆、面試、錄取或拒絕七種狀態,這個清單是寫進資料庫結構裡的正式欄位,不是陽春的備註。換句話說,它的企圖不止於「幫你改一份履歷」,而是把求職週期從投遞到面試的進度一起管理。
介面提供英文、西班牙文、簡體中文、日文與巴西葡萄牙文五種語言,沒有繁體中文。操作介面得看簡體或英文,這點先有心理準備。
對履歷這種隱私密度極高的文件,「AI 處理發生在哪」幾乎是選工具的第一問。Resume Matcher 在這件事上的設計是:不替你決定,給你九個供應商選項。OpenAI、Anthropic、Google Gemini、DeepSeek、Groq、Azure Foundry、OpenRouter 這七個走雲端;另外兩個走本地,一個是 Ollama,另一個是任何相容 OpenAI 介面的自架伺服器,包括 llama.cpp、vLLM 與 LM Studio。選本地方案的人,履歷全文從解析、改寫到求職信生成,每一個步驟都不離開自己的機器。
雲端七家的意義也不一樣。前六家各有預設搭配的模型,OpenRouter 則是一個聚合層,一組金鑰能換用多家模型,對「想比較不同模型改履歷的效果」的人是捷徑。清單裡出現 DeepSeek 與 Groq 也說明了它的取樣:這份工具的預設讀者是捨得為了便宜與速度組合各種 API 的進階使用者,而不是打開網頁就走的族群。
但有個細節值得攤開:出廠預設值是 OpenAI 的 gpt-5-nano,一個雲端模型。安裝範本裡的 Ollama 與 llama.cpp 路線全部以註解形式存在,要自己動手切換。也就是說,本地處理是這個工具刻意提供的能力,卻不是它的起手狀態。一個照著快速開始指引走完、金鑰一填就開始用的人,履歷全文每一個版本都送進了 OpenAI 的伺服器。GitHub 儲存庫描述裡「100 多個 LLM」的說法也屬於作者宣稱的行銷口徑:程式裡實際定義的供應商欄位是九個,一百這個數字指的是 LiteLLM 這個路由層理論上支援的模型面。
選本地方案要有的心理準備是速度。後端對 AI 操作的逾時預設是 240 秒,程式註解明白寫著本地模型常需要更長時間,還引用了一個使用者只改後端逾時卻沒生效的 issue 編號作為教訓:逾時上限要後端與前端兩層一起調,只改一邊會安靜地失敗,允許的調整區間是 30 到 1800 秒。實際要等多久,只有裝了本地模型的人知道,這裡給不出數字。
金鑰的處理倒是比多數自架工具細緻。API 金鑰在執行時以加密形式寫進 SQLite 資料庫,不在設定檔裡留明文;把金鑰寫進應用程式設定檔的人,程式啟動時會自動把它搬進加密庫,然後把設定檔裡的明文清掉;環境變數檔裡的金鑰則會留在原檔不動。多數自架 AI 工具的金鑰是明文躺在 .env 裡,這個設計在同期工具裡算少見的仔細。
資料層的全部內容,包括母版履歷、每次調整的版本、職缺描述、申請狀態,都在本機單一 SQLite 檔案裡,這是從資料庫程式碼直接可見的事實。我把前後端全部程式碼掃過一遍,沒有找到任何遙測、錯誤追蹤或行為分析套件,連一個對外的統計端點都沒有。這在 2026 年的 AI 工具圈算得上乾淨:資料庫裡的東西就是全部的東西,備份與搬家就是處理那個檔案,但記得連同同目錄的金鑰檔一起帶走,否則搬到新機器後 API 金鑰要重新填一次。
文件落後於程式碼的現象倒是自家的好例子。README 的技術棧表格寫著資料儲存用 TinyDB 這個 JSON 檔案資料庫,但資料庫模組的說明文字開頭就寫著這是一個「保留原本 TinyDB 包裝行為的替代品」,真正的儲存早已換成 SQLite,TinyDB 只剩搬移舊資料的用途。連兩萬八千顆星、四天前還在提交程式碼的活躍專案都會這樣,一般讀者更沒有理由把任何一份第三方介紹當成現況,看介紹文先看它寫下的日期,再決定要信幾分。
順帶一提它的授權與財務模式:Apache-2.0 授權,商用與修改都沒有額外條款負擔;專案靠 GitHub 贊助、請作者喝咖啡與企業贊助維持,贊助區還掛著 Vercel 開源計畫的標章,網站上沒有任何付費解鎖或託管升級的入口。開源歸開源,作者的維運動力寫在 README 第一屏的募資呼籲裡,這種模式的長期節奏取決於贊助收入,使用者社群的活躍度(九十天內兩百多次提交、開放的 issue 與功能請求持續有人處理)目前看不出疲態。
從原始碼安裝是完整路線:Python 3.13、Node.js 22、uv 套件管理器三個前置,後端與前端分開啟動,適合想改程式或跟著主要分支更新的人。Docker 是折衷路線:一行指令把容器跑起來,版本可以鎖在特定 tag 上避免自動更新帶來的意外,適合只想要一個穩定可用版本、不想碰開發環境的人。第三條路與安裝方式無關,是裝完之後的選擇:填一組雲端 API 金鑰最快開始,代價是履歷全文出機器;裝 Ollama 拉一個本地模型最隱私,代價是硬體門檻與等待時間,入門等級的本地模型跑得動,但生成一份完整履歷的時間會明顯長於雲端,這點在選擇前要有預期。
三條路沒有優劣,只有對應。你的履歷如果包含現職公司的專案細節、客戶名單或未公開產品資訊,那已經超出隱私偏好,是職業風險問題,本地方案的麻煩是值得付的價格。如果你投的是一般職缺、履歷內容本來就會公開貼在求職平台,雲端模型的生成品質與速度優勢就實際得多,gpt-5-nano 這種等級的模型用量花費也在多數人可負擔的範圍。
安裝流程的順暢度、AI 生成的履歷品質、本地模型的實際速度,都在我親自跑過的範圍外,判斷只建立在程式碼結構與官方文件上。工具形態也是一道現實:官網是文件與宣傳站,沒有定價頁、沒有登入、沒有試用方案,想用就得自己裝,這道門檻不會消失,期待打開網頁就能用的人,這個工具從第一步就不適合。時間本身就是變數:從 1.0 到 1.3 只花了八個月,功能與介面持續變動,任何具體到按鈕位置的描述都有保存期限。
另外要分清楚的是行銷語與功能的距離。官網標題還掛著 ATS 掃描器的舊定位,內文用「打敗 ATS」「被演算法設計來拒絕你」這類訴求包裝,但工具實際做的是關鍵字比對與 AI 改寫建議,它從來不是、也沒有宣稱自己是任何真實 ATS 系統的模擬器。把 AI 生成的關鍵字覆蓋率當成錄取機率的保證,是讀者要自己避開的誤區:篩選系統每家做法不同,通用工具只能對「職缺描述裡明寫的需求」負責,對「某家公司系統的內部規則」誰都無法負責。
如果讀完的結論是「我不想自架」,站上有現成的替代路線。想要打開瀏覽器就編輯的,Magic Resume 是開源的線上履歷編輯器,編輯在本地端完成,匯出前要注意檔案去向;ResumeToJob 走純瀏覽器路線,履歷不出瀏覽器就能匯出 PDF;Self.so 把履歷變成個人網站,上傳 PDF 之前要先看清資料流向;UP簡歷 則是商業平台的免費邊界實測案例。求職流程更前端的自動化,還有開源的牛人快跑 GeekGeekRun 可以參考。這幾篇各自的邊界都實測過,跟 Resume Matcher 的自架路線是互補而非重複:前者答覆「哪個現成工具適合我」,這篇答覆「我願意為隱私與控制權付出多少安裝成本」。
總結成一句話:Resume Matcher 值得裝的場景很明確,你有一些履歷內容不方便交給雲端、願意花一個下午架 Docker 或跑安裝腳本,並且記得在第一次生成之前,先到設定裡把 AI 供應商從預設的雲端換成本地。做到這三件事,它大概是 2026 年把履歷隱私與 AI 生成力同時拿到手的少數選項之一;做不到,先從上面的現成工具開始,負擔小得多。