TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

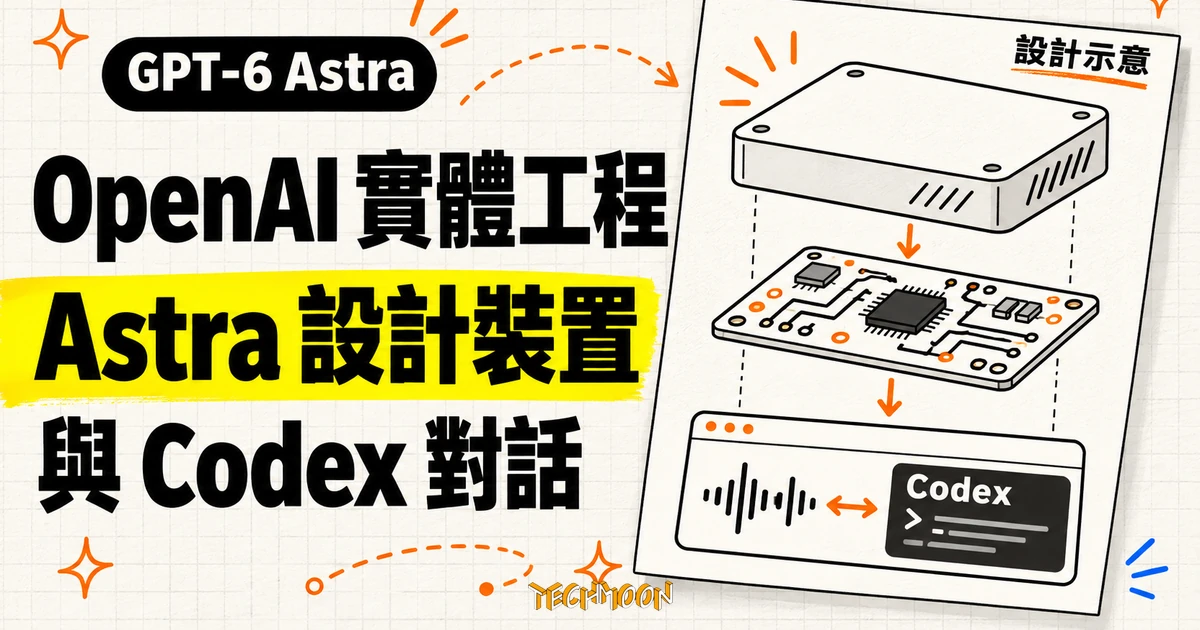
OpenAI 於 2026 年 11 月 3 日公布實體工程進展:兩位成員與 GPT-6 Astra 在一週內完成可與 Codex 對話的測試裝置設計,委外廠商一個月內做出小批原型;BenchCAD 2.0 評測中較新的內部模型平均 0.875 分、GPT-6 Astra 最高推理設定 0.594 分,另擴大 Chip Ganassi Racing 合作、新增 Mazda 研究合作。量產仍需多輪公差與組裝審查,0.875 也仍是尚未對外供應的內部模型自測成績。
用 AI 摘要這篇文章:
OpenAI 在 2026 年 11 月 3 日發布實體工程進展,官方 X 帳號同日稍晚貼出搭配影片的進展貼文(台北時間 11 月 4 日凌晨 2 點 56 分)。文章涵蓋的範圍橫跨機械工程、電子工程到整機系統設計,也包含內部團隊與產業合作夥伴的實際使用。這次公布會被引用最多的是兩個數字:一週,還有 0.875。前者指兩位 OpenAI 成員和 GPT-6 Astra 在一週內完成一台測試裝置的設計;後者是一個內部模型在 BenchCAD 2.0 工程基準上的平均分數。
先把判斷講完。這兩個數字各自帶著 OpenAI 親手寫下的但書:一週完成的是設計迭代,量產前的公差與組裝審查一輪都沒有少;0.875 是自家內部模型的自測成績,沒有名稱、沒有供應時程,而基準方十月的公開量測裡,所有排上榜的模型都停在 0.59 這一關。對工程團隊真正可用的訊號是:模型已經接手工程檔案之間的反覆修改,可製造性的判斷仍然留在人類工程師手上。
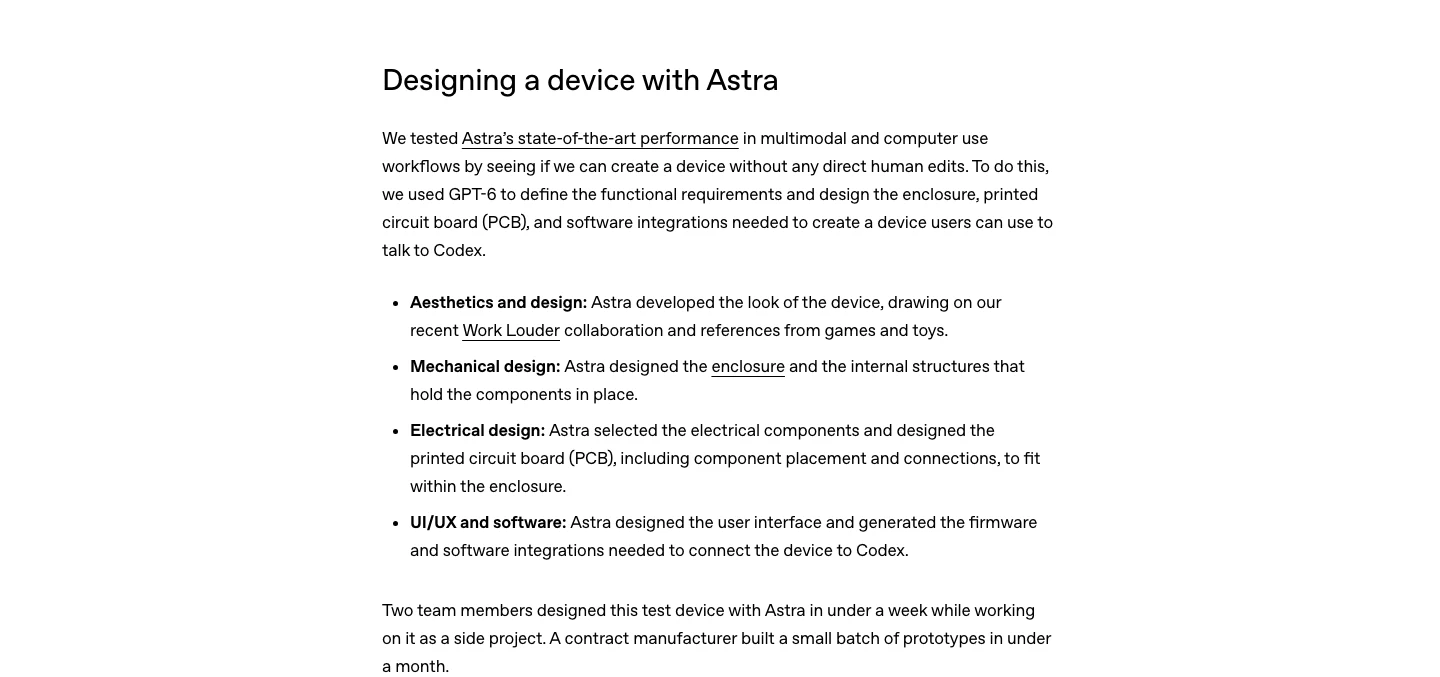
這次的主角是一台測試裝置:使用者拿著它,就能和 OpenAI 的開發代理 Codex 說話。官方在文章裡寫得很直接,他們用 GPT-6 定義功能需求,並設計外殼、電路板與軟體整合,實驗條件是沒有任何直接的人工編輯。條列各設計層面時,文章的主詞都是 Astra:外觀借鑑 OpenAI 與 Work Louder 的 Codex Micro 合作以及遊戲、玩具的參考;機構部分包含外殼與固定零件的內部結構;電子部分由 Astra 挑選零件、設計電路板的佈局與連線,好塞進外殼空間;軟體部分則是使用者介面,加上把裝置接上 Codex 的韌體與軟體整合。
值得注意的是這四個層面彼此牽動的方式。電路板是為了塞進外殼而設計的,接頭位置與板子大小直接受限於機構決定;介面與韌體又得配合電子端的選料。這種跨領域的彼此約束,正是硬體設計最花溝通成本的地方,也是這次展示真正挑戰的題目:模型能不能在改一處時,還記得其他三處的限制。官方沒有公布設計過程中來回了多少輪對話,這個數字外界看不到。
兩位成員把這個案子當成工作之餘的 side project,一週內完成設計;接著由委外製造商在一個月內做出一小批原型。這兩個時間各有分工,引用時不能互換:一週對應設計,一個月對應製造。官方對裝置的定位也寫得明白,它是測試原型,沒有售價、沒有購買頁,文章裡不存在任何上市時程。
一週完成設計聽起來像宣告工程師失業,但官方在同一篇文章裡自己補上了邊界:讓裝置可以量產,仍需要好幾輪審查與迭代,而 Astra 並沒有穩定考慮製造商的產線限制、公差與組裝需要的細節。公差白話講,就是成品尺寸可以接受的誤差範圍;兩片外殼要留得出接合間隙,螺絲要留得出工具伸進去的位置,這些條件圖面上看不出來,打樣與回饋才會現形。官方也把這些缺口定位成未來模型的改進線索,等於自己承認:設計生成與可製造性之間,還有一段要補的工程。
所以一週這個數字要正確地讀:被壓縮的是探索配置與重複改圖的時間,而不是交付文件與審查流程。而且這些審查的每一輪都是工程師的時間,省下來的設計時間有多少會被審查吃回去,官方沒有給出數字,這個缺口在導入評估時要自己補量。OpenAI 至少把「模型在可製造性上不穩定」寫進了展示文的同一篇裡,這比只放一段漂亮渲染影片的展示誠實。同一個弱點在第三方基準的失分模式裡也看得到,下面把 0.875 的脈絡一起攤開。
BenchCAD 2.0 是 BenchCAD 團隊在 2026 年 10 月 12 日發布的工程基準,官方定位是「需要硬體工程專業的 3D 建模基準」,測的是兩件事:模型能不能從工程圖或渲染圖重建 3D 零件與組件,能不能從電路板的組裝渲染圖找回接線關係。它的引用題名寫的是 Benchmarking Programmatic CAD on Real Engineering Work,模型以寫程式的方式產出 CAD,工程師拿到的是可以參數化修改的模型,不是一張只供觀看的渲染圖。這和實體世界裡測機器人任務成功率的模擬基準走的是不同路線:一個量工程檔的正確性,一個量動作的完成率。
六類任務值得展開看,因為它們對應的是真實工程現場的不同工作。圖面建模給模型一張標註尺寸的零件圖,要產出 CAD 零件;有兩類組裝題,一類把每個零件的 3D 檔和組裝圖都給齊,只要模型裝得對,另一類只給部分零件的圖面,模型得先把缺的零件建出來再組裝;逆向工程也分零件與組件兩級,前者給四個渲染視圖要重建零件,後者連整機帶各零件的視圖都要還原;電路題則是給六張組裝完成的電路板渲染圖,要產出整張接線圖。每一類分開計分,不用 LLM 當評審,直接比對模型輸出與參考答案;從基準方附錄看,評測讓模型在每個案例上最多可以跑三十輪,跑完還沒交卷就記零分。
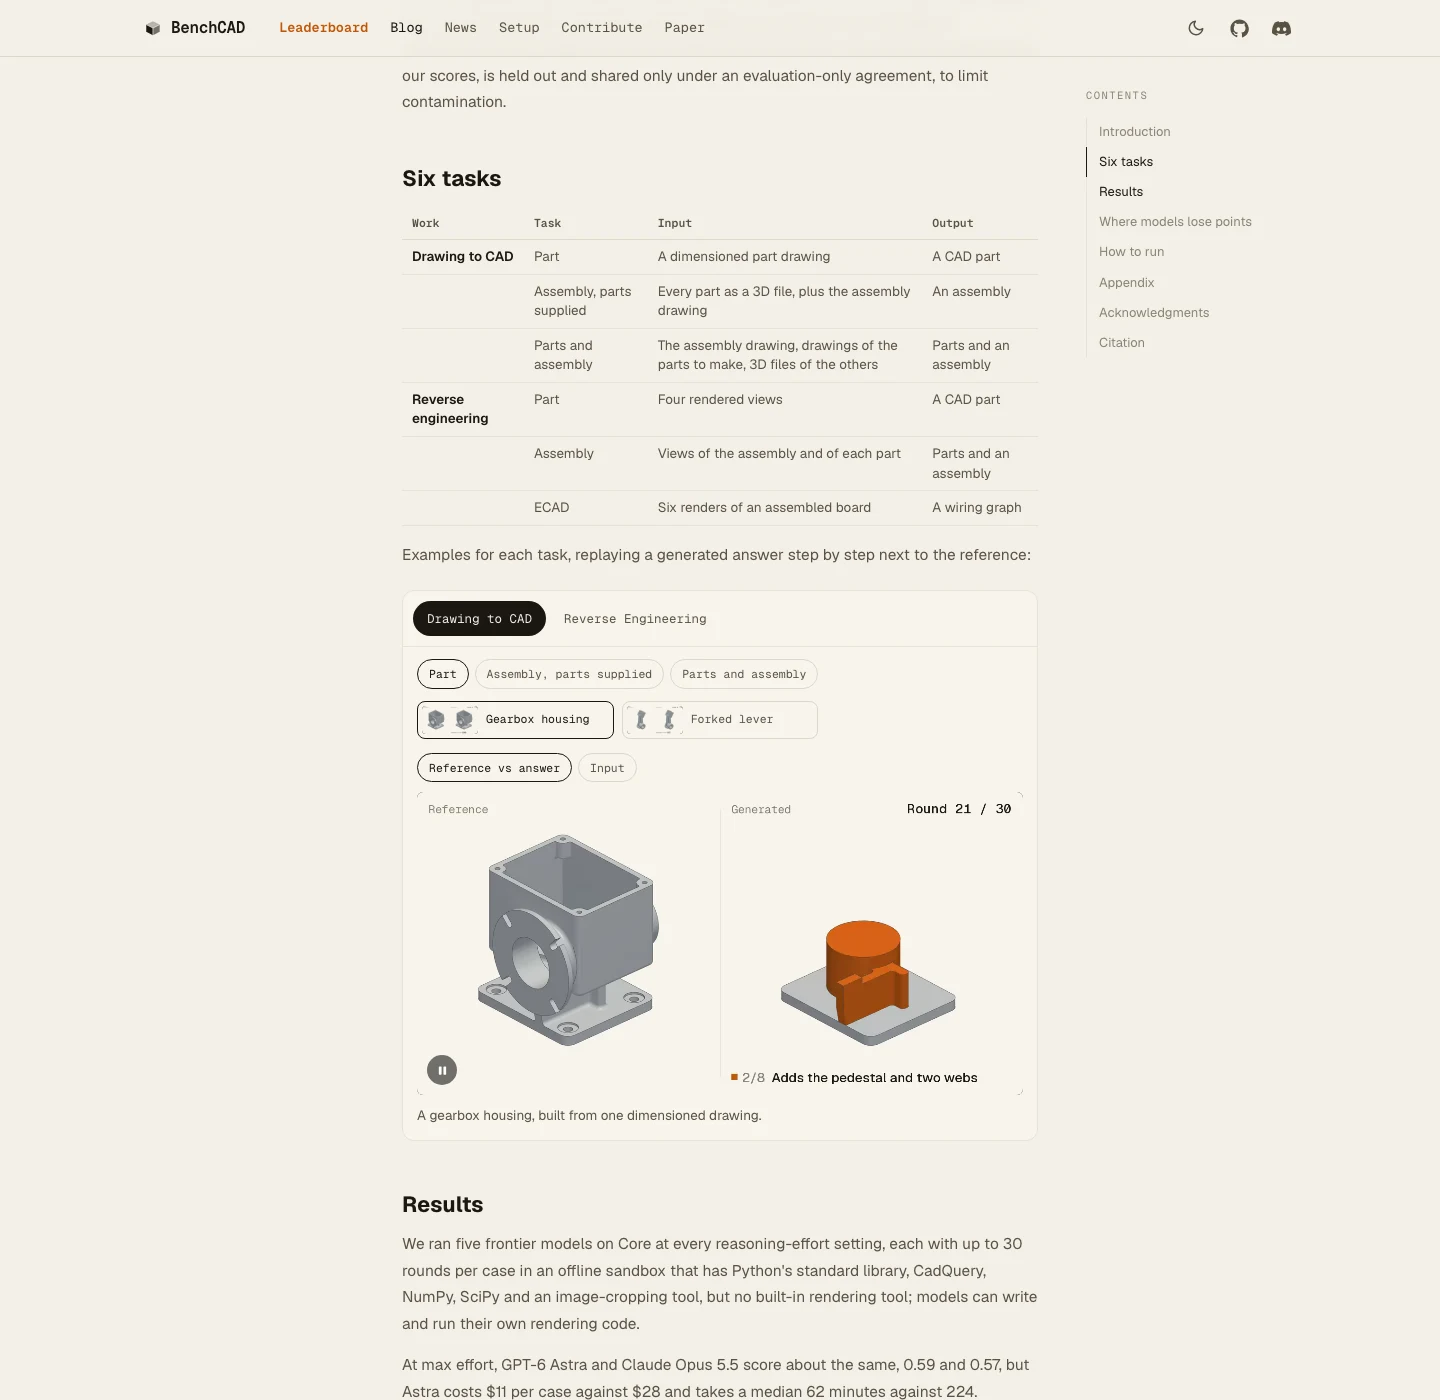
OpenAI 文章公布兩個分數:一個較新的內部模型平均 0.875,GPT-6 Astra 在最高推理設定 0.594。後者可以交叉確認,BenchCAD 十月自己量到的數字就是 GPT-6 Astra 在 max effort 的 0.59,與官方口徑一致;同一次量測裡,Claude Opus 5.5 是 0.57,Claude Sonnet 5.5 是 0.41。基準方同時給了成本與時間:GPT-6 Astra 拿 0.59 的每一個案例平均花 11.05 美元、中位數 62 分鐘,Opus 5.5 拿 0.57 則要 27.58 美元。想把基準納入自家評估的團隊,可以直接拿這組數字估預算。
0.875 的身分則要讀清楚。BenchCAD 的 Core 集一共有 100 個保留案例,研究者與模型開發者要簽下僅供評測的協議,才能在自己家的基礎設施上跑分。換句話說,0.875 是 OpenAI 拿一個未命名、沒有對外供應時程的內部模型,自己跑出來的數字。這種「廠商自測未發布模型」的分數,在模型行銷裡越來越常見,讀法只有一種:它說得通的方向是下一代模型的差距會拉開,但它不是今天可以買到的能力,把它當採購依據會誤判。另外有個值得一起看的事實:BenchCAD 在致謝段寫明,Anthropic 與 OpenAI 都提供了支援與評測用的 API 點數。基準是獨立團隊在跑,但受測廠商同時是贊助者,看分數時把這層關係放進去。
基準方自己整理的失分模式,比總分更值得記。組裝題的分數低於零件題,而且主要不是零件形狀畫錯:GPT-6 Astra、Claude Opus 5.5 與 Sonnet 5.5 的零分零件類型裡,有 83% 到 96% 形狀正確卻放錯位置。電路題則是找得到 85% 到 96% 的元件,連線比例卻上不去,GPT-6 Astra 在最高設定約 80%,電源軌的合併與拆分是重災區,有的跑題把三條電源與地線併成同一個網路,該板直接記零分。還有一種損失發生在幾何被計分之前:部分模型跑完所有回合直接空白繳卷,基準方舉的例子是 Haiku 5.5 在低推理設定下,100 個案例有 62 個從未送出答案,這些跑題全部記零分。瓶頸在空間關係與交接,不在畫不出形狀,這與官方在量產段承認的弱點指向同一個地方。
除了展示裝置,OpenAI 也公布了內部採用數字:硬體與基礎設施團隊用 Codex 與 ChatGPT 建立與修改 CAD 模型、準備製造圖面、設定模擬、審查設計,範圍涵蓋機器人與運算基礎設施,自 2026 年 2 月起,這些團隊以 token 計的模型用量成長了 23 倍。token 用量說明的是採用強度,等於大家真的在用,但它不能直接換算成可交付的工程成果,這層換算官方也沒有提供。文章裡倒是有一段內部硬體設計師的現身說法:OpenAI 工程師 Qiong Wang 描述,團隊把 Codex 與 ChatGPT 用在整理跨功能設計限制、探索系統架構、跨 ECAD 環境執行與設計審查,稱它們是不下班的工程夥伴,有潛力長成能把一塊電路板從概念帶到 Gerber 檔輸出的硬體專家團隊(Gerber 檔是電路板製造的標準交換格式)。
產業端有兩個名字。OpenAI 擴大與賽車團隊 Chip Ganassi Racing 的合作,與其研發部門測試把既有零件的 3D 掃描轉成可編輯的 CAD 模型與 2D 製造圖面;原始設計檔不可得的舊零件因此有了新的起點,賽車場上這種缺圖件並不少見,而掃描轉出來的模型與圖面,由 CGR 的工程師審查準確性與可製造性。另一個是新宣布的 Mazda 研究合作,對象是空氣力學與碰撞安全工程師,用氣流與結構模擬探索車輛設計:空力端讓 GPT-6 Astra 建模新的車頭形狀、跑氣流模擬、再收斂最有潛力的方案,而且官方明言這些探索要同時考慮造型與成本,三個目標彼此拉扯才是車輛外形的真實難題;碰撞端則看結構行為的模擬。成果官方預告會在未來幾個月分享,並註明已取得 Mazda 的使用同意。
兩個試點有同一個模式:模型進入的是有真實限制的工程流程,而且一律掛著工程師審查。模型輸出的模型檔與圖面,最終都由合作方的工程師驗收,而不是直接進產線。這正是這次公布裡最穩固的部分,比任何單一展示都可信。
已經能測的部分只有 GPT-6 Astra 這一側,它是已發布的模型(GPT-6 家族先前也展出過研究支線),BenchCAD 榜上同時給了每個案例的成本與時間,適合拿來估自己專案的測試預算。基準本身也開放得起:評測工具與公開資料集放在 GitHub 與 Hugging Face 上(BenchCAD 1.0 的程式碼採 MIT、資料採 CC-BY-4.0),任何人都能在公開集上試跑,只是公開集的分數不可對外引用,要報分數得申請 Core 的評測資格。想試的團隊可以從一個邊界清楚的既有零件開始:先給固定需求讓模型建模,再把輸出的可編輯檔接回自家工程軟體,改一個條件,看相關幾何會不會跟著動。交接檔能不能用,比示範影片快不快重要;若每次都要人工重建整份模型,聊天再快也省不了時間。畫電路板的需求,現在也有把輸出做成帶得走的 KiCad 專案的 MCP 工具可以對照。
該等的則有三件事:內部模型的名稱與供應時程、Mazda 與 CGR 的實際成果數字,以及這台裝置有沒有後續。0.875 哪一天變成一個可以呼叫的模型名稱,那才是採購討論的起點;在那之前,它就是一個方向訊號,而且是一個由模型廠商自己量給你看的訊號。這些數字都是發布當天的快照,內部模型時程與 Mazda、CGR 的成果下次有官方更新時,值得回頭對照同一組數字看落差。