TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

精神科醫師 Bhooshan Shukla 在 X 主張 AI 絕對能取代醫師的診斷與開藥,卡住的只有法律責任;外科醫師以身體檢查反駁。牛津團隊刊在 Nature Medicine 的千人隨機研究顯示,模型單獨作答能找出 94.9% 的病症,實際由民眾使用時卻低於 34.5%,還輸給自己查資料的對照組;猶他州試點則把責任做成 AI 決定、醫師掛名的制度。
用 AI 摘要這篇文章:
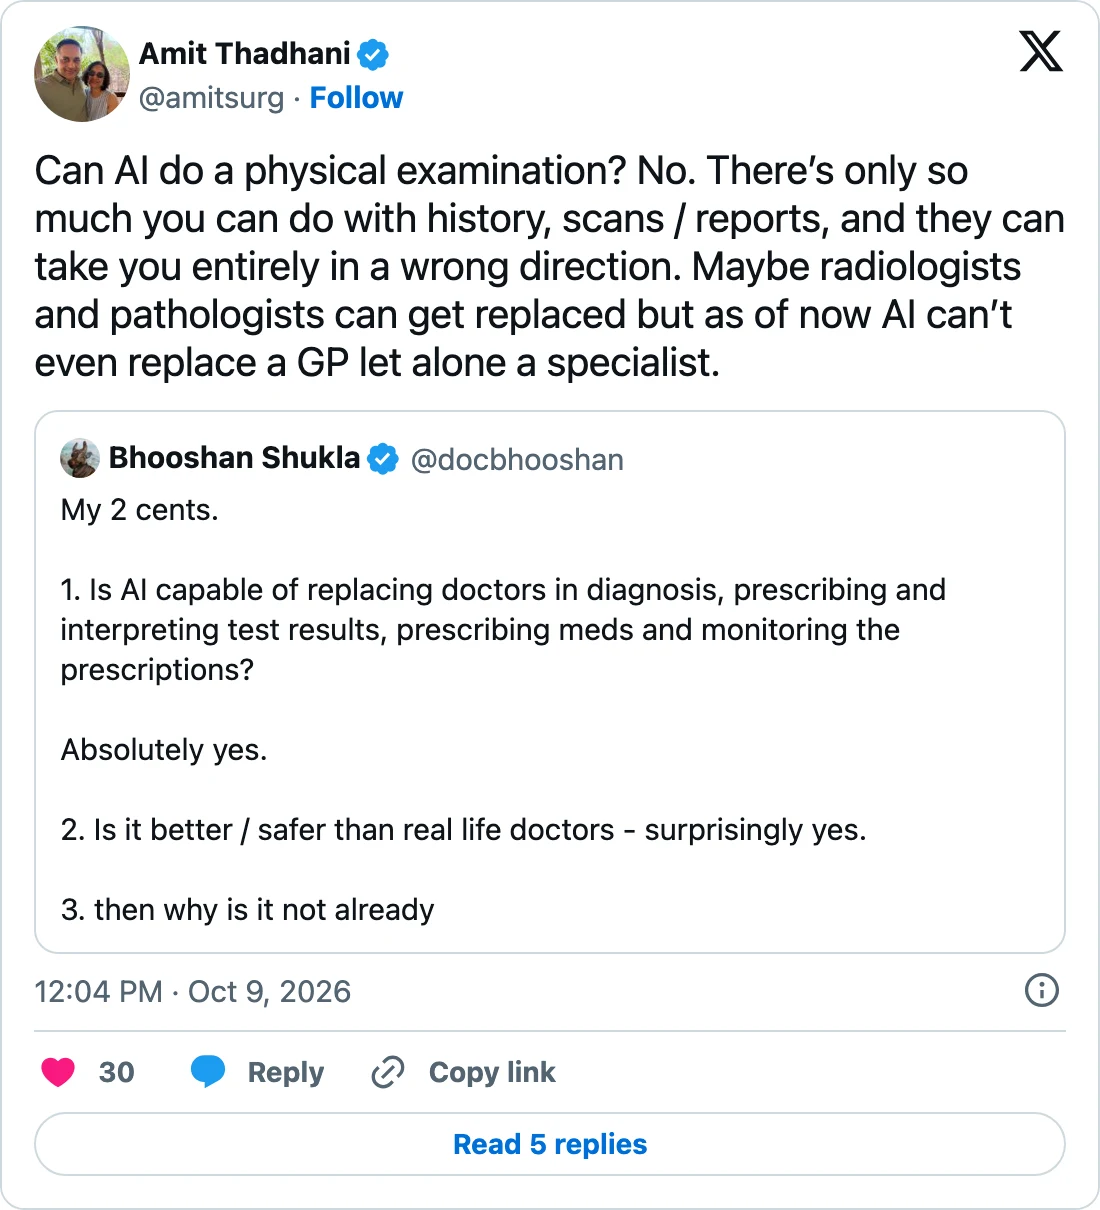
10 月 9 日中午,X 上出現一場同業之間的交鋒。執業於印度浦那的兒童與家庭精神科醫師 Bhooshan Shukla 貼出三個自問自答:AI 能不能在診斷、開藥、判讀檢查結果與監測處方上取代醫師?他的答案是「絕對可以」。那它會不會比真人醫師更好、更安全?「出乎意料地,是」。至於為什麼還沒發生,他在後續貼文提出自己的假說:卡住的是法律責任這一關,能力早就不是問題。
約 25 分鐘後,在個人網站上列有腹腔鏡外科執業資訊的 Amit Thadhani 引用這則貼文回擊:AI 連身體檢查都做不了。靠病史、掃描與報告能走的路有限,而且可能把判斷帶到完全錯的方向。他也留了一個例外:放射科與病理科也許真的會被取代,但 AI 現在連家醫都取代不了,更別說專科。
兩段發言都沒有附上研究佐證,本質上是兩位執業醫師的個人判斷。不過這個題目不需要停在誰的嗓門大:一份 2026 年 2 月刊登在《Nature Medicine》的英國隨機對照研究、一份常被引用的同理心研究,以及一個自 2026 年 1 月上線運作至今的美國州政府試點,正好把「AI 取代醫師」拆成三個可以分開驗證的問題。模型會不會答題,證據很強。民眾會不會用,證據出現大反轉。出了事誰負責,答案則已經有人做出來了,而且跟這場辯論裡任何一方說的都不太一樣。
Shukla 的原文結構很清楚。他把問題拆成三步:能力、品質與安全,最後才是「那為什麼還沒發生」。前兩步他直接給出肯定答案,第三步他把矛頭指向制度,認為技術已經不是障礙。
他在後續貼文寫下自己的假說:法律責任是 AI 接手醫療的路障。他預測五年內 AI 會被證明遠比人類醫師更不容易出錯,而且會在涵蓋數以百萬計病患的臨床試驗中一再被證明。這段是個人的五年預測,貼文裡沒有附任何資料。他把路障畫在法律責任這一邊,這個假說隱含一個可以檢驗的命題。
如果責任安排真的能被制度化,AI 就有機會走進醫療流程。美國猶他州自一月以來做的事,幾乎就是這個命題的對照實驗。
Thadhani 的反駁集中在身體檢查這一環。他的質疑是:只靠病史與報告做判斷,方向可能整個錯掉,而觸診、聽診這類身體檢查正是把方向校準回來的工具。這個論點的力量在於它無法用筆試或螢幕對話反駁,也是目前所有大型語言模型都碰不到的區塊。
更微妙的是他自己劃出的例外。放射科與病理科的工作對象是影像與檢體,恰好是 AI 已經大量進場的領域,這個讓步讓他的反對從「AI 不行」收斂成「AI 的能力有邊界,而邊界畫在身體檢查之前」。
兩位醫師加起來,等於把「取代醫師」講成了兩件事:一方談的是認知工作,另一方談的是身體在場。但真正的證據指出,還有第三件事雙方都沒碰到。
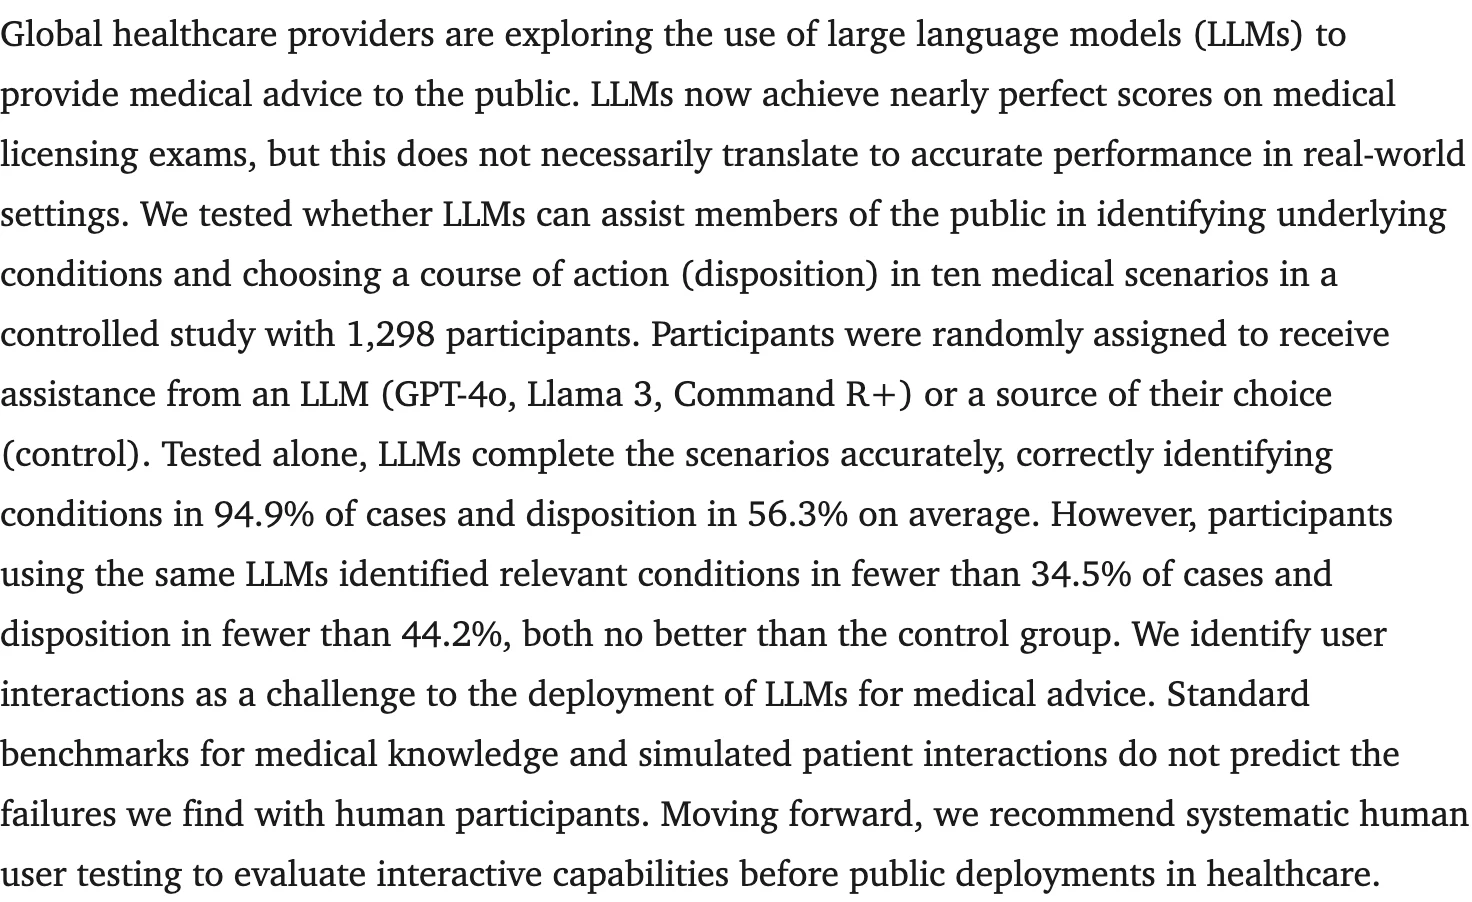
2026 年 2 月 9 日出刊、由牛津大學網路研究所團隊主導的《Nature Medicine》研究,設計可以直接回答「能力是不是早就足夠」這個問題。研究團隊先請三位醫師撰寫十個醫療情境,再交給另外四位不知道標準答案的醫師建立病症清單,然後在 Prolific 平台上招募 1,298 名英國參與者,分層抽樣以貼近英國人口結構。每個人隨機分到一組:用 GPT-4o、Llama 3 或 Command R+ 其中一個模型對話,或者落入對照組,用自己的方法查資料。任務是判斷情境裡可能有哪些病症,以及該採取什麼行動,選項從在家休息一路排到叫救護車。
模型單獨作答的成績相當高。平均 94.9% 的情境能找出相關病症,GPT-4o 為 94.7%,Llama 3 高達 99.2%,Command R+ 也有 90.8%。如果「取代醫師」指的是答題,這個數字確實接近 Shukla 想說的東西。
反轉發生在真人上場之後。同樣的模型、同樣的題目,由參與者實際對話使用,能找出相關病症的比例降到 34.5% 以下,選對處置的比例在 44.2% 以下,兩項都不比對照組好。更刺眼的是,對照組自己上網查資料,找出相關病症的勝算是 LLM 組的 1.76 倍,從較嚴重的紅旗清單裡抓出病症的機會也是 1.57 倍。把最先進的對話模型交到一般人手裡,表現反而輸給自己查資料。
研究團隊把問題定位在互動層。他們檢視對話紀錄後歸納出幾種失敗樣態:有人只問封閉式問題,例如「這跟壓力有關嗎」,把模型能回答的範圍先砍掉了;有人用擬人的方式讀模型,覺得「AI 聽起來很有信心」就跟著做決定;也有人刻意不把完整症狀告訴模型,留著事後考它。答案曾經出現在對話裡,使用者卻沒有辨識出來,或者沒有採納。
這份研究本身也有幾條必須一起讀的邊界。收案時間是 2024 年 8 月到 10 月,用的三個模型以當時標準算是前一代產品,對 2026 年的最新模型不能直接套用。參與者面對的是模擬情境,不是真實看診的壓力。而且就算模型單獨作答,處置正確率也只有 56.3%,在「該怎麼辦」這一半上,模型自己也還不到六成。研究結論寫得很直白:標準醫學基準與模擬病人測試,都預測不了真人使用時的失敗,對大眾開放前應該先做系統性的真人測試。
這個斷層不是醫療獨有。專業領域的自報分數與實際表現之間的距離,在法律版的 ChatGPT 榜單爭議也曾出現同一種結構。而民眾把健康問題直接交給 AI 工具的行為已經很普遍,研究引註的美國 KFF 民調顯示,每六位美國成人就有一位每月至少一次問 AI 聊天機器人健康資訊,健康資料助手類工具與把醫療報告收進本機的 AI 知識庫的流行,只是這個行為的另一面。
支持方常引用的另一份證據,是 2023 年刊登在《JAMA Internal Medicine》的比較研究。研究人員從 Reddit 的醫療問答版隨機抽出 195 則有醫師回覆的公開提問,把原始問題丟給 ChatGPT 生成另一套回覆,將兩套回覆匿名隨機排序後交給執照醫療人員三重評比。結果是 78.6% 的評估偏好聊天機器人的回覆,被評為有同理心或非常有同理心的比例是 45.1% 對 4.6%,相差 9.8 倍。
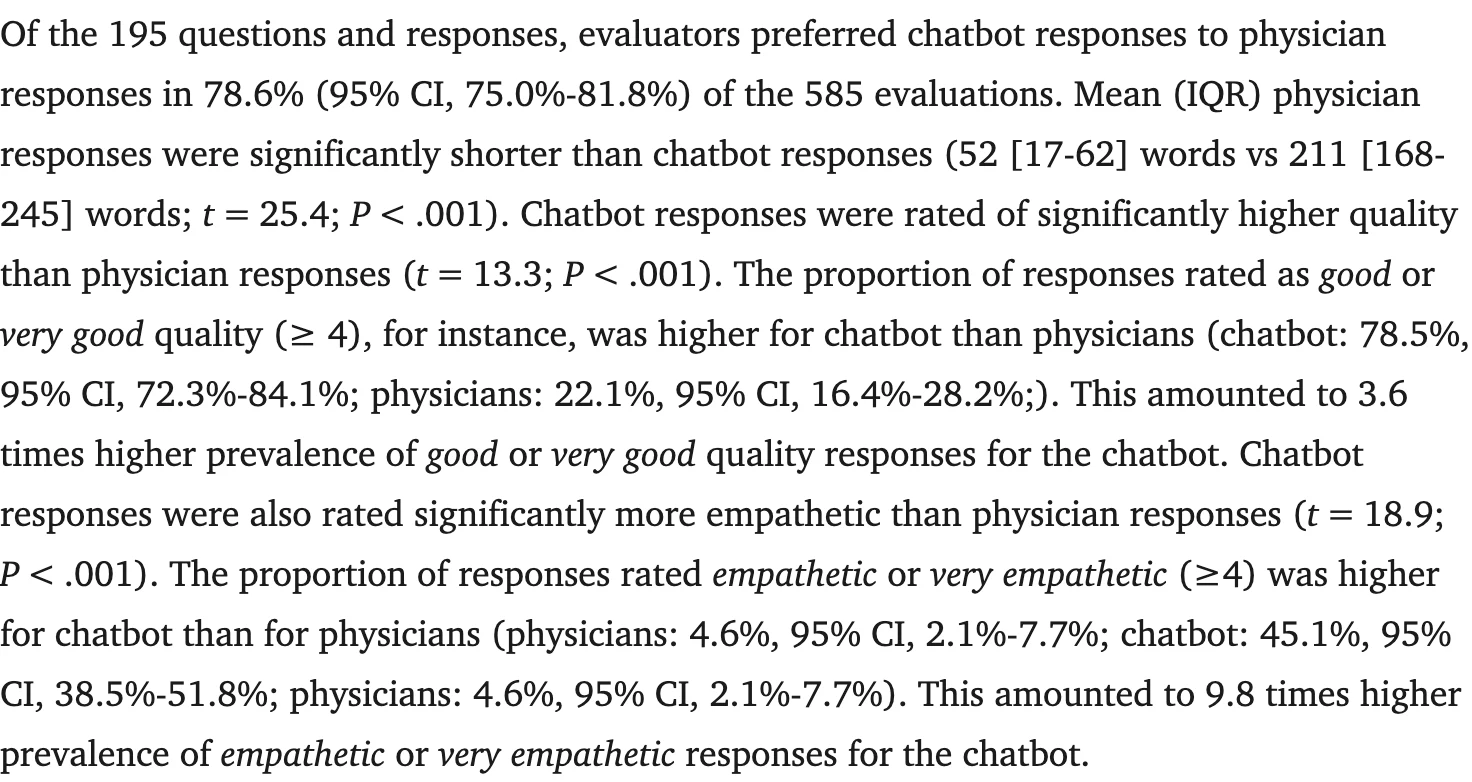
數字本身沒有問題,有問題的是它常被拿來講的故事。同一份研究也量了篇幅:醫師回覆平均 52 個英文字,聊天機器人約 211 個,差距超過四倍。在論壇語境裡,長而完整的回覆本來就容易被讀成有耐心。研究作者的結論也收得很保守:AI 或許能協助起草回覆,再由臨床醫師審閱。他們比較的範圍僅止於公開論壇上的文字往來,離面對面看診裡的同理心都還有一段距離。
換句話說,這份研究支持的是「AI 能寫出讓人覺得被傾聽的文字」,而不是「AI 比醫師更有溫度」。把它放回 Shukla 的能力論證裡,它撐起來的部分比表面數字少很多。
如果說前兩份研究回答的是能力與使用,美國猶他州回答的是 Shukla 指出的第三關。2026 年 1 月,猶他州商務部所屬的人工智慧政策辦公室(OAIP)與健康科技公司 Doctronic、主管醫師執照的 Division of Professional Licensing 三方簽訂為期 12 個月的監理緩減協議,讓 AI 在限定範圍內接手一件真實的醫療工作:既有處方的續開。
範圍畫得非常窄。AI 只能處理 30、60 或 90 天的續開,對象必須是持照醫療人員原本就開立的藥物;不能開新處方、不能改治療計畫,管制與成癮性藥物明文排除。系統會先查核病人身分與原處方,再向 Surescripts 藥事資料庫查證最新處方狀態,發現劑量或時程對不上就轉交人類醫師。據 TNW 轉述美聯社的報導,Doctronic 約 190 種可續開藥物裡包含抗凝血劑這類出事會很嚴重的藥。
責任的設計把 Shukla 的路障假說直接做成了答案。協議把試點分成階段:第一批 250 名病患的每一筆 AI 續藥決定,都要由猶他執照醫師在送到藥局之前事前審查;接下來的 1,000 名病患改成回溯審查。藥師有疑問可以直接連絡 Doctronic 的醫師群。AI 可以做決定,但每一張處方仍然掛在人類醫師名下。人類沒有離開流程,人類被放在責任鏈上。
這個設計換來的是真實上線,也換來真實的爭議。據 AP 報導,試點 1 月上線時,州的醫療執照委員會是在新聞裡才知道這件事。4 月,委員會 11 名成員連署要求暫停,理由是副作用與藥物交互作用風險不該交給自動續開。委員會主席、家醫科醫師 Alan Smith 以個人身分對媒體說,他們得到的答覆基本上是「對,這在進行。而你沒有說話餘地」。州政府拒絕暫停,理由是第一階段每筆續藥仍有醫師審查;TNW 的報導並指出,試點由五名都不是醫師的 AI 專家組成的委員會監督。
官方自己的說法寫在 OAIP 頁面的狀態更新裡,時間點是試點上線約三個月時:已收到兩份內容合乎約定的月報;辦公室沒有接獲重大安全事故的通報;第三方紅隊測試發現對抗性使用下的潛在弱點,但評估認為防護措施大幅限制了典型使用者受害的可能性,也有防止管制藥品未授權發放的硬性攔截。同一份更新確認試點仍在第一階段,所有處方請求都需要持照醫療人員授權。到 7 月的後續報導為止,試點仍維持第一階段的設計;8 月起媒體仍在追蹤這個試點。
把猶他州經驗放回辯論裡,可以得到一個比「能不能取代」具體得多的結論:責任這一關不是等著被打破的牆,而是可以被工程化的設計題。代價也清楚可見,醫師團體被繞過的憤怒、監督委員會裡沒有任何醫師、以及抗凝血劑自動續開這類具體風險,都是這個設計正在承受的張力。
回到 10 月 9 日那場交鋒,兩位醫師其實都只回答了三分之一的問題。答題能力這一塊,證據站在偏向 Shukla 的方向,但《Nature Medicine》的 56.3% 處置正確率也提醒,連這一塊都沒有全部拿下。真人使用這一塊,目前的證據是明確的反轉,而且失敗機制出在人這一端,模型升級不會自動修好。責任這一塊,猶他州已經示範了一種可複製的解法,同時也示範了它的政治成本。
之後值得追蹤的驗收點很具體。猶他州試點的第二階段回溯審查資料,會顯示 AI 與醫師的分歧率與嚴重度分佈;執照委員會與州政府的對峙有沒有走到立法或訴訟;以及有沒有研究團隊用 2026 年的新一代模型重跑真人使用測試。Shukla 預測的那種百萬人規模出錯率對比試驗若真的出現,那會是這場辯論的終局證據,但在它出現之前,「絕對可以」與「連家醫都不行」都還停留在信念的層次,離量出來的距離還很遠。
身體不適,請諮詢合格醫療人員;在把健康判斷交給 AI 之前,記得研究裡那個 1.76 倍的差距。就像機器人體力工作研究算出的那條 40 年成本曲線一樣,「做得到」與「真正發生」之間,永遠有一段需要被量出來的距離。