TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

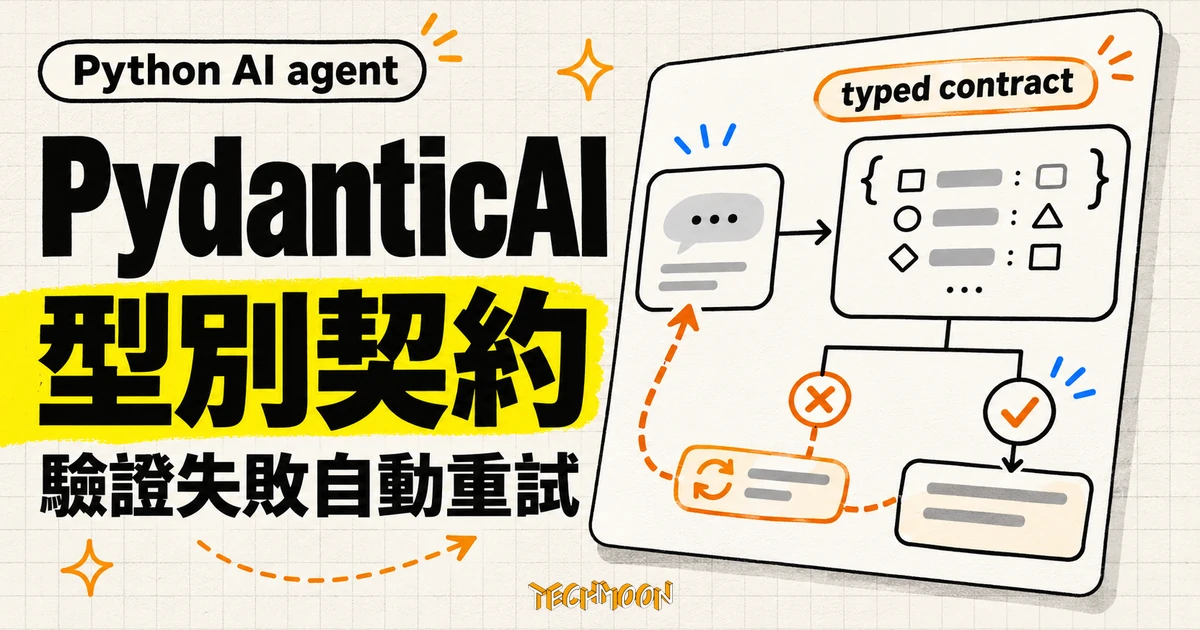
PydanticAI 是 Pydantic 團隊的開源 Python AI 代理框架(MIT),用原生型別驗證把模型輸出約束成後端可用的資料結構,驗證失敗會帶著原因自動退回重試。本文在 Python 3.11 實際安裝 2.71.0、跑通最小代理與重試迴圈,並核實版本現況、供應商清單與 Logfire、AI Gateway 的費用邊界。
用 AI 摘要這篇文章:
PydanticAI 是 Pydantic 團隊的開源 Python AI 代理框架,MIT 授權,到 11 月 20 日我查詢時在 GitHub 有 21,294 顆星,PyPI 近一個月被下載約 697 萬次。最新版 2.71.0 在台灣時間 11 月 19 日上午剛推上 PyPI,光 11 月就出了七個小版本。我用 Python 3.11 實際安裝 2.71.0、跑通了它的最小代理與重試迴圈,接下來依序看三件事:型別契約實測起來是什麼感覺、版本與採用現況,以及這個免費框架把錢賺在哪裡。
它賣的東西一句話講完:把「拜託模型別吐錯格式」換成「型別契約加自動退回重試」。你用一般的 Pydantic BaseModel 宣告要模型回傳什麼形狀的資料,框架把 schema 交給模型、驗證回傳內容,驗證失敗就把錯在哪裡退回給模型再試一次。範圍早已超出純文字代理:儲存庫的官方描述寫的是代理、及時語音、影像生成與嵌入向量,「每個模型、每個介面、端到端都有型別」。聽過 Pydantic 這個名字的讀者可能更熟悉它的另一個身分:FastAPI 背後的資料驗證層,OpenAI、Anthropic、Google 的 SDK 與 LangChain 內部也用它做驗證,官方文件自己就列了這段履歷。
先交代接觸層級:我在乾淨的虛擬環境裝了 pydantic-ai 2.71.0(需要 Python 3.11 以上),用官方內建的離線測試模型跑代理,沒有接任何真實模型服務。這個 test 模型是官方為開發與測試設計的,完全離線,所以契約層的行為可以零成本驗證。
最小代理長這樣:宣告一個 Report 模型(標題、嚴重度 1 到 5、關鍵字清單),建 Agent('test', output_type=Report, deps_type=int, retries=3),掛兩個工具。跑完 run_sync 拿到的東西是 Report 的實例,可以直接取 r.title、r.severity,IDE 的型別提示全部接得上,下游程式碼不需要再寫「解析 JSON 字串然後賭欄位存在」那段防禦程式。
相依注入也照文件宣稱的運作。deps_type=int 之後,工具函式簽名裡的 RunContext 就帶著呼叫端傳進來的值,工具內用 ctx.deps 直接讀。這個設計的意義是把「連線物件、設定、閾值」這類狀態從提示詞裡拿出來,改成型別安全的參數傳遞,提示詞留給真正的指令。
還有一個小發現:每個新起的 Python 行程跑代理時,終端機會先印一大塊 ASCII 藝術橫幅,上面標明這個代理用的模型、輸出型別、工具數量,接著提醒觀測功能沒開、可以去設 Pydantic Logfire,並註明用環境變數 PYDANTIC_AI_NO_BANNER=1 能關掉。橫幅本身就是一份很誠實的組態摘要,第一次跑的時候用它確認模型與輸出型別接對了,比翻 log 快。這個橫幅也是商業模式的前門,後面會回到它。
核心機制值得攤開看,因為它就是這個框架有別於提示詞拜託派的地方。output_type 交給模型的管道有三種:預設的 ToolOutput 把 schema 掛在工具呼叫上送出,官方說它幾乎所有模型都支援;NativeOutput 用供應商原生的 JSON schema 輸出;PromptedOutput 把 schema 寫進提示詞,官方自己承認這條路往往最不可靠。回傳之後用 Pydantic 驗證,這層就是契約本身。
我用輸出驗證器實測退回流程。在 @agent.output_validator 裡檢查摘要欄位,第一次故意拋出 ModelRetry,第二次讓它通過。觀察到的行為:驗證器跑了兩次、框架發出兩次模型請求,而且第一次的退回原因,帶著我寫的完整錯誤訊息,被記進訊息歷史成為一個重試回饋部分,下一輪請求看得到。換句話說,模型收到的資訊是「你剛才的摘要沒提到磁碟,長這樣」,不是一句空泛的再試一次。除錯的時候這份歷史直接可讀,官方提供 is_retry 函式幫你從訊息序列裡挑出重試的部分,新舊兩種紀錄格式都認得。
契約還有兩個設計細節,實務上都用得到。輸出型別可以給多個,框架會把每個型別註冊成獨立的輸出工具,用來降低單一 schema 的複雜度,這讓「模型自己選擇回傳成功物件或失敗物件」這類分流寫法變得很自然。另外輸出也可以是函式:模型呼叫這個函式,執行就結束,函式的回傳值成為結果,不會再送回模型,等於把最後一步的後處理收進契約裡。
重試的預算設計有細節。Agent(..., retries=3) 一個整數同時設定工具與輸出兩份預算,也可以用 retries={'tools': 5, 'output': 1} 分開指定;沒指定的保持預設值 1。工具的重試走同一套退回機制,我讓一個工具第一次拋 ModelRetry、第二次回正常值,實測它跑了兩次後成功。工具的計數器以工具名稱為鍵,成功就歸零,模型亂叫一個不存在的工具名稱會另開一份新的預算,官方靠這個設計處理模型幻覺出假工具的情境。兩件事官方文件都寫得明白:每次修正都是一個完整的模型往返,會計入請求上限與用量;預算耗盡時拋出 UnexpectedModelBehavior,由你的程式決定怎麼處理。這就是自動重試的代價結構,方便是真的,帳單也是真的。
實測最反常的結果在這裡。我一開始在輸出驗證器裡拋普通的 ValueError,預期框架會像文件說的那樣退回重試,結果例外直接穿出來傳到呼叫端,一次重試都沒發生。對照官方文件才確認:輸出型別本身的驗證錯誤(例如整數超出 ge 到 le 的範圍)會進重試迴圈,自訂驗證器要明確拋 ModelRetry 才會。
這個坑背後有一條更重要的分界線。型別契約保證的是格式:欄位在、型別對、範圍符合。實務上最常見的爛輸出,好比模型在 JSON 前面先加一句「好的,以下是要的資料」,或把數字包在字串裡,這一層契約確實擋得住,擋下來就退回重試。至於摘要寫得對不對、嚴重度給得合不合理,這些語意層的判斷,框架不知道也不該知道,要靠你自己寫成驗證器。想清楚這條線,就不會對「輸出保證符合結構」這類說法過度期待:結構符合是契約管的,內容正確是你的規則管的,而你的規則得記得用對的錯誤種類。
這個專案不算新面孔。儲存庫 2024 年 6 月就建立,1.0.0 在 2025 年 9 月發布,2.0.0 在 2026 年 6 月,現在最新是 2.71.0。PyPI 上累計 364 個版本,3,217 個 fork,發布節奏以天計:11 月尚未過完,2.65 到 2.71 七個小版本已經先後上架,其中 2.69.0 與 2.70.0 相隔不到一天接連推出。同時 1.x 維護線沒有死,11 月 4 日還推了 v1.107.10,代表舊版使用者有安全修補的緩衝,但 2.x 已是主線。
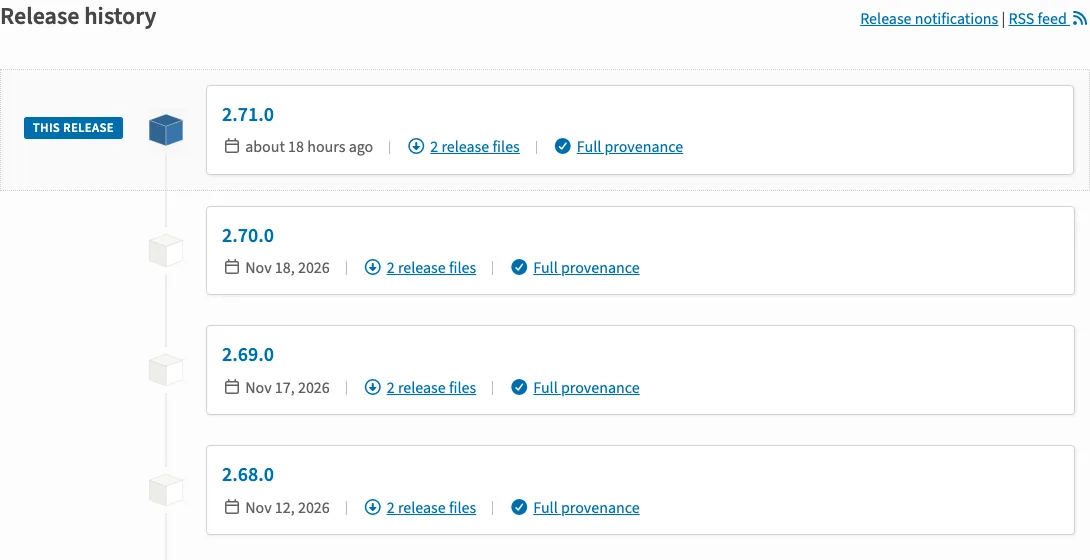
| 時間點 | 事件 |
|---|---|
| 2024 年 6 月 | 儲存庫建立 |
| 2025 年 9 月 | 1.0.0 發布 |
| 2026 年 6 月 | 2.0.0 發布,進入 2.x 主線 |
| 2026 年 11 月 19 日 | 2.71.0 推上 PyPI,1.x 維護線同月仍在修補 |
採用面除了開頭的星數與月下載量,還可以看兩個訊號。生態分工變清楚了:主框架之外另有獨立套件 pydantic-ai-harness(官方定位是能力與執行環境層),兩者版本號各走各的,前幾天才推出讓多個代理互傳訊息的 Peers 功能,細節可以先看先前的追蹤報導;還在 1.x 的專案則要認知到,修補會繼續一陣子,新功能與文件都長在 2.x 上,遲早要面對遷移。功能面也在擴張,官方概述頁列了及時語音、影像生成、嵌入向量,以及橫跨九種引擎的持久執行(Temporal、DBOS、Prefect、Restate、AWS Lambda、Airflow 等),代理的前端事件流也點名支援 AG-UI 與 Vercel AI,AG-UI 1.0 凍結時我們整理過它的定位。
對要引用它的團隊,時效提醒只有一句:這個節奏下,任何 API 細節都以當下文件為準,教學文章三個月後對不上很正常,鎖版本號再上線。
框架本身 MIT 完全免費,但那個每次執行都跳出來的觀測橫幅,就是理解這門生意的入口。型別契約解決格式層的問題;系統上線之後真正的痛點換成「每一次模型呼叫花多少錢、卡在哪一步、重試了幾次」,這要靠觀測工具,而觀測正是 Pydantic 的收費產品 Logfire。橫幅上推的設定精靈只要一行指令就能把整個追蹤接起來,這條路的順滑程度是刻意做出來的。值得一提的是綁定不深:官方文件說儀器化走 OpenTelemetry 標準,任何 OTel 後端都能接,Logfire 只是其中最順手的一個。
價格結構我逐字核對過定價頁。Logfire 個人方案免費,每個月 1,000 萬筆紀錄、保留 30 天、一個正式席次加兩個唯讀訪客,超量的處置是停止寫入而非扣費,個人帳戶等於停在零元。付費從團隊方案每月 49 美元起,同樣 1,000 萬筆、超量每百萬筆 2 美元。另一個產品 AI Gateway(一把鑰匙代理所有模型供應商,內建故障轉移與成本監控)的計價有個清楚的分界:用自己帶來的模型 key(BYOK)完全不加價,個人方案最多登錄 3 組憑證;用它內建的供應商則在個人與團隊方案加價 5%,而且個人方案要先綁信用卡。另外代理沙箱(Agent Sandboxes)任何方案都送每個月 5 萬次免費叫用,測試重試迴圈這類開發工作有現成的免費額度可用。
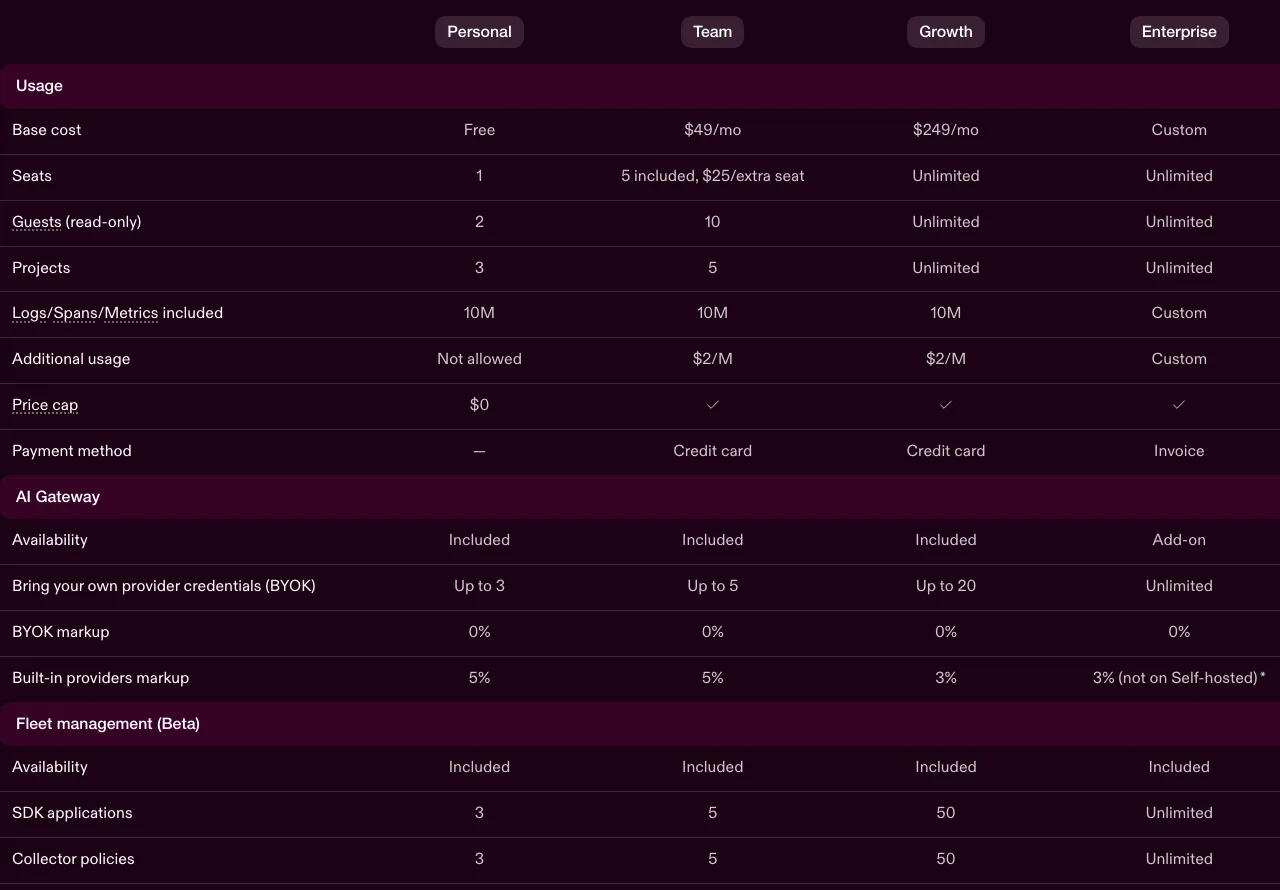
判讀很簡單:個人開發者幾乎碰不到付費牆,免費額度大到用不完;要簽核的是團隊,因為觀測資料會落在 Pydantic 的雲端,資料流向與保留天數得照自家政策走一遍。
把限制集中說。我只實跑了離線測試模型,真實模型下的重試率、延遲與帳單數字不在實測範圍,接真模型前先小流量驗證。串流有限制:官方文件提醒串流執行會把第一個符合輸出型別的結果當最終輸出,之後的工具呼叫不再執行;預設的 ToolOutput 串流要求模型支援串流工具參數,不支援就得換輸出模式。模式相容性也有地圖:官方列出較早的 Gemini 型號與 Groq 不能把 NativeOutput 和函式工具並用,Anthropic 則會把 schema 編譯成文法,複雜度有上限,schema 太複雜時要調整。
模型無關是真的但要正確理解:概述頁列了 OpenAI、Anthropic、Google、Bedrock、Azure AI Foundry、Groq、Mistral、xAI、Ollama 等供應商,模型用一個字串就能換;我實測的只有測試模型,換供應商後輸出品質與成本要各自重驗。MCP 支援也查過:代理可以當 MCP 用戶端掛外部伺服器的工具,也可以反向把自己包成 MCP 伺服器,官方建議的寫法預設在本機跑伺服器,供應商原生支援可以選用、不支援時退回本機,這段我沒有實測。環境門檻也提一句:套件要求 Python 3.11 以上,還卡在 3.10 或更舊的專案要先處理環境,這在企業內部伺服器並不罕見。
已經在 FastAPI 或 Pydantic 生態裡的 Python 團隊,採用成本最低:BaseModel 的寫法直接沿用,要學的是代理、工具與輸出模式的 API,而且官方設計好的開發路徑就是先用測試模型把契約與重試邏輯全部寫完再接真模型,這段完全不花 API 費。要把 AI 輸出接進資料庫、報表或既有 API 的場景,獲益最直接,因為下游型別安全是這個框架最硬的保證;評估輸出品質時,官方生態裡還有 Pydantic Evals 可以把評測腳本化,不用另外找工具。需要複雜狀態圖工作流、多階段人工審核的系統,請另外評估,我沒有做跨框架的對稱實測,不替你下結論;TypeScript 陣營的讀者可以對照我們先前實測過的 Mastra。
起手式三行:建虛擬環境、pip install pydantic-ai、用 Agent('test') 跑一個帶 output_type 的代理。跑通重試迴圈、看過訊息歷史裡的退回原因,你就知道這套契約適不適合你的專案,這一輪的時間成本大概是一杯咖啡。