TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

Hugging Face 的開源語音合成模型 Parler-TTS 用一段英文描述控制聲音風格:實測同一句話換描述,生成長度差 44%。880M 參數 mini 版在 Apple Silicon 上本地可跑,程式碼與權重採 Apache-2.0,但 main 分支停在 2024 年 12 月,且不支援中文。
用 AI 摘要這篇文章:
同一句英文餵進 Parler-TTS,只把聲音描述從「Jon 的聲音平板、語速偏快」換成「Laura 的聲音低沉、語速放慢」,生成出來的音檔長度從 2.39 秒變成 3.44 秒,整整慢了 44%。這是我在 MacBook 上實測 Parler-TTS mini 模型拿到的結果:它對「速度」這件事的控制,寫在一段自然語言描述裡就生效,完全不必動取樣率或滑桿參數。
這個 2024 年由 Hugging Face 團隊釋出的開源語音合成(TTS,把文字轉成語音)模型,在 2026 年 11 月的現在是什麼狀態?把結論先講:它還裝得起來、跑得動,授權乾淨到連訓練資料都公開;但它的程式碼凍結在 2024 年 12 月,而且整個模型家族不支援中文。要不要把它裝進自己的專案,取決於你要的是即戰力,還是一份完整可拆解的開放配方。
實測環境是 macOS(Apple Silicon)配 Python 3.11。開一個乾淨的虛擬環境,pip install parler-tts 一行裝完,拿到 0.2.3 版。安裝過程它會把 transformers 釘在 4.46.1 這個特定版本,整個依賴樹等於停在 2024 年 10 月的時間點,連帶拉進 Descript 音訊工具鏈的兩個分支套件。好處是不會遇到版本打架,裝完直接 import 成功,我重開了一個全新環境驗證,同樣一次到位;代價是未來其他專案要共用環境,得先確認 transformers 版本會不會衝突。
有個小地方值得說:repo 的 README 叮嚀 Apple Silicon 使用者改裝 PyTorch nightly 才吃得到 bfloat16。我用穩定版 torch 2.13、預設的 float32 精度直接跑,三段生成都正常。這份說明是 2024 年寫的,放到今天的穩定版環境已經用不到,照抄反而多裝一層 nightly。
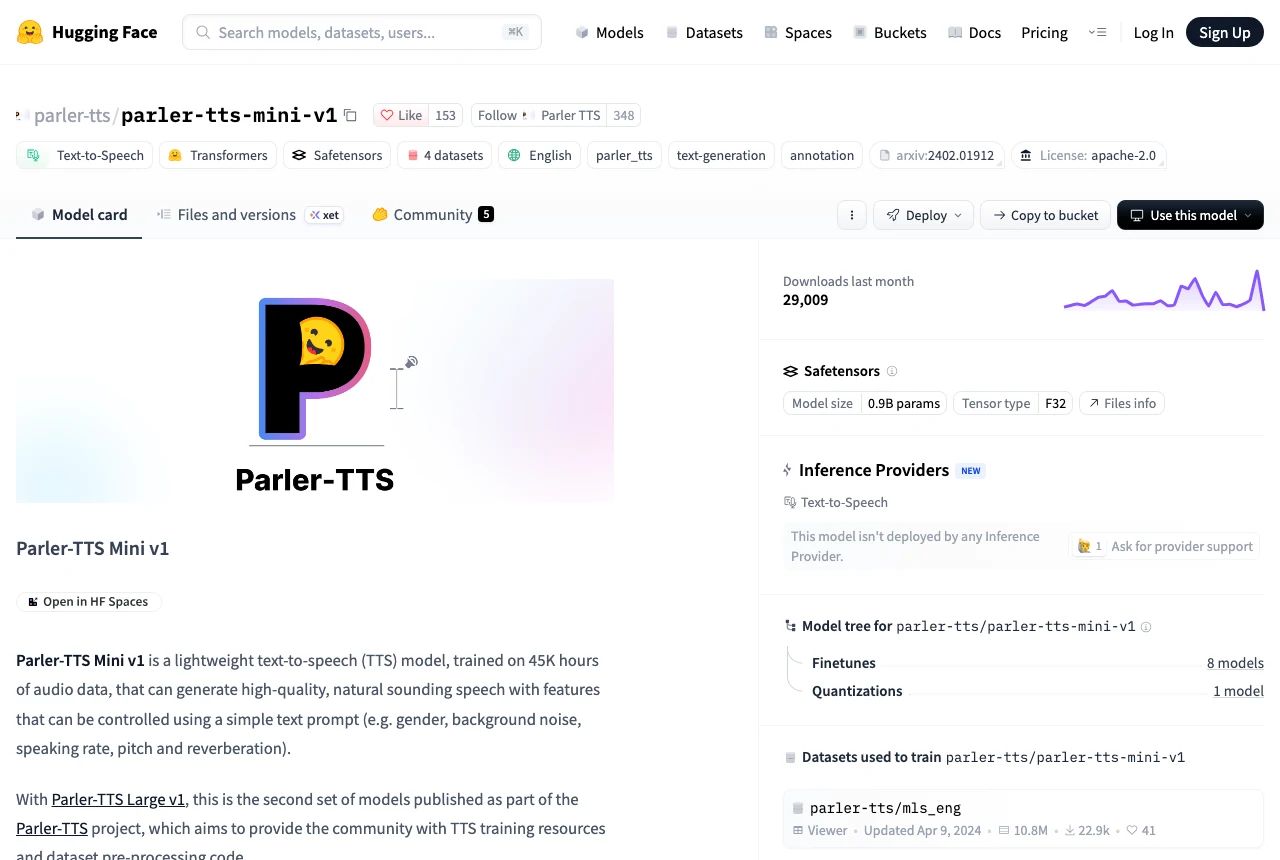
權重抓下來約 3.5GB,第一次載入含下載花了 90.5 秒,之後走本機快取。我把 880M 參數的 mini-v1 載到 MPS(Apple Silicon 的 GPU 後端)生成第一段語音,13.7 秒產出 4.26 秒的 44.1kHz 單聲道 WAV 檔;暖機後同模型的生成時間降到 5 秒上下。換句話說,在沒有 NVIDIA 顯示卡的 Mac 上,生成時間大致是音檔長度的 1.5 到 3 倍多,做短句配音、原型驗證夠用,長文稿的批次生產會等到想睡。
實際跑起來的程式碼比多數 TTS 框架短:載入模型與分詞器各一行,把「聲音描述」與「要念的文字」分別編碼成兩組輸入,呼叫 generate 就拿到波形陣列,用 soundfile 寫成 WAV。描述與內文走同一個分詞器,這也是為什麼描述寫得具體,控制就比較準。跑的時候終端會跳一句 attention mask 警告,警告文字本身指出成因是分詞器的填充符號與結尾符號相同;我三次生成的輸出都正常,可以把它當雜訊忽略。
import torch
from parler_tts import ParlerTTSForConditionalGeneration
from transformers import AutoTokenizer
import soundfile as sf

model = ParlerTTSForConditionalGeneration.from_pretrained(
    "parler-tts/parler-tts-mini-v1").to("mps")
tok = AutoTokenizer.from_pretrained("parler-tts/parler-tts-mini-v1")

desc = "Jon's voice is monotone yet slightly fast in delivery."
text = "The quick brown fox jumps over the lazy dog."

gen = model.generate(
    input_ids=tok(desc, return_tensors="pt").input_ids.to("mps"),
    prompt_input_ids=tok(text, return_tensors="pt").input_ids.to("mps"))
sf.write("out.wav", gen.cpu().numpy().squeeze(),
         model.config.sampling_rate)
如果要先零安裝試聽,Hugging Face 上的官方互動展示間還在運作,可以先在上面試幾段聲音描述,確認這種控制方式合不合自己的工作習慣,再決定要不要把 3.5GB 的權重抓下來。
挑 checkpoint 之前得先知道這個家族走過的路,因為網路上流傳的教學多半停在最早的版本。
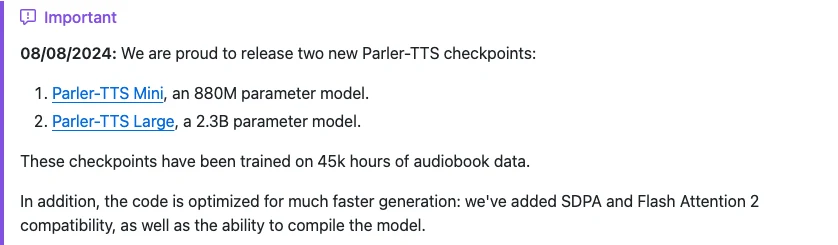
2024 年 2 月 repo 建立,第一批公開的 v0.1 世代以 10,500 小時的多說話者語料起家,另有聚焦單一女聲 Jenny 的微調變體,當時就是「輕量、可商用」的定位。2024 年 8 月的公告是真正的分水嶺:同時發布 880M 的 mini-v1 與 2.3B 的 large-v1,訓練語料換成 45,000 小時的有聲書,mini-v1 帶進 34 位以名字索引的說話者(Jon、Laura、David、Karen 這類英文名),並加入 SDPA 與 Flash Attention 2 支援來壓生成時間。之後還有一輪 v1.1 修正版,以及 2024 年 11 月的迷你多語版。到今天,Hugging Face 上的 parler-tts 組織共有 13 個模型倉庫,連聲音還原用的 DAC 解碼器都單獨開放。
下載量的分佈說明了使用者用腳投票的結果:近 30 天 mini-v1 有 29,009 次下載,large-v1 有 4,629 次,多語版 10,641 次,最早期的 v0.1 反而只剩 1,958 次(以上皆為 2026 年 11 月 20 日查詢 Hugging Face 平台的結果)。把整個家族加總,每個月仍有約五萬次下載,對一個停更近兩年的專案來說,這個數字本身就是一種信任訊號。想入門,mini-v1 是事實上的標準選擇;要極致品質才考慮 large-v1,代價是權重體積與生成時間;組織裡還有一個更小的 tiny 版與一個用 Expresso 情感語料訓練的變體,前者適合快速試水管線,後者衝著戲劇化語氣去,不過兩者的月下載都只有數百次,屬於實驗性質。
選 checkpoint 的實務建議很單純:英語配音選 mini-v1,歐洲語系選多語版 v1.1,只想驗證流程不想等下載選 tiny,需要更強的聲音細節再上 large-v1。中文使用者如果目標是國台語配音,這個家族幫不上忙,後面限制段會把這條邊界講清楚。
這次實測留下了三個可核對的音檔與量測紀錄。
頭一段用「女性說話者、略帶表情、中等速度與音高、錄音品質極佳」的描述,生成 4.26 秒音檔,峰值振幅 0.883。後兩段用同一句話(The quick brown fox jumps over the lazy dog),只換聲音描述:指定 Jon 生成 2.39 秒、RMS 振幅 0.135;指定 Laura 生成 3.44 秒、RMS 振幅 0.085。兩段描述都是官方文件示範的寫法,不是我自創的咒語。輸出的取樣率固定在 44.1kHz 單聲道,跟 CD 同級,直接進剪輯軟體不需要再重取樣。
測試條件先講清楚:我只量了波形統計,沒有做主觀聽測,所以「Jon 聽起來比 Laura 生動」這類說法我不會講。但客觀數字已經說了兩件事:同樣的文字內容,速度描述直接反映在輸出長度上,44% 的差距不是隨機雜訊能解釋的幅度;振幅分布也跟著描述變了,慢速版的 RMS 低了將近四成,與「放慢、帶強調」的敘述方向一致。
官方文件還給了幾個控制手感,同樣屬於「作者宣稱」層級、我沒有逐一驗證:描述裡寫 very clear audio 會往乾淨錄音靠,寫 very noisy audio 會得到高背景噪聲;標點符號直接影響韻律,逗號多停頓就多。描述能操作的維度包括性別、語速、音高、表達力、錄音距離與殘響,都是標注模型當初被訓來辨識的面向,所以描述落在這些維度內效果最穩。對想批次產配音的人,這些等於是一套可玩的混音台旋鈕,只是旋鈕上刻的不是頻率,而是形容詞。
大多數 TTS 要控制聲音風格,要嘛調速度參數,要嘛餵一段參考音檔去做聲音克隆。Parler-TTS 的做法是把控制面整個換成英文描述:你在描述欄位寫「錄音非常乾淨、幾乎沒有背景噪音」,生成結果就往那個方向靠。
反常的地方在於這件事居然能用一句話量化驗證。我改的只是描述文字,模型端沒動任何設定,輸出時長就移動了 44%。這代表「聲音風格」在這個模型裡被當成條件輸入一起處理,而非生成完再套的後製濾鏡。對開發者來說,這意味著可以用寫 prompt 的方式批次生產不同人設的配音,34 位命名說話者再加上自由描述,組合空間比固定的說話者下拉選單大得多。
還有一個附帶的好處:不靠真人聲音指紋做克隆,權利關係單純。描述導向的生成不需要先取得某人的錄音授權,商業部署時這條法律邊界比「聲音克隆」路線清爽。
這個模型出自 Hugging Face 的 Yoach Lacombe、Vaibhav Srivastav 與 Sanchit Gandhi 三人之手(repo 引用格式裡具名),技術源流可以追溯到 Stability AI 的原始論文。知道出處的好處是研判風險:它不是某個匿名帳號一夜爆紅的權重,而是有組織背書、有論文對應、有完整釋出紀錄的專案,這也解釋了為什麼停更近一年仍有人持續下載。
這套設計有清楚的學術出處。Parler-TTS 是對 Stability AI 與愛丁堡大學兩位研究者 2024 年論文的開源重現(arXiv 編號 2402.01912)。那篇論文的核心主張是:大型 TTS 的聲音控制若靠人工標注描述,規模上不去;那就先訓一個標注模型,自動為 45,000 小時的有聲書語料產生「這位說話者的性別、語速、音高、錄音條件」的文字描述,再讓 TTS 模型拿這些描述當條件一起訓。Hugging Face 接手實作後,進一步把標注工具(Data-Speech)、訓練程式碼、資料集與權重全部公開,README 裡甚至附上以單一說話者資料集微調的 Colab 筆記本。
想自己動手微調的人,repo 的 training 資料夾給了一條完整的路:從架構說明、環境準備到用 accelerate 一行指令重現 mini-v1 的起訓配置都有文件,另有單一說話者資料集的微調示範。這條路已經有人走通:issue 區就有人照著配方訓出韓英雙語版本,代表食譜是真的能開火的等級。相形之下,多數只開放權重的模型連這扇門都沒有。
生成端有個值得知道的細節:模型先產生音訊離散代碼,再由 DAC 解碼器還原成波形,每一組代碼對應 0.011 秒的聲音。官方推論指南算過,86 步解碼大約湊出第一秒聲音,所以不必等整段生成完就能開始播放,library 內建了對應的串流類別,torch.compile 與 SDPA 的加速選項也寫在同一份指南裡。我這次沒有實測串流與編譯加速的幅度,這部分維持在文件層級;照官方說法兩者都是衝著降低延遲去的。
接著面對專案現況:GitHub 上 huggingface/parler-tts 的 main 分支最後一筆 commit 停在 2024 年 12 月 10 日,之後只有 2025 年 1 月上傳 PyPI 的 0.2.2 與 0.2.3 兩個版號,到今天約 23 個月沒有新程式碼。README 的安裝指令也還是建議直接從 GitHub 安裝,PyPI 比較像順手留下的鏡像。repo 沒有被封存,5,598 顆星與 591 個 fork 都還在,131 個 open issue 裡留著大量使用者經驗:#139 有 37 則討論,使用者表示語音一致性與零樣本克隆「運作得相當好」;#67 有人分享自己訓出韓英雙語版本的成果;也有新增語言的討論串留在 issue 區。官方停更之後,issue 區變成了事實上的使用者論壇。
順帶一提,最後幾筆 commit 的內容也透露了當時的重心:修復梯度累積、加入 logits 處理器、修串流功能,都是訓練與推論品質的收尾工作,看得出專案是在「能用的狀態」下停住,而非爛尾。這對使用者的意義是:拿到的雖是凍結版,但凍在高原而非半山腰。
市場的對照組很殘酷。Kokoro-82M 的 v0.19 在 2024 年 12 月 25 日上線,距離 Parler-TTS 的最後一筆 commit 只有兩週;到 2026 年 11 月 20 日我查詢時,它近 30 天的下載量是 1,313 萬次,Parler-TTS mini-v1 是 29,009 次,相差四百五十倍。Kokoro 走的是小參數(82M)、高速度、Apache 授權權重的路線,部署成本低到官方模型卡直接附上「每百萬字元不到 1 美元」的 API 報價參考。追求馬上能上線、速度優先的人,生態答案已經不在 Parler-TTS 這邊。
但 Kokoro 有一個繞不過去的短處:它的模型卡只交代訓練資料是「數百小時」,資料來源與完整配方沒有公開。Parler-TTS 是少數連訓練資料集、自動標注工具、訓練腳本都一起放的 TTS 家族,想自己微調出新語言、新聲音,或想研究「描述條件化」這條技術路線的人,它留下的配方屬於少數把資料集、標注工具與訓練碼一次湊齊的組合。用與不用,分水嶺就在這裡。
程式碼與主要 TTS 模型權重都是 Apache-2.0(聲音解碼器 DAC 另採 MIT 授權),可以商用、可以閉源部署、可以改了再發布。我把裝好的 parler_tts 套件本體掃了一遍:總共 8 個 Python 檔(含 DAC 包裝子套件),找不到任何遙測、分析或對外 API 呼叫的程式碼,唯一會連網的行為是第一次下載權重時連上 Hugging Face。推論全程在本機,沒有 BYOK 金鑰、沒有雲端代理。對隱私敏感或離線場景(把客戶訊息轉成語音、無外網的內網機器),這是放心的架構。
把缺點一次講完。
中文是硬邊界。家族裡的迷你多語版(v1.1)支援英文、法文、西班牙文、葡萄牙文、波蘭文、德文、荷蘭文、義大利文共 8 種歐洲語言,中文連實驗版都沒有。中文語音需求請直接繞路,站上先前介紹過的 LuvVoice 線上語音合成是現成的另一條路;要在開源圈找中文方案的話,ChatTTS 這類主打中文對話的模型比 Parler-TTS 對味。
速度與模型尺寸掛鉤。mini-v1 在我的 MPS 環境生成速度約為音檔時長的 1.5 到 3 倍多;2.3B 的 large-v1 我沒有實跑,但參數量擺在那裡,CPU 或 MPS 上跑它要有耐心。顯示卡記憶體的抓法可以用參數量換算:880M 參數在 float32 下光權重就約 3.5GB,這是推論(依參數量與精度的換算推估,非實測數字),bfloat16 可以再砍半,但 Apple Silicon 走 MPS 時精度支援要看 torch 版本臉色。追求即時串流上線的場景,這不是 2026 年的最優解;官方指南給的加速倍數以 GPU 環境量測,Apple Silicon 上的增幅沒有官方數字。
維護狀態要自己扛。約 23 個月沒有 commit,意味著 transformers 未來版本若有重大改動,沒有人保證相容;131 個 open issue 裡還躺著 SDPA 與 Flash Attention 2 的相容問題。依賴被釘在 transformers 4.46.1,短期是穩定的理由,長期是升級的債。
我的測試條件:單機、三次生成、波形統計佐證,沒有做主觀音質聽測,也沒有跟其他模型做同文稿對決。音質的好壞請以官方試聽樣本或自己跑一輪為準,有量測支撐的結論只有兩件:描述控制確實生效,以及它今天仍可安裝、可執行。
要 Parler-TTS 的人:想研究或微調 TTS 的開發者、需要 Apache 授權與完全離線推論的專案、想用文字描述批次產生多種英語配音的人,以及替八種支援語系的有聲書、遊戲語音或語言學習內容做原型的人。裝起來跑通一段的成本很低,乾淨環境、一行安裝、權重 3.5GB,今天就能驗證它符不符合你的聲音人設需求,驗證成功的樣子就是:改一句描述、生成時長跟著動,而你在描述裡寫的乾淨度與語速要求,聽起來確實朝那個方向走。
不該選它的人:需要中文或多數亞洲語言的、要即時低延遲上線的、期待專案持續修 bug 的。這幾種情況分別往支援中文的服務(不想碰程式碼的人,LuvVoice 這類線上工具三分鐘就能出音檔;要穩定出品質的專案可以看 SpeakItAI 自架 Azure 語音合成的做法)、Kokoro 這類輕量新世代、或有活躍維護的方案走,都會比枯等 Parler-TTS 復工實際。
它的價值在 2026 年已經從「最好用的開源 TTS」變成「最完整的開放配方」。要成品,市場往前走了;要配方與地基,它還擺在那裡,授權沒變、資料沒收、八個 Python 檔乾乾淨淨。