TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

Perplexity 於台北時間 11 月 18 日凌晨在 X 正式宣布 Orchestrator API:一把金鑰、統一計費,沿用 OpenAI 與 Anthropic SDK 呼叫 45 個模型 ID。官方文件把路由拆成可程式化的模型層與平台收走的部署層,遷移前要先核對三件事:對話狀態自己帶、搜尋不在這個產品裡、快取行為因供應商而異;能呼叫哪些模型還按累計消費分層。
用 AI 摘要這篇文章:
台北時間 11 月 18 日凌晨 4 點 13 分起,Perplexity 在 X 上於 11 秒內連發三則貼文發表 Orchestrator API:一把 Perplexity API 金鑰,透過 OpenAI Chat Completions、OpenAI Responses 或 Anthropic Messages 三種請求格式,呼叫官方所稱 45 個以上的模型目錄,費用統一從平台點數扣除。最後一則貼文補上重點:自動路由以預覽形式提供,由一個決策模型替每個請求挑選模型。
對已經同時接好幾家模型的團隊,這個入口接管的是接線與帳務:一把金鑰、一張帳單、同一個模型 ID 在三種格式都通。官方文件也把沒接走的部分寫得相當直白:對話狀態要自己帶、搜尋能力不在這個產品裡、快取行為因供應商而異。以 11 月 18 日查核時的官方文件為準,把兩邊各自對帳一次。
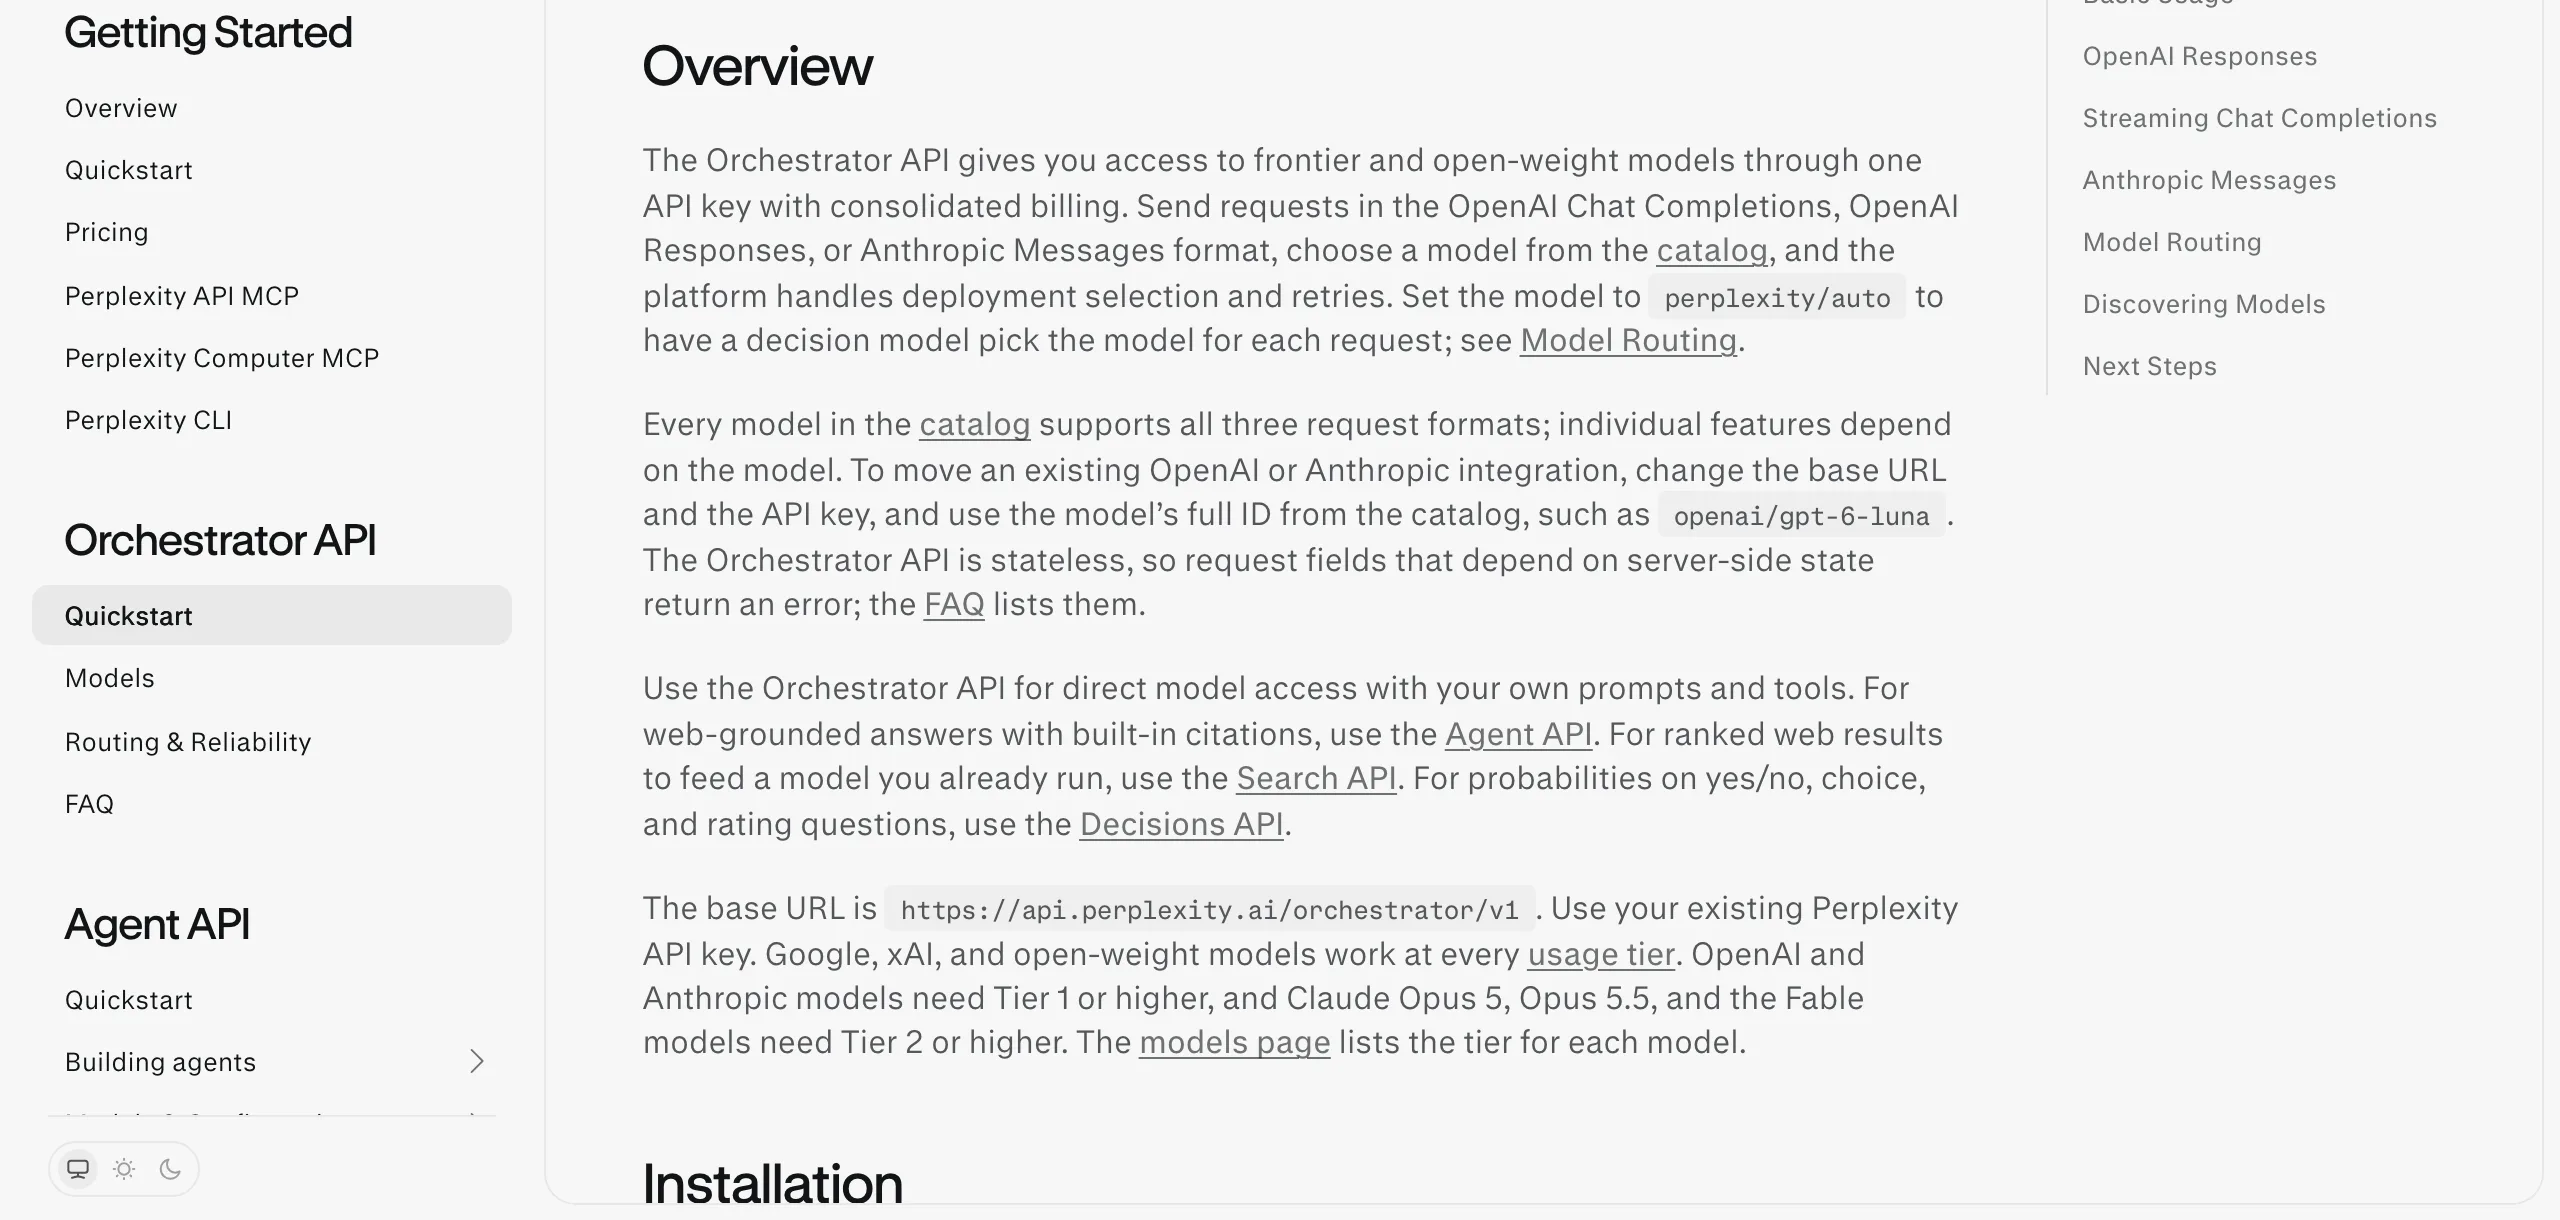
Orchestrator 最值得看清楚的設計,是把「路由」拆成兩層,而且兩層的控制權歸屬不同。
模型路由(model routing)是可選的。把 model 設成 perplexity/auto,再帶一個 routing 物件,裡面是一個 default_model 加上 1 到 5 條路線,每條路線用一段自然語言描述該處理什麼請求、配上負責的模型。決策模型讀的是對話文字與路線描述,路線名稱和模型 ID 它不看,所以「診斷帶錯誤堆疊的程式失敗」這種描述,比「進階模式」更能讓分流命中。文件還明講:圖片、音訊、影片、檔案這類多媒體內容不經過決策模型,直接由 default_model 服務,所以挑預設模型時要先確認它吃不吃你送的媒體。
供應商路由(provider routing)則完全是平台的事。模型選定後,平台依觀察到的錯誤率、容量與延遲,從同一個模型的多個部署裡挑一個來服務;某個部署出錯、被限流或逾時,請求換同模型的其他部署重試,牌價不變。開發者不能指定部署,也沒有 per-provider 參數可以調。換句話說,這個入口接走了部署層的可靠度工程,代價是你放棄部署控制權,而同價備援是官方給的交換條件。
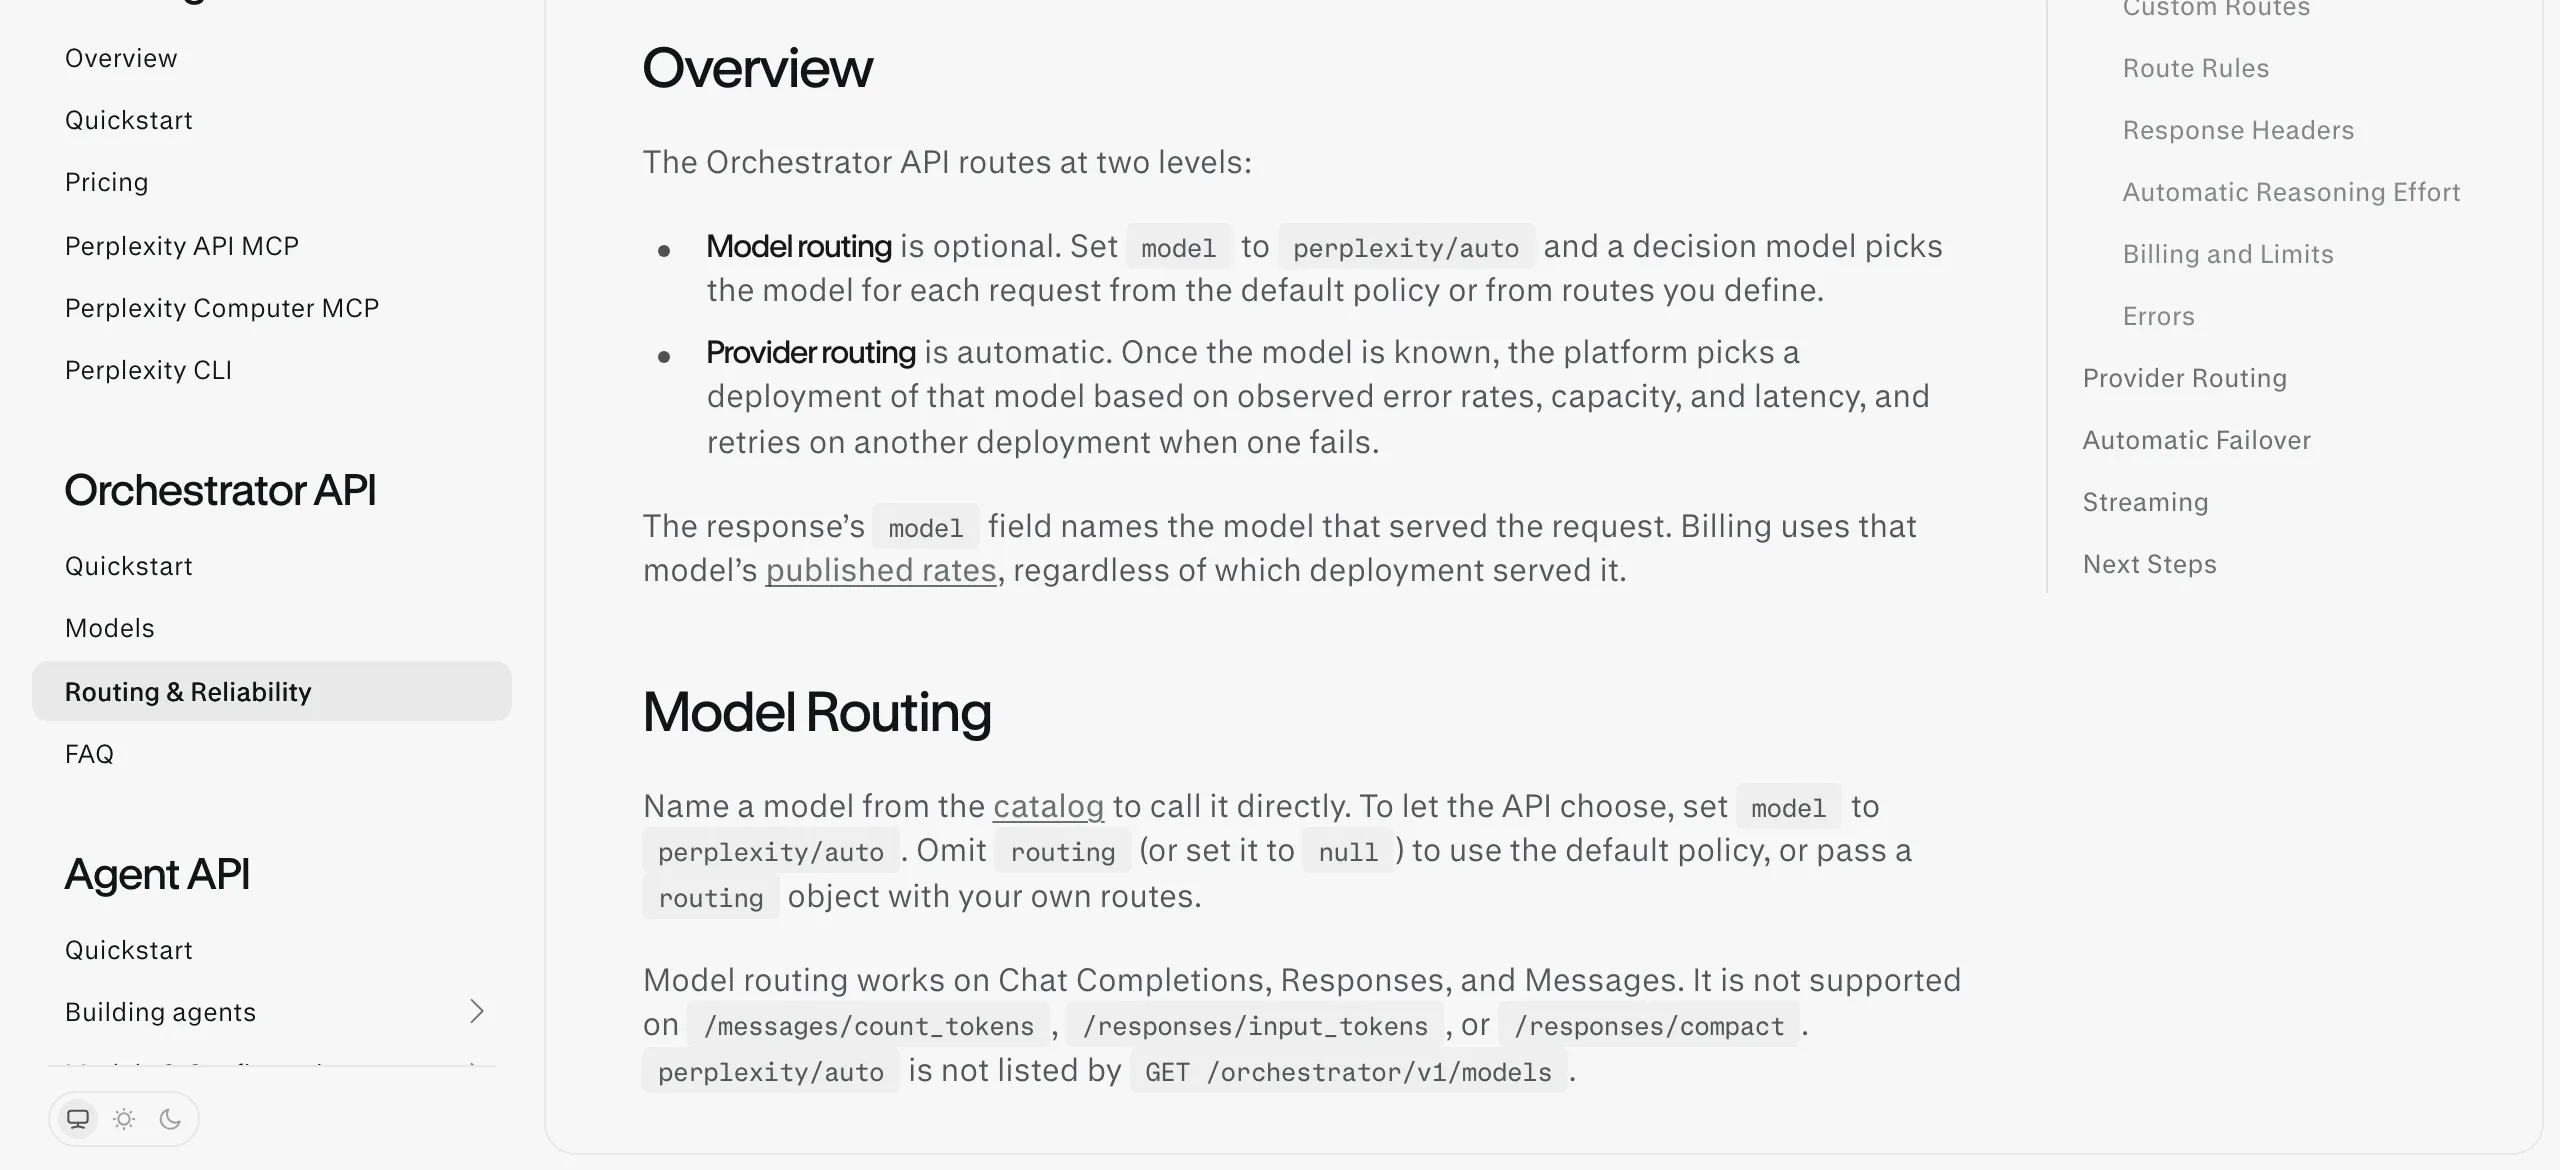
每個請求獨立路由,同一段對話的前後兩輪可能由不同模型接手。實際結果要看回應的 model 欄位,以及 x-perplexity-autoroute-outcome、x-perplexity-autoroute-route、x-perplexity-autoroute-confidence 這組回應標頭。文件範例裡,一個除錯請求命中 hard_debugging 路線、信心度 0.889,由 openai/gpt-6.1-sol 服務;預設政策下「把 good morning 翻成法文」命中 simple 路線、信心度 0.991,由 openai/gpt-6-luna 服務。這組標頭在串流回應上也存在,因為路由在串流開始前就完成了。
路由結果本身分四種:routed 是決策模型挑中路線或回 none;media_input 是媒體內容讓選擇直接落在 default_model;fallback 是決策模型失敗、逾時或沒有文字可分類;single_model 是相容性檢查刪光了所有路線、default_model 未經路由就直接服務。相容性檢查在決策之前執行,會先把目錄、使用層級、零資料保留、組織模型設定與請求參數吃不下的模型從路線裡移除;連 default_model 都被移除時,由僅存路線的模型遞補,全部移除則回 400 並附上每個模型的原因。規則本身的錯誤訊息也相當具體:路線數量超出範圍回 routes must list 1 to 5 routes、路線命名 none 回 name must not be "none"、routing 物件配上其他模型回 routing requires model perplexity/auto,序列化後超過 16,384 位元組或帶未知欄位都會被拒。
不帶 routing 時的預設政策:openai/gpt-6.1-sol 是預設模型,simple 路線把問候、速查、標題與短改寫翻譯送給 openai/gpt-6-luna。兩個模型都要求使用層級 Tier 1 以上,所以累計消費未達門檻的帳號想用 auto,得自己帶路線,這個門檻下一段展開。
路由物件還能多交出一個決定:把 reasoning_effort 設成 auto,決策模型會替請求挑 low、medium 或 high 的推理強度,寫進該格式對應的欄位後才送給服務模型。同一個請求不能再自己設 effort,兩邊都設會回 400;不帶 auto 時,請求裡的 effort 設定原樣通過,什麼都不設就用模型預設。對成本敏感的團隊,這讓「簡單請求低強度、難題高強度」變成路由規則的一部分,不必在應用層另寫判斷;挑選結果會用 x-perplexity-autoroute-effort 標頭回報,沒挑或模型不支援時回 default。
既有 OpenAI 或 Anthropic 整合要搬過來,程式面上的改動確實很小:換 base URL、換金鑰、把模型名稱換成帶前綴的完整 ID。文件給的錯誤範例很實際:gpt-6-luna 會回 HTTP 404 Invalid model,openai/gpt-6-luna 才是合法 ID;目錄裡也沒有 OpenAI 模型的 -pro 變體,要調強度就選 reasoning effort。另一個容易踩的坑是路徑:OpenAI SDK 的 base URL 是 https://api.perplexity.ai/orchestrator/v1,Anthropic SDK 卻要設成 https://api.perplexity.ai/orchestrator,因為 SDK 自己會補 /v1/messages,多寫一段就送錯網址。
程式面之外,三個舊習慣帶不走。
最先卡住的是伺服器端對話。這組端點是無狀態設計,store: true、previous_response_id、conversation、background: true 這些依賴服務端保存狀態的欄位一律回 HTTP 400,錯誤訊息直接寫「this endpoint is stateless」。每輪都要帶完整對話;要讓推理模型延續前一輪的思考,Chat Completions 得自己把 reasoning_content 放回 assistant 訊息,Responses 則用 include: ["reasoning.encrypted_content"] 拿到加密內容後原樣帶回。
搜尋是另一個帶不走的預設。Orchestrator 賣的是直接模型存取,提示與工具都由開發者安排。需要模型自帶網路搜尋與引用,官方的分工是 Agent API;只要排序過的搜尋結果餵給自己跑的模型,用 Search API;要 yes/no、選項與評分的機率,用 Decisions API。原本「模型會自己查資料」的應用換入口之前,得先確認搜尋本來是應用自己呼叫的,還是舊平台附贈的。
部署控制權同樣要不回來。除了前面說的不能指定部署,想在多輪對話裡盡量留在同一個部署,官方給的是盡力而為的手段:每個請求帶穩定的 x-session-id 標頭,或在 /chat/completions 與 /responses 帶穩定的 prompt_cache_key。備援發生時請求仍可能跳到冷快取的部署,auto 模式下這個標頭也不鎖模型選擇。
發表串第三秒的貼文寫 serves 45+ models;官方文件在 11 月 18 日查核時逐表點算正好是 45 個模型 ID:Anthropic 15 個、OpenAI 18 個、Google 5 個、xAI 3 個,加上掛 perplexity/ 前綴的 4 個開放權重模型(Z.AI 的 GLM 5.3 與 GLM 5.3 Flash、DeepSeek V4 Pro、Moonshot 的 Kimi K3)。
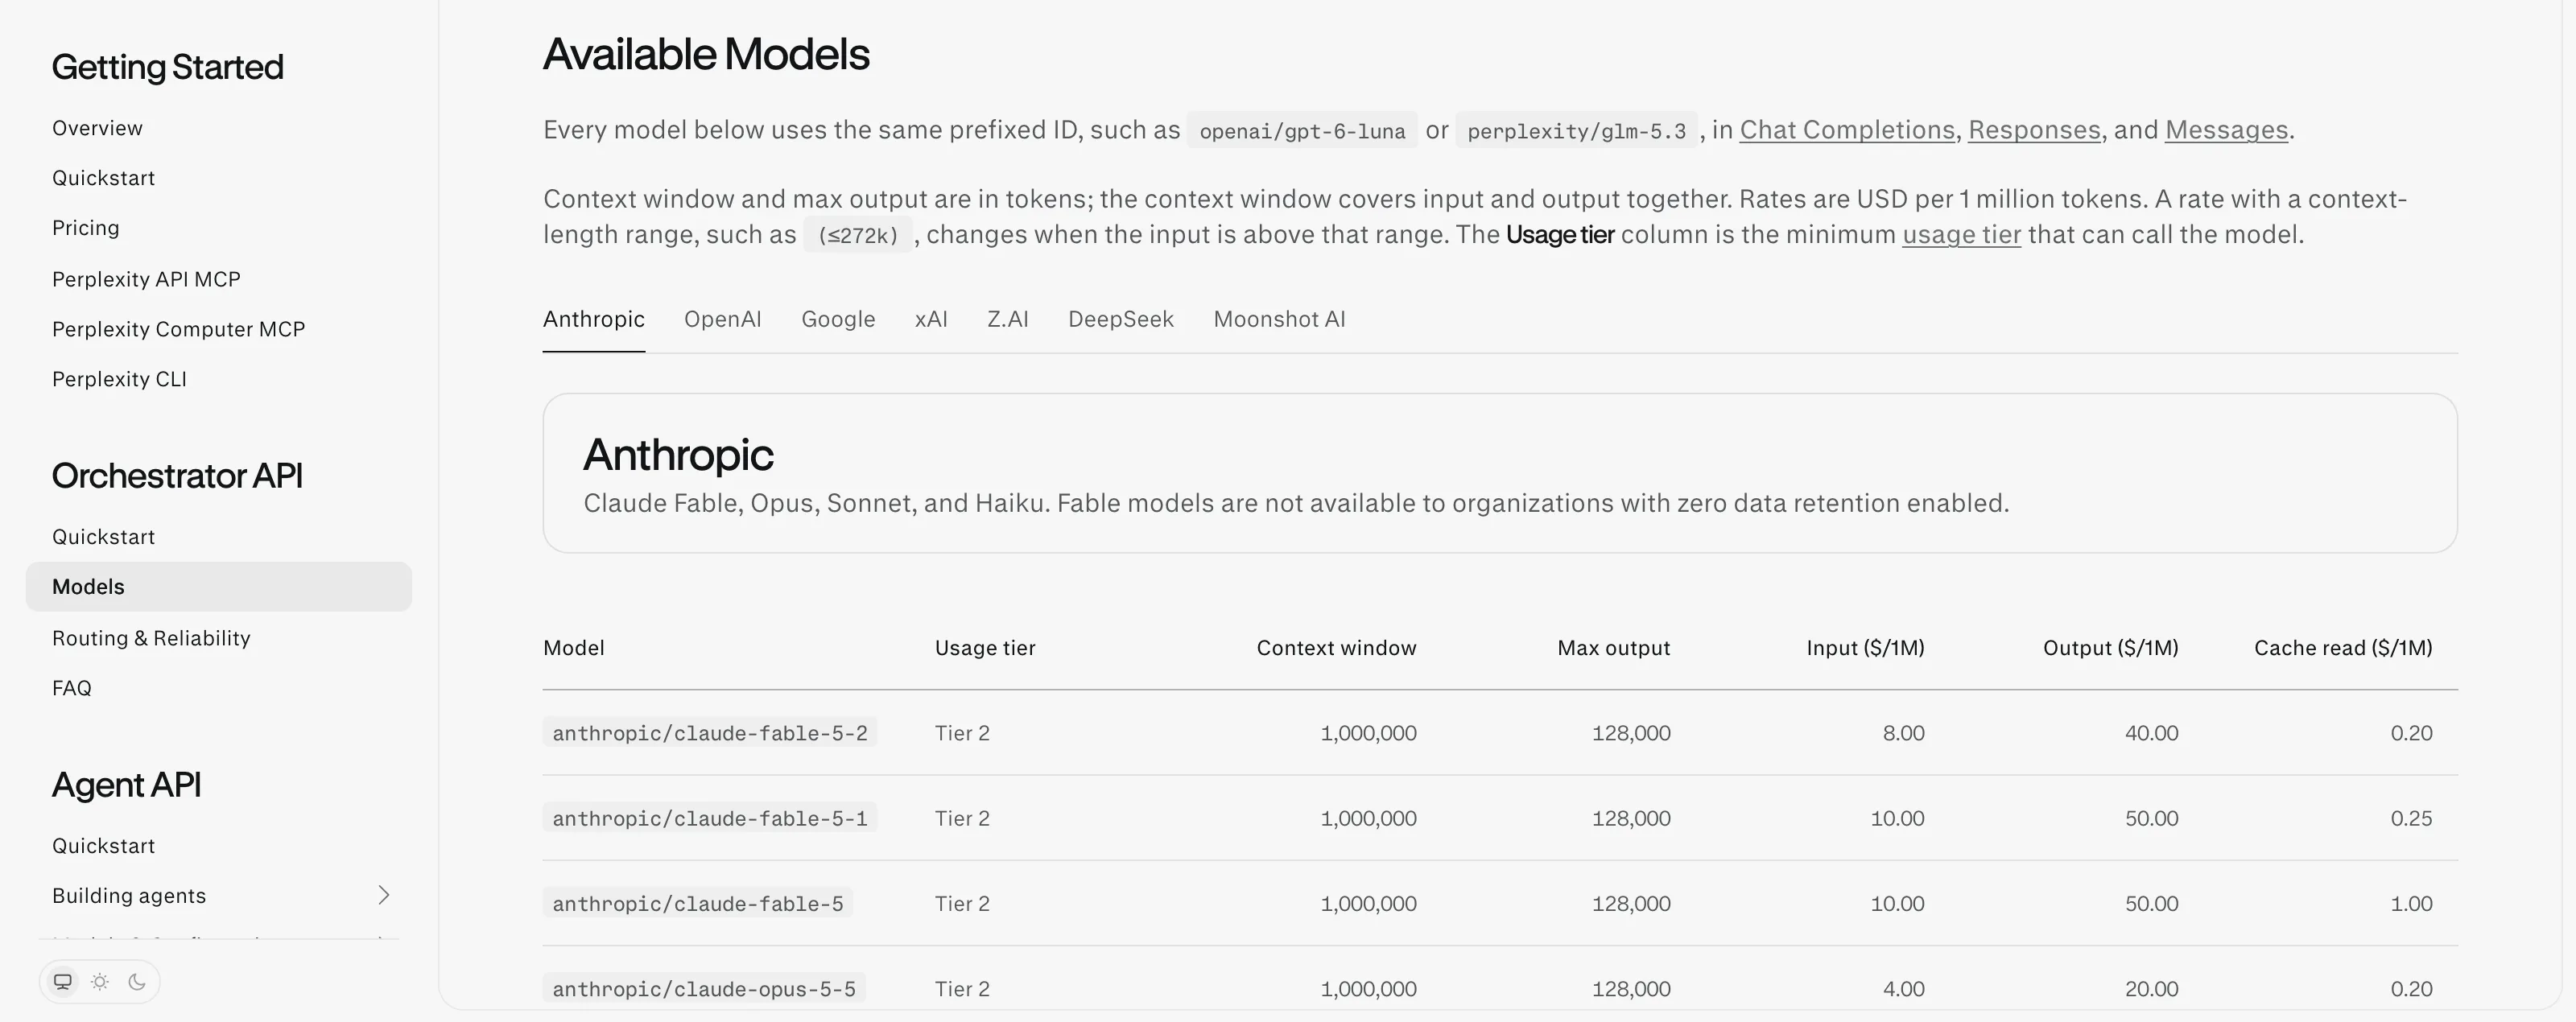
不過「目錄」按 API 組織的累計消費分層。層級定義在另一份文件上:Tier 0 是累購 0 美元的新帳戶,Tier 1 是累購 50 美元以上,Tier 2 是 250 美元以上,達成後永久保留。對應到目錄:Google、xAI 與開放權重共 12 個模型 Tier 0 就能呼叫;OpenAI 與 Anthropic 的 33 個模型要 Tier 1;Claude Opus 5、Opus 5.5 與 Fable 三款要 Tier 2。層級不夠的請求回 HTTP 402,錯誤文案還點明促銷點數不算數(not available for use with promotional credits)。
層級也掛著限速,但這裡要誠實一點:Orchestrator 文件本身沒有列各層的每秒數字,只確認重設間隔一秒,所以請求上限是每秒制的,被 429 擋下的請求不計費,照 Retry-After 間隔重試即可。平台同一份分層文件的每秒上限表寫在 Agent API 段:Tier 0 每秒 1 次、Tier 1 每秒 3 次、Tier 2 每秒 8 次,Tier 3 到 5 依序是 17、33、33。要在短時間掃整批文件的批次應用,先在現行頁面確認自己層級的每秒額度,要提高上限得填官方的限流申請表。
另外兩個細節容易漏:GET /orchestrator/v1/models 只列出你的層級能呼叫的模型,而且不套用零資料保留與組織模型設定,所以啟用 ZDR 的組織在清單裡仍會看到 Fable,真的呼叫才會回 403。另外目錄之外還有 10 個模型開放寫信申請,包括 google/gemini-4-carbon、perplexity/kimi-k3.1-pro、qwen/qwen3.7-max 等,受授權、資料駐留與容量核准,目錄不是上限。
計費按服務模型的牌價走,沒有逐請求費用,auto 模式按實際服務的模型計。回應的 usage 會分桶回報輸入、輸出、快取讀取、快取寫入與推理詞元,但沒有金額欄位,成本要自己乘牌價。有三個數字最容易在預估時漏掉。
輸入超過門檻後的雙費率。不少模型有兩段牌價,例如 openai/gpt-6.1-sol 輸入在 272k 詞元以下是每百萬詞元 2 美元、超過變 4 美元,輸出也從 10 美元變 15 美元。小樣本測試的成本直接套到長文件任務,會低估一倍;這類雙段牌價的遷移對帳,在 Qwen4-Max 正式版 上線時也出現過。
快取寫入的溢價。快取讀取有獨立的低費率,但 Anthropic 模型與 GPT-6.1、GPT-6、GPT-5.6 寫入快取要付 1.25 倍輸入率;Anthropic 另有 1 小時快取選項,寫入收 2 倍輸入率,其他模型送 ttl: "1h" 會回 400。同一份系統規則要不要進快取、進多久,是成本決策。
推理詞元按輸出率計費,而且內容不回傳也要付。文件範例裡 perplexity/glm-5.3 回一個兩句話的答案,1017 個輸出詞元中有 922 個是推理。畫面上很短的答案,帳單上未必短。各格式回報欄位也不同:OpenAI 兩種格式的總輸入已含快取讀寫、總輸出已含推理,乘費率前要先扣掉重疊桶;Messages 的三個輸入欄位不重疊,各自計價即可。還有一個會讓帳單對不上牌價表的欄位:service_tier 在 OpenAI 模型上另外接受 flex 與 priority,回應標示為 flex 時詞元費率乘 0.5、priority 乘 2;其他模型送這兩個值回 400。牌價表上的數字是基準,實際費率還要看請求自己帶的服務層級。
快取的開啟方式因模型家族而不同,這對多模型應用是真的工程負擔。OpenAI 模型自動快取重複前綴,文件實測數字是 639 詞元的提示沒有觸發快取、1259 詞元的有;Anthropic 模型要自己下標記,/messages 用 cache_control,/chat/completions 與 /responses 在可重用前綴的最後一段加 prompt_cache_breakpoint,沒有標記就完全沒有快取。標記後前綴快取 5 分鐘。
這套差異跟前面的路由設計會互相影響。auto 模式每輪可能換模型,而每個模型有自己的快取;跳到 Anthropic 模型的那輪沒帶標記,快取就是零。備援把請求換到另一個部署,命中的是冷快取。官方把這些互動都寫進了文件,結論也誠實:要固定模型行為就直接指名模型,不要依賴對話黏著。
失敗處理的邊界,官方寫得明白:請求在產出前失敗不計費;所有部署都失敗回 HTTP 429 帶 Retry-After,間隔後重試安全;串流開始後失敗會收到 in-band 錯誤事件,未正常結束的串流要當不完整處理,已送出的詞元照計費。
決策模型是哪個模型,文件沒有揭露,只描述它讀什麼、怎麼截斷長對話(保留系統指令、第一個使用者請求與近期輪次,送給服務模型的請求本身不縮短)。同一個決策模型在 ZDR 組織裡也以零保留運行,這有寫;它是誰,沒寫。
部署供應商清單也沒有。文件只說一個模型 ID 可由多個部署服務、流量按健康度分配,至於這些部署由誰營運,未揭露。零資料保留預設關閉,需要書面協議與帳號層設定才能開啟,ZDR 組織呼叫三款 Fable 會回 403;資料治理條件要自己放進模型的允許清單。
時效相關的兩個變動項:自動路由官方自己標為預覽,規則可能調整;google/gemini-3.8-flash 與 gemini-3.7-flash 的牌價註明只適用到 2026 年 12 月 31 日。目錄計數與費率都會漂移,45 個模型與所有牌價以 11 月 18 日的文件為準,導入前值得再看一次現行頁面。
遷移的驗收順序,文件的結構其實已經給了暗示:固定模型先通,路由後上。
先挑一個文字任務,用指名模型跑通格式與錯誤處理,把 usage 各桶留成紀錄對牌價。多媒體應用直接測 default_model 的媒體支援。兩個除錯線索先記下來:推理模型在寫出第一個內容詞元前會先思考,等待時間隨 effort 變長,想看到進度就開串流,安靜不等於卡住;max_tokens 給太小時輸出預算會先被推理吃掉,finish_reason 回 length、內容回 null,文件的例子是同一個單詞提示,perplexity/glm-5.3-flash 在 max_tokens 給 20 時內容全空、給 400 就完整。另外 thinking 欄位只有 /messages 接受,送到 /chat/completions 會回 unknown field;claude-sonnet-5-5 也拒絕固定思考預算,要改用 adaptive 搭配 output_config.effort 控制強度。開 auto 之後,把 model 欄位與 autoroute 標頭一起記下來,同一類請求經常分錯就先修路線描述,不要急著加模型。測試與正式流量分專案、分金鑰,API Console 的 Billing 頁可以按模型與金鑰拆帳。服務多終端使用者的應用,每個請求帶 Perplexity-Safety-Identifier 標頭,供應商封鎖會落在單一識別碼上,不會拖垮整個組織。
在模型閘道這個市場,Perplexity 這次的定位可以從路由設計讀出來:模型層開放程式化,部署層整個收走。同樣在做路由的還有 OmniRoute 與 Vercel AI Gateway 的 virtual models,計費與資料流向的取捨各不相同;Perplexity 自家產品線裡,Decider 檢查點與 Decisions API 已經先走了一步,從輸出端補上可回查的位置資訊。把 Orchestrator 當成搜尋產品的附屬品會看錯方向,它對上的,是已經在用 OpenAI 或 Anthropic SDK 的那一批開發者。