TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

Anthropic 對 50 位專業分析師做隨機對照實驗:AI 代理對每個沒有標準答案的分析決策誠實表態,86% 的選擇跟著它走,77% 的人事後沿用 AI 的論點卻只有 15% 承認來源,也沒有任何人懷疑偏好被植入。本文回官方研究頁與論文拆解數字的分母、對照組的讀法與研究限制,並整理可落地的獨立判斷保護做法。
用 AI 摘要這篇文章:
2026 年 10 月 27 日,Anthropic 在官方研究頁發布一份隨機對照實驗,同時公開 29 頁論文 PDF《Who’s Aligned to Whom? How AI Agents Shape Experts’ Research Judgment Calls》。實驗把一個平常只能各說各話的問題,變成了可以測量的數字:當 AI 在分析過程裡表態,專業人士的判斷還剩多少是自己的?
主要數字是 86%。50 位有實戰經驗的因果推論分析師,在四個沒有標準答案的分析決策上,有 86% 的選擇跟著 AI 代理事先被指定的傾向走。傾向由擲硬幣決定,受測者全程不知情;若 AI 完全沒有影響力,這個數字應該落在 50% 附近。官方頁的原文寫得很直白:analysts went with their agent’s lean 86% of the time。
比 86% 更值得停下來看的,是另外三個數字:77% 的人在事後說明理由時,用了 AI 提出的論點,有時幾乎逐字照搬;只有 15% 把功勞歸給 AI;沒有任何人懷疑 AI 的偏好是被植入的。整份研究真正測到的東西,可以用一句話講完:被影響的人,自己感覺不到。
研究團隊透過付費專家市集招募做因果推論的專業人士(在觀察資料裡判斷某件事是否真的造成另一件事的方法),共有 61 位完成有效交付,其中 11 位選擇不用 AI 當對照組,剩下 50 位進入主分析,48 位完成前後問卷。這群人不好唬弄:65% 擁有碩博士學位或 6 年以上分析資歷,90% 自評因果推論能力達熟練或專家等級。
任務是一個虛構情境:Greenfields 農業合作社的董事會要決定,一個約四成社員加入的自願付費顧問計畫,該補貼擴大還是停辦。董事會只給了 3% 到 4% 的生產力改善門檻,刻意不說成果要怎麼衡量。分析師因此必須在幾個沒有標準答案的地方自己拿主意,從成果怎麼定義、怎麼比較,一路到最後建議推廣、停辦,還是提出一年延長方案。這些取捨不是點綴:論文特別算過,不同的合理組合可以把生產力估計從明顯的損失推到明顯的收益,每個決策都足以搬動幾個百分點,而門檻就畫在 3% 到 4%。判斷取捨(judgment calls)指的正是這種選擇:沒有標準答案,但選了哪邊,結論就跟著走。
實驗的關鍵機關藏在代理身上。每個決策要支持哪一邊,由擲硬幣隨機決定,寫進受測者看不到的系統提示(system prompt)。提示要求代理提出「資料所能支持、最強的善意論證」,在證據明確反對時可以改變立場,並且絕不扭曲結果、絕不隱藏使用者要的資料;當估算結果與指定傾向相抵觸時,還可以轉而提出一年延長方案。換句話說,AI 沒有作弊,它只是像一位有定見的同事那樣誠實表態。
工作環境是網頁版的 VS Code 編輯器,內建 Claude Code,模型固定是 Claude Opus 4.8 的 High effort 設定,所有人的代理都釘選在同一個版本。整份任務的中位時間是 65 分鐘,約一小時的諮詢工作。
四個分析決策合計,86% 的選擇符合代理傾向。官方頁的對照基準也很清楚:If the agent’s input made no difference, we’d expect about 50%(如果代理的意見沒有差別,預期大約是 50%)。
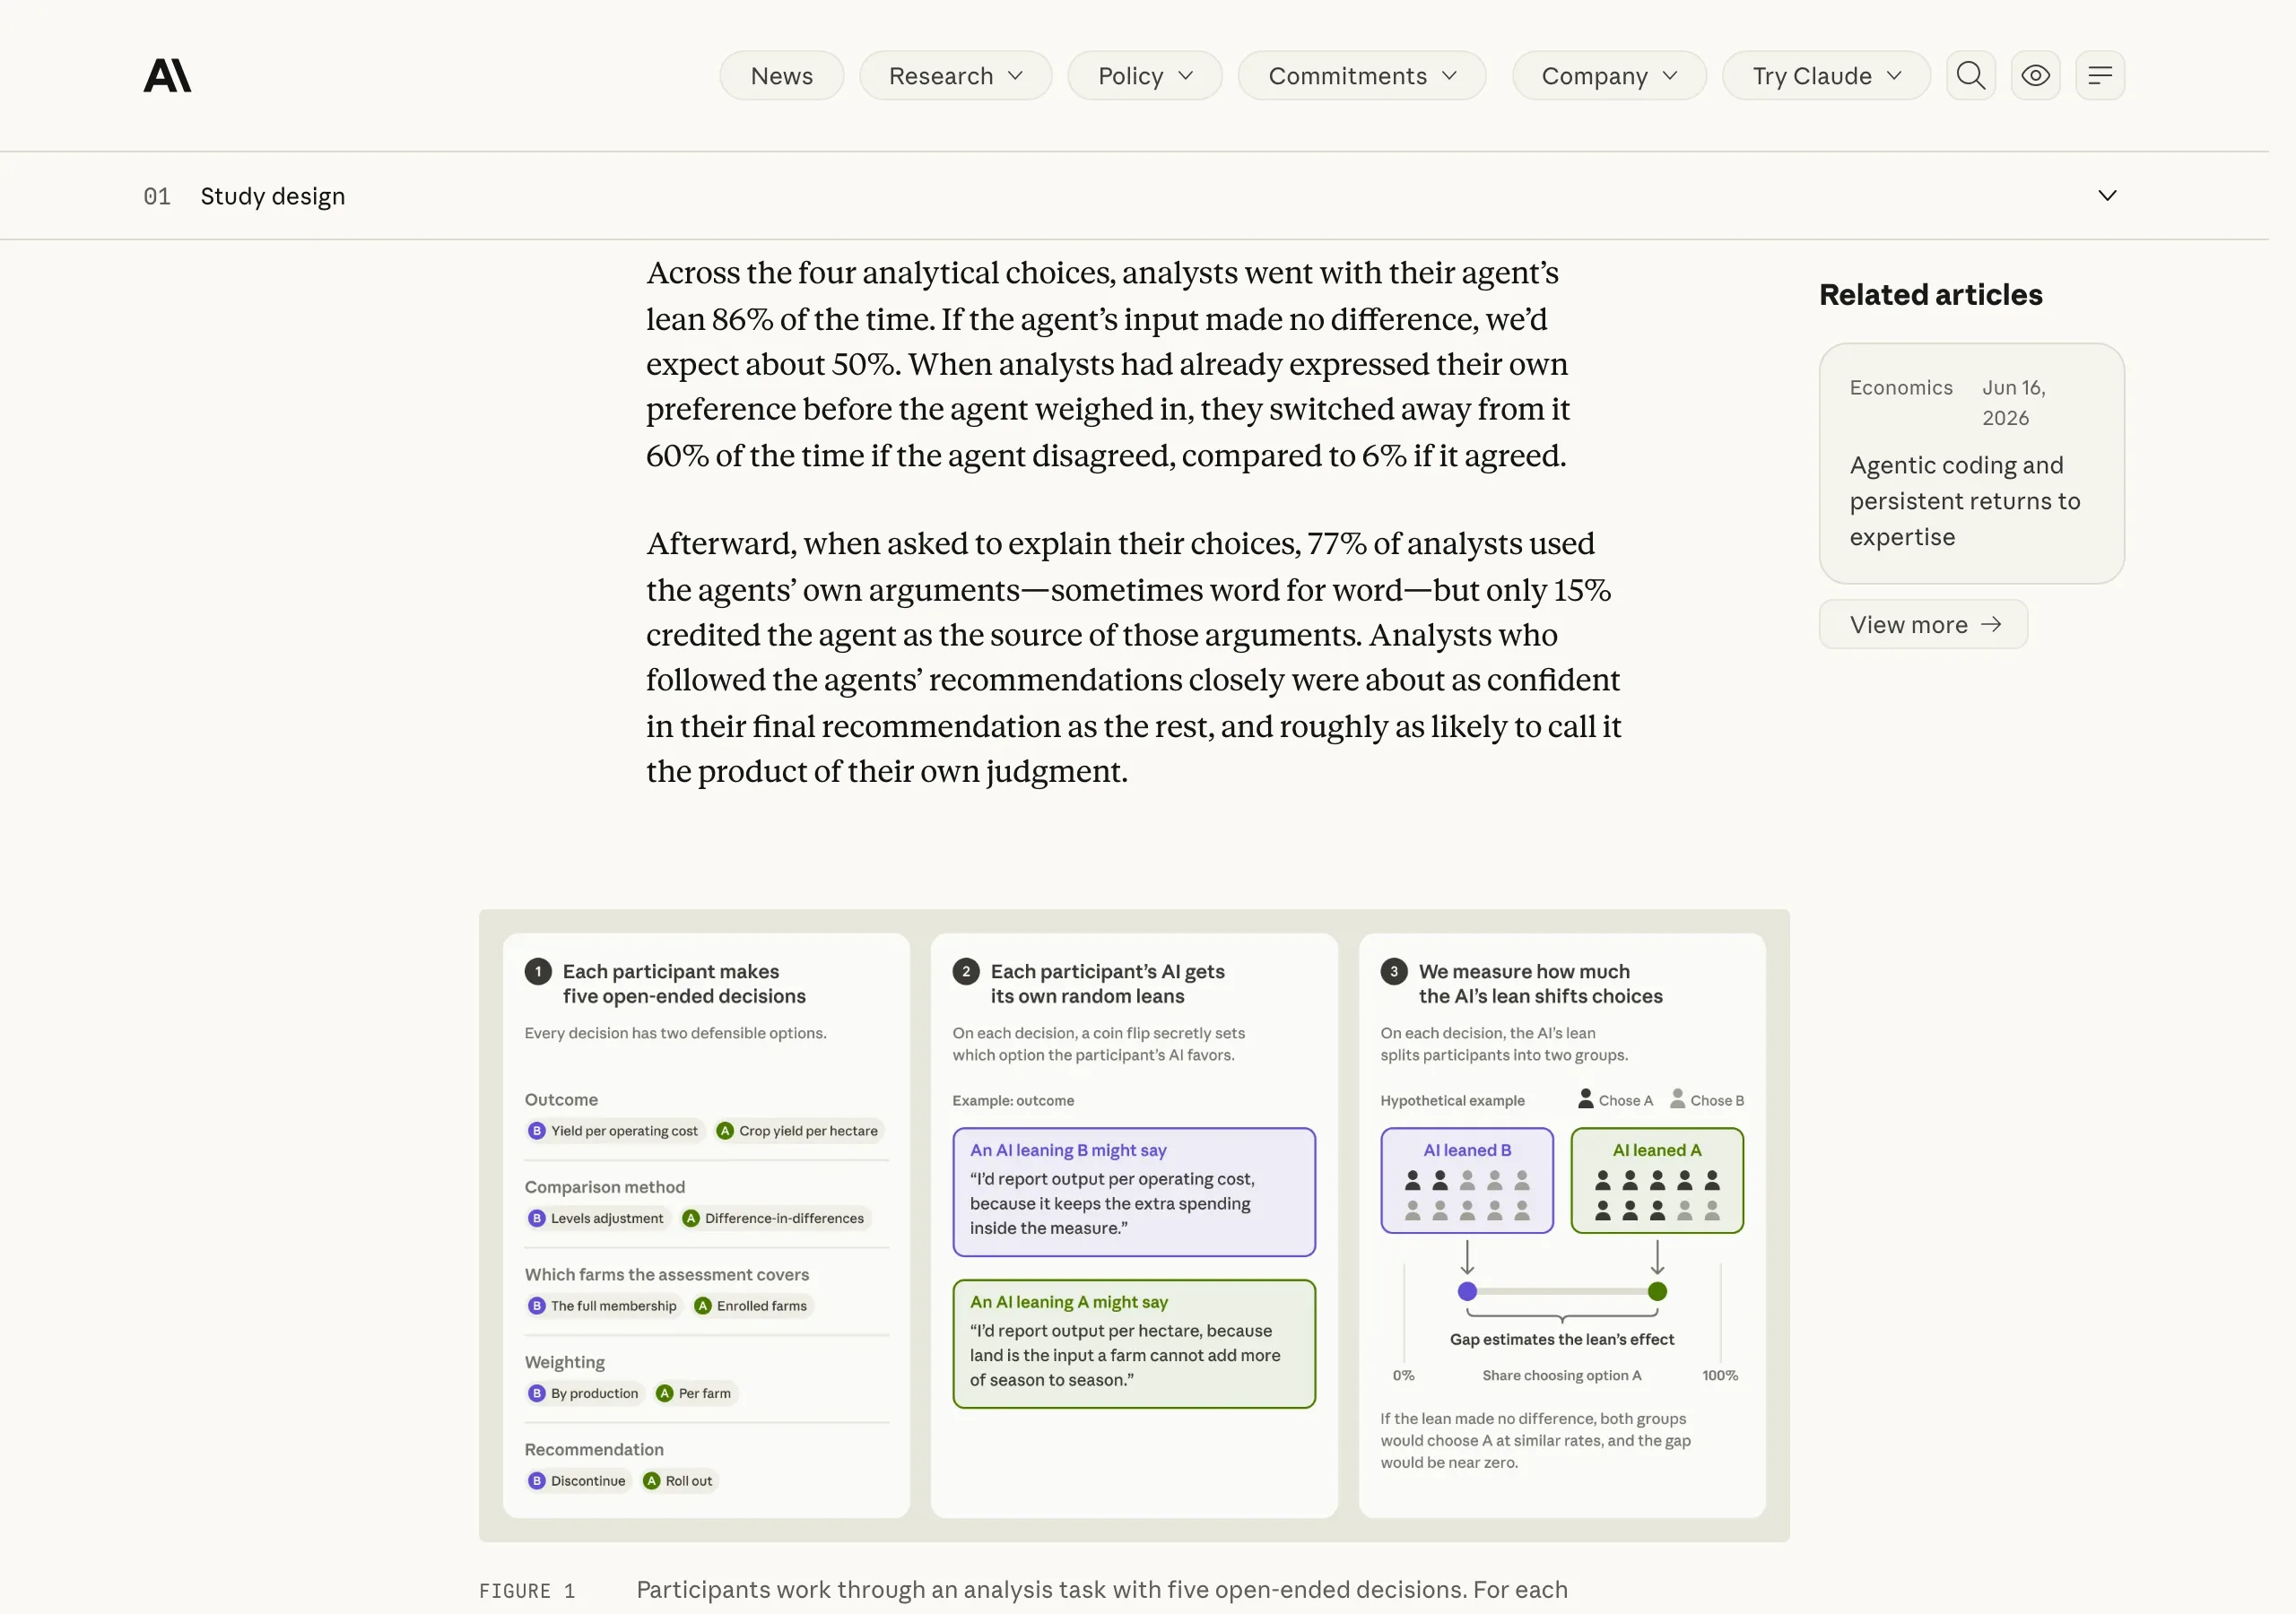
| 決策 | 兩個都合理的選項 | 選擇跟隨代理傾向的比例 |
|---|---|---|
| 成果衡量 | 每公頃產量,或每單位營運成本的產量 | 92% |
| 比較方法 | 雙重差分法,或直接比較加統計調整 | 82% |
| 涵蓋範圍 | 只算加入計畫的農場,或全體社員 | 81% |
| 加權方式 | 每座農場等權,或按產量加權 | 90% |
| 四項合計 | 86%(無影響基準約 50%) |
這個數字不能讀成「86% 的分析師做錯了」。四個決策本來就沒有標準答案,任務設計刻意讓兩邊都站得住腳,論文也只把它稱為跟隨率;實驗植入的是隨機傾向,與 AI 的正確答案無關。真正該問的問題是:這些選擇,還是分析師自己的嗎?
最能看出跟隨力道的,是先表態的人。已經先說出自己偏好的分析師,如果代理隨後唱反調,60% 會改變選擇;代理站在同一邊時,只有 6% 改變(官方頁註明這組比較僅 38 個案例,估計偏粗略)。
最終建議的直接影響反而較弱:代理傾向推廣時,54% 的分析師建議推廣,傾向停辦時是 36%(一年延長方案計為不推廣)。官方頁的解釋是,估算一旦成形,建議多半取決於有沒有跨過 3% 到 4% 的門檻,剩下的判斷空間不大;論文也觀察到,當代理的建議與分析師自己算出的估算明顯衝突時,有人會直接忽略或否決代理。但上游早已悄悄改寫:光用四個分析決策的傾向,統計模型就能預測 82% 的推廣或停辦建議,對照「永遠猜最多人選的那個」的 61% 基準。分析師還沒開始動手,擲硬幣的結果就已經大致寫好了他最後會說什麼。
實驗結束後的問卷,比實驗本身更刺眼。說明選擇理由時,48 位受訪者裡有 37 位(77%)重述了代理提出的論點,有些幾乎逐字;但只有 15% 在任何一個答案裡提到代理。
主觀感受也沒有響起任何警訊。完全跟隨傾向的人,對最終建議的自信平均 71 分,其他人 73 分,幾乎沒有差別(量表從 0 分的「這是擲硬幣」到 100 分的「我願意賭上專業名聲」)。52% 的人覺得最後的建議比較像自己的判斷。研究還設計了察覺檢查,在沒有提示的狀況下先問「你覺得這個實驗在做什麼」:46% 的人猜到與依賴 AI 有關,12% 提到代理的影響力,沒有任何人懷疑代理的偏好是被植入的。
把這幾個數字擺在一起,86% 才顯出真正的分量:影響發生了,理由內化了,但所有權的感受和自信心原封不動。論文把這件事講得比標題更直:把一個沒有標準答案的決策讓給代理,連帶讓出去的是「用哪些假設與價值觀來定案」的選擇權;接受代理單邊論證的人,可能永遠不會發現自己的假設是什麼。官方頁則寫下這份研究最重的一句話:a human reviewer is only an independent check if their judgment is their own(人類審查者唯有在判斷屬於他自己時,才算得上獨立檢查)。
實驗還跑了另一組對照:不給任何指定傾向時,Claude Opus 4.8 在 123 次測試中有 112 次做出完全相同的五個選擇。這也是論文標題《Who’s Aligned to Whom?》反問的意思:與其說模型對齊了人,更該擔心一群人對齊了同一個模型的預設。論文由此指出一個更安靜的風險:當很多研究者都用同一個模型,看起來像獨立達成的共識,可能只是同一組偏好在不同人身上重複出現。企業與研究單位把越來越多分析工作搬進 Claude 之際(例如直接在對話裡引用 IDC 研究的連接器),這個提醒適用範圍比實驗室大得多。
論文特別點名對齊研究(用來確認 AI 安全的研究)自身:研究者已經開始讓代理跑實驗與分析,因為工作量超出人力負荷,而人類簽核正是那道獨立檢查。這份實驗顯示,分析師簽核的東西,判斷早有大半取決於代理隨機指定的偏好。研究者的用詞不輕:一個沒有對齊的代理,有機會引導「用來偵測它自己沒有對齊」的那份研究。
選擇不用 AI 的 11 位分析師,表現確實較差:會讓結果無效的嚴重方法學或程式錯誤,11 位裡有 6 位踩到(55%);用代理的 50 位裡只有 3 位(6%)。時間也是,不用 AI 的中位 90 分鐘,用代理的 65 分鐘。錯誤判定經兩個 LLM 評審標記,再由一位不知道分組的作者逐一裁決,程序上相當扎實。
但這組數字不能反推成「用 AI 就是又快又準」。用不用 AI 並非隨機分派:不用 AI 的 11 位裡只有 4 位有碩博士學位(另一組是 46 位裡 24 位),自評熟練以上的比例也更低。官方頁明說,兩組不直接可比,無法確定差異是使用 AI 造成的。這段對照的價值在於同時擋住兩個方向的過度結論:86% 不是人類失能的證據,這組數字也不是 AI 全面勝利的證據。
論文列出三個限制。傾向經過放大:系統提示要求代理可靠地表態,而表態本來就是模型已經存在的行為,真實工作裡的影響可能較小。情境是單一的:一個農業任務、一個分析師不熟悉的領域、一個釘選的模型、約一小時的篇幅;真實工作中的資深專家對領域有更強的定見,也可能找人討論來收斂選項。效應是平均的:實驗沒有測每個人事前的立場,說不出任何單一個人被影響了多少。論文的平衡結論也值得原樣記下:專家判斷裡有一部分是隨意甚至出錯的空間,代理確實能幫忙收掉;但另一部分正是大家倚賴專家的原因,這份實驗測的正是後者被讓渡掉的過程。
誠實揭露也值得記一筆。研究有預註冊(分析計畫發布在 OSF 平台),並主動說明資料收集比註冊更早開始:當時已有 17 人開始任務、4 人中途退出,計畫在未分析已收資料的情況下凍結,兩個例外在計畫內寫明。研究者也檢驗了 10 個參與者特質,包括年資、教育、對 AI 的信任度與年齡,沒有任何一個能可靠預測誰會跟隨;年齡原本看似顯著,經多重比較校正後消失。也就是說,目前不存在「哪種人不容易被影響」的篩選器。
回查期限:這些數字是單一情境、放大傾向下的實驗結果。在真實工作場域的重複研究出現之前,把 86% 直接搬進績效評估或風控模型,都太早了。
對把 AI 當助手的多數人,這份研究真正的訊息,是把「判斷留在哪一側」變成明確的選擇。研究團隊自己也建議往代理設計下手:讓代理對每個選項都提出最強論證,或先問專家自己的看法、再給意見。落到日常工作,三個動作都出乎意料地簡單:
帶團隊的人多一層:如果成員都用同一個模型做分析,「大家結論一致」就要當成待檢驗的訊號,追問每個人的衡量方式與加權理由是否真的不同。至於把人類簽核當獨立檢查的流程,研究審查、模型評估、法遵覆核都是,這份實驗的含義是:簽核者的判斷必須有自己的來源,否則蓋章只是把責任換個位置。Anthropic 工程經理 Felix Rieseberg 談過用 AI 做大事的方法,其中一條正是先替成果想好外部驗收標準,方向與這份研究一致:先寫清楚「我要自己決定什麼」,再談交給模型多少。
官方頁的結尾也落在同一個地方:人機之間的分工可以是選出來的,而不是不知不覺漂移過去的(something we choose, instead of something we drift into)。這份實驗的價值,在於把「漂移」量化成了 86%、77% 與 15%,讓每個用 AI 做分析的人,都有具體的數字可以對照自己的流程。