TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

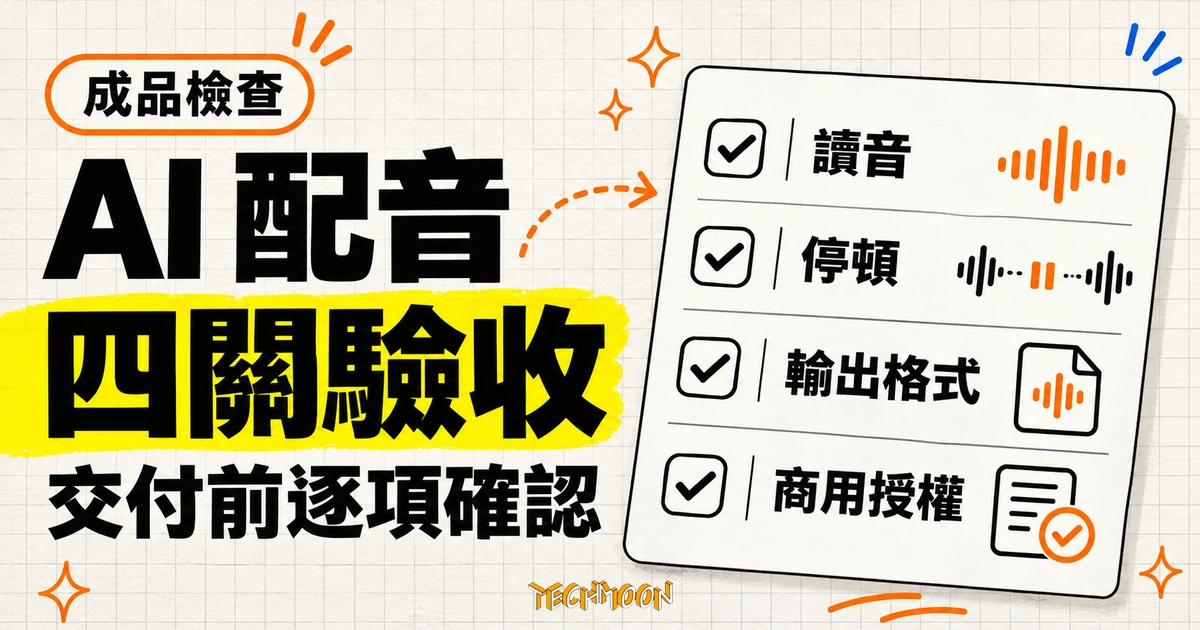
VoAI 中文配音要驗收的不只聽感:破音字與數字讀法沒有修正工具,只能改寫文字稿;停頓在網頁版與 API 是兩套不能混用的語法;輸出格式與下載權限跟著入口與方案走;商用資格畫在付費牆與 AI 標示義務上。本文對照官方使用教學、API 文件、價格頁與授權協議,整理成四關檢查表與五個失敗症狀的排解對照。
用 AI 摘要這篇文章:
AI 配音生成完,離可以上線還有一段路:字有沒有念對、停頓有沒有落在想停的位置、下載到的檔案能不能進剪輯流程、這支成品可不可以收錢,四件事各有各的檢查標準。VoAI 是網際智慧與子公司絕好聲創營運的 AI 語音服務,官方定位超擬真台灣口音,提供 73 位 AI 聲優與 Mosa、Sota+、Neo、Classic 四個聲音模型。這篇把官方使用教學、Connect API 文件、價格頁與服務使用者授權協議攤開對照,整理成可以逐項打勾的驗收流程。
先畫清楚這篇的範圍。文內所有數字與規則都對回官方文件:使用教學的更新日期是 2026 年 11 月 11 日,服務使用者授權協議的版本日期是 2026 年 2 月 14 日。我沒有實際生成音檔,所以聽感、自然度這類要用耳朵判斷的項目,只提供檢查方法,不給評分;模型之間的好壞比較,也以官方自己的比較表為準。
驗收拆成四關:讀音(字念得對不對)、停頓(節奏控制用的是哪套語法)、輸出(拿到的檔案格式與下載權限)、授權(能不能商用、要不要標示 AI 生成)。每一關都有官方參數可以對照,驗收不再只是「聽起來還行」。
先處理最容易讓人出戲的一關。中文配音常見的錯讀集中在三類:破音字(「重新」的「重」讀 ㄔㄨㄥˊ,「重量」的「重」讀 ㄓㄨㄥˋ)、中英混讀的品牌名與專有名詞、數字與日期的讀法。翻過 VoAI 官方使用教學與 API 文件,兩邊都沒有發音修正、破音字字典或數字讀法設定這類參數。換句話說,字念錯了沒有按鈕可按,唯一能做的是回到文字稿動手。
輸入端有幾個硬規則要先記住:短篇配音單次上限 1,000 字,句尾一定要加標點符號,注音符號與特殊符號不支援。實際的做法是把品牌名、常見破音字、數字寫法整理成一張對照表,拿真實稿件的一小段先跑一次,聽到錯字就回稿裡換同音字或調整句構,再重跑該段。不要只拿單句示範去判斷整篇,長句、數字與中英切換都會增加變數。
這裡有個容易誤判的點:介面上的試聽只播前 20 個字,官方文件明說「僅供參考,與實際結果可能略有不同」。試聽聽的是音色與風格,不能拿來代替整段驗收;完整檔案生成之後,標記點前後要再人工聽一遍。這一步沒有工具可以代勞,因為連自動轉錄都會出錯,轉錄對上了不代表讀音正確。
想像一個實際情境:為了讓引擎把某個品牌名念成英文原音,你把稿子改成拼音寫法,發音對了,字幕卻跟著變成奇怪的字串。所以發音稿與字幕稿要分成兩份維護:發音端換字求讀音,字幕端保留正確寫法;這套分工在做影片翻譯配音時是基本功,Linly-Dubbing 這類開源配音流水線也是靠同樣的原則在運作。長篇配音支援逐段單獨重新生成,改一段不必整篇重跑,這套分工在長稿上特別有用。
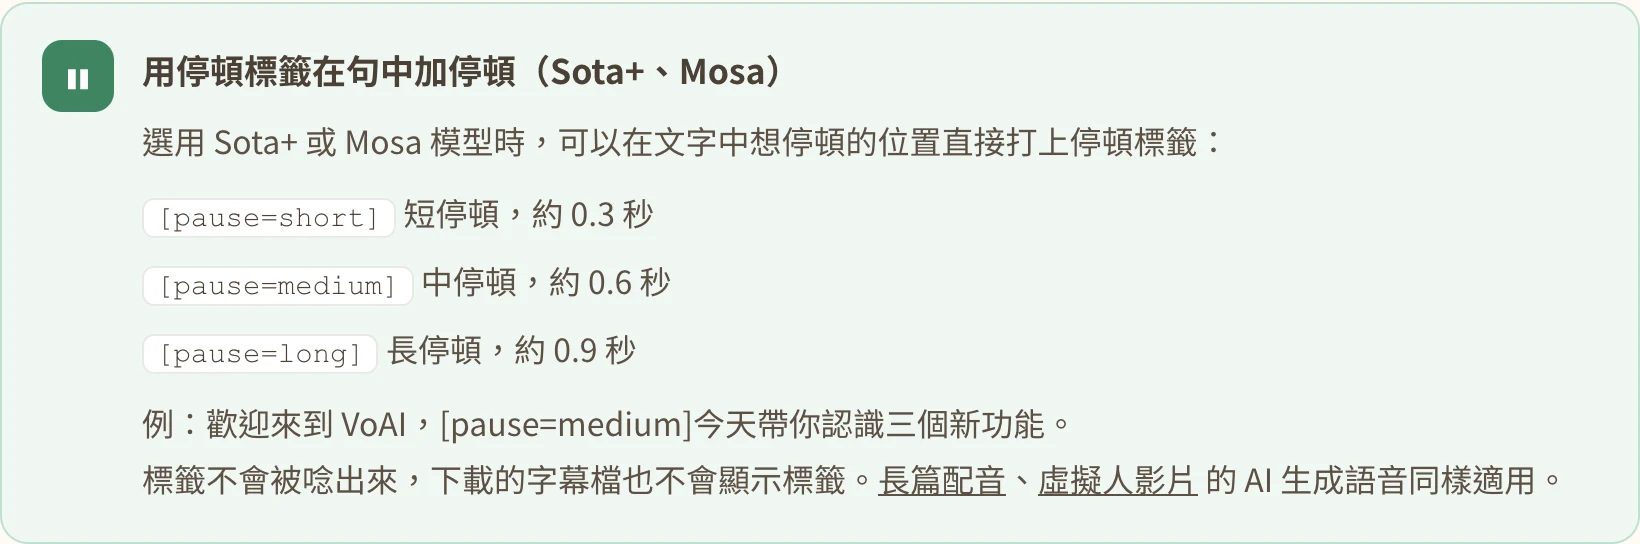
停頓是最容易踩坑的一關,因為 VoAI 的停頓控制分成兩個世界。網頁版的短篇、長篇配音與虛擬人影片的 AI 生成語音用標籤語法:在文字裡想停的位置打上 [pause=short]、[pause=medium] 或 [pause=long],對應約 0.3、0.6、0.9 秒。這組標籤只有 Sota+ 與 Mosa 兩個模型支援,標籤本身不會被念出來,下載的字幕檔也不會顯示標籤。
API 端是另一套。Connect API 的簡易端點 /TTS/Speech 不支援任何停頓標籤;要控制停頓必須走進階端點 /TTS/generate-voice,語法是 [:秒數],例如 [:2] 表示停 2 秒。規則寫得相當具體:有效位數到小數點後一位、最多 5 秒(超過一律視為 5 秒)、兩個標記之間以及標記與開頭結尾之間的文字建議不少於 20 字。
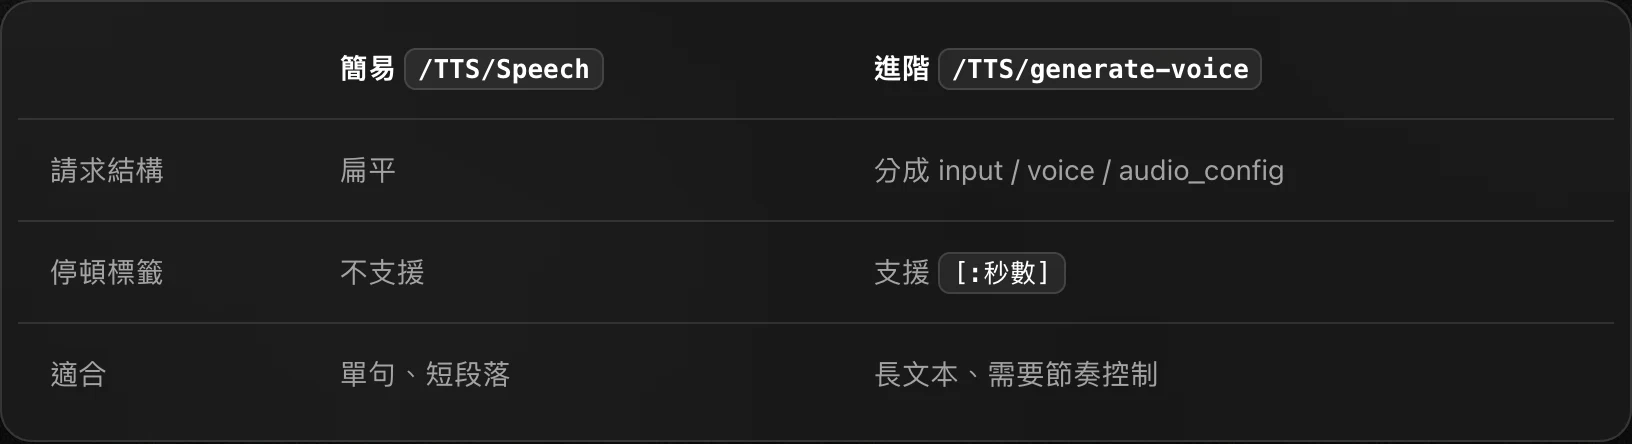
把網頁版標籤貼進 API 文稿,或把 [:2] 貼進網頁版文字框,後果都一樣:停頓失效,或者標籤被當成內容念出來。停頓驗收時最該優先確認的項目就是:這份文稿走哪個入口,就用哪套語法,兩邊不能混。
長篇配音還有另一個停頓入口:段落之間可以用「新增靜音」插入 0.1 到 60 秒的停頓,不靠標籤。長篇每段上限 500 字、整個專案上限 8,000 字。做多角色對話時,段落間的靜音與句中的標籤是互補關係:前者管換氣與轉場,後者管一句話裡的節奏。
停頓語法綁在模型上,選模型之前先看官方比較表怎麼定位四個模型:
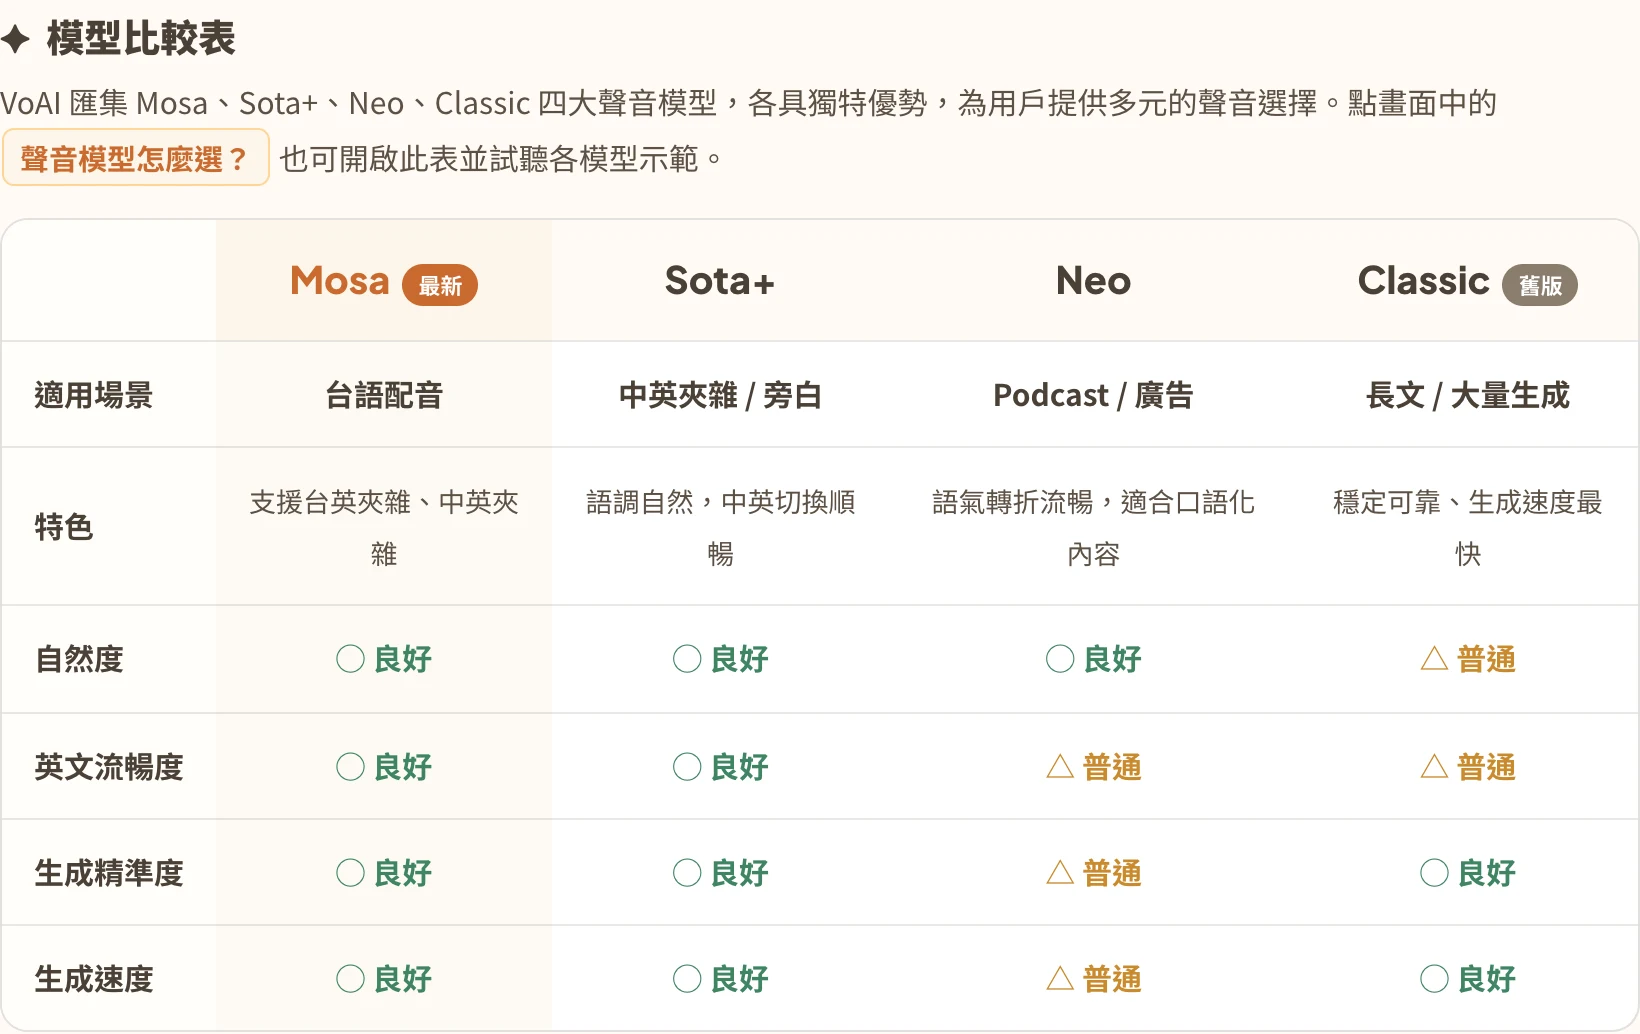
| 模型 | 官方定位 | 網頁版停頓標籤 | 官方評級摘要 |
|---|---|---|---|
| Mosa | 最新,台語配音 | 支援 | 支援台英與中英夾雜,各項評級良好 |
| Sota+ | 中英夾雜與旁白 | 支援 | 語調自然、中英切換順暢,各項評級良好 |
| Neo | Podcast 與廣告 | 不支援 | 語氣轉折流暢,英文流暢度、生成精準度與生成速度評級普通 |
| Classic | 舊版,長文與大量生成 | 不支援 | 穩定、生成速度最快,自然度與英文流暢度評級普通 |
這張表的定位與評級都出自官方使用教學的模型比較表,不是本站實測。要台語的專案沒有選擇空間:台語與台羅拼音(需帶調號)只有 Mosa 能生成,API 端的台語優先參數 nan-TW 也只對 Mosa 生效,其他模型帶了會被忽略,而且 Mosa 在 API 需要另行開通。
輸出這關看的是拿到的檔案。網頁版的音檔下載支援 wav 與 mp3,成品統一收在「生成紀錄」,可以播放、下載、產生分享連結與 QR Code;字幕檔在虛擬人簡報功能明確是 srt 檔,配音訂閱方案的輸出項目也列有字幕檔。驗收時把檔案丟進剪輯軟體播一次,同時打開字幕檔對時間軸,這關才算過。
API 端用 x-output-format 標頭指定格式,共三種:wav 是預設,完整生成後才回傳;mp3 檔案較小,適合網路傳輸;pcm 是串流模式,邊生成邊傳輸、延遲最低,但免費額度不含 pcm,要購買 API 點數才能使用。還有一個但書:音調參數 pitch_shift 設成非 0 時無法串流,即使指定 pcm 也會等完整生成才回傳。每次回應都會附 x-used-quota 標頭,標明這次消耗的點數,對帳可以直接從這裡讀。
採樣率用 x-sample-rate 標頭指定,可填 8000、16000、32000、44100,但上限跟著模型走:Classic 預設 44100,Neo 上限 32000,Sota+ 上限 24000,超過上限直接回 400 錯誤。要進後製或對接廣播規格的專案,這個數字先對清楚再生成。
下載權限是這關最容易誤會的地方。免費方案用 Mosa、Sota+ 生成只能試聽、不能下載,能下載的是 Neo 與 Classic;Starter 方案(月繳 NT$680)同樣只有 Classic 與 Neo 可下載;要到 Creator 方案(月繳 NT$1,990)才能下載 Sota+ 與 Mosa 台語。訂閱制的配音標榜不限字數,流量卻以整點計算:Starter 每個整點 3,000 字,Creator 每個整點 10,000 字,短篇與長篇分開計算,超出上限時畫面會提示可重試的台灣時間。短時間跑大批稿件時這個上限會直接決定產能。
網頁版與 API 的額度是兩本帳。網頁版訂閱吃字數流量與影像生成點數(虛擬人短影片 1 秒 10 點、簡報影片 1 秒 2 點);API 走儲值點數、點數不會過期,語音合成 1 字 1 點、虛擬人影片 1 秒 200 點,方案有 A(NT$900、9 萬點)、B(NT$6,000、75 萬點)、C(NT$18,000、300 萬點)三種,模型支援清一色是 Classic、Neo、Sota+。把 VoAI 接進 ChatGPT 或 Claude 的 MCP 入口用的也是 API 這本帳,1 字 1 點,方便歸方便,計費邏輯沒有比較便宜。
驗收完成的成品要自己下載留存。授權協議寫明平台上的檔案資料保留一個月,期滿刪除,官方並保留調整這個期間的權利;實際時限只會更短:虛擬人專案自建立後保留 14 天(訂閱後新建的專案可保留 1 年),分享音檔連結 7 天後失效。想查詢或刪除自己的資料,透過 [email protected] 聯繫。把雲端紀錄當永久倉庫,一個月後就會體驗到什麼叫雲消霧散。
授權是最常被跳過的一關。VoAI 的服務使用者授權協議把商用資格畫得很清楚:未付費的帳號(包括只用 API 免費額度的),生成內容僅限個人非商業用途,明文禁止的範圍包括廣告、宣傳、銷售、付費課程,以及上傳到開啟營利或會員分潤的影音平台,條文直接點名 YouTube、TikTok、Bilibili。免費方案生成的影片放上 YouTube 開營利,這條就已經踩線。
付費用戶拿到的是「完整且永久」的商業使用權,範圍涵蓋旁白、配音、影片、遊戲、電影、有聲書、Podcast 等內容,包含重製、改作、散布與再授權。但這個權利有明確的但書:一旦違反協議的禁止用途條款(清單涵蓋色情、詐騙等違法內容,也包括把生成內容拿去訓練 AI 模型),所有授權從違約之日起全部終止,而且必須刪除所有生成內容。商業權利不是買斷後隨便用,違約回收的是整包。
授權協議 2.4 條還有一條多數人沒注意的義務:把生成內容提供給終端用戶時,必須明確說明對方看到或聽到的內容由 AI 生成;沒做這個標示,導致第三方權益受損,公司不承擔責任。換成驗收語言:影片說明欄或片尾有沒有標示「配音由 AI 生成」,本身就要列進上線前檢查表。
API 端還有一道錢坑要避開:為了保護版權,從未購買過 API 點數的帳號,產出的音檔都會含背景音樂或浮水印,連網頁版的 Starter、Creator 訂閱戶也一樣。背景音樂跟著 API 帳號走,與網頁版訂閱無關;API 帳號買過任何點數,這個問題就不存在。如果你的驗收清單裡有「音檔乾淨無雜音」這一項,先確認帳號狀態再怪罪模型。
對資料流向敏感的團隊,協議也揭露服務使用 Google Cloud Platform、Microsoft Azure 與 RunPod 三家外部雲端。這是雲端服務的常態,不是 VoAI 特有的問題,但有內部資料規範的組織在採購前應該知道這件事,評估時可以把它與開源配音工作台 VoiceStudio 這類本機處理路線放在一起比較。
| 症狀 | 最可能的原因 | 回復動作 |
|---|---|---|
| 標籤被當成文字念出來 | 網頁版標籤貼進 API 文稿,或 [:秒數] 貼進網頁版文字框 | 改用對應入口的語法,重跑該段 |
| 停頓沒有出現 | 模型不支援標籤(Neo、Classic),或停頓語法用錯端點 | 換 Sota+ 或 Mosa,改走進階端點;段落間停頓改用長篇靜音 |
| 指定 pcm 卻收到 400 錯誤 | 免費額度不含 pcm,或採樣率超過模型上限 | 購買 API 點數;降到模型上限內,或改用 wav |
| 生成完成卻找不到下載 | 方案對該模型只有試聽權(免費與 Starter 的 Mosa、Sota+) | 升級 Creator,或先用 Neo、Classic 完成驗收流程 |
| 音檔裡有背景音樂 | API 帳號從未購買過點數 | 購買任一 API 點數方案,或改從網頁版輸出 |
排解的順序很重要:先確認入口(網頁版、API 的哪個端點,或 MCP),再確認模型,最後才看方案。三層任何一層對不上,症狀表面上看起來像故障,往下追其實是方案邊界。把這個順序固定下來,可以少走很多重複生成的冤枉路。
四關走完,驗收清單可以壓成八個格子:
| 關卡 | 檢查項 | 通過標準 |
|---|---|---|
| 讀音 | 常錯詞對照表與完整複聽 | 標記點前後人工聽過,沒有未處理的錯字 |
| 讀音 | 發音稿與字幕稿分離 | 字幕維持正確寫法,發音端可自由換字 |
| 停頓 | 語法對入口、模型有支援 | 標籤沒有被念出來,停頓落在指定位置 |
| 停頓 | 秒數對照官方值 | 網頁版約 0.3/0.6/0.9 秒;API 在 5 秒上限內 |
| 輸出 | 格式與採樣率 | wav 或 mp3 符合後製需求,採樣率在模型上限內 |
| 輸出 | 下載權限與留存 | 只把可下載的模型納入流程,成品自行保存 |
| 授權 | 商用資格與 AI 標示 | 付費方案生效中,對外已說明由 AI 生成 |
| 授權 | 內容用途 | 不落入禁止用途清單,包含訓練 AI 模型這一項 |
兩種情況建議先停下來:免費帳號但成品要商用的人,先處理方案再驗收;依賴 Mosa 台語卻要走 API 的團隊,先向官方確認開通狀態。方案價格、模型權限與停頓規則都會變動,這篇文章的數字以 2026 年 11 月查核的官方文件為準;真正簽約或大批生成之前,回 voai.ai 的價格頁與 Connect API 文件再對一次最新的表。如果你的需求是多語市場發佈,也可以把這套四關驗收法直接搬到ElevenLabs Studio 4.0 這類把配音與剪輯收進同一時間軸的工具上用,檢查的骨架是通用的;要逐句控制語氣與讀法的專案,Gemini 3.8 Flash TTS 的逐句導戲路線也值得放進同一輪比較。