TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

把 jhao104/proxy_pool 的 14 個免費代理源全部實跑一輪,429 個代理用專案自家驗證器實測:HTTP 通過 14.7%、HTTPS 只剩 1 個。池子機制真實運作,但免費代理撐得起練習場,撐不起正式任務。
用 AI 摘要這篇文章:
想在爬蟲專案裡省下代理費,大概都會遇過 jhao104/proxy_pool 這個名字:GitHub 上兩萬三千多顆星、開源十年、文件齊全,README 說它會定時採集網路上免費發布的代理、驗證後存進資料庫,再透過 API 餵給你的爬蟲。問題只有一個,而且每個想自架的人都該先問:池子裡的免費代理,到底有多少能連線?
我在 2026 年 11 月 11 日把它的 14 個內建代理源全部跑過一輪,收到 429 個不重複的代理 IP,再用專案自己的驗證器逐一測試。結果是:HTTP 驗證通過 63 個,佔 14.7%;HTTPS 驗證通過 1 個,佔 0.2%。官方線上 demo 的即時統計也一致:池裡一百多個代理全部只標 http,用 https 參數去查,回覆是 no proxy。
這組數字直接給出答案:這個專案的機制是真實運作的,值得架來玩、來學、來撐高容錯的任務;但它撐不起任何需要 HTTPS 或穩定連線的正事。以下逐個回答自架前該弄清楚的問題。
如果你已經在跑 Crawl4AI 或 DrissionPage 這類爬蟲框架,代理池就是它們旁邊那個可插可拔的備援零件,要判斷的是這個零件值不值得裝。
先把實測攤開。clone 專案後,我跳過排程器,直接把 14 個代理源當成獨立程式逐一執行,每個源計時、計產出。當天結果:9 個源有產出、合計 429 個不重複代理;5 個源空手而回。
接著用專案內建的驗證邏輯測這 429 個代理。驗證器在 helper/validator.py 裡,HTTP 走 httpbin.org、HTTPS 走 qq.com,逾時 10 秒,跟它自己排程時用的完全是同一套函式。429 個代理、24 條執行緒跑完將近四分鐘後:HTTP 剩 63 個活著,HTTPS 只剩 1 個。
| 代理源 | 收進代理 | HTTP 驗證通過 | 觀察 |
|---|---|---|---|
| proxifly | 121 | 30 | 產出與通過數都最高 |
| scdn | 100 | 16 | 產出快但過驗率低 |
| ip89 | 40 | 0 | 收得到、連不通 |
| roundproxies | 50 | 0 | 同上 |
| freevpnnode | 30 | 0 | 免費 VPN 節點性質 |
| ip3366 | 30 | 2 | 大陸老牌免費代理站 |
| kxdaili | 20 | 0 | 免費欄位全滅,付費側未測 |
| kuaidaili | 24 | 0 | 免費欄位幾乎是展示品 |
| goodips | 15 | 15 | 量少但全數通過 |
| daili66/docip/geonode/ihuan/zdaye | 0 | 0 | 當天無產出或直接出錯 |
兩個細節值得注意。通過驗證的代理集中在 4 個源,其中 goodips 收 15 個全數通過,ip89 收 40 個全軍覆沒,源與源之間的品質差距比想像大。另外,zdaye 源在執行時直接拋出 IndexError,ihuan 源空轉了 120 秒才回報零產出,這兩個是原始碼層的問題,下面部署段會再提到。
源的身份也值得攤開看。14 個源裡,kuaidaili、kxdaili、zdaye、ip3366、89ip、ihuan 這幾個 URL 指向的都是中國大陸代理商經營的站點,免費欄位本質上是付費方案的展示櫥窗,免費代理的壽命與品質形同壓在可用邊緣;proxifly 指向的是一個開放代理清單專案,scdn 與 roundproxies 是境外清單站,freevpnnode 則名實上是免費 VPN 節點的收集頁。理解了源的身份,就理解了池子的上限:輸入端的素材本來就是各站「願意免費給」的剩餘物,再怎麼高頻複驗也變不出新東西。
還有一個容易被忽略的變因:驗證目標。setting.py 把 HTTP 驗證目標設為 httpbin.org、HTTPS 設為 qq.com,池子判斷「代理能用」的基準是連得到這兩個站。這意味著兩件事:從台灣自架時,qq.com 的可達性與在大陸伺服器上不同,同一批代理會得到不同的可用率;而這兩個網址都可以換成你自己真正要爬的目標站,讓池子直接用實戰場景校驗代理。換掉驗證目標再跑一輪統計,得到的數字才是屬於你自己的數字。
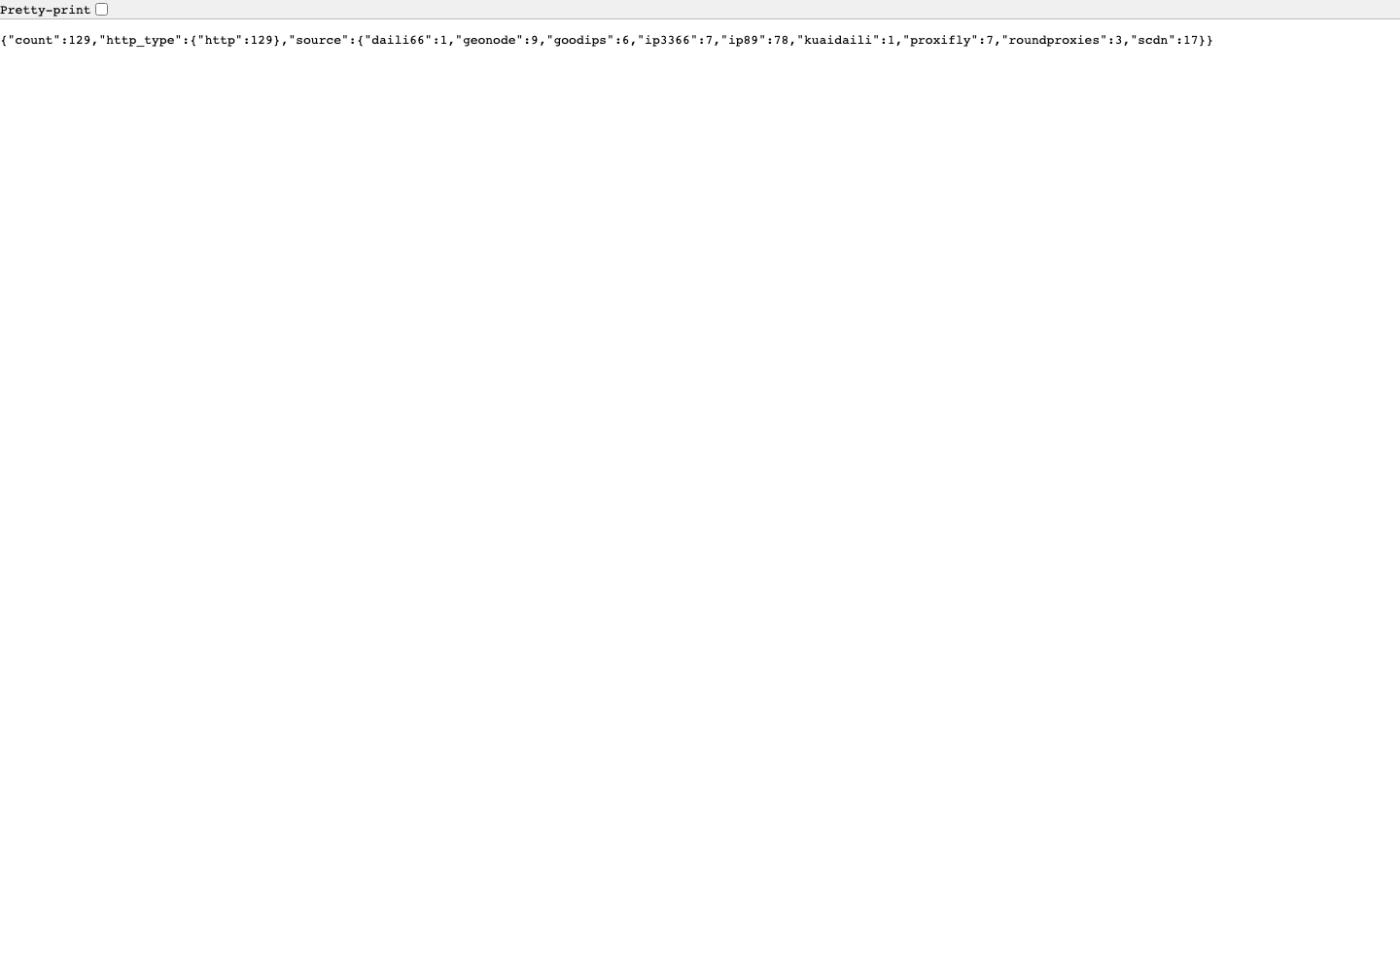
單一時點的抽樣會不會剛好撞上運氣差?拿官方 demo 對照可以降低這個疑慮。demo.spiderpy.cn 是作者持續運轉的公開實例,我查詢當下池裡有 129 個代理,http_type 統計全部是 http、https 為零;隨機抽一個代理出來看,這個 IP 已被複驗 29,322 次、失敗 0 次,上次檢查時間就是幾秒前。一個全天候跑著的池和一次性的手動實測指向同一個結論:免費代理要過 HTTP 已經要挑,要過 HTTPS 幾乎是抽獎。
免費代理的壽命以分鐘計,所以這個專案的核心價值在複驗節奏。讀 helper/scheduler.py 的設定:每 5 分鐘跑一輪採集、每 2 分鐘複驗池內所有代理,執行緒池 20 條。剔除規則寫在 setting.py,預設 MAX_FAIL_COUNT 為 0,意思是一旦最近一次校驗失敗就立刻剔出池外,沒有緩衝;同一份設定還有 POOL_SIZE_MIN 的水位線,池內代理少於 20 個就觸發抓取補貨。一進一出的高 churn 從設計上就註定:池子追求的指標是「此刻全部可用」,池深是用採集頻率換來的。
那個被驗了 29,322 次的 demo 代理,就是這套機制的活證據:一個免費 IP 要活在池裡,等於連續四十天、每 2 分鐘過一次 10 秒逾時的檢查。反過來說,你從 /get 拿到一個「現在能用」的代理,它可能在幾分鐘後就消失,爬蟲端必須照文件建議寫成取用、失敗、刪除、重取的循環,而不是把代理當固定資產。
架構上它把代理存在 Redis(或 SSDB)的 hash 裡,另起一個 Flask 服務提供 /get、/pop、/all、/count、/delete 幾個端點,/count 還會附上來源分布與 http/https 分類統計。每個代理在池裡是一個帶履歷的物件:check_count 記錄被驗過幾次、fail_count 記失敗、last_time 記最後檢查時間,另外有 https、region、source 三個屬性欄位,/get 的回應就是把這份履歷整包給你。/get 與 /pop 的差別在於後者取出的同時刪除,適合「用壞即棄」的消費模式;文件給的爬蟲範例也是這個思路,取用、失敗就呼叫 /delete、再取下一個。不想走 HTTP 的話,直接讀 Redis 那個 hash 也行,兩種取法文件都支援。
部署形態是兩個行程:schedule 負責採集複驗,server 負責 API,兩個都是 proxyPool.py 底下的子命令,另外有個 fetcher 子命令用來列出目前啟用的代理源。官方提供 Dockerfile 與 docker-compose,compose 檔裡就是兩個容器:應用本體映射 5010 埠、旁邊帶一個 Redis,環境變數 DB_CONN 指過去即完成接線。新版還附了一支 proxy_pool.sh 服務管理腳本,把 start/stop/restart/status 包起來,對放在小機器上長跑的人算友善。region 屬性預設開啟,會在驗證時呼叫 api.ip.sb 的 geoip 服務查國碼,/get 回傳的 region 欄位就是這樣來的。
文件寫著 pip install -r requirements.txt 就能跑,我照做了一次,環境是 Python 3.11 的全新 venv。最先撞到的不是代理品質,是 import 直接報錯:requirements.txt 把 APScheduler 釘在 3.x 舊版,這個版本倚賴 pkg_resources 模組,而 2026 年的 setuptools 已經把它移除,不安裝舊版 setuptools 連排程器都載不起來。整套依賴都是同個年代的味道:Flask 釘 2.1.1、gunicorn 釘 19.9.0(2018 年版)、requests 釘 2.31.0。想長期架,先想清楚要不要接手維護這份依賴清單。
發行版與原始碼的落差是另一個坑。GitHub 上最新的 release 停在 2023 年 2 月的 2.4.1,tag 有 2.4.2 但沒有對應 release,而 setting.py 裡的版本字串還寫著 2.4.0。真正活躍的是 master 分支:2026 年 5 到 6 月有一輪大重構,代理源改成外掛架構(放在 fetcher/sources/ 目錄、自動掃描、支援黑名單停用),測試整套換成 pytest 分三層,文件也搬到 GitHub Pages 的新站。也就是說,照 release 下載拿到的是三年前的舊架構,新文件描述的是 master 的行為,中間隔著一整輪重構。README 的支援徽章標 Python 3.8 到 3.11,重構日誌同時寫明放棄 3.7 以下版本,新版 tox 的測試環境也只列 3.8 到 3.11;在 2026 年買新機器裝 Python,會直接踩在支援範圍的上緣。
原始碼層還有前面提到的兩個坑:zdaye 源解析頁面時直接 IndexError,ihuan 源會空轉兩分鐘才放棄。外掛架構的好處是停用某個源只要在 PROXY_FETCHER_EXCLUDE 加一行,不必改原始碼;但這也表示「裝完就有一池可用代理」的期待要修正成「裝完之後,池子的內容是十幾個免費網站當下的存貨」。
免費代理池最該想清楚的一題不是可用率,是信任。把請求丟給公開清單上的陌生節點,等於把流量交給不知名的第三方:HTTP 代理本身不加密,節點端看得到明文;HTTPS 請求雖然有 TLS 保護,但 CONNECT 階段仍會暴露你連線的目標主機。帳號、cookie、任何登入後的請求,都不該走這種池子,這是比可用率更硬的底線。
專案自身還有一條容易忽略的外送路徑:region 查詢會把每個代理 IP 送到 api.ip.sb 這個第三方服務查國碼,而且預設開啟。只是拿池子練爬蟲的人可以照 setting.py 的註解把 PROXY_REGION 關掉,少一條資料外流。
指紋問題也順帶一提。util/webRequest.py 裡的 User-Agent 清單最舊到 Chrome 21、Firefox 2.0 與 IE6,最新的也不過 Chrome 39,請求標頭帶 zh-CN 語系。用這副十年前的指紋去敲現代的反爬系統,被擋下的機率只會更高,真要上場得自己換掉;Easy Scraper 那類掛在真瀏覽器上的擴充,在這一點就佔了先天優勢。
最後是合規邊界。代理池解決的是「被擋」,從來沒解決「可不可以抓」:目標網站的服務條款與 robots 限制不會因為你換了 IP 就消失,登入牆後的內容更牽涉帳號風險,MediaCrawler 那篇談過的平台條款問題在這裡同樣成立。把池子用在公開資料的教學、測試與高容錯場景,是它安全的位置。
回到決策。如果你的目的是學爬蟲、測試自己的反封鎖邏輯、或跑一種「失敗就換下一個 IP 無所謂」的高容錯任務,這個專案值得架:機制完整、程式碼不複雜、MIT 授權(LICENSE 全文就在 repo 裡,著作權標 2017 年的 J_hao104)容許你改到完全符合自己的需求,14 個源也能用外掛方式換成自己找到的清單。
如果你的任務需要 HTTPS、需要穩定成功率、或承載任何敏感流量,免費池此刻的實測結果已經給了答案。有意思的是,README 自己也把這件事說白了:頁面上有兩大段付費代理服務 Bright Data 的推薦文,用簡體中文寫著親測成功率極高、輕鬆突破反爬封鎖之類的推薦語,附聯盟連結。免費池與付費代理出現在同一頁,等於作者自己把需要高成功率的讀者導去付費方案。對讀者來說,這反而是個誠實的訊號:高需求本來就走另一條路。
想把池子打磨成自己的形狀,2026 年之後的程式碼給了兩條低門檻的路。停用特定源只要在 PROXY_FETCHER_EXCLUDE 黑名單加一行,實測裡那個會拋 IndexError 的 zdaye 就適合先關掉;新增源則是寫一支繼承 BaseFetcher 的小類別,fetch 方法回傳 host:port 字串,baseFetcher.py 內建的正則工具 parseProxiesFromText 能直接從任意網頁文字裡抽出 IP 與埠號,放進 fetcher/sources/ 目錄就會被自動掃描載入,全程不必改主程式。對能把代理清單餵進來的人,這個外掛位就是整個專案最值得用的部分。
台灣讀者還有一個在地因素:14 個內建源多半是中國大陸的免費代理站,部分源從境外連線的可用性會再打折扣,實測裡 geonode 這種國際源也有收不到的時候。池子內容會隨你所在的網路位置變動,架好後先跑一輪自己的統計再決定怎麼用。
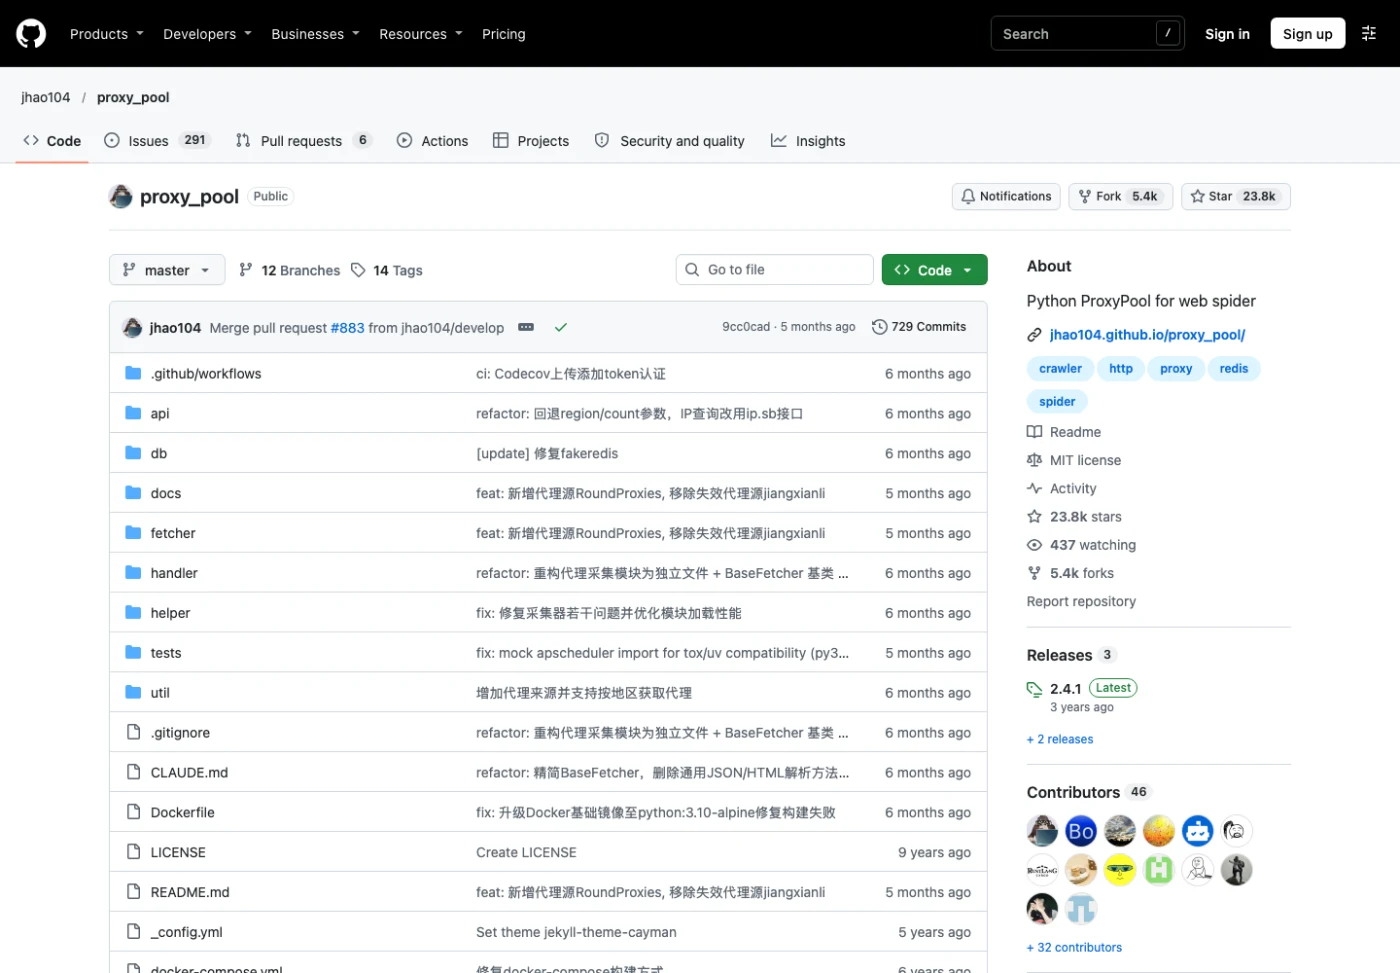
jhao104/proxy_pool 在 2016 年 11 月建立,到今天累積 23,785 顆星、5,411 個 fork,open issue 有 291 個(加 6 個 PR)。LICENSE 的著作權年份從 2017 年起算,changelog 則記著 2021 年加上多執行緒採集與 source 屬性、2022 年加 region 屬性、2023 年支援帶帳密認證的代理格式、2026 年 5 到 6 月這輪把代理源外掛化並重寫測試。跟 KSpider 這類新一代視覺化爬蟲平台相比,它的介面就是一份設定檔跟幾個 API 端點,所有價值都在機制本身。活躍度的高峰早已過去,但專案沒有死:master 最後一筆合併在 2026 年 6 月 15 日,而且是把作者自己 develop 分支上的工作合進主線,那輪 5、6 月的重構把測試、文件、外掛架構都翻新過,repo 裡還放著一份 CLAUDE.md,看得出維護者已經把 AI 助手納入日常工作流程。對一個免費工具來說,這種緩慢更新、偶有大整理的節奏是常態,架構也夠簡單,真要接手維護的門檻不高。
決策可以濃縮成一句話:把它當爬蟲課程的教材與高容錯任務的備援,它兩萬顆星的成熟度完全撐得起;把它當正式任務的基礎設施,先看過上面那組可用率數字再說。想進一步,官方文件在 jhao104.github.io/proxy_pool,線上 demo 在 demo.spiderpy.cn,動手前先拿 /count 看一眼今天的池子長什麼樣,再決定要不要把 Redis 架起來。