TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

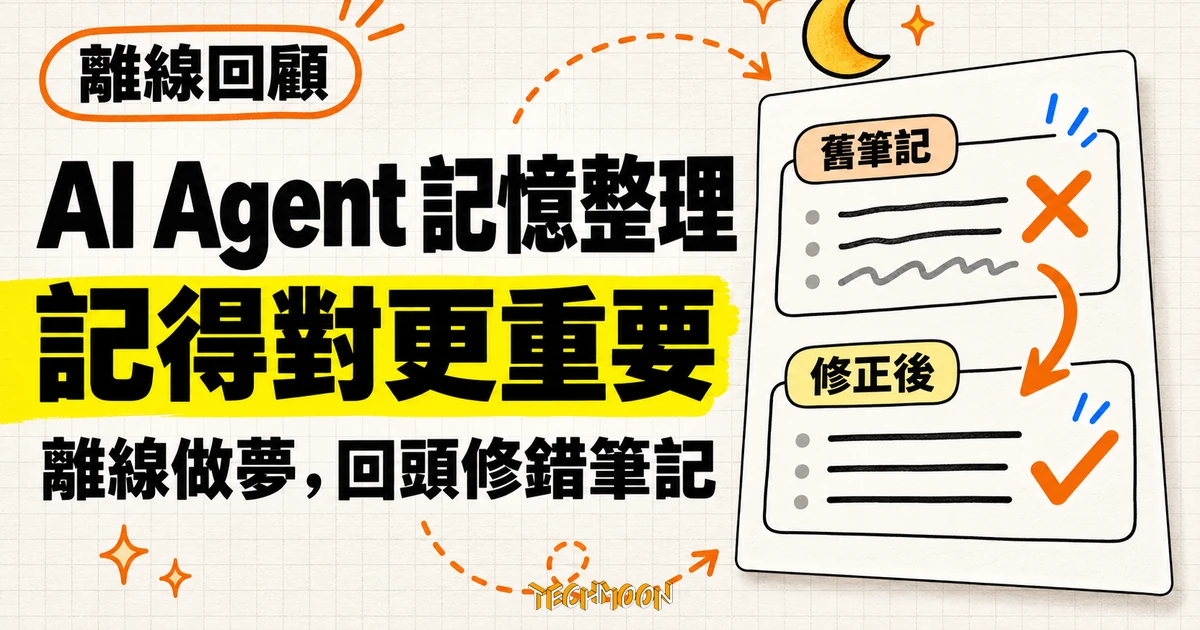
Anthropic 工程團隊用寶可夢紅版與文件問答實驗拆解 agent 記憶:Sonnet 3.7 寫了 413 個檔、約 97.8 萬字元,只換 1 枚徽章;Fable 5 用 10 個檔拿 4 枚。替強模型訂「只記失敗」的規則反而讓進步縮水,離線整理能把寫錯的筆記修回來,而 Claude Code 只載入 MEMORY.md 前二百行,用的正是同一套記憶階層邏輯。
用 AI 摘要這篇文章:
Anthropic 的工程團隊在 11 月 6 日發表了一篇拆解 agent 記憶的文章,用寶可夢紅版和兩套文件問答實驗得出一個反直覺的對照:舊模型 Sonnet 3.7 一路見什麼記什麼,寫了 413 個記憶檔,遊戲只拿到 1 枚徽章;新模型 Fable 5 只留 10 個檔,拿到 4 枚。記憶寫得越多,agent 不一定走得越遠。把自己的 MEMORY.md 打開從這個角度看一遍,你會開始懷疑裡面有多少東西其實是包袱。如果你在用 Claude Code、或在 API 上自己組 agent,這篇實驗直接對應到你每天在看的兩樣東西:模型的記憶夾,以及你寫給它的規則檔。
把整篇讀完,值得帶走的是一個整理過的判斷:agent 記憶的成敗在兩個時機的判斷力。寫入的當下,要判斷什麼值得記;事後離線,要回頭驗證與整理。Anthropic 把第二件事叫做「做夢」(dreaming):讓 agent 在沒有任務的空檔回看自己的逐字稿,修掉寫錯的筆記、把零散紀錄整理成可導航的結構。記憶的價值不在累積,而在這兩次判斷;缺了第二次,第一次寫錯的東西會一直留在那裡,誤導後面的每一個 session。
我把官方文章、Claude Code 的記憶文件、Managed Agents 的 Dreams API 文件都讀過一遍(接觸層級是讀文件,沒有實際呼叫 API)。下面先講官方畫出來的四層記憶結構,再看三組實驗怎麼拆解「記什麼」與「怎麼修」,最後整理現在就能動手做的三個入口。
官方文章把 agent 記憶畫成一棟四層樓。最底層是逐字稿(transcripts),agent 做過的每個 session 的完整紀錄;第二層是記憶筆記,agent 邊做事邊寫下的觀察與規則;第三層是 wiki 這類記憶形態,由筆記整理而成、頁頁相連,像一張知識地圖;最頂層是開場注入(injected context),每次 session 開始時被直接塞進情境的少數內容。頂層最貴:它佔用每一個 session 的 token,而且一條錯的筆記會被帶進每一個 session,所以官方的原則是把頂層顧小,細節往下放、留連結。
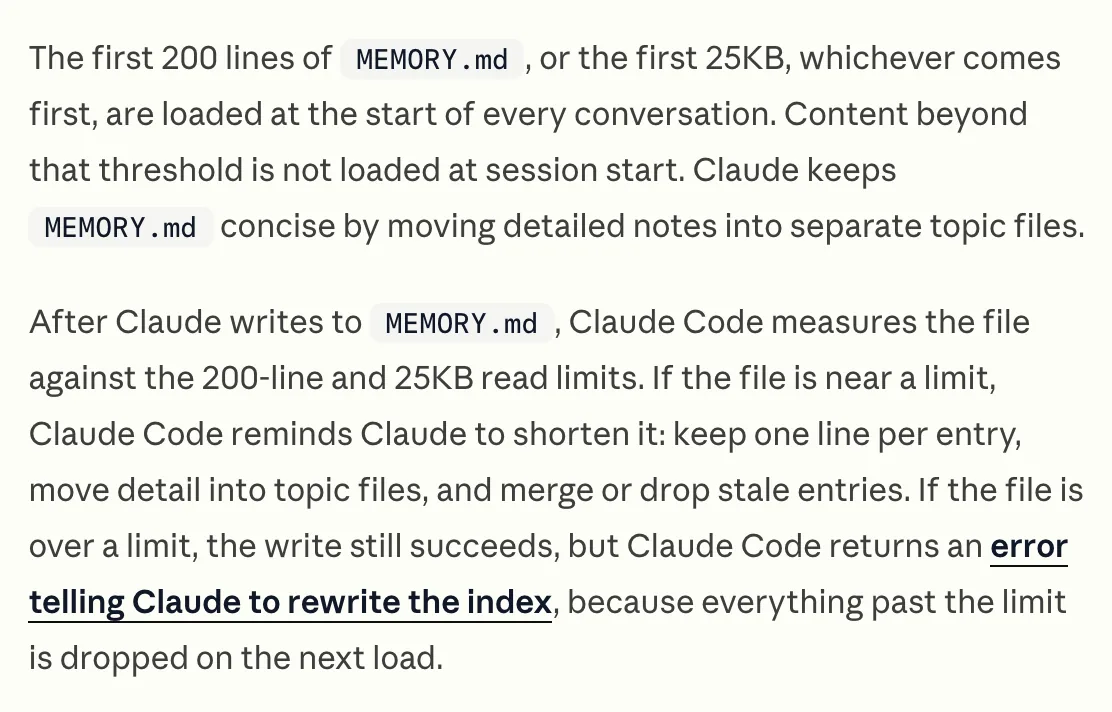
Claude Code 的 auto memory 就是這套結構的桌面版。官方文件寫得很明白:每個對話開場只載入 MEMORY.md 的前二百行或 25KB,先到者為準,超過的內容不會載入;細節要放進各個主題檔,MEMORY.md 本身當索引用,Claude 在 session 中自己維護這個頂層、把細節往下搬。換句話說,你檔案裡超過這個上限的內容,開場不會自動進到 Claude 的情境裡,這也是為什麼記憶需要定期整理。CLAUDE.md 的建議同方向:低於二百行,指令檔越長,遵循度越低。
做夢發生在樓層之間:把底層的逐字稿往上送,更新上面的筆記、wiki 與注入層。靈感來自人腦,睡眠時海馬迴重播白天的經驗,把其中一部分固化成長期知識;Letta 與 UC Berkeley 的研究者把類似想法稱為 sleep-time compute,用互動之間的空檔重組既有情境。回頭整理這件事在別的工具裡也逐漸成形,像把專案記憶搬出單一工具的 ai-memory,或騰訊混元讓跨工具記憶自己選資料流向的 Hy Memory 2.0,處理的都是同一個問題:記憶散落在逐字稿與筆記層,沒有整理就不會變成可用的知識。
寶可夢紅版是文章裡最直觀的實驗。他們給每個模型一個可以讀寫的記憶資料夾,比較 Sonnet 3.7 與 Fable 5 各一個 run 走到大約一萬步時的長相。Sonnet 3.7 的資料夾塞了 413 個檔案、散落在 225 個子資料夾,約 97.8 萬字元,每場戰鬥、每個道具、每個路人都幾乎各建一檔;Fable 5 只有兩個資料夾共 9 個檔,加上頂層一個 global.md,總共 10 個檔、約 4.3 萬字元。結果是 1 枚徽章對 4 枚。官方用同一比例尺把兩個資料夾畫成面積圖,字元數差二十多倍,視覺差距比數字更直接。
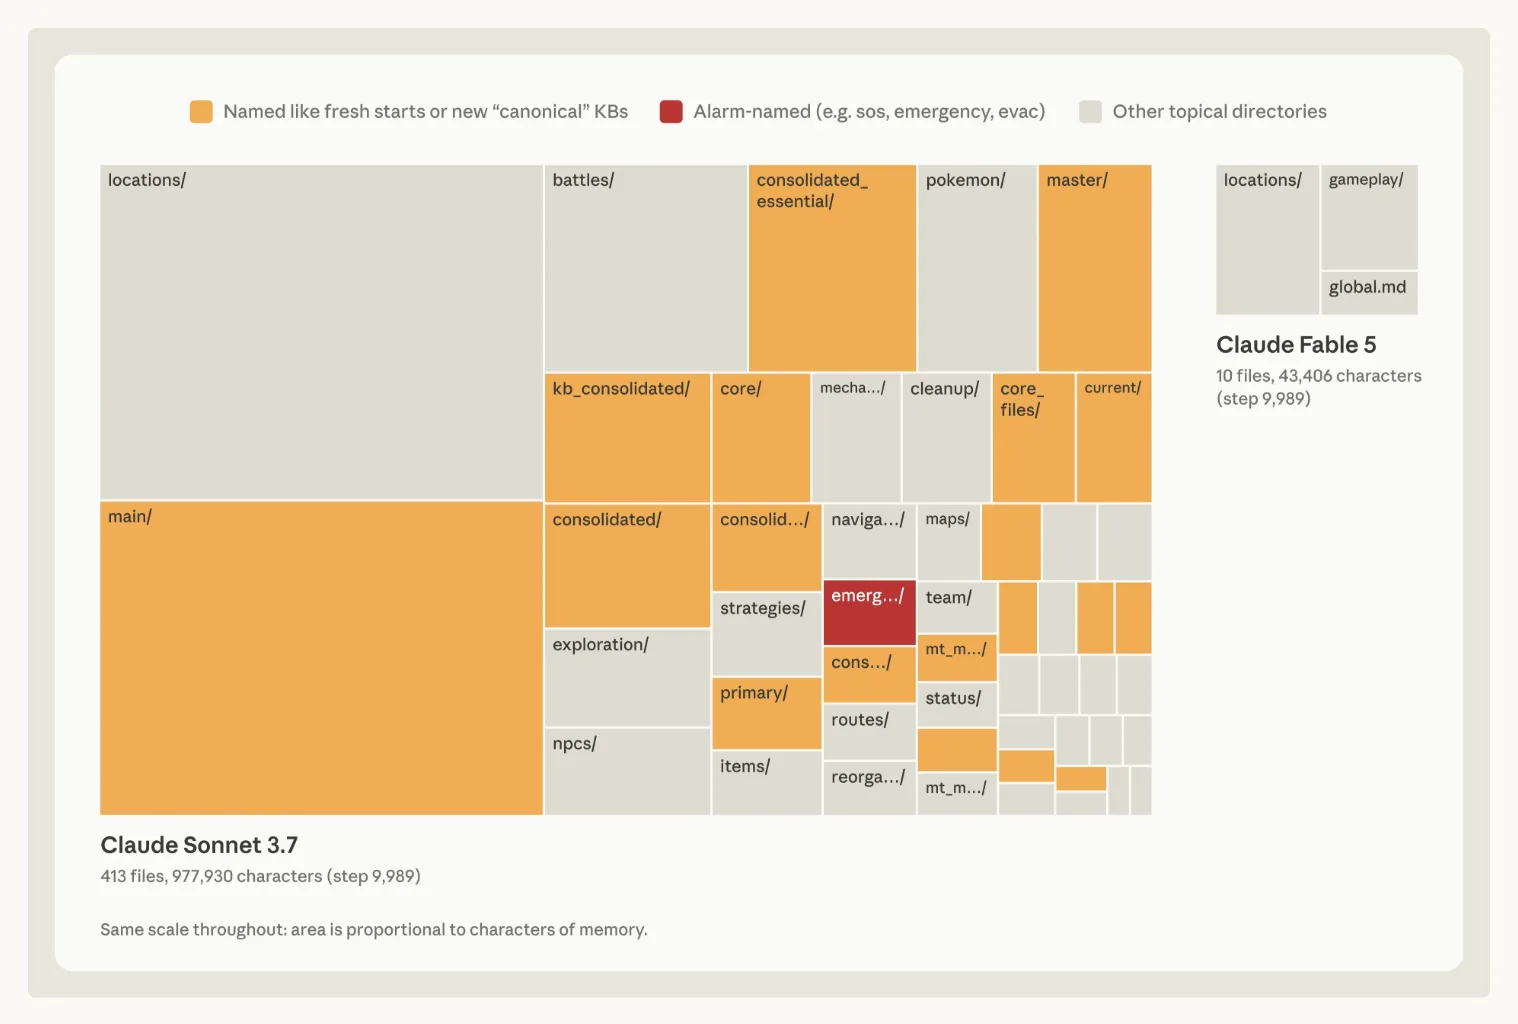
差別在於記的東西會不會立刻過期。遊戲狀態一直在變:身上多少錢、人在地圖哪個位置,畫面每回合都讀得到,寫進記憶馬上變成冗餘。Fable 5 記的是畫面上看不到的東西,global.md 是儀表板,放當前目標、道館攻略計畫、還有它自己訂的記憶使用規則。抓鯉魚王連續七次失手後,它寫下一條筆記:連續三顆以上精靈球失手,就改變節奏、在選單步驟之間多插入等待按鍵,改了之後立刻抓到。這種規則不寫下來就會消失,寫下來也不會過期。
冗餘的另一個代價是整理時間。Sonnet 3.7 在第一萬步附近連續 17 步都在整理記憶,建了 6 個檔、刪掉 9 個,遊戲本身一步都沒玩。官方也標了邊界:這是各一個 run 的定性比較;至於判斷什麼值得記這個方向,下面的基準測試給了量化佐證。同一組實驗裡 Opus 5.5 也是小資料夾、邊玩邊重寫的風格,最後把遊戲破關。
第二組實驗測的是記憶帶來的進步,以及人訂的規則有沒有幫助。CL-Bench 1.0 的資料庫任務這樣設計:模型每題在新的 session 裡作答,答完被告知正確答案,可以寫記憶幫助後續題目。有記憶之後每個模型都進步:Opus 5.5 從 0.655 升到 0.838,Opus 5 從 0.564 到 0.828,Opus 4.7 從 0.383 到 0.700,Sonnet 5 從 0.306 到 0.610。看絕對分數,越新的模型帶著記憶到達的水位越高;看進步幅度,同一條 Opus 線反而從 Opus 4.7 的 0.317、Opus 5 的 0.264 縮到 Opus 5.5 的 0.183,因為新模型的起點已經墊高。官方的說法是 Claude 已經學會判斷什麼值得記,這個判斷力隨世代在進步。
那要不要替它們訂規則,例如「只記失敗」?結果是對強模型扣分:加上這條規則後,Opus 5 的記憶增益少了 0.234,Opus 4.7 少了 0.150。官方的解讀是,對夠強的模型,給它自由判斷比事先綁規則有效,規則反而可能削弱表現。但這條結論有明確的世代邊界:Sonnet 4.6 有記憶幾乎沒進步(0.330 只到 0.364),被明確提示「作答前先讀記憶、再驗證假設」之後,才跳到 0.641。同一句提示對 Sonnet 5 不需要,它十次裡有九次自己先讀記憶;Sonnet 4.6 這麼做的次數不到一半。
對寫 CLAUDE.md 或記憶規則的人,這是直接可用的界線:模型越舊,提示與規則越有價值;模型越新,規則越可能反過來壓住模型的判斷。記憶有時候就是一種預測:寫下一條規則,等於預測未來的 session 還會用到它。官方觀察到 Claude 的這類預測隨世代明顯進步,這也呼應了規則實驗裡新舊模型對同一條規則的反應差異。
做夢要解決的問題,在月見山看得最清楚。月見山是個洞穴,入口在西側、出口在東側,入口附近有個單向崖:跳下去會落回原路,而且看不出怎麼爬回去。Claude 把寶可夢中心的位置記錯成東側,從中心走出來時它宣布「月見山已經在我背後」,把筆記更新成「月見山完成」。事實相反。幾個動作後它跳下崖,落回原路,導航工具又沒顯示這個落差,於是它推論自己「衝過頭到了很西邊」、自己一直站對邊。帶著這條錯筆記,它三次跳崖、一路退回尼比市,最後寫下「與其一直繞圈,我打算停下來」;實驗環境的自動回覆叫它繼續,它就繼續走,回頭去山前的小鎮補血補給,到這個 run 結束都沒走進華藍市。
修正不必清空重來。他們對同一份記憶夾跑一次做夢:讓 Claude 拿逐字稿當對照的原始紀錄,回頭核對那條方位筆記,抓到錯誤並改掉。帶著修正後的筆記,它直接走回洞口繼續推進,在第 1,935 個動作抵達華藍市;完全沒有記憶的 run 同樣到不了。這組對照帶出的教訓在信任兩個字:錯的筆記會被信任、會被引用,在每一個新 session 裡重複誤導,後果不會比沒有記憶輕。
做夢除了修錯,還能長出新的記憶形態。他們拿收購來的軟體公司 Stainless 的內部文件當語料,大約 350,000 個檔案、4.2 億 token,從中出 25 道問答題,讓 Opus 5 代理用 128 個 sessions 漸進式建 wiki。只用 wiki 作答,成績從 2 個 sessions 的 13% 一路長到 128 個的 48%;wiki 加搜尋,分數隨 wiki 長成從 54% 升到 61%,比只用搜尋的 53% 高,而且每題省下約 20,000 個 token。另一份併購文件的 24 道問答裡,需要跨好幾份文件組合資訊的題目,用 wiki 拿 87%,只用搜尋 73%。這個模式跟先整理再回答的問答代理是同一個道理:整理過的地圖讓檢索少走冤枉路。
wiki 的成長過程官方用了職場比喻:剛開始建時,Claude 像新進員工,答得出來的只在地圖上已有的範圍;做夢的次數越多,知識地圖越密,越像待了多年的老員工。但 wiki 不是萬靈丹,反例就寫在同一篇文章裡。某個 LAB 法律任務的評分準則大多能從單一文件直接搜到,wiki 沒有帶來明顯增益;整理的價值出現在需要跨文件組合的題目上,單檔就能答的題目不需要地圖。另一個任務更難堪:語料 115KB,建成的 wiki 卻有 203KB、68 個頁面、255 條連結,是語料的 1.77 倍。官方引了波赫士那則大地圖寓言自嘲:地圖畫得跟帝國一樣大,等於什麼都沒有抽象掉。
教訓最多的是契約那一題。一開始多個代理同時把條款寫進一張共享表格,彼此覆寫,最後生成的報告只保住 57 條評分事實裡的 41 條,約 72%。他們開一個反思循環,讓 Claude 從失敗裡自己改寫建 wiki 的指令;改出來的做法是每份契約各佔一頁、條款逐字引用、不寫摘要。重建之後 57 條全部保住。第二輪做夢把 9 條指向不存在頁面的連結改指到既有的正確頁面,另新增 3 個頁面。把「這份 wiki 要拿來做什麼」講清楚,比條列一堆規則有效,這個結論跟替強模型訂規則會扣分是同一個方向。做夢的方向也可以對準特定目標:官方提到像 Claude Duet 這類助理,記憶適合繞著它服務的人來組織,而指引記憶怎麼長的指令本來就因任務而異,先想清楚記憶要服務誰,再決定整理什麼。
第一個入口不用 API。Claude Code 的 auto memory 已經把這套分層邏輯裝進你的專案:MEMORY.md 前二百行當索引,細節放主題檔,而且記憶檔不受對話紀錄保留期清理,會一直留到你或 Claude 把它刪掉為止,所以累積是常態、整理要自己排。手動版做夢做起來很樸素:定期叫 Claude 讀一遍 MEMORY.md,刪掉過期的、合併重複的、把會變動的細節移進主題檔,再請它標出自己不確定還對不對的條目。文章裡有個節制的提醒,Sonnet 3.7 曾連續 17 步都在整理而不做事,所以從一週一次開始,比隨時都在整理安全。
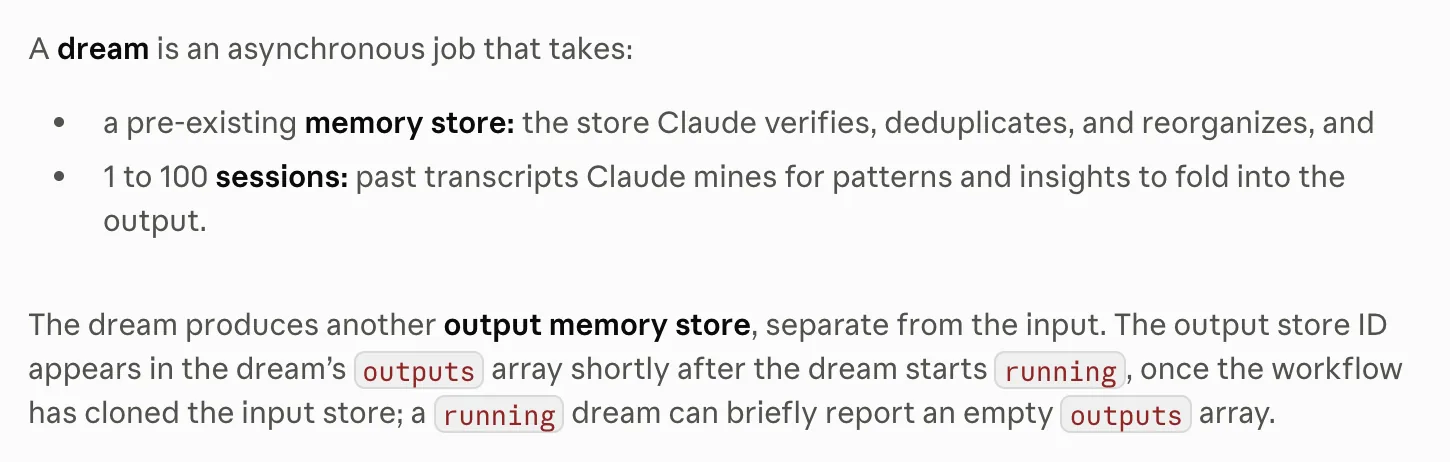
第二個入口給 API 使用者。Managed Agents 的 Dreams 功能目前是 research preview,要提出申請才能使用。一個 dream 是一個非同步工作:讀取既有記憶庫,加上 1 到 100 個過去 session 的逐字稿,輸出一份重組過的新記憶庫,重複的合併、過期或矛盾的換成最新值;輸入端原封不動,不喜歡輸出可以整份丟棄。可以用 instructions 給高層次的合成指引,例如聚焦程式碼風格偏好,但「把第幾行改成什麼」這種逐行編輯式的指令通常沒有效果。計費按所選模型的標準 token 費率,成本大致與輸入 session 的數量和長度線性,跑一次從幾分鐘到幾小時都有可能,官方建議先小批量確認整理品質再放大。支援的模型有限,示範用的是 Opus 5.5。企業使用者還要注意資料處理條件:文件標明 Dreams 不在零資料保留與 HIPAA 的適用範圍內,session 逐字稿會一直保存到你主動刪除。
第三個入口介於兩者之間:官方 cookbook 的 Dreaming with a dynamic workflow 配方,讓你自己決定什麼時候跑、讀哪些逐字稿、用哪個模型,等於自建一條做夢管線,適合不想等申請、或想完全掌握成本的人。
文章結尾自己列了開放問題,這兩題正好是讀者判斷的起點。記憶該什麼時候寫:任務當下寫,立即可用但會分心;丟給背景做夢,不佔注意力但產物不及時。記憶怎麼保鮮:做夢要花 compute,官方建議聚焦容易變動的資訊,或按照記憶被存取的頻率調整做夢節奏,不必無差別全面清查。逐字稿搜尋也可以直接當記憶的基礎,與 wiki 互補。
對照回自己手上的 agent,檢查順序可以很具體:先看注入層,MEMORY.md 前二百行裡有沒有過期或互相矛盾的條目;再把「什麼值得記」的判斷還給模型,規則留給舊模型;最後才考慮做夢的頻率與範圍。至於 Dreams API,把它當成一個要申請、要計費、產出要先檢查再採用的整理工具,會比當成自動保養來得準確。