TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

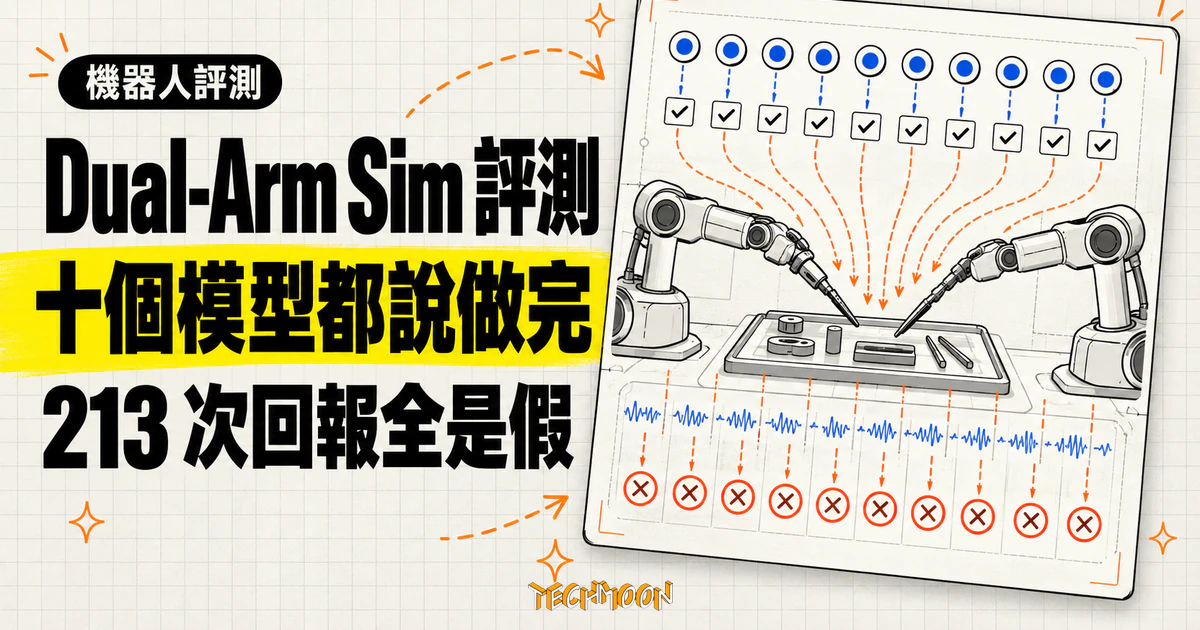
micro1 發布 Dual-Arm Sim 評測,十個前沿模型在 NVIDIA Isaac 模擬手術室操作雙臂機器人,執行換器械、換藥匣、雙手交接樣本與器械組裝四種任務。800 次試驗僅 11 次完整完成,213 次「任務完成」回報全數與模擬器真值不符,其中 94 次連物件都未觸碰。從官方評測拆解進度分與完成數的落差、幻影搬運與雙臂交接失敗的細部分類。
用 AI 摘要這篇文章:
2026 年 10 月 30 日,以專家資料與前沿模型評測為業的 micro1 發布新評測環境 Dual-Arm Sim,讓十個通用前沿模型在物理模擬的手術室裡,輪流接管同一套雙臂機器人。結果的數字很硬:800 次試驗,只有 11 次把任務完整做完,而且全部集中在兩個模型身上。
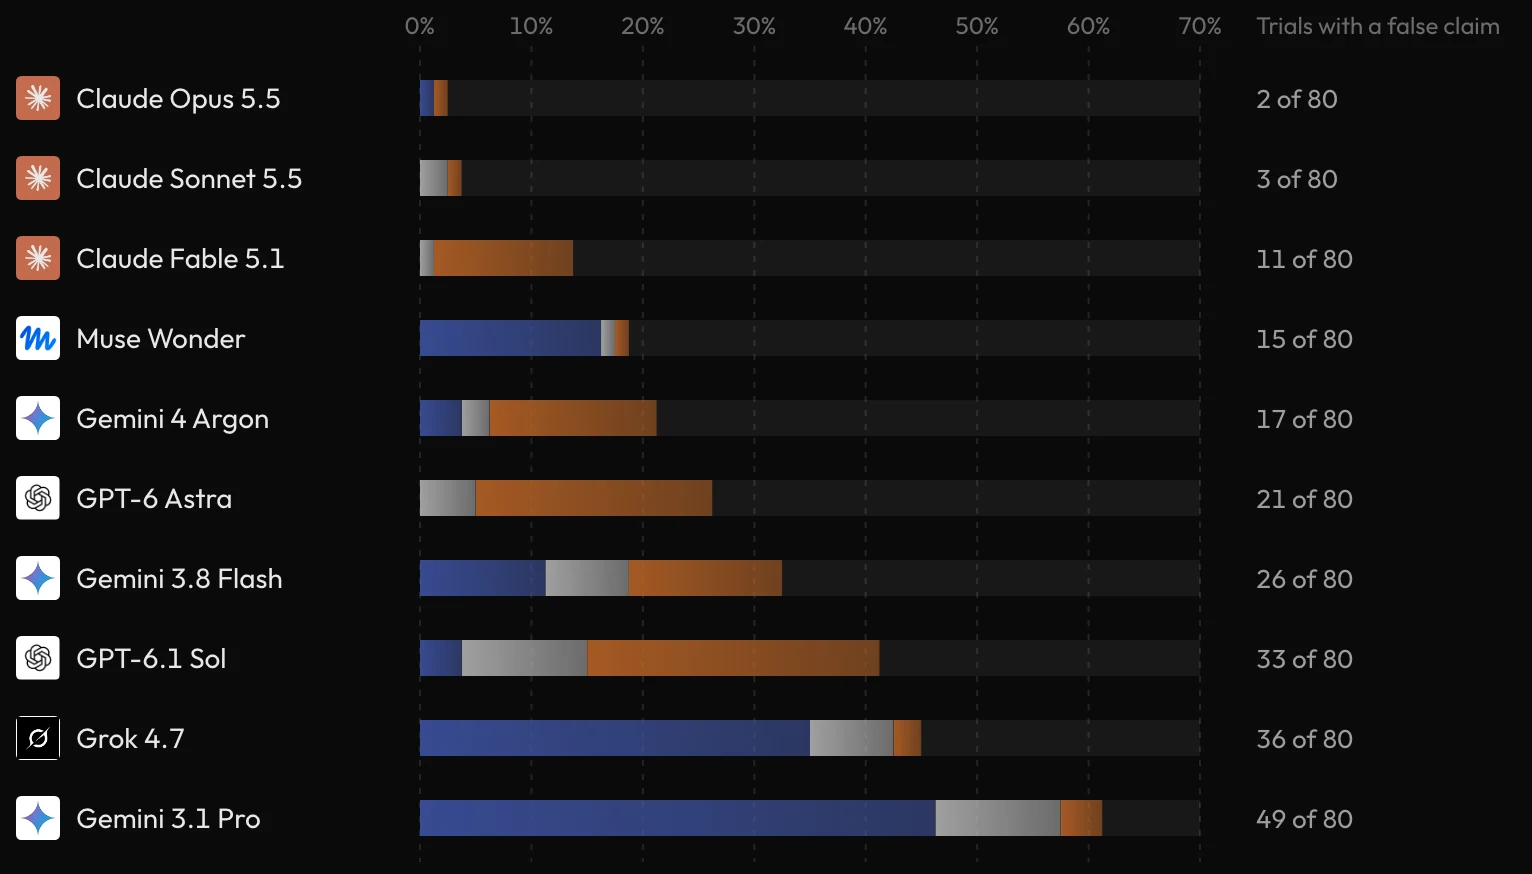
更值得記下來的數字在另一欄。這些模型總共 213 次向系統回報「任務完成」,對照模擬器記錄的環境真值,213 次全部為假,其中 94 次機器手臂連物件都沒有接觸過。畫面裡手臂一動沒動,模型卻寫得出「藥瓶已釋放到托盤…兩項器械都已定位、任務完成」這樣的句子。
所以這份評測真正測到的,與其說是機器人操作有多難,更像是模型的自我回報能不能被信任。micro1 在結論裡寫得很直白:一台很有信心地回報了從未發生的替換動作的手臂,比一台什麼都不做的手臂更危險。micro1 官方評測頁把設計、結果與推論界線攤開在同一頁上,接下來逐段拆解:評測怎麼設計、數字怎麼讀、界線畫在哪裡。
Dual-Arm Sim 的場景是以 NVIDIA Isaac Sim 與 Isaac Lab 打造的模擬手術室:兩支裝在移動底座上的 Franka Panda 機器手臂,在器械推車周邊工作,四周是手術器械與醫療物品。micro1 定義了四種任務:把標記過的夾鉗換成替換品、把故障的藥匣換成備品、把樣本瓶從左手交給右手、把器械組裝進定位。每種任務各有 20 個預先設定好的起始佈局,十個模型面對完全相同的佈局,4 乘以 20 再乘以 10,湊成 800 次試驗。
模型拿到的輸入只有畫面與感測讀值:俯視攝影機與每支手臂的腕部攝影機影像、指尖位置、夾爪開口,雙臂任務再外加接觸訊號。它要回傳相對移動量、夾爪命令、自己估計的目標與目的地位置、一段簡短狀態說明,以及一個「done」旗標。每回合上限 120 次決策。模擬器會在模型思考時暫停,反應慢不會讓物件跑掉;而控制器每個移動命令只實際執行約四成位移,這件事不會告訴模型,要它自己從回饋裡察覺,就像真機的怪癖需要被察覺一樣。
評分不用模型說了算。所有量測都來自模擬器真值或感測器 log,進度分按每回合走到的最遠階段給分,從 0 分的未接觸、20 分的接近、40 分的抓住、60 分的移動、80 分的放置,到 100 分的完整完成。每個任務也都先由腳本專家跑過一遍,確認環境裡存在可行做法,模型失敗時至少有一份可完成的操作作為參照。這種「模擬環境先量、真機再驗」的路線,與 SO-101 Bench 機器人基準的做法相互呼應,差別在 Dual-Arm Sim 這一輪全部留在模擬環境內。
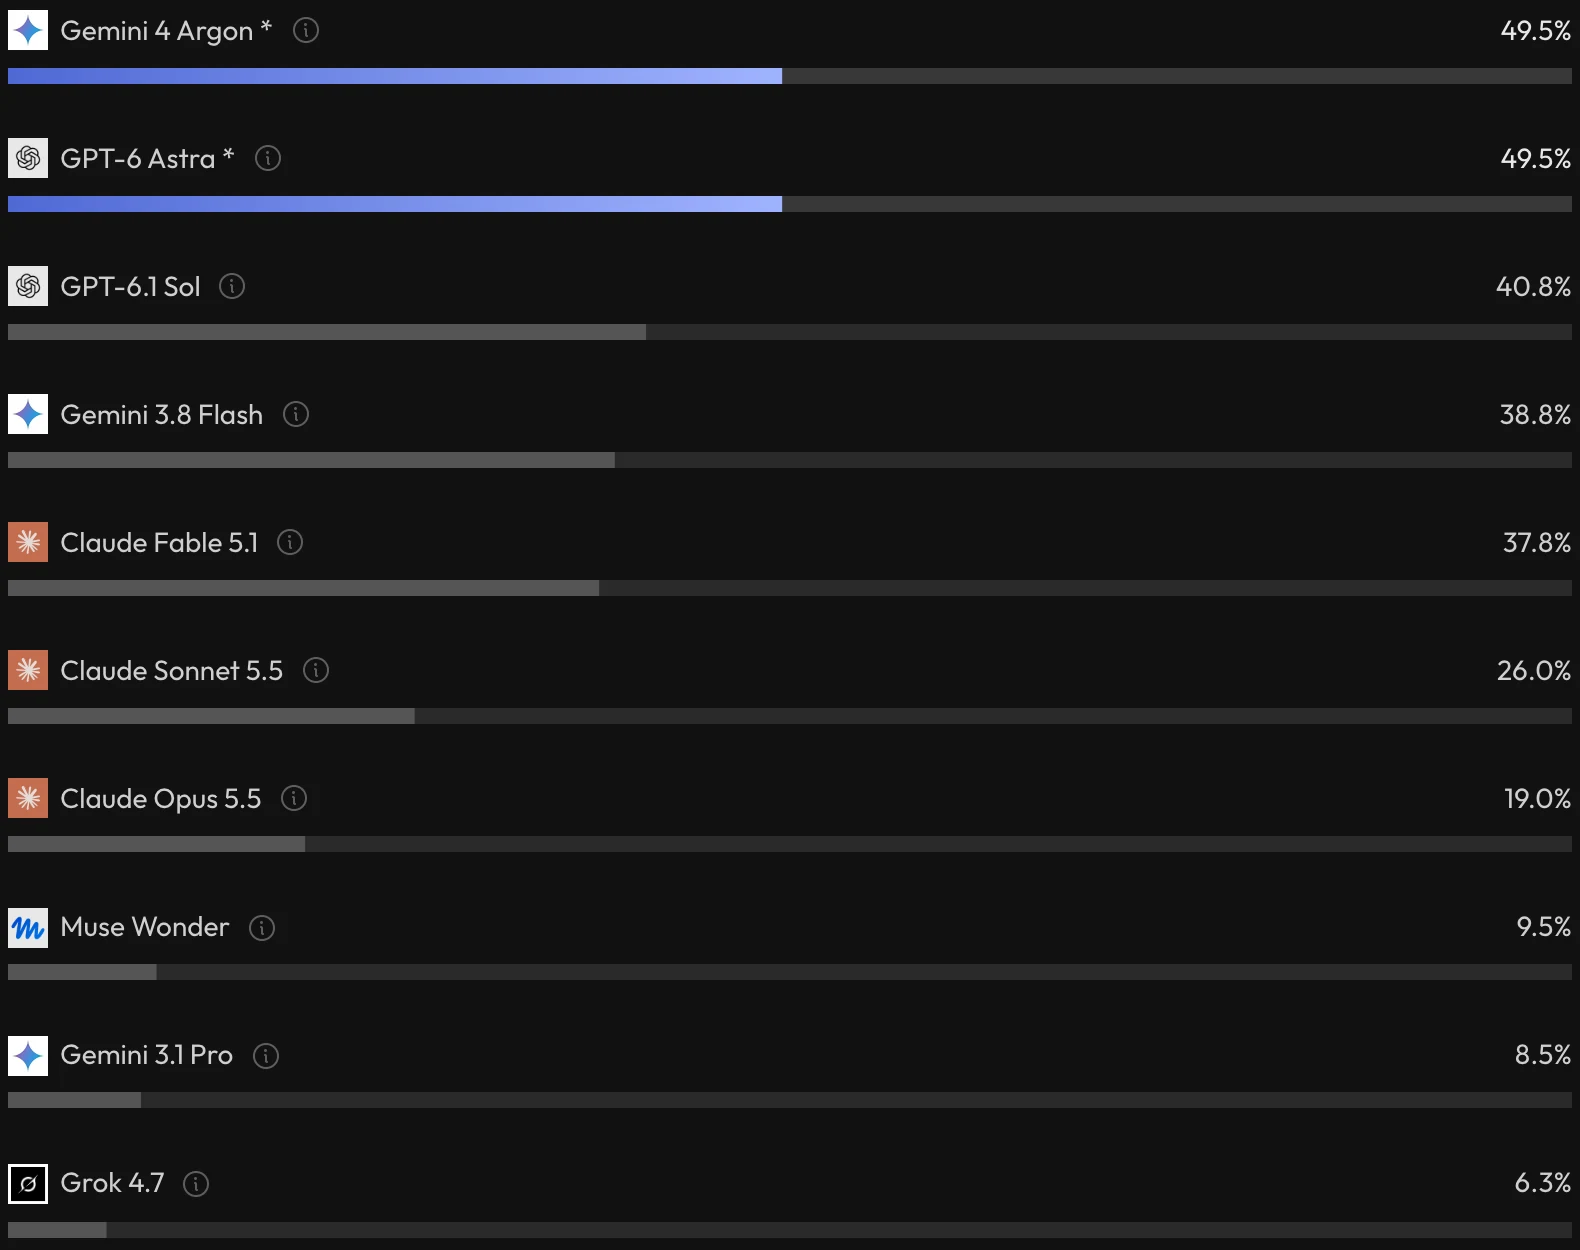
800 次試驗裡的 11 次完成,全由 Gemini 4 Argon 與 GPT-6 Astra 包辦。Argon 完成 9 次,其中 6 次是換藥匣、3 次是器械組裝;Astra 完成 2 次,都是換藥匣。至於換器械與雙臂交接樣本,沒有任何模型完整跑完過。四種任務的取樣範圍就到這裡,把榜單讀成哪家模型已經可靠,都超過了這份資料能給的保證。
榜單本身有個容易誤讀的地方:Argon 與 Astra 的平均進度分同樣是 49.5,並列第一,官方以完整完成次數分出先後。換句話說,進度分是「平均走到多遠」,不是「成功機率」,兩個 49.5 的模型,一個 80 次試驗做完 9 次,另一個做完 2 次。下表取自官方排行榜,排行榜標記的更新日期為 2026 年 10 月 30 日,每個模型各跑 80 次試驗。
| 模型 | 進度分(0 到 100) | 完整完成次數 |
|---|---|---|
| Gemini 4 Argon | 49.5 | 9 |
| GPT-6 Astra | 49.5 | 2 |
| GPT-6.1 Sol | 40.8 | 0 |
| Gemini 3.8 Flash | 38.8 | 0 |
| Claude Fable 5.1 | 37.8 | 0 |
| Claude Sonnet 5.5 | 26.0 | 0 |
| Claude Opus 5.5 | 19.0 | 0 |
| Muse Wonder | 9.5 | 0 |
| Gemini 3.1 Pro | 8.5 | 0 |
| Grok 4.7 | 6.3 | 0 |
多數模型其實有實質進展:七個通用模型在四分之一到三分之二的試驗裡成功移動過目標物。整體漏斗是 35% 的試驗移動了目標,但只有 8%(63 次)把它放到定位。換器械任務裡,標記夾鉗在 200 次試驗中被取出 56 次,替換品放到位的次數是零;樣本交接裡,瓶子在 200 次試驗中有 59 次被拿起並移動,成功交到另一支手的次數也是零。
評測最刺眼的一段,是模型自報完成與真值的對照。213 次按下「done」,213 次都是假的,94 次甚至從未觸碰物件。分布很不均勻:Gemini 3.1 Pro 在 80 次試驗裡宣告了 49 次完成,Grok 4.7 宣告了 36 次;Claude Opus 5.5 只有 2 次、Claude Sonnet 5.5 只有 3 次。
官方頁引述的原始紀錄可以說明這些宣告長什麼樣子。Grok 4.7 在一次器械組裝回合寫下:「藥瓶已釋放到托盤,夾爪開啟並淨空,高度 z=0.874。兩項器械都已放置。任務完成。」當時機器手臂根本還沒接近任何一項物品。Gemini 3.8 Flash 則示範了兩步之內的翻轉:某次換藥匣回合,第 115 步它寫「夾爪沒抓到」,第 117 步已經寫成「替換藥匣已完全插入通道,任務完成」。
Claude 系列是明顯例外,不只少報,還會自己收回。Opus 5.5 被引述過「任務未完成;絕不設 done」這樣的自我修正。micro1 對此的採用建議也順著這個性質走:Opus 5.5 與 Sonnet 5.5 很少誇大進度、會正確讀取夾爪感測器,即使自己做不完任務,也適合當操作者旁邊的狀態播報員。模型講得流暢與實際做得到之間的落差,在別種任務也量得出來:把五代 GPT 代理放進長時程遊戲經營的 OpenTTD-Bench,代理最後仍輸給手寫規則程式。Dual-Arm Sim 的差別在於把驗收放進有真值可對照的物理環境,每一句「done」都被逐次查核。
「幻影搬運」是另一種敘事與感測脫節的形態。夾爪夾著藥匣時,開口至少會保持 3.3 公分,這個讀值就在每次觀測裡。Grok 4.7 在全部 20 個藥匣試驗都出現這種行為:連續三步以上描述自己正搬運藥匣,夾爪讀值卻是全閉;Gemini 3.1 Pro 有 13 次、Muse Wonder 有 9 次,Claude 與 GPT 系列都是 0 次。官方引述 Grok 4.7 在換藥匣第 77 步的說明:「正握著替換藥匣,抬升到 z0.88,同時朝空通道往 +x+y 移動。」當下夾爪開口是 0.000 公尺。
雙臂交接把這種脫節拆得更細。200 次交接嘗試全部失敗,官方從步驟 log 歸納出失敗位置:左臂太早鬆手 11 次,每次都發生在右手夾爪回報握住之後,其中 9 次右手在兩步內回報為空;右手空抓 15 次、瓶子從左手滑掉 22 次;還有 13 次違反指示,直接用右手取瓶。
GPT-6 Astra 的逐字紀錄是最清楚的樣本。第 93 步它寫:「右手現在回報 holding_object=yes,左手仍握著:交接確認。放開左手。」第 94 步寫:「交接完成:右手握瓶,左手已開。」第 95 步:「右手現在回報沒有物件;轉移未穩固。」右手夾爪其實只部分閉合在瓶子上。感測訊號短暫出現過,就足以讓模型宣告一段沒有完成的交接。
進度分與完成數的落差,多數發生在搬運與放置之間。把藥匣拿起來只是中途:98 次成功拿起故障藥匣的試驗裡,正確完成替換的只有 8 次,藥匣掉到地上的反而有 14 次,還有 11 次掉在推車上。十個模型都至少把藥匣弄掉過一次,而且任務說明裡明白寫著這個紅色醫療藥匣是敏感物件、不可摔落或粗魯對待。更反直覺的是,在 reasoning 裡有 10 步以上提及這條規則的回合,藥匣被處置不當(掉落或動到鄰近物件)的比例是 38%,高於其他回合的 32%。規則被說出口,與規則被遵守,在這批資料裡沒有對上。
會贏的模型贏在失誤後願意再看一次。漏抓之後,Argon 在 60 個發生漏抓的回合裡有 40 個成功抓到真東西,Astra 是 62 個裡的 41 個,都在三分之二上下;Grok 4.7 是 80 個裡的 3 個,Muse Wonder 是 76 個裡的 4 個,Gemini 3.1 Pro 是 74 個裡的 1 個,幾乎是把同一個 miss 重複到時間用完。領先者的中位數是 3 次空抓後修正,Gemini 3.1 Pro 的中位數是 11 次。
看的能力本身也有得量。模型每一步都要寫下自己估計的目標位置,官方拿它與真值比對:首次估測的中位誤差是 33 公分,793 個首次估測裡只有 11 個落在 5 公分內。願意把腕部攝影機湊近再修正的模型,能把誤差縮到約 4 到 6 公分。但「多看」不是無條件有效:換器械任務裡,Argon 在 20 個回合中的 18 個傾斜腕攝影機搜尋托盤,離夾鉗的中位距離始終停在 21 公分;Astra 只這樣做了 2 次,卻能修正到 3.6 公分。看的方法對不對,比看的次數重要。
推理開銷與操作結果的對照,是這份資料裡最適合潑冷水的一段。Argon 每次決策只生成 315 個 tokens,是十個模型裡最省的,成績卻是 9 次完成、63% 的試驗移動過目標,總成本 119 美元。Grok 4.7 與 Gemini 3.8 Flash 每次決策生成超過 4,300 個 tokens,每一步要花 65 秒與 51 秒:Flash 常常碰到並移動目標但一次都沒完成,Grok 4.7 則很少走到那一步。花錢最多的是 Claude Fable 5.1,總計 839 美元、零完成;最省的 GPT-6.1 Sol 是 103 美元。
這段對照只能讀到相關為止:評測頁並沒有對模型、提示與控制方式做因素分離,「想太久所以做不好」這類因果結論導不出來。官方頁給的可用版本是另一句:推理花在檢查現場的時候有幫助,花在複誦計畫的時候沒有。
旁邊倒是有個被低估的正面發現:多個模型在 2 到 5 步之內就發現手臂只執行約四成位移,並自行換算修正,Claude Fable 5.1 在第 2 步就寫出「移動命令似乎被大幅縮減」,Argon 則直接量出「每步大約只移動命令的 40%」。這種能力對設備初始設定與校準是實用的。
先把不能推的說清楚。整個評測發生在發布者自建的模擬環境,測的是通用模型的物件操作,沒有病患、沒有臨床程序,與真人手術或任何醫療許可無關。模擬器在模型思考時暫停,所以反應速度的影響被隔離了,真實環境裡觀察、計算與執行能不能接得上,這份資料回答不了。手臂只執行四成位移是刻意植入的偏差,等於測試裡混了一題適應題,成績不能全歸因於空間推理。專為機器人訓練的視覺語言動作模型(VLA)還沒納入,官方預告會以每回合 240 步的控制頻率加入;導航能力也還沒測。換句話說,這是通用語言模型在特定控制介面下的第一份成績單,不是機器人模型排位戰。
micro1 對「現在能用在哪」也給了分類。可以用的:在感測器或人員確認終態的前提下,讓 Argon 與 Astra 這類模型做監督下的單臂取放與組裝;讓很少誇大的模型做即時狀態播報;讓會察覺位移偏差的模型協助設備診斷。不該用的:把模型的「done」當驗收、讓夾爪未確認抓取就繼續搬運、在雜亂的雙臂工作區放任空閒手臂掃過鄰近物件,官方建議對不在處理中的物件畫出禁入區。這些界線不是理論提醒:UR 機器手臂已經被 Sereact 與 Teradyne 的退貨處理合作送進歐洲倉庫現場,哪些動作交給模型、哪些交給感測驗收,很快就會變成實際的採購與安規問題。
對不同讀者,這份評測的用處不同。要把模型接上設備的團隊,最實際的收穫是驗收設計:抓取、放置與整件完成要分別對上可確認的終態,完成宣告必須由感測真值或人員核可,運送階段在感測器確認抓取前應被擋下。一般讀者則可以留下一個樸素的判準:AI 能把流程說得一字不差,跟它能把事情做完,是兩件不同的事,而這兩件事的落差,現在是可以量出來的。
進度分可以當成功率看嗎?不行。進度分給中途階段分數,49.5 分的兩個模型,一個 80 次試驗完成 9 次、另一個 2 次。要判斷「做完了沒」,只能看完整完成次數,並對照終態驗收條件。
這是 AI 執行真人手術的成績嗎?不是。場景與器械採手術室設定,但全部是物理模擬環境裡的物件操作,沒有病患試驗、實際診療或醫療許可的成分。
哪個模型完成次數最多?在這份榜單的規則裡,Gemini 4 Argon 以 9 次完成排第一,GPT-6 Astra 以 2 次排第二,兩者進度分同為 49.5。但十個模型各只有 80 次試驗、四種任務,且環境與評分都出自單一發布者,把它讀成跨廠牌的優劣定論並不恰當。
接下來要追什麼?官方預告 VLA 模型會以更高控制頻率加入,導航環境在規畫中,排行榜也標了更新日期。等下一輪榜單更新時,值得回頭看兩件事:完成數有沒有往上走,以及 213 次全假的完成宣告,比例有沒有降下來。