TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

arXiv 新論文 VibeVideoBench 用 239 道任務實測九款 AI 代理寫程式做有聲影片,沙箱禁用任何影片生成模型、一小時硬上限。GPT-6 Astra 與 Claude Opus 5.5 品質居前兩名,但 2,151 次執行有 224 次連影片都交不出來,四分之三敗在最終渲染的時間管理。拆開看交件與品質的雙軸排名、每任務 0.32 到 15.38 美元的成本差距,以及時間預算消融結果。
用 AI 摘要這篇文章:
北京郵電大學、中關村學院、北京大學、吉林大學與快手 Kling 團隊共 24 位研究者,在 10 月 26 日把一份名為 VibeVideoBench 的基準測試論文放上 arXiv(編號 2610.35864,隔日更新第 2 版),用 239 道任務、2,151 次計分執行,第一次大規模回答一個問題:讓 AI 代理自己寫程式做一支有聲影片,現在到底做到哪裡了?測試對象是九款可直接買到的代理系統,從 OpenAI 的 GPT-6 Astra、Anthropic 的 Claude Opus 5.5,到 DeepSeek、Kimi 與智譜的模型都在名單上。規則很硬:每個任務一小時,沙箱裡沒有任何影片生成模型,代理要自己寫程式渲染每一格畫面、合成聲音,在期限前交出能播放的 MP4,期限一到容器直接終止。官方專案頁上放的展示影片,每一支也都是這樣用程式做出來的,全程沒有文字生影片模型介入。
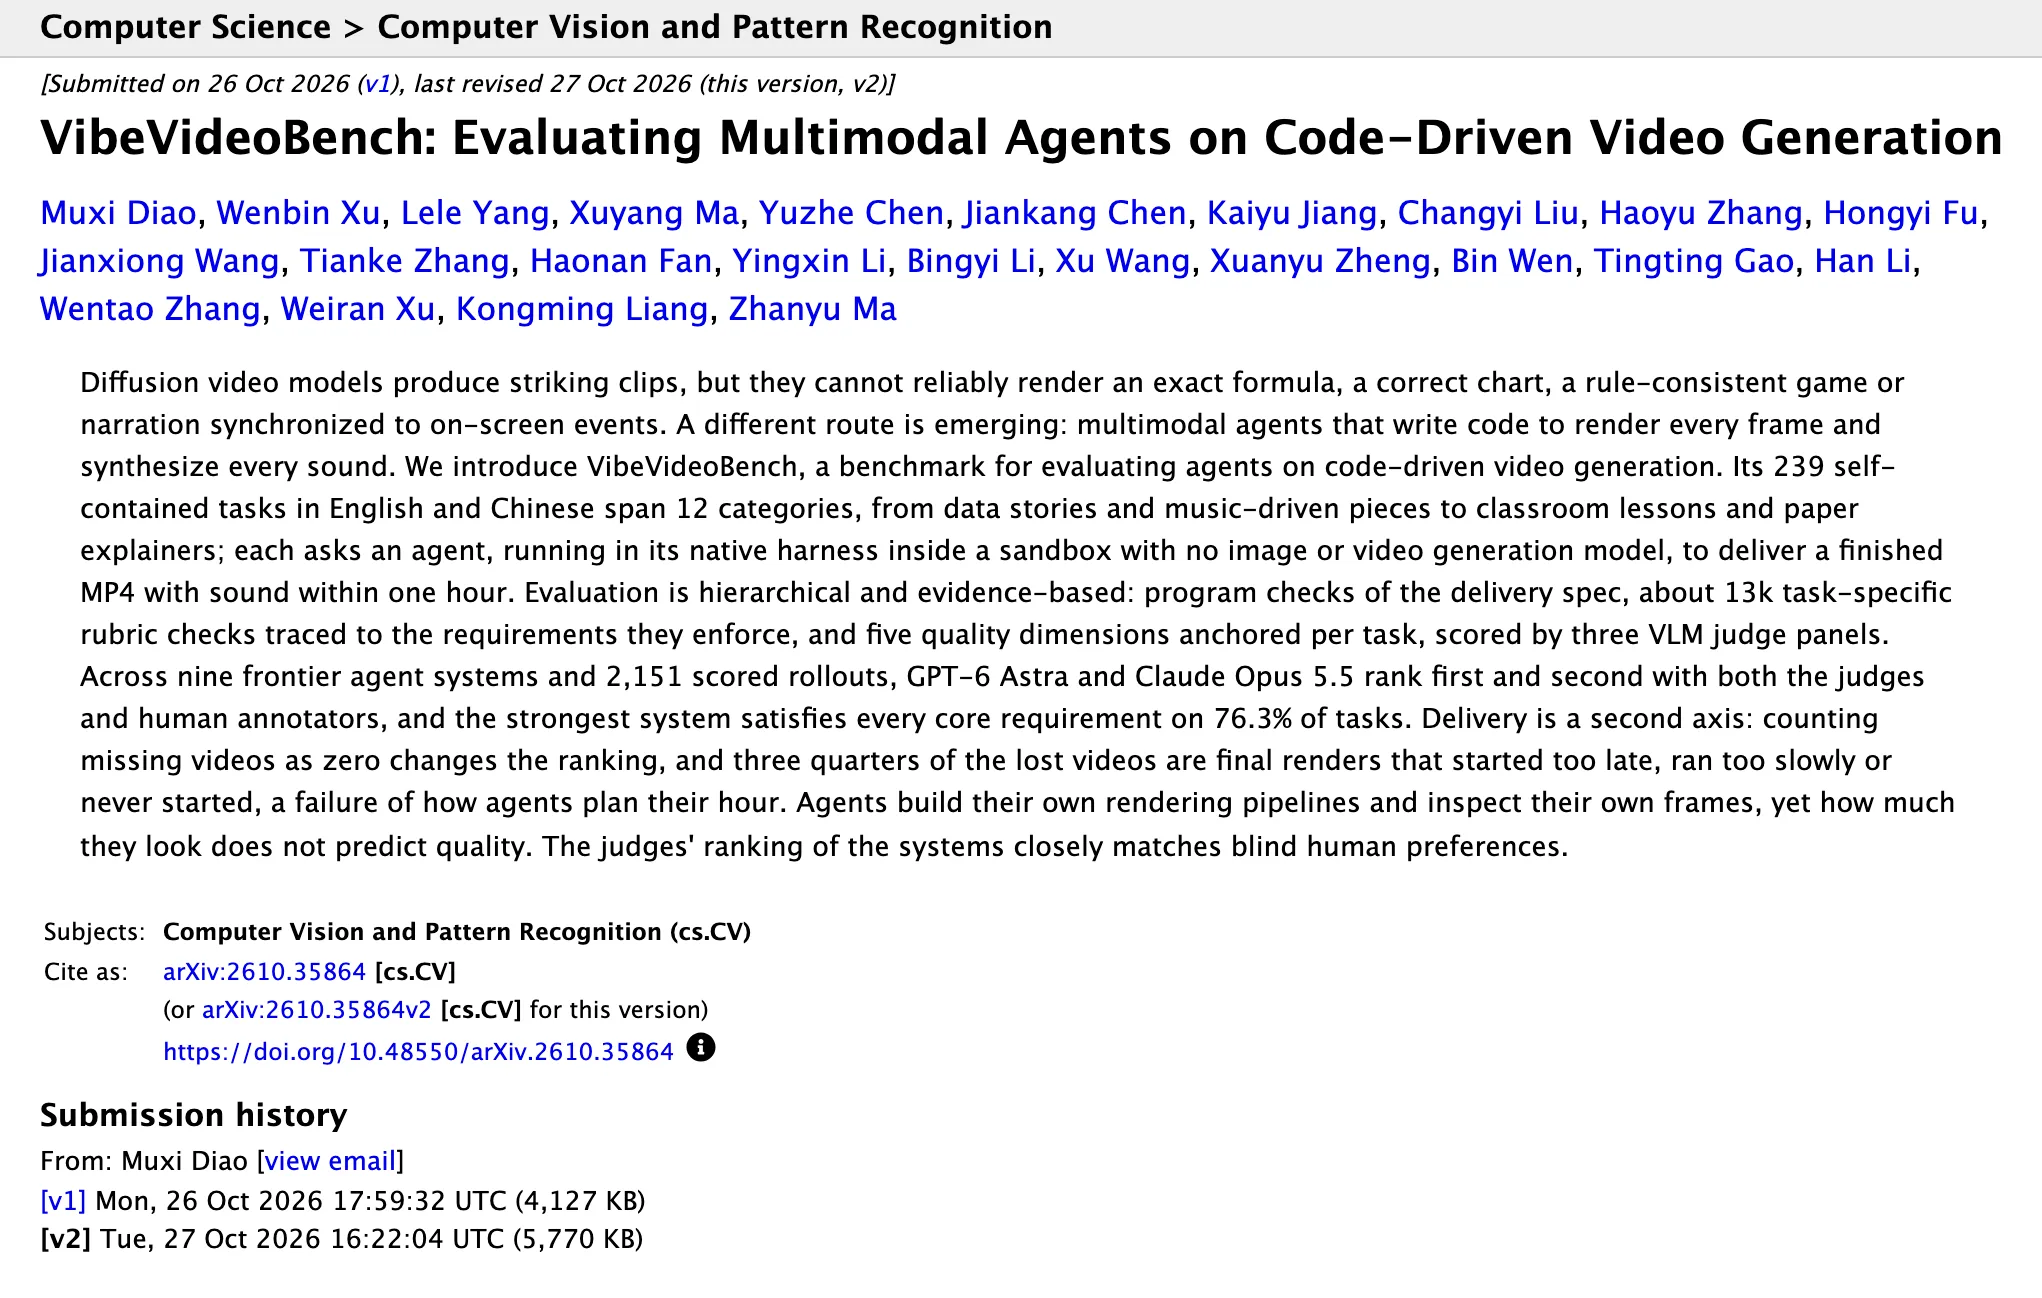
結果裡最該先記住的是兩組數字。品質面上,GPT-6 Astra 與 Claude Opus 5.5 在評審與人類盲測裡都穩居前兩名,但連榜首系統都只在 76.3% 的任務通過全部核心要求。交件面上,2,151 次執行有 224 次連一支可播放的影片都沒留下,其中 169 次與最終渲染的時間管理有關:渲染開始得太晚、跑得太慢,或根本沒開始。作品漂不漂亮,與能不能準時交出成品,在這份測試裡是兩條會互相拉扯的軸,只看其中一條都會選錯系統。
這份基準瞄準的場景很具體。擴散模型生影片擅長氛圍與寫實片段,但論文開頭就點出它保證不了的東西:精確的公式、數字正確的圖表、規則前後一致的遊戲畫面、與劇情同步的旁白。這些恰好是教學影片、論文講解、資料故事這類「真的會被拿去用」的影片最需要的性質。人類早就有一條替代路線:用 Manim 或 Remotion 寫程式做影片,每一格畫面都由程式算出來,改文字就改文字、改數字就改數字。VibeVideoBench 測的是 AI 代理能不能自己走完這條路。
測試環境本身就是論文的一部分。每個任務跑在一個全新的容器裡:Ubuntu 24.04、8 顆 CPU、32GB 記憶體、沒有 GPU。沙箱預裝了 Python 與 Node 的常用影像和瀏覽器自動化函式庫、軟體渲染 WebGL 的無頭 Chromium、ffmpeg、ImageMagick、SoX、three.js、GSAP,以及大型中英文字型集。唯一能用的生成式 API 是 Qwen3-TTS-Flash 文字轉語音,其餘一切畫面與聲音都得靠代理自己寫程式產生。一個小時的預算也定義得相當嚴格:模型等待、工具呼叫、語音合成、預覽與最終渲染全部計入 3,600 秒,時間到容器就被殺掉,不留緩衝。
239 道任務分 12 類,涵蓋品牌行銷、產品示範、資料故事、遊戲與運動、音樂與聲音、課堂教學、論文講解等,其中 209 道英文、30 道中文,目標片長從 8 秒到 15 分鐘。中文任務主要來自七個科目的自編講課筆記,論文講解類則直接附上 Transformer、ResNet、GAN、DDPM、NeRF、CLIP、LIGO 這類經典論文的 PDF。任務本身經過一道篩選,共有 332 道候選題被剔除,原因包括題目預設了沙箱裡沒有的素材(125 道)、只描述風格而不要求成品(99 道)、片頭動畫與標誌展示(43 道)、沒有發展的背景循環(25 道)等,留下來的題目必須自包含、可檢查。交付物也不只一支 MP4,還要交出可重新渲染的可編輯專案、時間表與製作筆記,也就是說測的是完整的交付能力,不是片段特效。
評分採三層。程式層用程式檢查直接驗規格,例如檔案能不能播、時長符不符合;規格層有 12,985 道針對個別任務寫的檢查題(平均每道任務 54.3 題,其中 85.8% 屬核心要求),每題都標註它對應題目的哪一句要求;品質層則由三個視覺語言模型(VLM)評審面板,對視覺品質、視覺美感、內容邏輯、節奏與動態、聲音與影音同步五個構面各給 1 到 5 分,錨點依任務各自定義。
檢查題的嚴格程度可以用一個例子感受。超級瑪利歐關卡那道任務(編號 CG01)共有 59 道檢查題,其中一道核心題寫的是「碰觸蘑菇後的成長要能辨認」,所以一支瑪利歐吃了蘑菇卻沒有變大的影片,就算其他 58 道全過、單題通過率 98%,整道任務照樣判定失敗。這也解釋了前述 76.3% 的含義:九款系統在交件作品的單題通過率都高達 80.5% 到 97.3%,卡住大家的從來不是單一項目做不做得到,而是有沒有辦法在同一支影片裡把全部核心要求一次做對。
論文最容易被斷章取義的地方,是排行榜其實有兩欄。只看成功交件的作品,與把沒交件的執行算零分,名次會明顯變動。九款系統的完整數字如下:
| 系統 | 交件數 | 規格合規率 | 只看交件作品的整體分 | 沒交件算零分的整體分(排名) |
|---|---|---|---|---|
| GPT-6 Astra(Codex CLI) | 238 | 93.7% | 4.126 | 4.109(1) |
| Claude Opus 5.5(Claude Code) | 239 | 99.6% | 4.074 | 4.074(2) |
| Claude Sonnet 5.5(Claude Code) | 232 | 94.6% | 3.999 | 3.880(4) |
| Gemini 4 Argon(Antigravity CLI) | 184 | 76.6% | 3.989 | 3.069(7) |
| DeepSeek-V4.1-Flash(DSH) | 236 | 94.6% | 3.961 | 3.911(3) |
| Kimi K3(Kimi Code) | 213 | 85.8% | 3.864 | 3.440(5) |
| GPT-5.6 Sol(Codex CLI) | 213 | 84.5% | 3.735 | 3.317(6) |
| Gemini 3.8 Flash(Antigravity CLI) | 193 | 77.4% | 3.470 | 2.798(8) |
| GLM-5.3-Flash(ZCode) | 179 | 66.9% | 3.736 | 2.790(9) |
(數字出自論文 Table 2;整體分是五個品質構面的平均,1 至 5 分。)
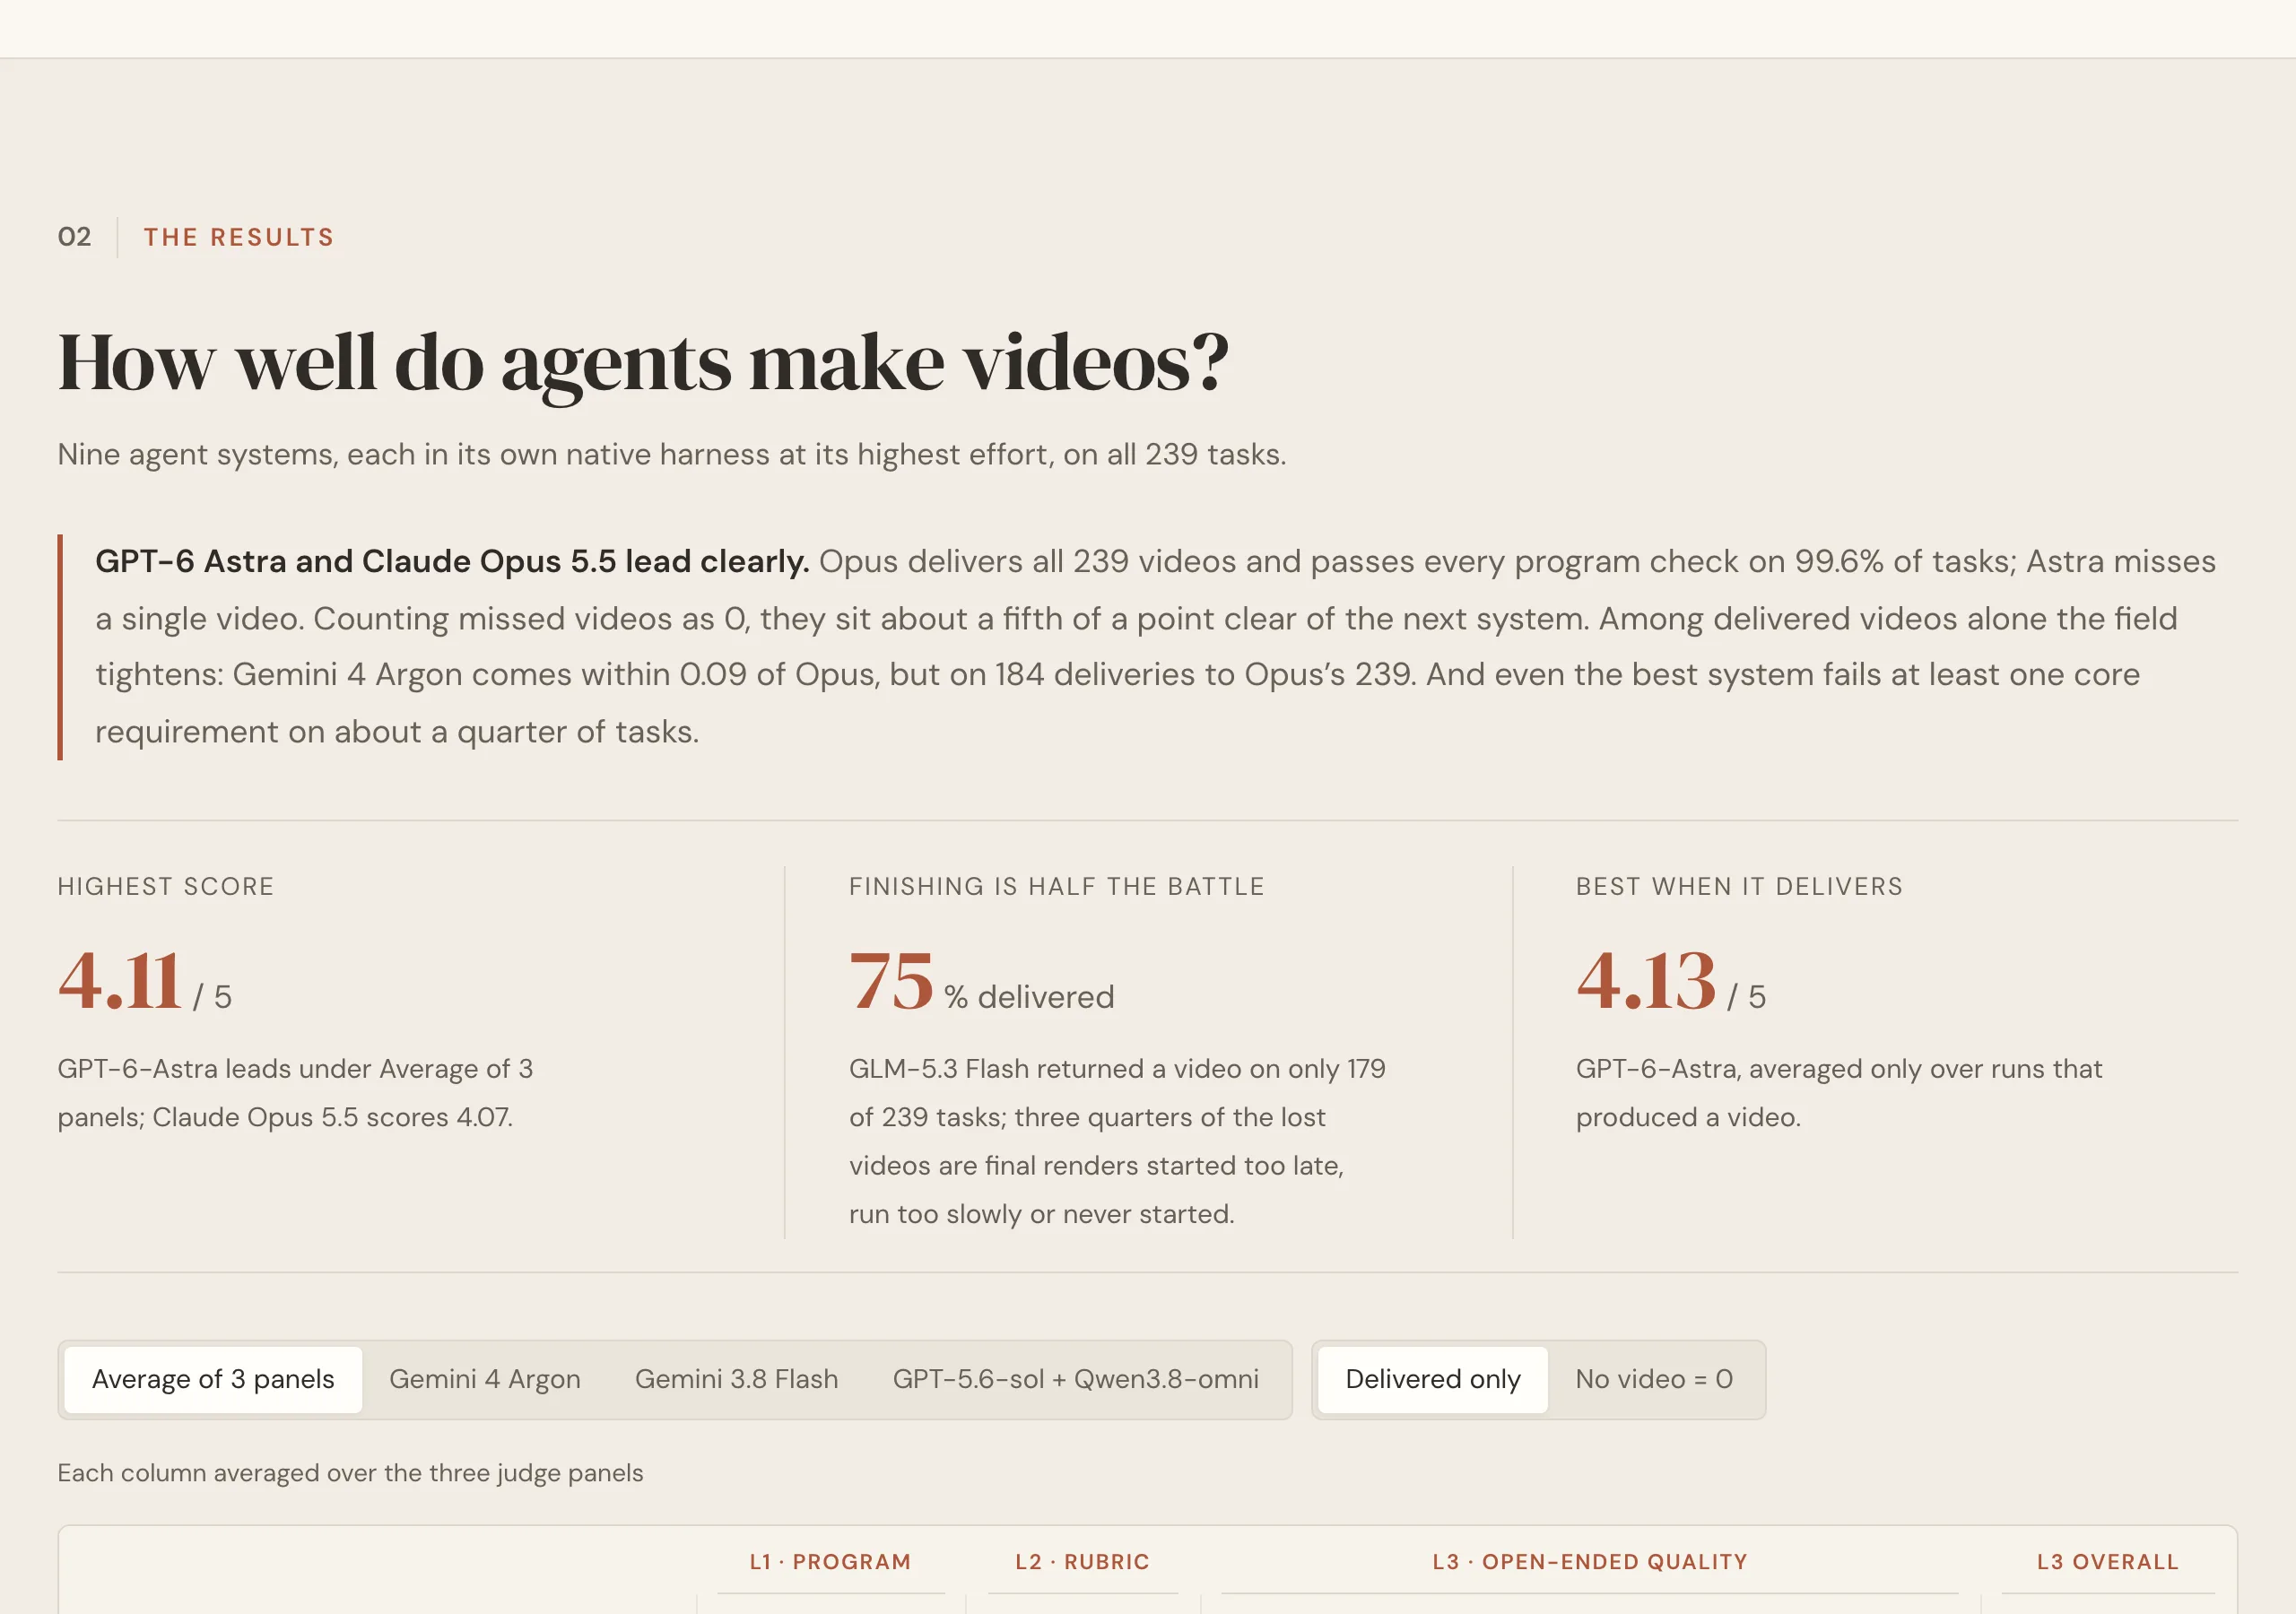
兩個極端案例把雙軸差異拉得很開。Claude Opus 5.5 是唯一 239 支全交的系統,規格合規率 99.6% 也是全場最高,換算下來它是最穩的選擇;GPT-6 Astra 只漏了一支,但交出來的作品評分最高(4.126),人類盲測的 Elo 分數 1,242 也居首,Opus 以 1,203 緊追。兩款系統在五個品質構面裡包辦了四個構面的前兩名,唯一的例外是聲音構面,Gemini 4 Argon 在那裡排第二。陷阱在中段:Gemini 4 Argon 只看交件作品的話分數 3.989,與 Opus 只差 0.09,看起來幾乎並駕齊驅,但它 239 道任務只交出 184 支,把沒交件的算零分後整體分掉到 3.069,排名從第 4 滑到第 7。反過來,DeepSeek-V4.1-Flash 靠著 236 支的交件數,在零分制下升到第 3。
還有一個容易忽略的設計:這裡測的是「模型加官方工具」的整套組合,Astra 配 Codex CLI、Opus 配 Claude Code、兩款 Gemini 配 Antigravity CLI。論文的立場是使用者實際採用的就是這種組合,所以排名屬於組合而非裸模型,換一個 Harness 結果不保證一樣。
研究團隊逐案讀完 224 件交不出影片的執行紀錄,歸因結果相當集中:169 件(約四分之三)屬於時間管理失敗,其中 104 件是最終渲染開始太晚或跑得太慢,65 件則是到期限為止從未開始最終渲染(65 件裡有 31 件出自 GLM-5.3-Flash)。其餘是 45 件渲染停擺或被截斷、7 件代理自己毀掉或弄丟產出、3 件其他原因。
時間管理失敗的機制並不難理解。代理傾向反覆打磨元件與預覽,把完整渲染留到最後:GPT-5.6 Sol 的失敗執行裡,全片渲染中位數在截止前 9 分鐘才開始,而它常採用的逐格瀏覽器擷取做法本身就需要 5 到 35 分鐘。卡死的那 45 件全部集中在兩款 Gemini 系統,其中 33 件是同一種工程錯誤:代理的腳本把畫面串流餵進 ffmpeg 卻從不讀取錯誤輸出,管線因此死鎖,有一件停在 10,102 格裡的第 7,744 格,離完成只差約 90 秒。作為對照,Claude Opus 5.5 成功執行的中位數在截止前 24 分鐘就完成寫檔,也是唯一零失敗的系統。
交件還有一種安靜的失敗型態:GPT-5.6 Sol 交出的 213 支可播放影片裡,有 48 支根本沒有音軌,讓它在聲音構面墊底。對要把成果交給客戶的團隊來說,這種「有檔案但缺一塊」的失敗比整支沒交更難在驗收前發現。
幫 2,151 支影片打分的三個 VLM 面板,身分是 J1 用 Gemini 4 Argon、J2 用 Gemini 3.8 Flash、J3 的視覺評審用 GPT-5.6 Sol。這帶出一個明顯的利益衝突:三個評審模型全部都在參賽名單上。論文沒有迴避這件事,附錄實測了每個面板對自家參賽者的偏寬幅度,並因此定下規則:面板成績不在跨面板間直接比較,只比三面板平均。官方專案頁也把這條講白,註明 GPT-5.6 Sol 加 Qwen 的面板是交叉核對用。
評審流程本身有做盲測設計:評審看得到題目與檢查題,但看不到系統身分、原始碼與代理筆記,而且每個判斷都要求附上時間區間與畫面或聲音頻道當證據,不能只給結論。可信度方面,三面板平均排出的系統名次與人類盲測偏好高度一致(等級相關係數 0.98),但對單一支影片的成對判斷只有 73% 與人類相同,也就是說這套評審適合排系統,不適合裁定單支影片。論文另做了一個側面驗證:針對 34 道課堂與論文類任務寫了 404 道選擇題,讓 Gemini 4 Argon 只看影片作答,答案必須附上時間戳與影片原句當證據,這份測驗排出的系統名次與評審的相關係數 0.93,量測的是影片有沒有把該講的內容涵蓋到。專案頁同時誠實標註:分數尚未與人類評級正式校準,也沒有跨構面加權總分,比較時應留在同一評審面板內。
把 API 帳單攤開,九款系統的每任務成本從 GLM-5.3-Flash 的 0.32 美元到 Claude Opus 5.5 的 15.38 美元,差距 49 倍(全程共 163,197 次 API 呼叫,每任務輸出 token 從 6.1 萬到 28.9 萬不等)。換算每美元能買到的整體分數,最便宜的 GLM-5.3-Flash 以 8.83 分居冠,DeepSeek-V4.1-Flash 以 8.25 緊追在後,GPT-6 Astra 是 0.50,Claude Opus 5.5 只有 0.26。如果任務量大、對品質的要求是夠用就好,成本軸會完全改寫選型答案。
時間方面,團隊把三款系統放在 15、30、60、120 分鐘四種預算下各重跑 20 道任務(這組重跑由單一評審面板計分)。以 DeepSeek 為例,15 分鐘時整體分 2.89、20 道只交出 16 道;30 分鐘升到 3.80、20 道全交;60 分鐘 3.92;120 分鐘 3.94,幾乎不再進步。短預算先垮的是交件率而非品質,而過了一小時之後加時間的邊際效益非常小,這與一小時的設計選擇相互印證。
代理的自檢行為也有一個反直覺的結果:95% 的執行會看自己渲染出來的畫面,但看得多寡與最終品質幾乎無關(相關係數 -0.07),而且結案報告常宣稱做了某項驗證,實際上驗證並沒有發生。代理說「我檢查過了」,在這份測試裡不是可靠訊號。
基準本身還沒開放下載,官方專案頁的 GitHub 與 Hugging Face 欄位都標著 Coming soon,短時間內第三方無法自行重跑排行榜。但對已經在用 AI 做影片的團隊,這份測試的三個教訓今天就能用上。
先把可播放版本交出來,再回頭打磨。Opus 的 24 分鐘完成餘裕與 169 件的時間管理失敗指向同一件事:渲染是整條流程裡最不可壓縮的一段,先產出完整可播放的粗版,剩下的時間才拿來改細節。會用 Remotion 寫程式做影片的讀者,可以參考 Finch 免費剪片技能把 MP4 與可修改專案一起交付的做法,那正是這份基準要求的交付型態。
渲染管線要先估時間再上線。逐格瀏覽器擷取需要 5 到 35 分鐘、ffmpeg 管線會因錯誤輸出未被讀取而死鎖,這兩個坑都發生在最後一步,值得在流程裡加一道渲染時間的預估與小規模試跑。想用對話把整支影片做完的讀者,Pexo 這類代理式影片工具的點數帳與授權設計,或 Codex 做白模再交 Seedance 生成的分工做法,都可以跟這份測試的結論互相對照:前者賣的是整段對話式製作,後者把程式渲染與像素生成分給不同模型,VibeVideoBench 測的是純程式路線的上限。
驗收標準裡加一條「有聲音」。48 支無音軌影片的案例說明,檔案存在不等於合格,驗收清單至少該查到有無音軌這一層。
這份基準的「第一個」定位是作者自稱(論文原文寫的是 to our knowledge),開放領域裡是否有性質相近的既有測試,需要等社群檢視。測試環境沒有 GPU,結果不能直接外推到有 GPU 或不同預算的環境。中文任務佔 30 道,比例偏低,中文表現是否與英文一致,論文沒有單獨拆分。九款系統的排名綁定特定 Harness 與模型版本,模型一改版就會過期。基準與程式碼釋出後,排行榜能否被獨立重現、評審校準會不會修正,是下一個該回查的時間點。