TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

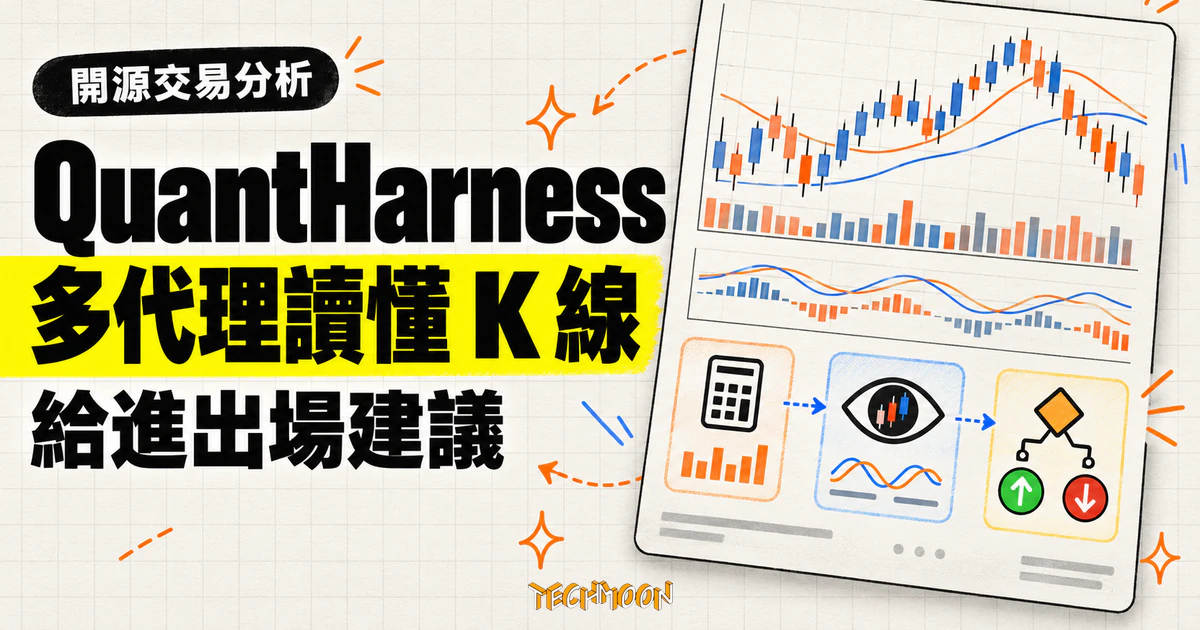
QuantHarness 是石溪大學團隊開源的多代理 LLM 交易分析平台(原名 QuantAgent),程式先算好五項指標與趨勢通道、畫成 K 線圖,再交給視覺模型讀圖,決策代理彙總出方向、理由與風險報酬比建議。本文從原始碼對照論文,拆解它實際交貨的範圍、自備金鑰的六家模型選項,以及名稱裡的高頻該怎麼理解。
用 AI 摘要這篇文章:
把大型語言模型放進交易決策鏈,這兩年學界走出了兩條路。一條讓模型讀新聞、讀財報、讀社群討論,做偏長線的消息面判斷,論文裡點名的 TradingAgent 與 FINMEM 都屬於這一支;另一條回頭相信交易圈最古老的直覺:圖會說話。QuantHarness 走的是後者,而且做得相當徹底,K 線圖先由程式算好指標、畫好趨勢通道與標註,再交給看得懂圖片的模型判讀,最後由決策代理彙總成一段附理由的方向建議。
這個專案出自紐約州立大學石溪分校 Y-Research 團隊,與卡內基美隆、英屬哥倫比亞、耶魯、復旦的研究者合作,2025 年 7 月上線、9 月掛上 arXiv 論文,MIT 授權完整開源,到 2026 年 10 月底累積近兩千九百顆星。它在 GitHub 上的現名是 QuantHarness,原本叫 QuantAgent,2026 年 7 月下旬才改名,舊網址會自動轉到新倉庫,你搜到的 QuantAgent 教學與討論指的都是同一個專案。
先交代它實際交付什麼:在本機跑一個 Flask 網頁,選好商品與時間週期,系統抓最近的 K 線、計算指標、產出帶標註的圖,幾個分析代理各自交出報告,決策代理彙總出作多或放空的方向、預測視野、決策理由與風險報酬比建議。它不會替你下單,倉庫裡沒有任何券商串接,也沒有回測引擎;論文裡的效能數字,repo 裡同樣沒有一鍵重現的程式。想把它接到實單,執行層與風控都得自己寫。
QuantHarness 的核心設計,是把交易分析拆成性質不同的兩層,讀原始碼時最有收穫的也是這一段。
數值層全是確定性程式。指標代理背後的工具箱用 TA-Lib 計算五項經典指標:RSI(預設週期 14)、MACD、隨機指標、ROC(預設週期 10)與 Williams %R,每一項都是包在 LangChain 工具介面裡的純計算函式,同樣的 K 線進去,算出來的數字永遠一樣。送給模型判讀時,多數指標序列只取最後 28 個值,這個切片長度寫死在工具函式裡,控制的是餵給模型的上下文長度。趨勢代理的通道更有意思,原始碼對近期高低點做迭代配適:先取樞紐點與初始斜率,反覆調整斜率直到沒有價格點越過軌道,再把上下軌切成線段畫上圖。這套做法不神秘,但每一步都攤在 graph_util.py 裡,想驗證通道怎麼來的讀者可以逐行對。
語言層才輪到 LLM。整條流程用 LangGraph 的狀態圖組起來:指標、圖形、趨勢三個分析代理逐一接力,先後跑完把報告交給 Decision Maker 節點收斂,狀態裡帶著 K 線資料、各代理報告與訊息序列。趨勢代理把畫好通道標註的 K 線圖餵給模型,圖形代理給的則是乾淨的 K 線圖加一份常見型態清單,請它們用白話描述看到的型態與走勢;指標代理把數值層的輸出交給模型解讀成動能強弱;決策代理讀完三份報告,寫出結論。README 的「重要說明」寫得直接:模型必須支援影像輸入,因為圖形與趨勢分析靠的就是讀圖。這代表純文字模型跑不動這條鏈,選型時 gpt-4o、gemini-2.5-flash、qwen3-vl-plus 這類視覺模型才是有效選項。兩層的溫度都預設 0.1,盡量壓低判讀的隨機性,但不會是零。
為什麼要繞一圈畫圖給模型看,而不是直接丟數字陣列進去?從原始碼的分工看,至少有兩個用意。視覺模型本來就擅長圖形判讀,雙底、突破、收斂這類靠形狀說話的型態,畫出來比列數字更接近模型擅長的輸入;另外,指標值、通道上下軌、型態標註全部留在同一張圖上,決策代理引用的理由可以回溯到圖上的具體位置,整條鏈的判斷過程攤開來可檢查,這對研究用途比黑箱打分數有價值。論文把自己這套稱為價格驅動(price-driven),對照讀文字訊息的那一支,分野就在輸入的形態:一邊餵文字,一邊餵畫好的圖。圖形代理的實際做法也反映這個思路:程式把 K 線圖連同一份常見型態清單交給視覺模型,請它指出最像的型態並用白話解釋,模型輸出的是「這長得像雙底」這種交易員語言,不是一組機率分數;README 把這一步描述成「先標出主要高低點再比對型態庫」,程式碼裡其實沒有這個標記步驟。
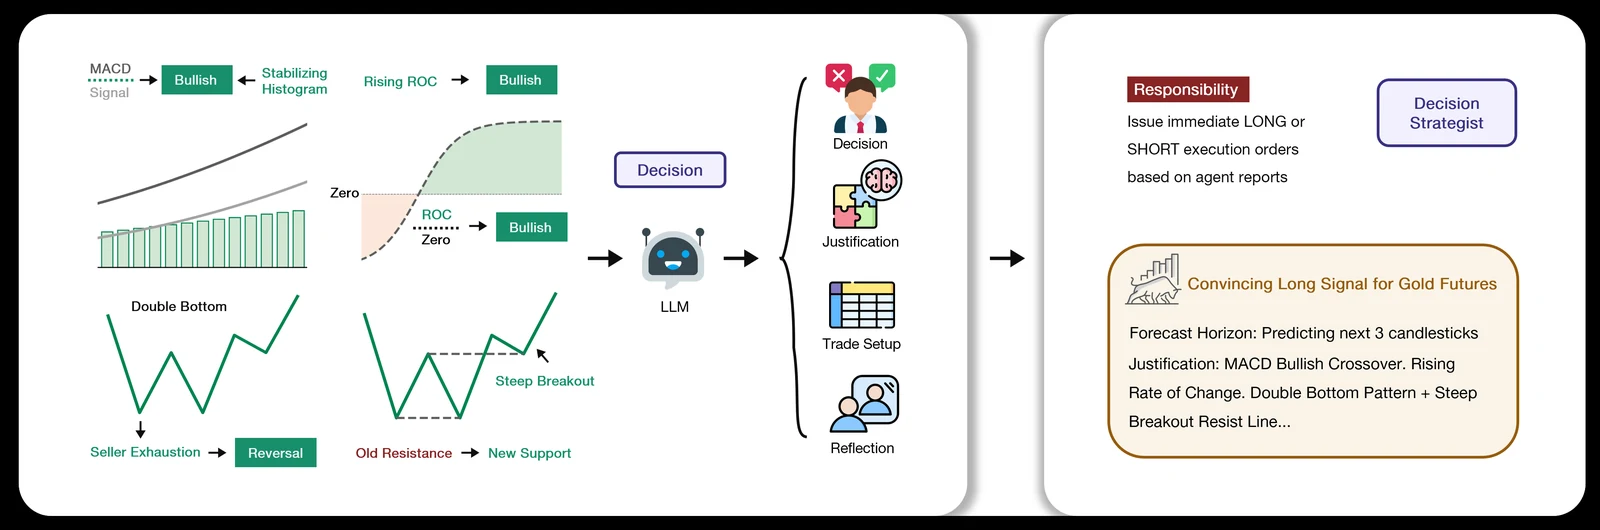
決策代理的輸出是四個結構化欄位:預測視野(範例寫的是接下來三根 K 棒)、方向(作多或放空)、一段決策理由,以及風險報酬比建議,比例在 prompt 裡寫死區間 1.2 到 1.8,並要求依當下的波動度與趨勢強度給值。值得注意的是 README 宣稱決策會給「進場與出場參考點、停損門檻」,但結構化輸出裡沒有這些欄位,prompt 也沒有要求具體價位;方向與理由是真的,點位級的進出場建議停在文件層。官方架構圖裡的範例輸出是黃金期貨的作多訊號,理由欄位逐一引用 MACD 黃金交叉、ROC 上升與雙底型態,決策鏈的每一環都對得上前一段講的分工。
網頁介面是 Flask 驅動的單頁。資產選單預設是比特幣、以太幣與幾檔美股大型股,另有 Custom 輸入任意 Yahoo Finance 代號,期貨加 =F、指數加 ^,後端清單裡的 S&P 500 或黃金期貨要用自訂代號叫出,台股掛牌公司用 2330.TW 這類代號輸入,能不能取到資料取決於 yfinance 端。網頁時間框架按鈕從 1 分鐘到日線(程式層另支援 5 分鐘、30 分鐘、週線與月線),不過 yfinance 對短週期有回看限制,例如 30 分鐘線最多回看約 60 天,想做更長歷史的分析得改走程式化路線餵自己的資料。行情來自 yfinance 的免費資料源,系統自動抓最近的 45 根 K 線送進分析。這裡有個值得記下的細節:README 寫的是 30 根,原始碼裡實際切片是 45 根,註解裡還留著從 49 根一路調下來的痕跡,文件沒有跟上程式的最後一次調整。
資料入口不止網頁這一條。程式層留了一個列出本機 CSV 檔案的介面(依「商品_週期_日期.csv」命名,欄位需要 Datetime、Open、High、Low、Close),但倉庫裡沒有把檔案內容讀進分析的程式碼,網頁端也寫死一律用即時行情;想餵自己的資料,要靠下面這條程式化路線。更完整的程式化入口是 trading_graph 模組:建一個 TradingGraph 物件,把 K 線資料、商品名稱與週期放進初始狀態,呼叫 invoke() 就拿到完整分析結果,幾行程式碼就能把整條代理連結進自己的資料管線,想換掉 yfinance、餵自己行情源的人從這裡下手。
讀到這裡你可能會問:那論文裡講的風險代理呢?這是 QuantHarness 最值得攤開講的落差。
arXiv 論文的摘要明確寫著系統分解成四個專任代理:指標、圖形、趨勢、風險。README 裡決策代理的介紹也說它彙總「指標、圖形、趨勢與風險代理」的輸出,專案網頁同樣列出四個。但翻開建構整條 LangGraph 流程的 graph_setup.py,實際加進狀態圖的節點只有指標、圖形、趨勢三個分析代理,逐一串接後交給 Decision Maker 結束;分析與決策的程式碼裡找不到任何風險代理實作,risk 相關的程式碼只有決策輸出的風險報酬比欄位。換句話說,論文架構裡的第四個代理,在開源版本裡還沒有對應的程式碼。
這不是 QuantHarness 獨有的狀況,學術專案的論文常是研究當下的快照,開源倉庫則是持續搬動的可行系統,兩者之間本來就會有時間差。文件與程式碼的漂移在這個專案可以數出好幾處:剛才的 30 根與 45 根之差;README 宣稱的進出場點位與停損不在結構化輸出;圖形代理的高低點標記只存在於文件描述;專案網頁把指標寫成 RSI、MACD 與 Bollinger Bands,但程式碼實算的五項裡沒有 Bollinger Bands。給讀者的實用結論有兩個。引用規格時以原始碼為準,文件層的描述有時間差;想研究「風險評估怎麼做成一個代理」的人,在這個 repo 裡會撲空,論文與程式碼要對照著讀,拿論文當功能清單會踩空。
環境是入門那道關。README 建議 Python 3.11 配 conda 環境,依賴清單裡最麻煩的是 TA-Lib,這個 C 語言函式庫在部分系統上編譯不過是常態,README 為此給了 conda-forge 的替代安裝指令。其餘依賴都是常規組合:Flask 做網頁、yfinance 抓行情、pandas 與 numpy 做資料處理、mplfinance 與 matplotlib 畫圖,LangChain 與 LangGraph 組代理流程,其中還有一個 langchain-qwq,是接 Qwen 系模型用的。順帶一提,依賴清單列了 scipy,但整個倉庫沒有 import 它,趨勢配適用的是純 numpy。啟動就是一行 python web_interface.py,瀏覽器打開 127.0.0.1:5000。
模型金鑰是另一道關。QuantHarness 是自帶金鑰(BYOK)的設計,介面上有六個供應商選項:OpenAI、Anthropic、Qwen、MiniMax 國際站、MiniMax 中國站與 Google Gemini。預設組合是代理層 gpt-4o-mini、決策層 gpt-4o;選 Anthropic 會換成 claude-haiku-4.5,選 Qwen 是 qwen3-max 配 qwen3-vl-plus,選 MiniMax 用 MiniMax-M3(國際與中國站走不同端點),選 Gemini 是 gemini-2.5-flash,介面上還標了 Free 字樣。金鑰可以放環境變數,也可以直接填進網頁裡的 API 管理框,存進組態後續分析就不用再填。這些供應商支援多數是 2026 年上半年由外部貢獻者陸續補上的,等於社群把這個學術原型慢慢養成了多模型工具。
組態裡代理層與決策層的模型可以分開設,看起來是現成的省錢槓桿,但看接線要小心:預設情況下指標判讀用的是決策層模型,代理層的便宜模型主要用在圖形與趨勢代理的工具呼叫路由,預設組合沒有把便宜模型放到最忙的位置,真要省錢得自己調組態。換模型會不會影響結果?會。六個選項預設的模型不同、影像判讀能力不同,同一張圖不同模型的讀法本來就會有差異,跨模型的輸出不能直接當成同一套訊號比較,做實驗時固定模型是基本紀律。
隱私邊界要畫清楚:行情下載與 K 線圖產生都在你的機器上,但判讀發生的那一刻,帶標註的圖與商品名稱會送到你選的那家模型雲端。它不是本機推理工具,資料出不出門取決於你的金鑰指向誰,成本也由那次呼叫按量計費。另一個現實帳是:一次完整分析至少要跑三個分析代理加一個決策者,等於多趟模型呼叫,用高階模型的話,一份報告的成本比你想像的高,拿免費額度的 Gemini 當入門試跑是合理起點。
論文標題把 QuantHarness 定位成高頻交易框架,摘要也自述是第一個專為高頻交易設計的多代理 LLM 架構。對照它實際的資料源與流程,這個詞要看得精確。
實務界說的高頻交易,指的是機房共置、微秒級延遲的競速。QuantHarness 的鏈路是:yfinance 免費行情(部分市場有延遲)、模型逐代理呼叫的秒級回應、每次分析只看最近 45 根 K 棒。論文自己的評估也是在 1 小時與 4 小時週期上做的,並非毫秒級搶價。把它理解成短視窗的日內研究工具,比把它當高頻系統部署,期待會準確得多。
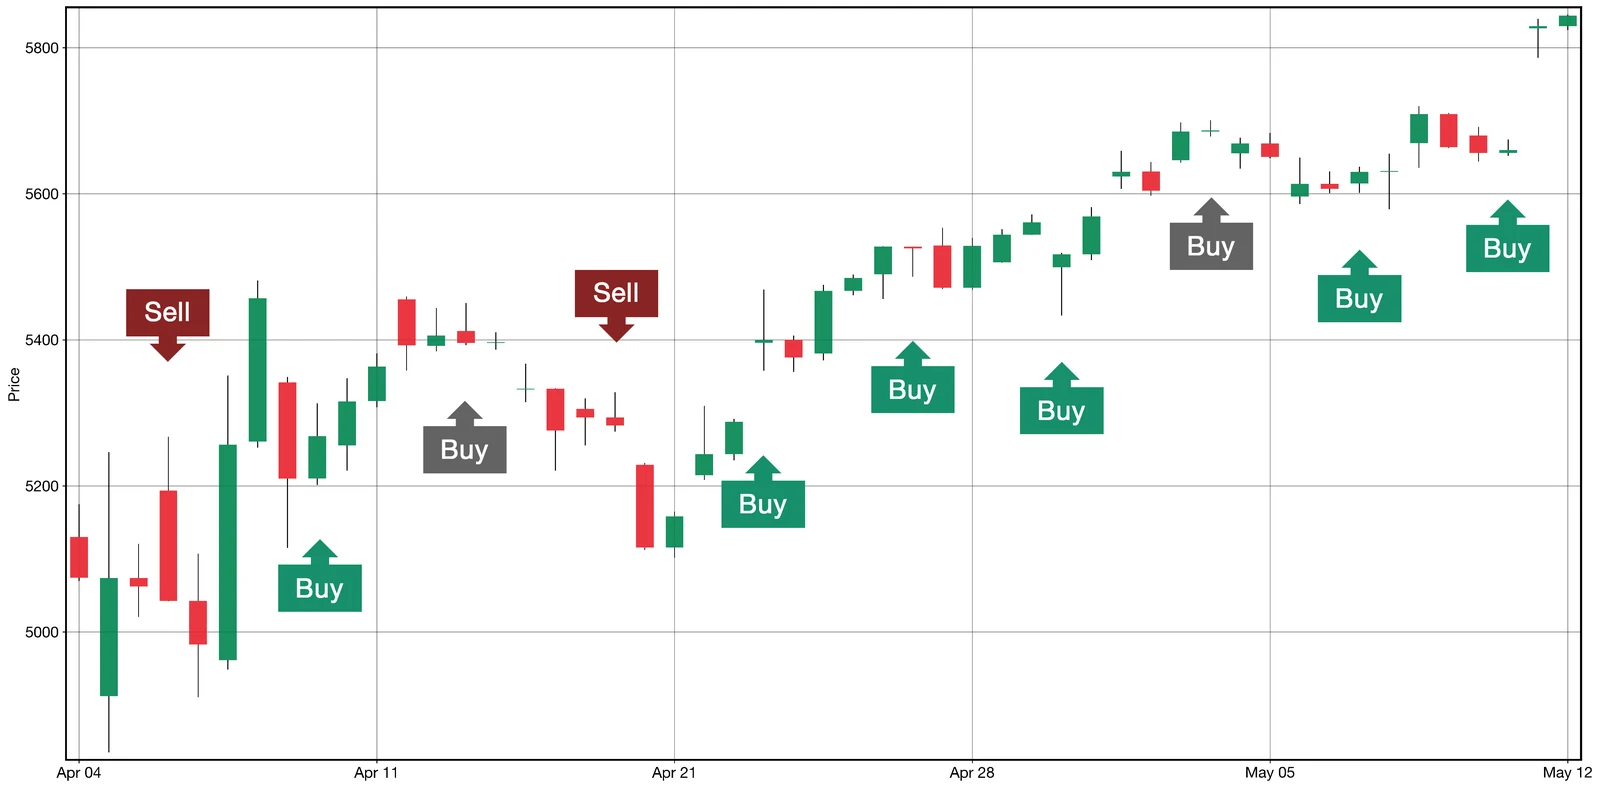
效能宣稱也一樣要標來源。論文寫在九項金融商品(含比特幣與 Nasdaq 期貨)上,預測準確度優於隨機、線性迴歸與 XGBoost 三種基線;隨機基線是地板,線性迴歸與 XGBoost 是兩種不讀圖的淺層模型,打贏它們說明「LLM 讀圖」這條路有東西,距離打贏實務策略還很遠。這些是零樣本設定下的作者宣稱,repo 沒附回測引擎讓第三人重現;專案網頁的案例分析顯示某段 SPX 樣本十個訊號八個方向正確,那是單一期間的樣本截圖,不是常態保證。決策鏈裡有 LLM 判讀,就永遠有變異的可能,溫度 0.1 壓低它,拿不掉它。這些數字可以當選題線索,不該當績效依據。
能拿它直接回測嗎?現在不能。倉庫裡沒有回測迴圈、沒有績效統計,論文實驗的評估管線也沒有開源,你要自己把 TradingGraph 的輸出接進自己的回測框架,訊號品質才算真正被檢驗過。這也是研究起點與交易產品之間那條線的具體位置。
把 git 歷史攤開,QuantHarness 呈現典型的學術專案節奏。2025 年 7 月 9 日初始提交,兩天內補上授權檔;2025 年 9 月 arXiv 論文編號 2509.09995 上線後,核心架構就基本定住,之後的改動幾乎都是供應商支援與小修,而且多數來自外部貢獻者:2026 年 3 到 6 月間,陸續有人提交了 MiniMax、MiniMax 中國站、Gemini 供應商與 M3 升級的 pull request。2026 年 7 月 23 日作者把專案從 QuantAgent 改名 QuantHarness,同一批提交更新了網頁與示範動圖,README 建議的 conda 環境名也跟著從 quantagents 改叫 quantharness;2026 年 8 月 18 日同一天合併三個外部 pull request(MiniMax 升級、Gemini 供應商、星數歷史圖修復)之後,主線就凍結了,到本文查證的 10 月底沒有新提交。
137 個 commits、2,885 顆星、621 次 fork、3 個未關閉 issue,對一個附論文的學術 repo 是相當亮的數字,提交歷史裡多次「update wechat」也透露主要社群互動發生在微信圈,英文 issue 區相當安靜。給讀者的判斷是:把它當教材與研究起點,凍結狀態影響不大,架構與論文都在;要把它放進長期維運的正式環境,就得認知它可能就停在 2026 年 8 月,供應商 API 一改,修的人可能是你也可能沒有人。
適合的人有三種讀者樣貌。想讀多代理 LLM 架構原始碼的人,這是一份小而完整的 LangGraph 樣本,狀態圖、工具箱、代理 prompt 全部攤開,代理與工具鏈的 Python 程式碼約一千七百行,加上網頁端合計約兩千九百行,一兩個下午讀得完;想重現或延伸論文實驗的研究者,它給了可改造的底座,只要自己補評估迴圈;想讓「LLM 讀圖判讀」接上自己行情源的工程者,TradingGraph 的程式化介面就是為此留的。如果目標只是先玩玩 LLM 交易這個題目,AITradingSimulator 用三個指令就能起一場紙上交易競賽,門檻低得多;要的是帶回測的自架量化工作台,QuantDinger 更對題;還在建立量化概念的讀者,Quant Wiki 的中文條目是更便宜的起點。
不適合的用法同樣明確。拿它的訊號直接下單:訊號沒有經過獨立驗證的歷史績效,模型判讀有隨機性,零樣本比較也不含實盤的滑點與手續費,當研究材料成立,當交易依據不成立。需要低延遲的場景:鏈路裡的模型呼叫決定了它的速度上限。期待開箱即用產品的人:TA-Lib 安裝、金鑰設定、英文與簡中介面,每一關都要動手,它假設的讀者本來就是願意讀程式的人。
第一步很具體:照 README 建 conda 環境、裝依賴、啟動 web_interface.py,挑一檔你最熟悉的商品跑 1 小時週期,把決策代理給的理由與你自己看圖的判斷並列對照。它講得通的部分,你會知道這套架構的價值在哪;它講不通的部分,你會比任何評分都更快看清邊界。