TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

史丹佛與 Radical Numerics 的 Halcyon 研究只用 1 億組圖文配對從零訓練文生圖模型,完全不預訓練語言模型。1.6B 版本以 275 分之一的總預訓練算力勝過掛 Qwen3 文字編碼器的擴散基線,三個消融實驗都顯示語言預訓練沒有幫助,五種尺寸檢查點已在 Hugging Face 開源。
用 AI 摘要這篇文章:
文生圖模型有個很少被質疑的產業慣例:先把一顆語言模型餵飽網路規模的純文字,再讓它當生圖模型的「大腦」。2026 年 10 月 15 日,Radical Numerics 與史丹佛大學的研究團隊發布了一份 25 頁的預印論文與五種尺寸的模型檢查點,把這個慣例變成一道可以量化的實驗題:拿掉語言預訓練,文生圖會變差多少?論文給的答案出乎意料,在他們的受控比較裡答案甚至是「沒有變差,還變好了」。
這個名為 Halcyon 的模型家族完全從零訓練,只吃 1 億組圖文配對,連文字與圖像的 tokenizer 都是自訓的。對照組是兩個帶語言預訓練的主流做法:自迴歸路線的 LlamaGen-XL/8 掛著 1.22B 參數的 FLAN-T5-XL 文字編碼器,擴散路線的 JiT-T2I-XXL/8++ 掛著 1.7B 的 Qwen3。論文裡兩個最受矚目的數字:Halcyon-0.52B 用少 18.2 倍的總預訓練算力,在 GPIC 測試集上把 LlamaGen-XL/8 比下去(生成弗雷距離 gFD 48.0 對 63.3,越低越好);放大到 1.6B 參數,用少 275 倍的算力勝過 JiT-T2I-XXL/8++(35.3 對 41.0)。275 倍是什麼概念:對手花一整年訓練,等價的說法是 Halcyon 只花一天多一點。
先講清楚這次發布的主體:它不是產品,是研究。改變的東西在方法論層:一份把「語言預訓練對文生圖的貢獻」攤開來算的受控實驗,加上可以直接下載的研究檢查點;沒變的東西也一樣明確:你今天用的 FLUX、Midjourney 或 GPT Image,沒有任何一個因為這份論文而改變。論文連同官方部落格與檢查點都在 10 月 15 日同日公開。
要看懂這份研究在挑戰什麼,先把兩種主流接法分清楚。晚期融合(late fusion)是現在多數文生圖系統的做法:一顆在純文字上預訓練好的語言模型當編碼器,把提示詞變成向量,再透過注意力層餵給另一顆獨立的圖像生成器;文字與圖像兩顆模型各訓各的,最後在生成時接起來。早期融合(early fusion)則把兩者裝進同一顆模型:文字 token 直接當序列的前綴,圖像 token 接在後面,用同一套注意力機制一起預測,Chameleon 與 Emu3 都屬於這一路。兩種接法看似不同,論文指出它們有一個共同點:純文字的語言預訓練都佔掉大部分的算力預算,而這筆帳在多數文生圖論文裡根本沒被計入。
Halcyon 團隊做的第一件事就是把這筆帳攤開。他們把幾個代表性文生圖系統的總預訓練算力,拆成語言與視覺兩桶來畫圖:LlamaGen 的 FLAN-T5-XL 編碼器、JiT-T2I 的 Qwen3 編碼器,語言那一桶都遠大於圖像那一桶。換句話說,當產業把「更強的文字理解」當成生圖品質的理所當然投資時,這份研究問的是:這筆投資的回報率到底多少?一個小線索藏在消融實驗裡:把 LlamaGen 的文字編碼器從 0.11B 的 FLAN-T5-Base 換成 1.22B 的 FLAN-T5-XL,語言模型的訓練算力差了 13.5 倍,生成品質只從 66.7 進步到 63.3。算力換品質的邊際效益,一開始就攤得很平。這也是整份研究讀下來最反直覺的地方:產業直覺假設文字理解是生圖的地基,帳面上卻看不到這筆投資在哪裡回收。換算成絕對值,論文註腳引的估計是 FLAN-T5-XL 的預訓練約 9.06×10^21 FLOPs,FLAN-T5-Base 約 6.69×10^20 FLOPs,多出的那一個數量級,只換到三點多的 gFD 改善。對照表裡也留了縮編碼器的那一列:LlamaGen-XL-T5-Base/8 把文字編碼器降級成 0.11B 的 FLAN-T5-Base 後,gFD 66.7、GenEval 28.48、DPG 64.67,各項都只比完整版退一小步。
Halcyon 本身是一個 decoder-only 的自迴歸 Transformer 家族,參數量從 0.1B 一路到 4B,共五個尺寸。架構直接用 Qwen3 的設計,但權重隨機初始化,沒有吃任何預訓練。它把四種序列裝進同一套 80,640 條目的詞彙表(16,384 個文字 token、64,000 個圖像 token、256 個特殊 token),共用一個嵌入表與一個輸出頭:純文字、純圖像、圖生文(I2T)與文生圖(T2I)。圖像端用 Cosmos 風格的編碼解碼器加有限純量量化,把一張 256×256 的圖壓成 32×32 網格共 1,024 個圖像 token。
這套從零訓練的 tokenizer 並不陽春。圖像端用重建與感知損失訓練一個 epoch,再補半個 epoch 的對抗損失,解碼器寬度從 Cosmos 的 128 加寬到 192;在 GPIC 測試集的重建評比上全項指標勝過 Cosmos-DI-8×8(重建弗雷距離 18.86 對 37.93、LPIPS 0.062 對 0.153),對照真圖對真圖的參考值 7.59,差距已經不算遠。論文也誠實標了已知弱點:小字與細緻圖形的保真度仍偏低,這是離散式 tokenizer 的共同課題。文字端更值得看:詞表只有 Qwen3 的九分之一大(16,384 對 151,669),在 GPIC 測試描述上的壓縮率卻幾乎打平(每 token 4.774 對 4.763 位元組),明顯勝過 FLAN-T5 的 4.152。小詞表養出接近的壓縮力,對把詞表規模當成本在算的團隊是個好消息。
訓練資料是關鍵前提:全部 1 億組圖文配對來自 GPIC(Giant Permissive Image Corpus),這是同一批人 2026 年 5 月發布的資料集,主打授權乾淨、可自由用於訓練。五個尺寸都只看資料一遍(一個 epoch),全局批次 1,024、97,632 步,同樣的暖身衰減排程。放大行為也值得記一筆:從 0.1B 到 4B,GPIC 測試集的生成弗雷距離從 144.16 一路降到 28.43,還沒有看到飽和;最適的分類器自由引導強度隨尺寸從 7.5 降到 4.5,模型越大越不需要靠引導硬拉。提示長度也有個實用的旁證:在 GPIC 測試集上,中等與長提示的 gFD 在每個尺寸都優於短提示,這與生圖圈「把提示寫具體」的實戰經驗一致。梯子下半段也一併交代:0.1B 與 0.25B 的 gFD 分別是 144.16 與 72.55,GenEval 是 27.31 與 35.72,最小的尺寸在 GenEval 還輸給原始配置的 LlamaGen-XL(30.03)。從零訓練的優勢要到大約 0.5B 之後才翻正,這條曲線提醒讀者方法不是免費入場券,規模仍然必要。
GPIC 這份地基本身也值得記住:測試用的五萬對圖文直接公開在 Hugging Face 上,任何人都能下載同一份測試集重跑評比,這在大型生圖研究裡並不常見。對照多數閉門資料集的生圖模型,這組實驗的可重現性高一截,也是為什麼後續社群重現值得期待:資料、檢查點、評測協定三樣都齊了,缺的只是有人動手。
這裡的生成弗雷距離(gFD)量的是生成圖片分佈與真實圖片分佈的距離,不是提示遵循能力,所以論文同時跑了兩個公認的提示遵循基準:GenEval 測構圖(物體數量、顏色、位置),DPG-Bench 測長提示的遵循度。Halcyon-0.52B 在兩個基準都勝過 LlamaGen-XL/8(GenEval 44.91 對 30.48,DPG 76.84 對 67.08),對 JiT-T2I-XXL/8++ 則是 GenEval 小勝(44.91 對 43.17)、DPG 打平(76.84 對 76.85);放大到 1.6B 兩項全勝(53.48 與 77.90),4B 的 GenEval 再推到 56.39,不過 DPG 停在 77.90 沒有再動,長提示遵循度的增益在 1.6B 之後暫時踩住。從零訓練路線在提示遵循上並沒有掉隊。
讀這類論文最容易犯的錯,是把它當成產品評比。論文裡的 LlamaGen-XL/8 與 JiT-T2I-XXL/8++ 其實都是研究團隊拿原作者的官方程式碼,在 GPIC 上重訓、再各自強化過的版本。原始配置的 LlamaGen-XL 重訓後是 147.0 的 gFD,換上 1,024 token 的圖像表達後降到 63.3;JiT-T2I-XXL/16 從 67.9 開始,加感知損失、再把圖像 patch 從 16×16 縮到 8×8,才到 41.0。也就是說,Halcyon 比的是「被強化到表現最好版本」的對手,這個門檻設計反而讓結論更乾淨:同一份資料、同一種圖像表達、同樣跑一個 epoch,差別只剩「有沒有先花算力訓一顆語言模型」。關鍵數字整理成下表,算力欄是成對比較:
| 模型 | 融合方式 | gFD(低較好) | GenEval | DPG-Bench | 成對算力比 |
|---|---|---|---|---|---|
| LlamaGen-XL/8 | 晚期融合+FLAN-T5-XL | 63.3 | 30.48 | 67.08 | 算力是 Halcyon-0.52B 的 18.2 倍 |
| Halcyon-0.52B | 早期融合、從零訓練 | 48.0 | 44.91 | 76.84 | 對比基準 |
| JiT-T2I-XXL/8++ | 晚期融合+Qwen3 | 41.0 | 43.17 | 76.85 | 算力是 Halcyon-1.6B 的 275 倍 |
| Halcyon-1.6B | 早期融合、從零訓練 | 35.3 | 53.48 | 77.90 | 對比基準 |
| Halcyon-4.0B | 早期融合、從零訓練 | 28.43 | 56.39 | 77.90 | 未單獨提供對比 |
這也是為什麼 275 倍這個數字要讀得精確。它不是「Halcyon 比 JiT-T2I 省電 275 倍」這種工程宣稱,而是把對手的 Qwen3 語言預訓練、圖像 tokenizer 訓練與生成器訓練全部計入總帳後的比值。論文的算力拆解圖把每個系統畫成語言與視覺兩環的圓圈,Halcyon 沒有獨立的語言模型預訓練,語言那一環只剩聯合訓練裡文字 token 的份額(依尺寸佔 7% 到 19%);對手的語言環才是佔掉大半的外部預訓練(LlamaGen 超過九成三、JiT 接近全部)。對要在算力預算裡做取捨的人來說,這張圖比任何單一 benchmark 分數都有參考價值。
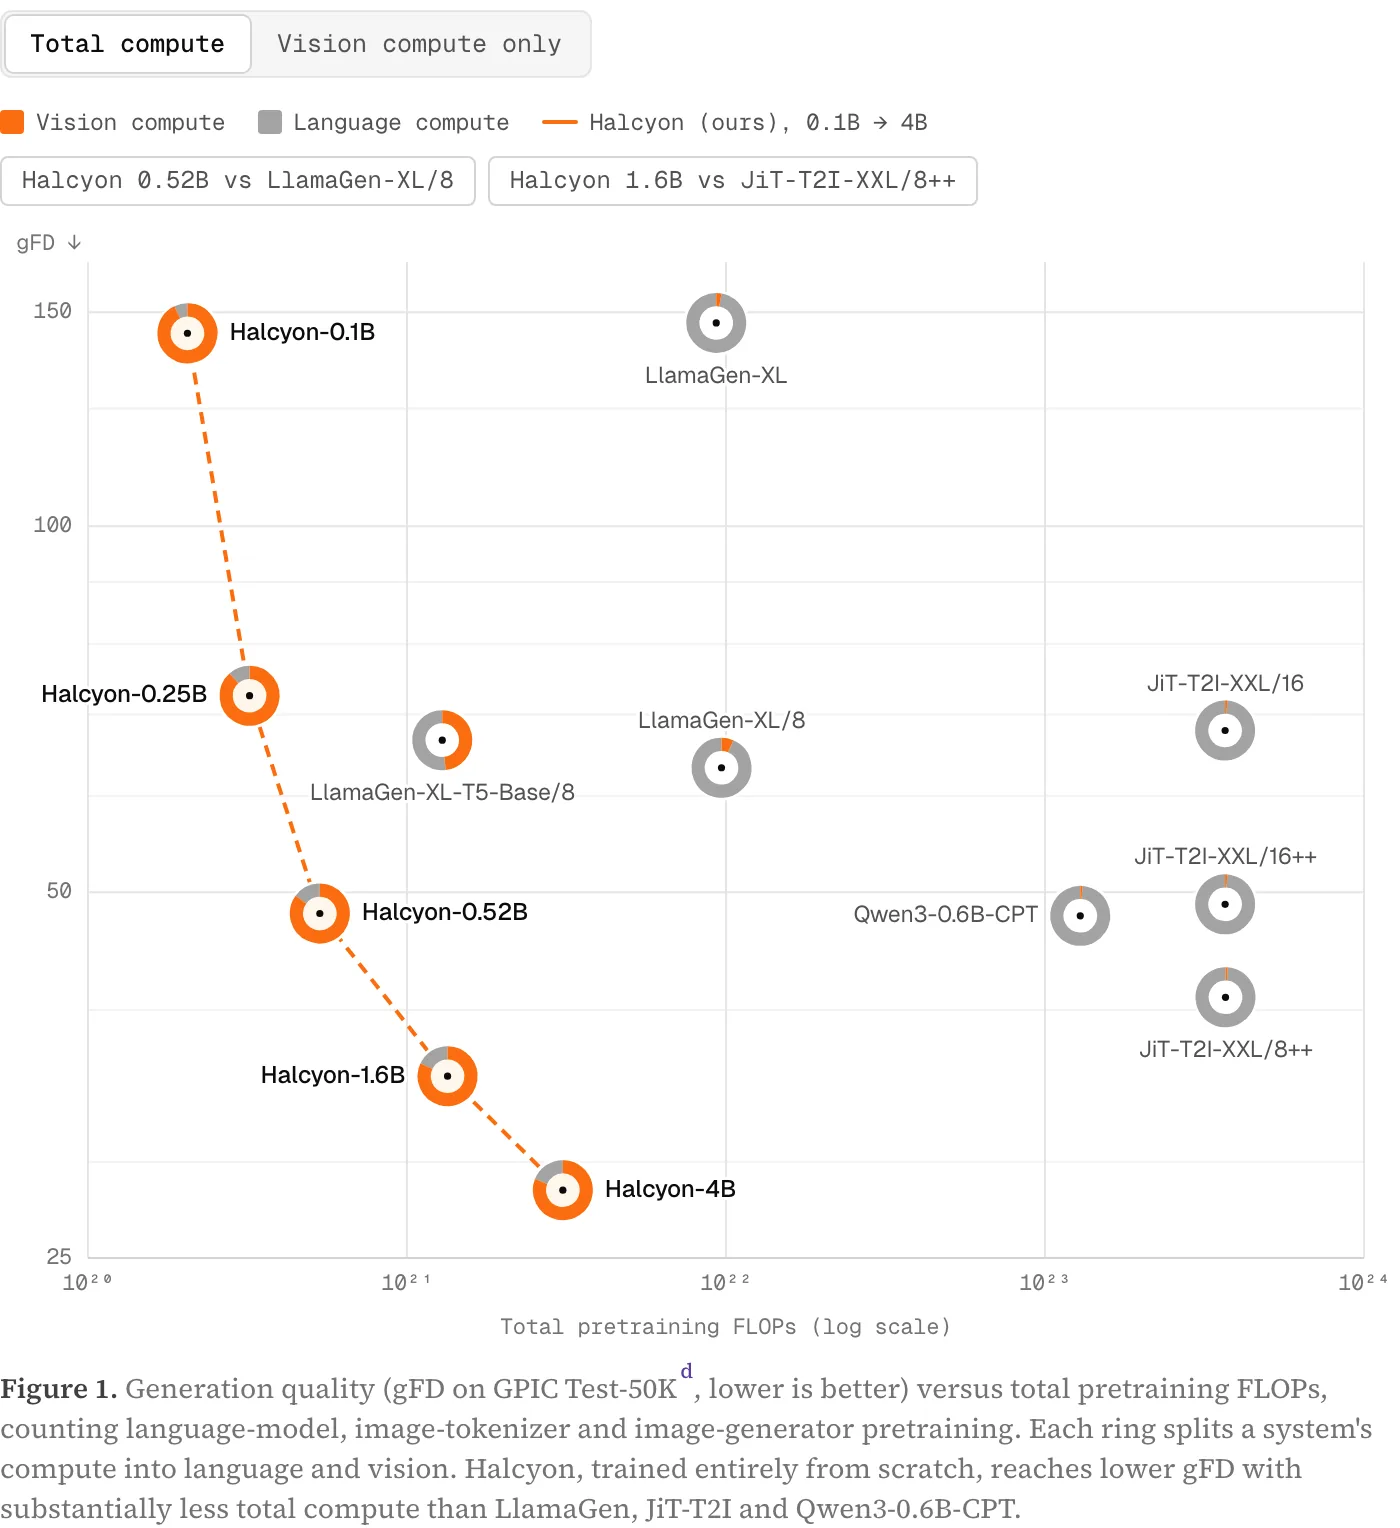
論文最有分量的部分不是勝過誰,而是三個專門設計來回答「語言預訓練有沒有幫助」的實驗。固定預算下的配比實驗先給出直觀答案:把 10%、20%、50% 的訓練量先撥給純文字預訓練再進行圖文訓練,gFD 從 48.0 分別惡化到 51.6、52.8 與 65.1,撥得越多生圖越差,因為圖文對的訓練量被排擠掉了。排擠效應的干擾接著被單獨排除:純文字先做完,再完整跑一個 epoch 的圖文訓練,總算力花到 1.5 倍,結果 49.2 對 48.0,多花的算力沒有買到任何改善。最直接的一問是從 Qwen3-0.6B-Base 接續訓練,這顆模型已經看過 36 兆個文字 token,結果 47.8 對從零訓練的 46.6,龐大的語言先備知識沒有轉換成生圖優勢。算力拆解圖上還有一個殘酷的座標:Qwen3-0.6B 接續訓練的版本拿到 48 上下的 gFD 時,總算力落在 10^23 FLOPs 附近,從零訓練的 0.52B 拿到相近分數只花了約 5×10^20 FLOPs,中間隔著超過兩個數量級。
三個實驗從不同角度切進同一個問題,答案一致:在他們的評估設定裡,把算力花在純文字上,對文生圖沒有可見的回報。這個結論的適用範圍論文自己也寫得很保守,用的是「在評估的設定下」這種措辭,設定指的是 256×256 解析度、一個 epoch、4B 以下參數、GPIC 資料集。它沒有宣稱語言預訓練在高解析度、產品級規模或更長訓練下也一樣無用,這條邊界引用結論前要自己畫上。
一般文生圖模型有個訓練細節:為了取樣時能做分類器自由引導,會隨機丟掉 10% 樣本的提示詞,讓模型同時學會無條件生圖。這些被丟掉的樣本等於浪費了文字監督。Halcyon 的做法是把這些樣本的描述搬到圖像 token 後面,變成圖生文序列:模型先無條件預測圖像,再根據圖像預測描述。能這樣換的關鍵在於兩種序列的前綴完全相同,圖生文序列的開頭與被丟掉提示詞的文生圖序列是同一串圖像 token,所以它可以直接補進分類器自由引導需要的那個無條件分支,引導機制不需要任何改動。同一份資料、同一個預算,生圖品質維持住,模型還順便學會了看圖說話。
數字上這件事成立得很乾脆:0.52B 的圖像條件文字損失從 18.41 降到 1.10;用 Qwen3-VL 重排器量描述與圖像的對齊度,分數隨規模從 0.09(0.1B)升到 0.56(4B),真實人寫的描述是 0.89(量法是以圖為查詢、描述為文件,用 Qwen3-VL-Reranker-8B 對五萬對測試圖文評分)。距離人類水準還有一段,但「免費多學會一個能力」對訓練配方設計者是實實在在的借鑑:與其丟掉監督信號,不如換個順序把它接回去。
排程怎麼排也有實驗支撐。把圖生文當獨立任務先訓完再接文生圖,或讓兩種序列從頭交錯混訓,各撥 10% 預算時生圖都守得住(gFD 48.35 與 48.18,基準是 48.0);撥到 50% 兩種排程都傷生圖,混訓傷得更重(76.0 對 54.2),但混訓換到的描述能力好得多(文字損失 1.009 對 20.437)。論文最後採用的做法回到前面說的替換法:把丟提示詞的那 10% 直接換成圖生文序列,預算不增加,兩種能力都保住。
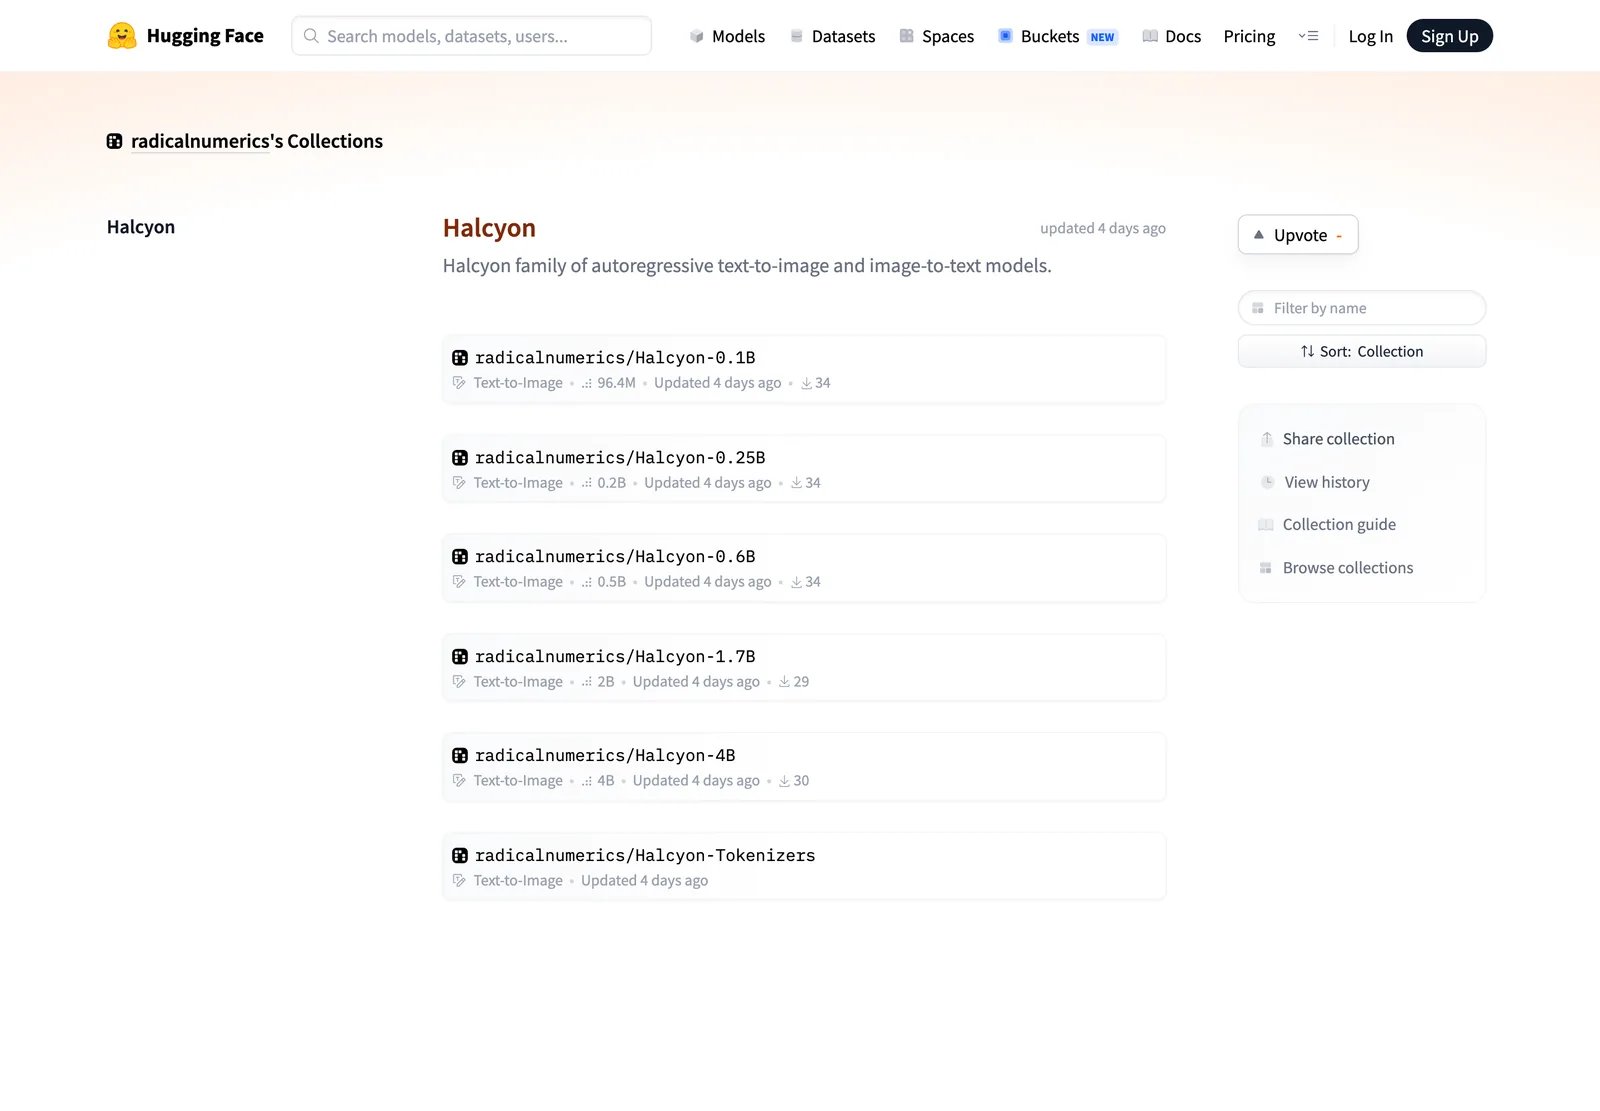
配合論文,團隊在 Hugging Face 的 Halcyon 合集以 radicalnumerics 名義開源了檢查點:0.1B、0.25B、0.6B、1.7B、4B 五個尺寸,外加一個 tokenizer 儲存庫,全部在 10 月 15 日同一天建立。值得注意的是官方部落格寫「釋出十個 Halcyon 模型」,但 Hugging Face 上 Halcyon 相關儲存庫實際能數到的是六個,兩種說法對不上,差的可能是尚未上架的變體,下載前以儲存庫頁面為準。論文裡的 0.52B 與 1.6B 對應上架的 0.6B 與 1.7B(Hugging Face 標註的參數量分別是 5.23 億與 15.7 億),是向上進位的命名差異。上架四天,幾個儲存庫的下載次數都還在三十上下徘徊,關注度顯然還沒跟上題目的爭議度;後續如果有人重現結果,下載數會是最快的風向球。六個儲存庫的更新時間都停在建立當天,之後若出現回頭改動(例如補齊部落格預告的其他模型),也值得回看一眼。
對照著看,這種研究檢查點的開源與商用生圖模型的權重開放是兩件事。前者是研究重現的工具,授權與商用條款要逐庫看清;後者像先前介紹過的 Qwen-Image 開放權重生圖模型,把可下載的權重當成產品策略在經營。Halcyon 的定位屬於前者,適合的研究用途多於直接的生產部署。要下載的話動作可以早一點,十月初 Moondream 被收購後雲端服務直接設了硬停機日的案例就是提醒:掛在別人基礎設施上的入口說關就關,把權重抓在自己手裡才是留得住的那一半。
這份研究最需要守住的三條線,分別畫在規模、資料與發布狀態上。規模的線最明顯:所有比較在 256×256、一個 epoch、最大 4B 參數的設定下完成,離 1024×1024 起跳的產品級生圖還有距離,高解析度下文字 token 的角色可能不同;就算只看研究用途,256×256 的上限也意味著生成結果到不了素材管線的前段,定位是概念驗證而非成品。資料的線緊接在後:訓練與主評測都落在 GPIC 這份自家資料集上,gFD 量的是單一資料集的分佈距離,換資料集的表現需要社群重現才能確認。發布狀態的線也不能忽略:論文目前是發布在官方網站的預印本,尚未見到 arXiv 條目,同儕審查與第三方重現都還沒有發生,論文裡的主要評測數字都出自研究團隊自己跑的實驗。
回頭看研究單位會更理解這份論文的位置:Radical Numerics 的主業是生物領域的多模態預訓練,他們的 Omnii 基因組模型同時建模二十多種生物模態,文生圖對他們只是乾淨的實驗場。語言預訓練是不是必需品,真正決定的是將來多模態基礎模型的算力分配策略,個別生圖產品線反倒其次,這也解釋了為什麼這份論文把算力帳算得這麼細。
所以這則新聞對誰的分量不同。研究生圖模型或在做算力分配決策的團隊,這份論文值得整份讀,特別是算力拆解圖與三個消融的設計,更實際的動作是直接拉 0.6B 或 1.7B 的權重,在自己領域的圖文資料上重跑這組對照;在找可直接使用的生圖工具的一般讀者,現在能做的事有限,檢查點是研究權重不是產品,繼續用現有工具打磨提示詞反而實際,例如 GPT Image 的官方提示詞指南 這類文件對成圖品質的影響比換底層模型更快。追蹤開源生圖生態的讀者可以把它放進觀察清單:如果接下來幾個月有團隊在非 GPIC 資料上重現「從零訓練不打輸」的結果,產業對語言預訓練的預設投資就真的會開始鬆動;反之如果重現失敗,GPIC 資料分佈的特殊性就會浮上檯面。到時候這篇的結論都需要回查,更新的數字以官方部落格與 Hugging Face 儲存庫為準。