TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

Google Research 在 10 月 14 日發布地理空間推理代理技術報告並擴大早期存取,Ask Google Earth 深度分析、代理對代理 API 與行星預測引擎三軌都採限量申請。報告的消融實驗顯示,專家級開放式地理分析的分數從個位數跳到 62.7,功勞主要在 Earth AI 工具層與前置規劃;單獨的聊天模型得分為零。官方同時把輸出定位為供專家審閱的初稿,分數量的是流程比對,不是最終答案正確率。
用 AI 摘要這篇文章:
Google Research 在 10 月 14 日的 Research@ 活動上發布了地理空間推理代理(Geospatial Reasoning agent)的技術報告,同一時間擴大早期存取,開放三條申請路徑:Ask Google Earth 的深度分析預覽、給開發團隊的代理對代理 API,以及行星預測引擎。這個代理做的事情,是把 Gemini 模型接到 Earth AI 的一系列地理模型與地圖工具上,先規劃分析步驟、再執行,產出文字、表格與地圖並陳的報告。
不過這份報告真正值得記住的,是一組拆解得很乾淨的數字。在專家級的開放式地理分析題目上,不帶工具的聊天模型得分是 0;接上 Earth AI 工具後跳到 52.2 分;再加上前置規劃,來到 62.7 分。換句話說,讓模型學會算地圖的,主要不是模型本身換代,而是工具層與規劃層。這個結構對怎麼解讀「AI 會做地理分析」這類新聞,比任何單一分數都有參考價值。
把時間軸對齊。技術報告先在 10 月 11 日登上論文預印本平台 arXiv,10 月 14 日官方部落格與 @GoogleResearch 的官宣貼文同步發布(貼文時間為台北 15 日凌晨 0 點 41 分),內容打包成三件事:發布報告與兩個自建基準測試的開發集、公布五個組織的早期實測、擴大早期存取。
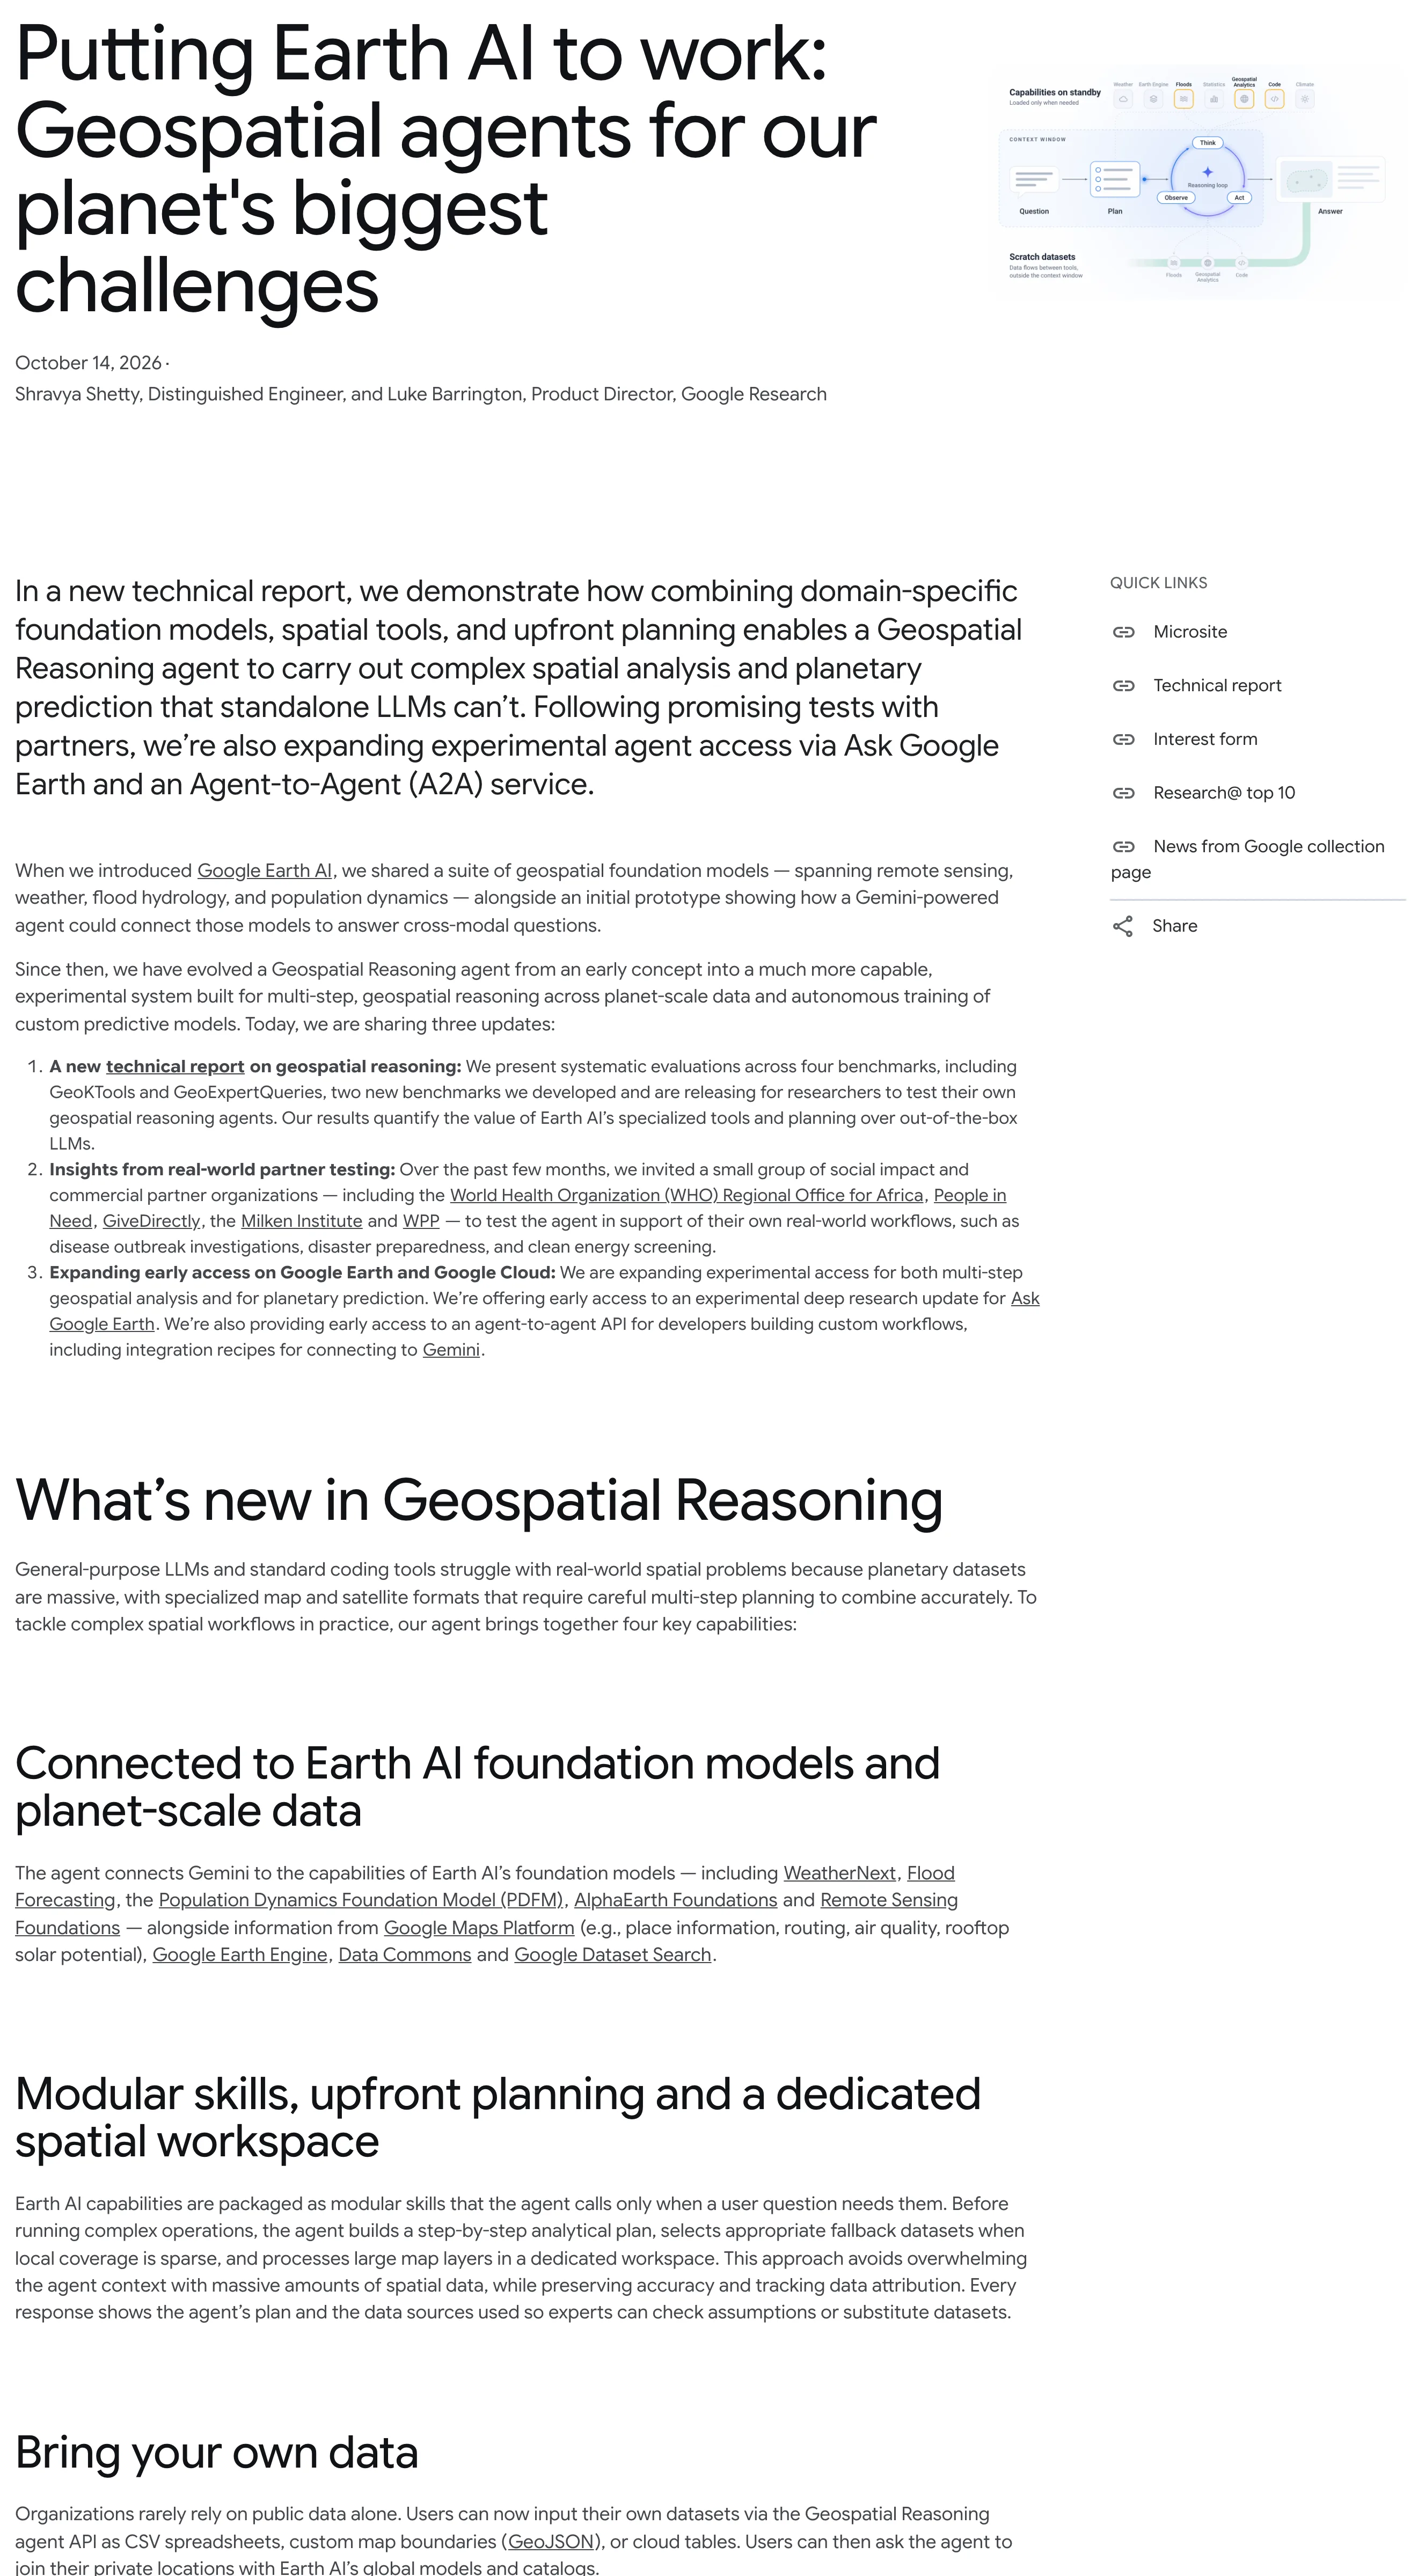
代理的定位也要先講清楚。Google 在 Google Earth AI 之下維護一系列地理基礎模型,涵蓋天氣預報、洪水預測、人口動態、衛星嵌入與遙測;這次的主角是把這些能力包成模組化技能、加上前置規劃的編排層。官方強調兩個設計:大型圖層在獨立工作區處理,不塞進模型的對話視窗;每次回應都附上分析計畫與資料出處,讓專家可以檢查假設或替換資料集。組織也能上傳自己的 CSV 表格、GeoJSON 邊界或雲端資料表,跟全球模型接在一起算。
報告的核心實驗是把同一個問題交給四種配置,分別跑 Gemini 3.1 Pro 與 3.8 Flash 兩款模型:裸模型、加了網頁搜尋與地圖基本工具的模型、接上 Earth AI 工具但沒有前置規劃的模型,以及完整的代理。四個基準測試裡,最有資訊量的是 Google 自建的 GeoExpertQueries:76 道開放式題目,每題附三位獨立專家共識的標準流程,由人工校驗過的自動評分器比對「代理有沒有走完該走的步驟」。
兩個自建基準的開發集都完整公開:GeoExpertQueries 有 25 道開發題、76 道測試題,GeoKTools 是 85 對 220。外部借來的 CBGB 原本有 45 道地球觀測分析題,官方直接剔除最難的一題再計分:那題的參考解法要在多邊形緩衝區上反覆二分逼近約十次,單次嘗試就要跑好幾個小時,超過代理的執行時間限制。
結果的落差大到不需要統計學。裸模型在 GeoExpertQueries 上得分為 0,而且不是偶爾失手,是每個領域、兩款模型都是 0;基本工具版勉強到 3.3 分,官方補了一個更狠的細節:超過八成的題目,這個配置三次測試全部拿零分。接上 Earth AI 工具後直接跳到 52.2 分,加上前置規劃再到 62.7 分。
| 配置 | GeoExpertQueries | GeoKTools | CBGB |
|---|---|---|---|
| 裸模型 | 0.0 | 40.5 | 12.9 |
| 加基本工具 | 3.3 | 40.0 | 19.7 |
| 加 Earth AI 工具 | 52.2 | 86.0 | 87.9 |
| 完整代理 | 62.7 | 85.9 | 86.4 |
表中數字都是 Gemini 3.8 Flash 的成績,0 到 100 分、三次執行的平均。GeoKTools 是模板化、有標準答案的工具呼叫測試,CBGB 是外部地球觀測分析測試;兩邊說的是同一件事:有確定答案的題目,工具一接上就從不及格跳到八十分區間,規劃層增加的幅度有限。規劃真正發揮作用的地方是開放式分析,而它跟模型的搭配還挑人:同樣的規劃在 3.8 Flash 上加分 10.5,在 3.1 Pro 上反而少了 3.2 分。官方對此的解讀很節制:規劃的價值主要在開放式、多步驟的問題上,而且要看模型能不能好好利用它。把 GeoExpertQueries 拆到領域別,完整代理在 Flash 下的成績是危機應變 66.0、選址與都市規劃 65.6、公共衛生 55.6、營運與商業 50.0,四個領域都落在 50 到 66 分之間,沒有哪個領域特別突出,也沒有哪個領域垮掉;其中營運與商業類只有 4 道測試題,這個數字看看就好;對照基本工具版超過八成題目拿零分,差距的形狀非常一致。
四個基準裡壓軸的 UnivEARTH,貢獻了整份報告最有意思的方法學段落。這個由外部團隊設計的 140 題是非題,原本用來測「有沒有能力用地球引擎找資料算答案」,這個基準設計當年測 2025 年初的旗艦模型時,最好的系統在可存取地球引擎的設定下也只有約三成正確率,卡關的地方超過一半是執行失敗,模型會幻覺出地球上引擎目錄裡根本不存在的資產名稱。這次裸模型拿了 93.6 分,看起來像大躍進,執行紀錄卻顯示它 100% 的題目都有作答、九成答對,而且完全沒有做任何計算。原因不玄:題目源自 NASA 地球觀測站的公開文章,答案就寫在網路上,模型用背的、用查的都行。
更諷刺的是完整代理在這個基準上反而吃虧。它有六成的題目認真載入地球引擎技能、照著分析路徑走,於是暴露在 29% 的執行失敗率之下;最後分數跟從不動手的模型差不多。官方把這個結果明確定位成「基準耐久度」的發現,能力證明要另外找證據。對讀者的啟示很實際:看到「AI 在某某地理測驗拿高分」的新聞,先問分數是算出來的,還是查出來的。另外 CBGB 測試裡有四題的參考答案在這次評估前被更新,因為 Sentinel-2 衛星影像重新處理過、某保護區的公告邊界重劃了。地理資料會漂移,連基準本身都會過期,這是地理分析跟一般問答最不一樣的地方。
評估同時算了每題的推論成本。完整代理配 Gemini 3.8 Flash 在開放式題目上每題約 0.199 美元,配 3.1 Pro 要 0.688 美元,而 Flash 版分數還高了 15.1 分;規劃層加上去的那 10.5 分,代價大約每題 3 美分。成本表裡另一個反直覺的數字:基本工具版在 CBGB 上每題花 0.514 美元只拿 13.6 分,完整代理花 0.151 美元拿 84.8 分,這組對比兩邊跑的都是 3.1 Pro,錢都燒在不斷失敗的嘗試上。先前拆 Asana 的 AI 代理成本實驗時就看過同樣的形態:代理的帳單省不省,取決於它有沒有直達答案的路徑,無關模型大小。
官方也在報告裡把話說在前頭:GeoExpertQueries 的分數來自自動評分器對專家流程的比對,量的是「有沒有做該做的事」,不是最終答案的正確率,所以代理的輸出定位是「供專家審閱的強力初稿」。這句定位值得原樣記住,因為它同時劃出了上游與下游:上游,分數不可直接換算成可信度;下游,任何要把這類報告拿去做決策的團隊,都需要留一道專家核對的程序。
五個早期使用者的實測都屬於官方與當事人說法,數字無法獨立覆核,採納時要打折看。但案例的形態本身有參考價值。世衛非洲辦公室在剛果民主共和國今年的伊波拉疫情中,用代理交叉比對森林流失、礦場位置與人口資料,標出高暴露風險的偏遠礦區走廊,幾分鐘內找出 48 個暴露聚落與超過 45,500 名風險人口,同樣的工作過去要花數週;該團隊的引述把機制講得很白:人口移動比紙本監測快,衛星與人流訊號補上了看不見的盲區。捷克的人道組織 People in Need 用它分析 14 條歷史氣旋路徑找出高暴露村莊,把數天的手動 GIS 工作縮到數分鐘;GiveDirectly 在熱帶氣旋 Maila 期間上傳自訂地圖邊界,按風速區計算人口暴露,同一個工作區裡還回頭盤點了美國密西西比的龍捲風災損;Milken Institute 則把 1,500 多棟候選建築配上屋頂太陽能潛力、交通與氣候風險資料,篩選社區韌性中心的落點。五個案例裡唯一的商業端是廣告集團 WPP,把人口動態洞察接上自家資料評估地理行銷成效,官方特別註明它的資料隱私有保全;商業案例的說法通常比公益案例更該打折看。
這些案例的共同點值得注意:都是「把本來要人工對齊的多層資料接起來」的活,不是憑空生成答案。官方另引用自己的公共衛生研究,稱人口與衛星訊號讓健康結果預測比人口學基準改善 12%、空間解析度細 8 倍;同樣是官方數字,引用時標明出處即可。一般讀者平常接觸的衛星影像多半是 Zoom Earth 這類雲圖服務,看的是單一圖層;這批案例展示的則是把圖層相加之前,先處理日期、尺度與座標對齊的那段苦工。
現在實際拿得到的東西分成三軌,而且都是限量申請制。一般使用者這邊,是 Ask Google Earth 裡的深度分析預覽,官方定位成在 Google Earth 專案裡用自然語言問複雜空間問題、分析含自己上傳的資料、在地圖上直接看結果;這是原有功能的擴充預覽,不是全新產品。開發團隊這邊,是實驗性的無頭代理對代理服務,官方提供把它接進自家代理與資料管線的步驟說明,也給了接上企業環境 Gemini 的範例。另一軌是行星預測引擎,互動介面與 API 兩種形式都在早期預覽,官方示範的用途包含乾旱風險預測與健康結果建模,講的都是「給它在地結果資料,它自己挑相關的人口與環境訊號、訓練並驗證模型」這條路。
申請的入口是官方的意願表單與 Early Access Pool,頁面上明寫「限量早期存取」。官方頁面沒有列出任何地區限制,台灣的組織與開發者一樣走限量申請,也沒有任何優先權;何時轉正式版、代理對代理服務怎麼收費,官方都還沒給出時間表或價格。如果團隊的地圖工作流已經卡在多來源資料對齊這一步,先丟一兩個真實題目進申請說明裡,會比等正式版更有機會早拿到。
未定的部分要分開列。分數的口徑:GeoExpertQueries 是流程比對不是答案正確率,UnivEARTH 已經飽和,引用任何一個都要帶量法。能力的範圍:報告自己說現有基準對遙測與天氣技能的著墨很淺,預測類工具甚至沒被測到,所以 62.7 分不是能力上限的證明。取用的現實:三軌皆申請制,正式版時程與定價未知。另外兩個自建基準的開發集已經完整公開在 Google Research 的 GitHub 專頁,做地理相關研究的團隊可以直接拿去測自己的系統,這大概是這次發布裡對研究端最實在的一塊。
回查的時間點抓三個:Ask Google Earth 深度分析何時從預覽轉正式、代理對代理服務的定價公布、以及第三方用公開開發集重測的結果出爐。在那之前,把「地理空間推理代理」理解成一套把工具與規劃接到模型上的工程,而不是一個突然變聰明的模型,會更貼近這份報告實際證明的東西。