TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

FunClip 是阿里通義 FunASR 團隊的開源影片剪輯工具,先在本機聽懂整支影片再照句子下刀。實測指定一句話剪出 2.875 秒片段、時間點逐字命中,同時撞到 README 指令列第二步崩潰、字幕時間軸漂移約 6 秒、台灣口音輸出全簡體三個坑,這篇整理能用的路與繞法。
用 AI 摘要這篇文章:
我在自己的 Mac 上把 FunClip 完整裝起來跑了一輪。餵進官方示範的雲棲大會演講片段(全長 2 分 58 秒),在辨識結果裡指定演講中間的一句話,它回報位置在 145.21 秒處,剪出一段 2.875 秒的片段。為了確認剪的時間點到底準不準,我把這個區段的聲音抽出來重新辨識,出來的逐字稿跟指定句逐字相同。引擎是真的。
同一輪實測也讓我撞到三個坑,前兩個發生在文件承諾會動的地方,第三個是官方一直沒處理的繁體缺口。README 教的指令列第二步直接崩潰;匯出的字幕檔時間軸在兩分多鐘處漂了約 6 秒;台灣口音的國語餵進去,出來的逐字稿全部是簡體字。這三個坑都有繞法,但也代表「裝起來能用」跟「照文件操作就會成功」之間有一段距離。
FunClip 是阿里巴巴通義實驗室 FunASR 團隊開源的影片剪輯工具,在 GitHub 上有 6,383 顆星,我查的版本是 2026 年 10 月 8 日剛更新的 main 分支。它跟一般剪輯軟體的思路相反:你先讓它把整支影片「聽」完,然後從逐字稿裡挑一句話、一位說話人,或交給 AI 挑段落,它再照時間點把片段剪出來。這篇是完整的本機實測記錄,能用的路、會踩的坑、該怎麼繞,一次講清楚。
FunClip 的核心是一條在本機跑的語音辨識鏈。預設的中文引擎是 SeACo-Paraformer-Large,這個模型在 ModelScope 上被下載超過 3,566 萬次,是中文語音辨識裡被廣泛使用的開源模型,README 對它的下載量還停留在 1,300 萬次的舊數字。辨識的同時會標好每個詞的時間戳、加上標點斷句,另外掛了 CAM++ 模型區分不同說話人,SeACo 版本還支援熱詞,介面上就有熱詞欄,人名或專有名詞用空格分隔餵進去可以提高命中率。
剪輯的邏輯就建立在這份帶時間戳的逐字稿上。你貼一句想剪的文字,它去比對逐字稿、拿出這句話的起迄時間,再用 moviepy 照時間點切出片段,多段就自動拼接,順手輸出整支影片跟片段的 SRT 字幕檔。整條辨識與剪輯流程都在你自己的機器上完成,這是它跟雲端剪輯服務最根本的差別。
操作介面是 Gradio 網頁,選單中英並列,上傳影片、按識別、貼句子、按裁剪,四步走完。它也能用指令列兩段式操作,辨識一次存成狀態檔,之後反覆剪不同句子都不用重跑辨識,這個設計對長影片很省時間。
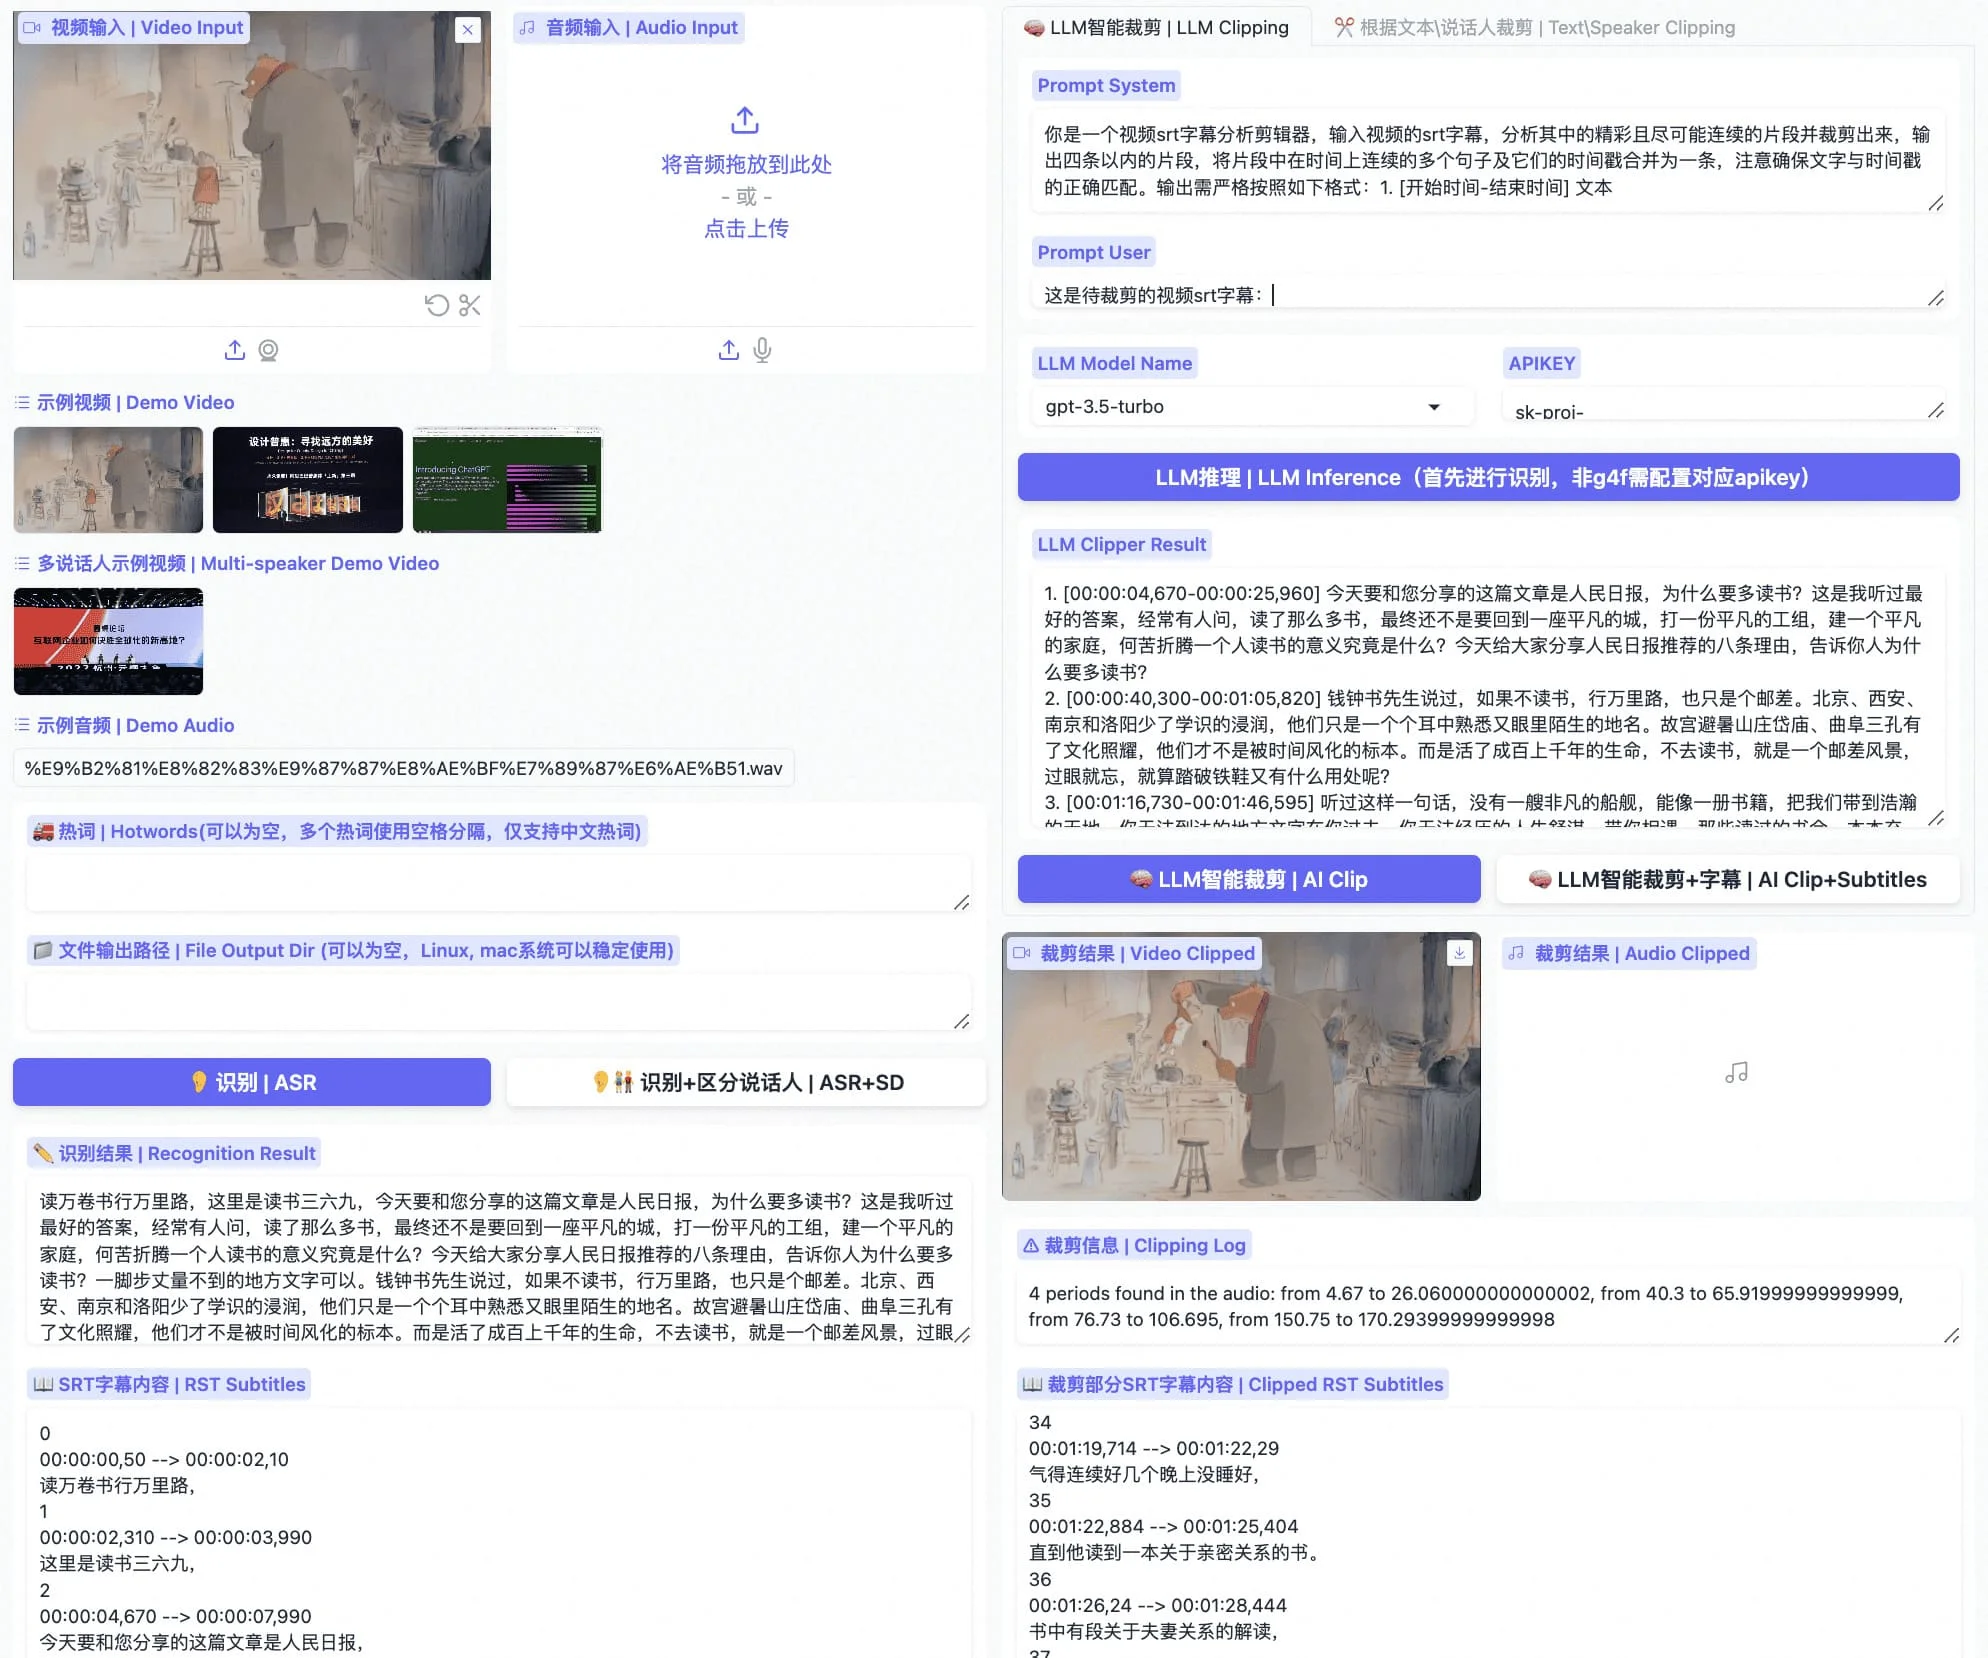
辨識引擎其實是一個選單。預設的 SeACo-Paraformer 顧中文,英文換 -l en 會改載 Paraformer 英文版;2026 年的幾次改版又接進兩條新路。一是 SenseVoice,多語系之外連情緒跟事件音(笑聲、掌聲)都能標,適合要對逐字稿做內容標記的人。二是 8 月底 v2.2.0 加上的 MOSS-Transcribe-Diarize,這是第三方 OpenMOSS 團隊的模型,走本機 vLLM 服務,一次吃長音檔、直接吐出匿名說話人標籤跟段落時間戳。要注意它標的 spkS01、spkS02 只是「這段錄音裡的第幾個聲音」,認不得你是誰,跨檔案也不保證標籤延續,官方文件把這條邊界寫得比多數商業服務誠實。我實測的是預設 Paraformer 路線,另外兩條只讀了文件與程式碼,沒有實際跑。
實測環境是 macOS(Apple 晶片)加 Python 3.11 的乾淨虛擬環境,README 官方建議 3.12,我用 3.11 全程沒有遇到不相容。安裝就是標準三步:
git clone https://github.com/modelscope/FunClip.git
cd FunClip
python -m venv .venv && . .venv/bin/activate
python -m pip install -r requirements.txt
第一次跑辨識時,模型會從 ModelScope 下載到本機快取,我實量快取目錄約 1.2GB,其中 SeACo-Paraformer 主模型 990MB,說話人模型 CAM++ 另有 292MB。我的實測速度大約每秒 40MB,整段下載加載入約一分半,模型進快取後重跑不用再下載。這支 2 分 58 秒的示範片,辨識加匯出總計約半分鐘。
辨識跟剪輯各是一道指令:
# 第一步:辨識,產出 total.srt 與狀態檔
python funclip/videoclipper.py --stage 1 \
    --file examples/2022云栖大会_片段.mp4 \
    --output_dir ./output

# 第二步:照句子剪(這步有坑,見下一段)
python funclip/videoclipper.py --stage 2 \
    --file examples/2022云栖大会_片段.mp4 \
    --output_dir ./output \
    --dest_text '我们提出的观点啊,我们努力的方向' \
    --start_ost 0 --end_ost 100
兩個小提醒。啟動服務或跑指令都建議待在 clone 下來的資料夾裡,它連介面主題設定檔都吃相對路徑,換了目錄啟動會噴 theme.json 找不到。另外第二步的輸出檔名會自動加索引,你要 res.mp4,它存成 res_no0.mp4,批次腳本取檔名時要留意。
剪輯品質有兩個微調參數值得認識。--start_ost 跟 --end_ost 以毫秒為單位平移剪輯點,上面的範例指令帶了結尾 100 毫秒的餘裕,怕切到字可以把邊界再往外推。多段剪輯把句子用 # 串起來,或在文字後面掛 [-100,100] 這種格式為每段單獨設定偏移,官方教學圖與原始碼都支援這個寫法,說話人剪輯同理用 # 串多位。辨識結果落在輸出資料夾裡四個檔案:全文文字、詞級時間戳、斷句結構,加上整支片的 total.srt,第二階段讀的就是這些狀態檔,所以只要辨識一次,第二次剪不同句子不用重跑辨識,只剩剪輯本身的時間。
上面第二步的指令,照 README 原文打下去,目前版本的結局是一行錯誤:AttributeError: 'VideoClipper' object has no attribute 'lang'。
這段指的是 2026 年 10 月 12 日的 main 分支,v2.2.1 之後含 10 月 8 日的最新提交。官方哪天補了修,這一段請以最新版為準,但至少在我實測的當下,文件與程式是脫鉤的。
根因我讀原始碼確認過。Gradio 介面的啟動檔 launch.py 第 55 行會把語言參數寫進物件,但指令列的第二階段分支只建立了物件、少了這一行設定,往下走到第 344 行讀取語言屬性時就炸了。也就是說,壞掉的只有文件上教的那條指令列兩段式路徑,介面跟直接呼叫 API 都正常。
繞法有兩條。最省事的是改用 Gradio 介面剪輯,完全避開這個分支。想留在指令列的話,把 stage 2 那行程式碼補一行 audio_clipper.lang = 'zh' 就好,我補了之後第二步跑通,剪出 2.875 秒的片段,內容正是指定的句子。
說話人剪輯在指令列上是另一條死路。參數 --sd_switch 的合法值只有小寫的 yes,但程式碼裡比對的是大寫 Yes,傳大寫直接被指令解析器擋下,傳小寫又進不了分離流程。這個問題從 2024 年 5 月的 issue #54 就有人回報,修復的 PR #221 從 2026 年 9 月開到現在沒合併。維護團隊 8 月底合併的優先項目是 issue 生命週期政策的調整,這些功能修正的 PR 仍然排隊等著。介面這邊倒是沒事,它把「識別+區分說話人」做成獨立按鈕,內部直接給正確值。我用介面同款參數直接呼叫 API 實測,一段 17.5 秒、兩個聲音交錯的測試音檔,正確標出第一人、第二人、回到第一人的說話人標籤,分離本身是能用的。
實測過程最有意思的發現,是「剪輯」跟「字幕」兩套時間戳各走各的。
我指定那句話剪輯時,它回報位置 145.21 到 148.075 秒。但同一份辨識結果匯出的 total.srt 裡,這句話被標在 139.0 到 144.845 秒,中間差了約 6 秒。兩個時間到底誰對?我把兩個區段的聲音各抽出來重新辨識當仲裁,用 ffmpeg 抽一遍、再用工具本身抽音的路徑抽一遍,結論一致:145.21 秒那個區段逐字命中指定句,139.0 秒那個區段是前兩句的內容。剪輯用的時間戳是準的,字幕檔的時間戳漂了。
而且漂移是漸進的。片頭幾乎零誤差,55 秒附近量到接近 1 秒的偏差,到 145 秒處拉大到約 6 秒。後果很實際:直接拿 total.srt 當字幕、或用「裁剪+字幕」把字幕燒進片段,越到影片後面越歪,我剪出的那段配到的字幕文字甚至是另一句的內容。相關的修復 PR #219(詞級時間戳對齊)2026 年 9 月就開著,issue #216、#217 也都在講字幕時間的問題,尚未解決。值得一提的是,我測的就是 README 教學裡那份雲棲大會示範片,也就是說拿官方自己的例子就能重現這個漂移,不需要特殊影片。所以我的建議是:剪出來的片段可以信任,字幕檔拿去用之前,自己抽核幾條對畫面。
我用 macOS 的美佳語音(zh-TW)合成了一段台灣口音的國語測試:「大家好,今天要跟大家分享三個重點。第一個重點是開源工具的授權條款……」。辨識結果的內容完全正確,連「授權條款」「語音辨識」這種詞都沒有錯字,但輸出全是簡體,「繁體中文的語音辨識」這幾個字出來是 繁体中文的语音辨识。標點模型還在詞中間插了逗點,「時間軸」被寫成 时间,轴 校正。
這是模型層的選擇,我實測的預設 SeACo-Paraformer 輸出簡體,FunClip 沒有做任何轉換,介面上也沒有繁體選項可開。我用 fontTools 檢查了它隨附的字型檔 STHeitiMedium.ttc,裡面同時包了 Heiti TC 跟 Heiti SC 兩套字集,抽測的繁體常用字都在字集裡,沒有缺字,所以把繁體字幕燒進影片這一步沒有問題。瓶頸單純在模型吐出來的是簡體。
對台灣用戶的實際影響:逐字稿跟 SRT 字幕要嘛自己用 OpenCC 轉繁,要嘛交給批次處理工具,例如我們介紹過的 ANTO 可以把整份 SRT 字幕批次翻譯處理。如果只是拿來「找段落、剪片段」,文字讀懂就好,這個限制無所謂;要產出對外使用的字幕,後處理是必要工序。
我也順手確認了「裁剪+字幕」這條路的成品。它用 Pillow 把字幕直接渲染進影片,字幕顏色、字級都能在介面上調,v2.2.1 的改版重點就是讓選定的字幕顏色在重新編碼後不會被吃掉。但前面講的時間戳漂移會在這裡現形:字幕文字跟聲音內容對不上、時間越後面越歪,所以長片燒字幕前,先抽核 SRT 再動手。
FunClip 另有一條掛著 AI 招牌的路:把整份 SRT 逐字稿連同提示詞交給大型語言模型,讓模型回報「精彩片段」的起迄時間,再交回剪輯。這一步的判斷發生在雲端。
介面上的模型下拉選單有 22 個選項,預設是 deepseek-chat,涵蓋 OpenAI、通義千問、DeepSeek,以及一串第三方閘道服務。跟模型互動的提示詞就寫在介面上,可以改,預設版本是簡體中文,預設版本是簡體中文,角色是影片 SRT 字幕分析剪輯器,要求模型合併連續句子、最多回報四條片段,輸出格式固定是 1. [开始时间-结束时间] 文本,剪輯端再照這個格式解析時間戳接手。操作按鈕上也直接標明,g4f 之外的選項都要搭配對應的 API 鑰匙才能推理。這條鏈路有幾個細節值得知道:不管選哪一家,你的整份逐字稿都會送到那個端點,本地辨識不等於本地判斷;選 g4f- 開頭的模型走的是逆向免費端點,不用鑰匙,但穩定性跟服務條款要自己評估,我沒有實測這條路;選 pegasus1.5 則是把影片本體整個送給 TwelveLabs 的影像理解模型;還有一個容易踩的誤會,模型名開頭是 gpt-3.5-turbo 的選項,實際被導到 Moonshot 的 API 端點,這是原始碼裡寫死的路由。
選單本身也值得看一眼。2026 年 7 月到 10 月的三個月裡,這個下拉選單長出了五家商業閘道:Atlas Cloud(7 月 22 日)、MiniMax(7 月 29 日與 8 月 18 日兩波)、OrcaRouter(8 月 21 日)、Cheaper Inference(10 月 8 日),討論區還有兩家排隊等著合併。OrcaRouter 加入後,維護者接連用兩個 commit 把 README 裡的安全宣稱改保守,明講防護功能預設不開。開源專案的模型選單熱鬧成這樣是好事也是訊號,我的看法很簡單:這些選項都用 OpenAI 相容格式,自帶一組自己信任的鑰匙、或用 litellm 前綴接自選供應商,會比追著選單裡的新名字穩。
這段 LLM 路徑我沒有實測挑段落的品質,手邊沒有可用的鑰匙,這篇文章對「AI 挑得好不好」不下結論。
我們之前實測過的 lossless-cut 走串流複製路線,不重新編碼、速度快、畫質零損耗,代價是剪輯點被關鍵影格綁住,而且你必須先知道要剪哪裡。FunClip 剛好補上另一端:先花時間聽完整支片,你憑「一句話」或「某位說話人」就能定位,代價是要重新編碼、要先跑辨識、字幕還要後處理。一個管「我知道位置的精準快切」,一個管「我不知道位置、讓機器聽」。實際場景分工很清楚:把兩小時的演講抓出三分鐘精華、從訪談裡抽出某位來賓講過的每一段、把線上課程裡講到某個概念的段落收集成複習素材,這些是 FunClip 的主場;婚禮影片去頭掐尾、螢幕錄影切掉開頭等待,交給 lossless-cut 三秒解決。兩個都是免費開源,在硬碟裡共存毫無衝突。如果你要的是「自動跳過影片裡的業配段」那種固定規則,Bilibili SponsorBlock 的思路更貼近,我們也寫過介紹。
授權是乾淨的兩層:程式碼 MIT,可以商用修改;預設模型權重是 Apache-2.0,README 提醒要再散布模型前先看各模型頁的條款。它也不是孤兒專案:背後是 FunASR 工具箱一家人,同家族還有旗艦級的 Fun-ASR-Nano(以 LLM 為基礎的端到端辨識,官方主打中英日三語、七大方言群與 26 種地方口音,另有獨立的 31 語言版本)、多語的 SenseVoice 一路到語音生成的 CosyVoice,模型都放在 FunAudioLLM 名下,這個生態系的存在讓「模型會不會突然沒人養」的風險小了一截。專案 2023 年 5 月開倉,累積 289 個提交,2026 年 7 月到 9 月接連出了 v2.1.0 到 v2.2.1 四個版本,我查的最後一次更新是 10 月 8 日,活躍度沒有問題。不過 14 個開著的 issue 裡,躺著 2024 年 5 月的老 bug,文件跟程式的縫隙短期內不會自己補上。
辨識、剪輯、字幕渲染全在本機,這層乾淨。周邊有三件小事:Gradio 框架的使用統計預設開啟,會連 api.gradio.app,不想送就設環境變數 GRADIO_ANALYTICS_ENABLED=False;funasr 啟動時會查一次 PyPI 上的版本更新;第一次跑的模型下載連 ModelScope。另外它把辨識結果存成狀態檔、第二階段用 eval 讀回,來路不明的輸出資料夾不要拿來跑第二階段。
不想安裝的話有兩個官方線上示範,命運不同。ModelScope 上的示範工作室累積 34.9 萬次瀏覽,我截圖的當天顯示 Stopped,進不去;Hugging Face 上的 Space 則正常運作中,跑在免費的 CPU 等級,速度本身有限,試手感可以,認真用還是裝在本機。
總結我的判斷。FunClip 適合的人:手上有一堆演講、訪談、上課錄影,需要憑內容找段落、憑說話人抽講話片段,願意開終端機、能接受繞過兩處文件沒修的坑,而且記得逐字稿要後處理轉繁。不適合的人:要無損快剪的用 lossless-cut 就好;要雲端一鍵、不想碰 Python 環境的,這套的自架成本會讓你不耐煩。輸出的逐字稿也自帶用途:演講整理、會議紀錄、字幕製作,這條副產品線對內容工作者可能比剪輯本身更有價值,只是記得它給的是簡體。引擎本身,3,566 萬次下載的辨識模型加活躍維護的剪輯層,實測結果對得起它的星星數。