TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

Youtube-Whisper 是 364 星的開源 YouTube 逐字稿工具。實測官方網址被 Cloudflare 擋下、示範站四輪轉錄全失敗,錯誤訊息還被一行程式 bug 吞掉;同一條管線自己架,19 秒影片 0.3 秒轉完,速度比官方宣稱更快,介面沒有中文選項也要一併知道。
用 AI 摘要這篇文章:
先說結論:Youtube-Whisper 是一個值得認識的開源工具,但它的官方網站現在幫不了你。這個 2024 年出現的專案在 GitHub 上有 364 顆星、MIT 授權,核心程式碼只有兩個 Python 檔、合計不到 150 行,做的事情很單純:你貼上一條 YouTube 連結,它用 yt-dlp 抓下音軌,交給 OpenAI 的 Whisper 語音辨識模型,吐出整段逐字稿。我把它從官方網址到本機重現它的下載加轉錄管線,完整測過一輪,結果是兩個世界:官方入口兩道牆都過不去,示範站四輪轉錄全部失敗;同一條管線(同樣的 yt-dlp 加 openai-whisper 套件)在自己的電腦上跑,19 秒的影片 0.3 秒轉完,3 分半的影片也只要 3.4 秒。所以判斷可以下得很直接:把它當自架工具用,別把它當免費網站用。
開發者是住在阿姆斯特丹的 Danilo Toapanta,專案 2024 年 9 月 12 日開張,前三週擠出五十多個 commit 之後就進入低溫,2026 年 3 月只做了一次 Dockerfile 大掃除。這種生命曲線本身就影響使用決策,後面會展開。
打開它的示範站,整個介面就四個操作:貼 YouTube 連結的文字欄、選模型大小的下拉選單(tiny、base、small、medium、large 五檔)、選語言的下拉選單,加上一顆 Transcribe 按鈕。按下去之後畫面會秀出影片標題、縮圖,以及純文字的轉錄結果,沒有時間軸、沒有說話者標記,就是一段文字。
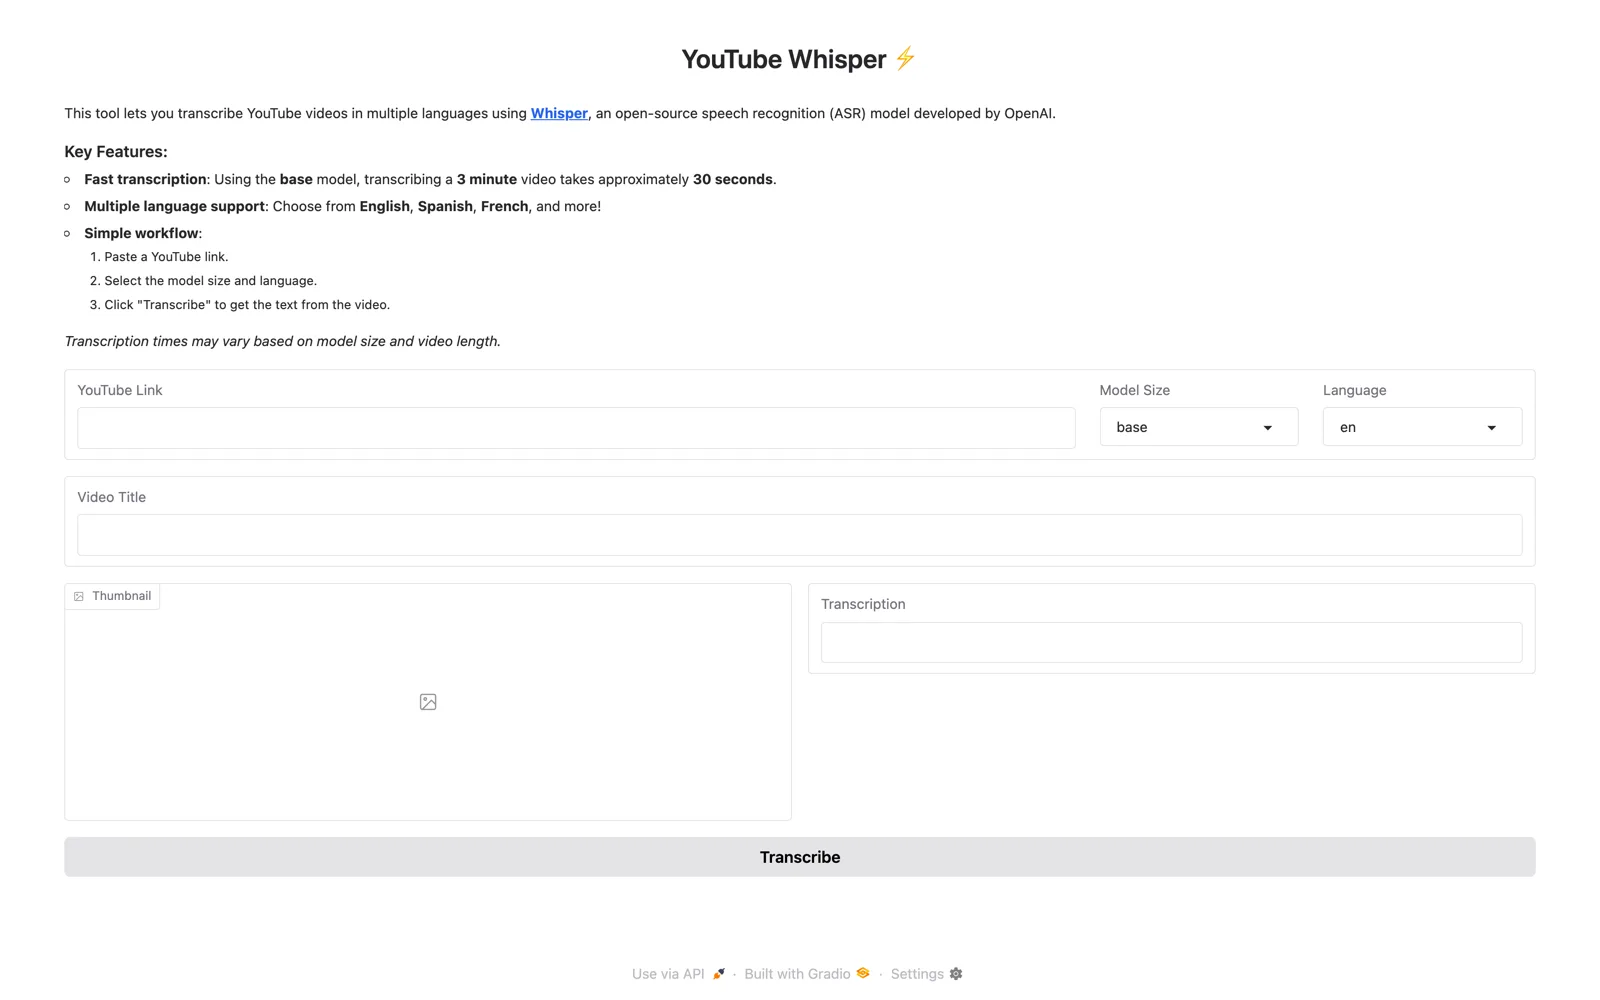
輸出的形態值得多講兩句,因為它決定這工具的用途邊界。Whisper 模型轉錄時其實算得出每段文字的起訖時間,輸出 SRT 之類的字幕檔對模型來說不是問題;但這個工具的程式碼只取了結果裡的純文字欄位,其他全部丟掉。所以它派上用場的場景是「整段讀稿」:你要把演講內容整理成文章、把訪談聽打成紀錄,它是對的工具;你要的是帶時間碼的字幕檔,直接出門右轉找字幕工具,這裡沒有。
抓音檔這步的實作也值得看一眼:程式用 yt-dlp 取 bestaudio 音軌,交給 ffmpeg 轉成 192kbps 的 MP3 之後才餵給模型,也就是說 Whisper 聽到的並非無損音訊,而是壓縮過一遍的聲音。對講話內容的辨識影響不大,但這解釋了為什麼音質本來就差的片源,轉出來的錯字會更多。它在 Hugging Face 的免費 Space 上執行,原始碼同步放在 GitHub,這點先把位階講清楚:示範站是免費額度的共用容器,配置是最基本的 CPU,睡著沒人用的時候會休眠,第一個訪客要等它醒來、容器重啟;原始碼才是這個專案的本體。模型選單從 tiny 到 large,越大越準也越慢,示範站首頁文案對速度的宣稱是「用 base 模型轉 3 分鐘影片大約 30 秒」,這句是作者自己的數字,沒註明在什麼硬體上量的,先記著,後面用實測對照。
GitHub 專案登記的官方網址是 yt-whisper.danilotpnta.com。2026 年 10 月實測,這個網址用指令直接請求、換成瀏覽器環境開頁面、再換一種帶完整指紋的隱身瀏覽器,三種方式拿到的都是同一個東西:Cloudflare 的「Sorry, you have been blocked」封鎖頁,連挑戰題都不給,直接擋。也就是說,你從 GitHub 點官方連結,大門口就吃閉門羹。
還好從專案的部署方式看,這個網址背後就是 Hugging Face 上那個 Space 容器,把網址換成 danilotpnta-youtube-whisper.hf.space 就能直搗本體。這也是這個專案現在最實用的一個冷知識:官方連結壞了,不代表服務本體壞了,繞過域名這層皮就找得到門。
直連 Space 之後,介面正常載入,底層的 Gradio 框架版本是 6.9.0,看起來一切健康。這個站不是什麼新生服務:網際網路檔案館從 2024 年 10 月起就持續收錄官方網域 yt-whisper.danilotpnta.com 的版本,一路到 2025 年 8 月都看得到正常頁面,所以它曾經好好活過,現在的失敗是後來才發生的事。接著我餵了兩部影片:19 秒的史上第一部 YouTube 影片 Me at the zoo,以及 3 分半的經典 MV,刻意選了存在多年、最不可能被下架的標的,各測兩輪,模型選最輕的 tiny,語言選英文,等於是最寬鬆的測試條件。
四輪的結尾全部一樣:等了大約 80 秒,畫面上跳出三個 Error 標記,影片標題欄、縮圖、逐字稿全數空白,沒有任何錯誤說明文字。等待期間畫面完全沒有進度提示,你無從判斷它正在下載、正在排隊,還是已經死了,只能等錯誤自己跳出來。影片被下架、模型不支援這兩種常見嫌疑都能排除:同兩部影片在自己的電腦上用同樣的管線全部轉成功。問題最可能出在伺服器端抓音檔那一步,等了約 80 秒才報錯的模式吻合下載逾時;沒有伺服器紀錄,轉錄階段出錯不能完全排除,原因有兩個候選:這個容器的映像檔 2026 年 3 月之後沒重建過,裡面的 yt-dlp 停在當時的版本,而 YouTube 和下載器之間的貓捉老鼠每個月都在打;另外 Hugging Face 的伺服器住在資料中心,YouTube 對這類 IP 向來不客氣。沒有伺服器紀錄,這兩個原因分不開,但對使用者的意義很單純:示範站現在拿不到逐字稿,而且失敗得毫無解釋。
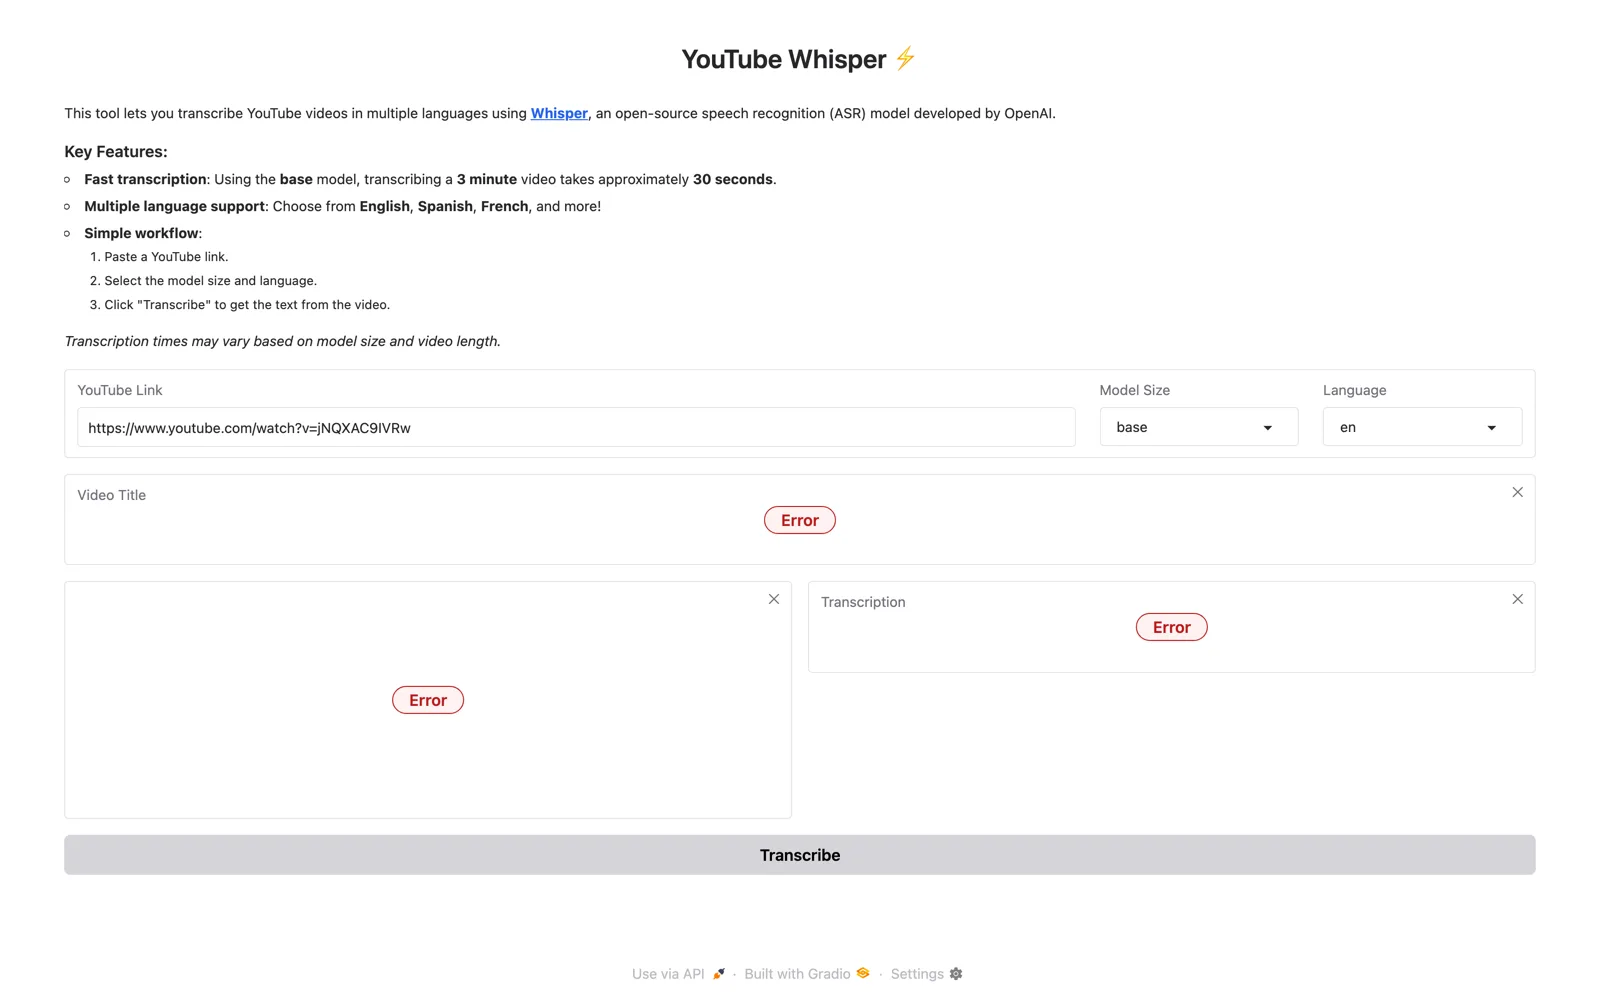
失敗可以失敗得有禮貌,這個站沒有,原因是程式碼裡一個真實的 bug。app.py 的設計裡,下載失敗時應該在畫面上顯示「Error fetching video.」這句話,告訴你問題出在抓影片;但寫法上,負責下載的函式在出錯分支一次交出四個值,而接收端的程式只準備了三個變數來接,Python 當場就炸在拆箱這一步,那句友善的錯誤訊息永遠沒有機會出現。於是你看到的就只是框架層丟出來的無字 Error。
這個 bug 對一般使用者的用處,是當作一個判讀訊號:看到無字 Error,代表連影片標題都抓不到,問題在伺服器端,你換連結、換瀏覽器都不會好。修正只需要改一行,但專案自 2024 年 10 月後就沒有功能更新,它也就一直留著。
這是台灣使用者最該知道的一件事:語言下拉選單寫死了六個選項,英文、西班牙文、法文、德文、義大利文、日文,沒有中文。而且這個欄位不是裝飾,你選的語言會被強制塞給模型,Whisper 被指定「用這個語言聽」,自動偵測的空間被拿掉了。
強制指定語言的後果,我用實測讓它現形:把英文語音硬標成西班牙語,整段立刻幻聽成不知所云的混合體,實際輸出長成「Aqui es la FROMCPUACEP enjoying」這種音節對不上、單字亂接的句子,模型盡力把聲音塞進一個不屬於它的語言框架裡,結果就是兩邊都不像。換句話說,中文影片丟進這個介面,你選任何一個選項都得不到可用的逐字稿。要分開看的是,Whisper 模型本身認得中文,問題只出在介面沒給選項;自己架的人改起來不費事,那六個語言在 app.py 裡就是同一行列出的選項清單,把 zh 加進去,或乾脆拿掉語言參數讓模型自動偵測,改完介面上就有中文的位置。
自架的路徑比想像中短。前置三件事:Python 3.9 以上、ffmpeg、把 requirements.txt 裝起來(作者另附 conda 環境檔,擇一即可)。執行 python app.py,瀏覽器打開 localhost:7860,就是你在示範站看到的那個介面,跑在自己機器上。不想碰 Python 環境的人還有第二條路:儲存庫裡附了 Dockerfile,用 Docker 直接建一個容器起來,埠號 7860,ffmpeg 這些相依套件都包在映像檔裡,這也是示範站自己的部署方式。跑起來之後有兩個行為先知道:模型第一次下載後存在本機快取,第二次啟動直接從磁碟載入,不用重抓;抓下來的音檔與縮圖固定寫在執行目錄裡,檔名就是 downloaded_video.mp3 和 thumbnail.jpg,轉完不會自動清掉,批次處理一整天之後記得自己收拾,不然資料夾會一直留著最後一部影片的殘件。第一次轉錄前模型會先下載,tiny 約 72MB、base 約 139MB(這兩個數字是我實際下載時看到的),往上按 OpenAI 官方資料是 small 461MB、medium 1.5GB、large 2.9GB 級,選越大越準也越吃機器,這是唯一的等待。
還有一個從示範站學到的教訓值得寫進你的使用習慣:自架之後記得讓 yt-dlp 保持新版,一條 pip install -U yt-dlp 的事。示範站這次四輪全敗,最可疑的原因之一就是映像檔裡的下載器停在半年前;自己機器上讓它跟著 YouTube 的變化更新,工具就跟得上。
實測數字給你當參考,環境是 Apple Silicon 筆電的 CPU 模式:抓 19 秒影片的音軌,目前的 yt-dlp 不到 1 秒完成;tiny 模型轉這段 19 秒的音檔花 0.3 秒;換 base 模型轉 3 分 33 秒的 MV,3.4 秒完成。對照首頁文案宣稱的「3 分鐘約 30 秒」,在我的機器上寬鬆了將近十倍。當然你的機器等級會讓數字浮動,但量級就是這樣:輕模型在家用 CPU 上跑起來是順手等級,稱不上煎熬。
選模型的實用建議可以簡化成一句話:先求有再求準。tiny 和 base 適合快速出草稿再人工校,我的實測裡兩者在乾淨的人聲上差距不大;要交給別看的正式稿,往上選 small 或 medium 比逐字校對省力;large 我沒有實測,以它近 3GB 的體積推斷,純 CPU 的機器跑起來會明顯吃力,有顯示卡再考慮。品質面也要誠實:tiny 模型把動物園短片裡的 trunks(象鼻)聽成 prompts,一聽就錯但語意還能猜;歌聲段的表現明顯掉一級,我拿整首英文 MV 用 base 模型測,主歌歌詞被聽成另一串近似音。所以逐字稿要留校對時間,模型越小越要校,唱歌內容直接當參考。
自架還有一個示範站給不了的好處:你貼的連結、抓下的音檔、轉出的文字,只跟 YouTube 本身連線,不經過任何第三方伺服器。反過來說,用示範站的時候這些都會交給別人的伺服器,這在共用的免費服務裡是常態,但這筆交換該算清楚。順帶一句:下載 YouTube 音檔來轉文字,著作權上的責任在使用者自己,自用研究多屬灰色地帶,要對外分享轉錄內容前先想清楚授權。
翻 commit 歷史會看到一段很有戲的前三週:作者 2024 年 9 月先是和 YouTube 的驗證碼纏鬥,紀錄裡看得到處理 captcha、強制無頭模式、引入 Selenium 和 chromium 的進進出出,最後收手改走純 yt-dlp 的樸素路線;10 月初定稿之後,專案就安靜了。2026 年 3 月那次唯一的整理,把 Dockerfile 現代化:換 Python 3.10、改非 root 使用者、加健康檢查、清掉 Selenium 殘骸。掃得不算徹底,packages.txt 裡還留著一條 chromium-driver,沒有任何程式碼用它,算沒掃乾淨的角落。
相依套件全部沒釘版本這點,是雙面刃:容器重建時永遠抓最新版,所以示範站現在跑的 Gradio 是 6.9.0,與說明檔登記的 4.44.0 已經對不上;但 yt-dlp 這類依賴要是停在舊版沒人重建,就是前面四輪全敗的樣子。Issue 看板上只有兩條:一條問環境檔去哪了,作者本人沒有留言,但當天把檔案加儲存庫並關掉了那條 issue,留言區幫忙解讀的是其他使用者;另一條請求支援 turbo 模型和即時串流轉錄,開了兩年,沒有下文。目前的星數對這樣的小品是不錯的成績,MIT 授權讓你商用、改寫、內部部署都自由,但一人專案、沒有版本發佈標籤、維護看緣分,期待它穩定服務會落空;當成一份乾淨可改的樣板搬走,壽命才是你自己的。
還有一個共站才會踩的坑,自架的人無感:輸出檔名在程式裡寫死成 downloaded_video.mp3,示範站這種多人共用一個容器的形態,檔案系統是同一份,一旦併發被打開就有互踩風險。就算哪天示範站恢復健康,這個共用結構也不會變。
TechMoon 先前介紹過幾個同任務的工具,位置各不相同。要貼連結就拿到現成逐字稿的網站服務,可以看 AI YouTube 逐字稿工具那條路;要字幕轉錄、每天有三段各 30 分鐘免費額度的,SubEasy 走的是雲端服務路線,免費版帶浮水印;處理演講、課堂錄音的 ReadLecture 顧的是長音檔;Tubly 則是瀏覽器擴充的形態,下載與轉文字綁在一起。也有更硬派的路線:先前介紹過的 fast-powerful-whisper-api 把自架 Whisper 做成通用轉錄 API,吃任何音檔,代價是部署門檻偏向 Windows 環境。Youtube-Whisper 的位置和它們錯開:完全免費、沒有額度、沒有帳號,顧的就是 YouTube 影片一條龍,條件是你願意裝 Python、自己按下滑鼠執行。如果你的需求是批次、固定、大量,自架一套跑在自己機器上的工具,長期看比挨額度舒服。
整理成可以帶走的判斷:這個專案最值得拿的是它的程式碼,不是它的網站。要馬上拿到逐字稿、不想裝任何東西的人,先走上面那些現成服務,官方網址的封鎖頁和示範站的無字 Error 會先消耗你的耐心;會裝 Python、常要批次處理、在意音檔不出門的人,把它 clone 下來,加一個中文語言選項,它就是一套跑在自己機器上、速度快到不用等待的逐字稿小工廠。開源工具的免費從來有兩種,一種是別人替你出伺服器的免費,一種是自己機器上的免費,這個專案剛好站在前一種壞掉、後一種活著的時間點上。它沒有花俏的功能表可以導覽,但該給的判斷素材都齊了:授權乾淨、程式碼小到一個下午能讀完、失敗時的症狀有明確解釋,剩下的就是你要不要騰出一個 Python 環境的決定。