TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

阿里巴巴通義千問團隊發表 Qwen3.8-LiveTranslate 即時同傳模型,字均延遲從上一代 2.8 秒降到 2.3 秒,新增說話人分離、原文譯文同幀同出與長上下文消歧,DashScope API 附 100 萬 tokens 免費額度,與 GPT-Live-1、Gemini 3.8 Live 的定位差異一次看清。
用 AI 摘要這篇文章:
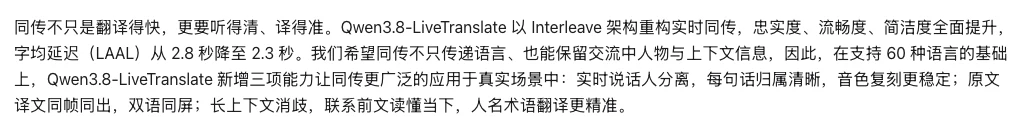
阿里巴巴通義千問團隊在台北時間 9 月 19 日下午 3 點 08 分,於官方 X 帳號宣布新一代即時同傳模型 Qwen3.8-LiveTranslate,官方部落格的發布頁面日期為 9 月 18 日。這次更新的重點可以用一句話講完:把即時同傳的字均延遲(LAAL)從上一代的 2.8 秒壓到 2.3 秒,同時補上即時說話人分離、原文譯文同幀同出、長上下文消歧三個往真實會議場景推進的能力,經由 DashScope API 的 qwen3.8-livetranslate-flash-realtime 模型對外提供。
先講定位,給正在選型的人:同一個九月,OpenAI 在 9 月 10 日把 GPT-Live-1 語音 API 推上正式版、Google 在 9 月 15 日發表 Gemini 3.8 Live,Qwen3.8-LiveTranslate 是九天內的第三發,但它鎖定的是更窄也更難的任務:講者不間斷發言時,系統邊聽邊譯。要判斷值不值得接,看三件事就夠:延遲數字怎麼量、三個新能力對應什麼場景、以及官方攤開的計費方式。
官方 X 公告的原文寫著「reducing average lagging (LAAL) from 2.8s to 2.3s across 60 languages」,官方部落格同樣載明:字均延遲(LAAL)從上一代的 2.8 秒降至 2.3 秒。以兩代官方數字換算,幅度約 18%。LAAL 量的是講者說出某個語意重點、與系統譯出對應內容之間平均落後幾秒;同傳延遲的本質是取捨,太早開口,語意還沒收齊,容易翻錯,太晚開口,聽者落後講者越來越遠,LAAL 就是把這個取捨量化成的單一數字。
有個邊界要先畫清楚:LAAL 不等於使用者從聽到原文到聽到譯文的全程體感。麥克風採集、網路傳輸、緩衝播放都不在這個數字裡,端到端的實際延遲一定比 2.3 秒高。延遲下降的官方解釋指向架構重構:已聽過的音訊與已譯出的文字都能快取複用,品質提升與延遲下降因此可以同時成立。
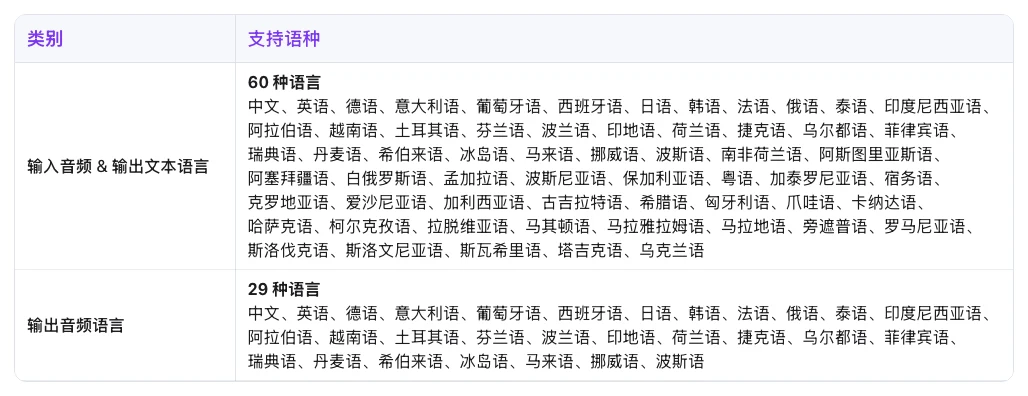
語言覆蓋沒有變動:音訊輸入搭配文字譯文支援 60 種語言,譯文語音輸出 29 種,與上一代 Qwen3.5-LiveTranslate-Flash 相同。換句話說,這一代的重點不在會更多語言。輸入清單包含中文、英語、日語、韓語、粵語、阿拉伯語等 60 種,輸出語音名單則短得多,完整兩份名單以官方語種表為準。
官方列出的三項新能力,各自對應一種過去即時翻譯做不好的場景,方向一致:把即時翻譯從一句一句的語音轉換,推向有記憶、有歸屬、可留痕的會議基礎設施。
第一是即時說話人分離(speaker diarization):多人交替發言時,系統區分不同說話人與各自的發言內容,譯文語音據此保留每個發言者的音色。過去多人場合的即時翻譯通常整場只有一個合成聲音,聽的人分不清這句話是誰講的;這個能力直接決定跨語言會議、法庭聽審、多方談判能不能交給機器。音色複製本身在上一代就有,這一代的差別是換人說話時聲音跟著換,而且官方強調複製更穩定。對音色複製這條技術有興趣的讀者,可以對照我們先前實測過的 MixVoice 語音克隆,兩者原理同源、用途不同。
第二是原文譯文同幀同出:原文與譯文同步呈現,雙語並列在同一個畫面。這個功能是給眼睛用的:字幕顯示、事後整理、檢索核對都需要原文對得上譯文。官方把它做成 WebSocket 協定的原生輸出,客戶端不必再外接一個語音辨識服務;需要原文辨識結果的話,會話設定裡可以開啟 qwen3-asr-flash-realtime,翻譯與原文同步拿。想在電腦上做類似雙語字幕應用的讀者,我們介紹過的 AirTranslate 是本機工具端的同類場景,可對照參考。
第三是長上下文消歧:結合前文與歷史語境,緩解專有名詞與指代關係造成的歧義,讓人名、術語跨輪一致。翻譯會議最常見的失誤不是聽錯單字,是同一個人名前後三種譯法、同一個專案代號每十分鐘換一個拼法。官方的解法是把對話歷史保留下來參與當下的推理,官方示範影片也用《西遊記》對話與同音詞例子展示說話人歸屬、雙語同步與視覺線索怎麼協同消歧。
架構面,官方部落格給了兩個關鍵詞。第一個是 Interleave(交錯):連續輸入的音訊編碼、即時產生的譯文文字、待合成的譯文語音,全部交錯編排進同一條因果序列,由模型自己決定什麼時候繼續聽、什麼時候開口譯。過去語音辨識、翻譯、語音合成三段串接的管線,每段都有自己的緩衝區,延遲層層疊加;收進單一序列後,已聽的音訊與已出的譯文共用同一份快取,不必在模組之間來回轉換。
第二個是 Thinker-Talker 雙模組,建立在 Hybrid MoE(混合專家架構)之上:Thinker 負責理解與翻譯,把影片、音訊、原文與譯文編排進同一條序列;Talker 負責語音生成,結合譯文與源音訊,合成保留原說話人音色的譯文語音。Thinker 的輸入清單裡還有一項:影片。影像也是翻譯的上下文之一,API 因此提供傳送影像畫面的方法,官方示範裡也演示了畫面資訊怎麼幫助聽不清楚的片段消歧。
對多數讀者,這段記一個判斷就夠:把更大的模型直接搬進即時迴圈會讓延遲失控,阿里改用架構分工讓理解與發音並行。官方未公布參數量與模型尺寸,這一代也沒有開放權重,只能經由 API 使用,想自架或微調的人這一代沒有選項。
模型經由 DashScope 的 WebSocket 介面提供,會話怎麼建立、事件怎麼收發,官方部落格附了一份完整的 Python 客戶端,幾個關鍵點直接決定能不能跑起來。連線端點帶有百煉業務空間 ID,北京區的格式是 wss://{workspace_id}.cn-beijing.maas.aliyuncs.com/api-ws/v1/realtime?model=qwen3.8-livetranslate-flash-realtime,也就是說環境變數要備齊 API Key 與業務空間 ID 兩樣。音訊規格固定:麥克風輸入 16kHz、播放輸出 24kHz,都是 PCM 單聲道。
協定是事件式的:session.update 設定目標語言與輸出模式(語音加文字,或僅文字)、input_audio_buffer.append 把麥克風音訊逐塊上傳、譯文以 response.audio_transcript.delta(文字)與 response.audio.delta(語音)流式返回,收工時送出 session.finish 並等服務端回 session.finished,避免最後一段譯文丟失。
兩個實用選項:熱詞表 corpus 可以把品牌名、行業術語的固定譯法注入會話,官方文件直接以人工智慧、機器學習當範例;要同步拿原文辨識結果,在會話設定開 input_audio_transcription 並指定 qwen3-asr-flash-realtime。視覺上下文另有 input_image_buffer.append 可傳影像畫面。
一個提醒:發布當天網路上已經出現掛著官方名號的接入範例,端點寫成 dashscope.aliyuncs.com/api-ws/v1/inference,參數裡有 voice_clone、enable_diarization 這類開關。對照官方客戶端,這些全部對不上:端點格式、事件名稱、參數結構都是另一套寫法。抄程式碼之前先以官方部落格附的版本為準,可以省下好幾個小時的除錯時間。
計費按輸入與輸出 tokens 分開算,官方帳單頁的數字(每百萬 tokens)如下:國際(新加坡)區音訊輸入 7.5 美元、影像輸入 0.55 美元、譯文文字輸出 20 美元、譯文語音輸出 30 美元;同一張價目表的北京區掛 5.653、0.466、14.133、22.613 美元。新模型附 100 萬 tokens 免費額度,自開通、模型發布或申請通過日起算 90 天有效,且僅限新加坡區。
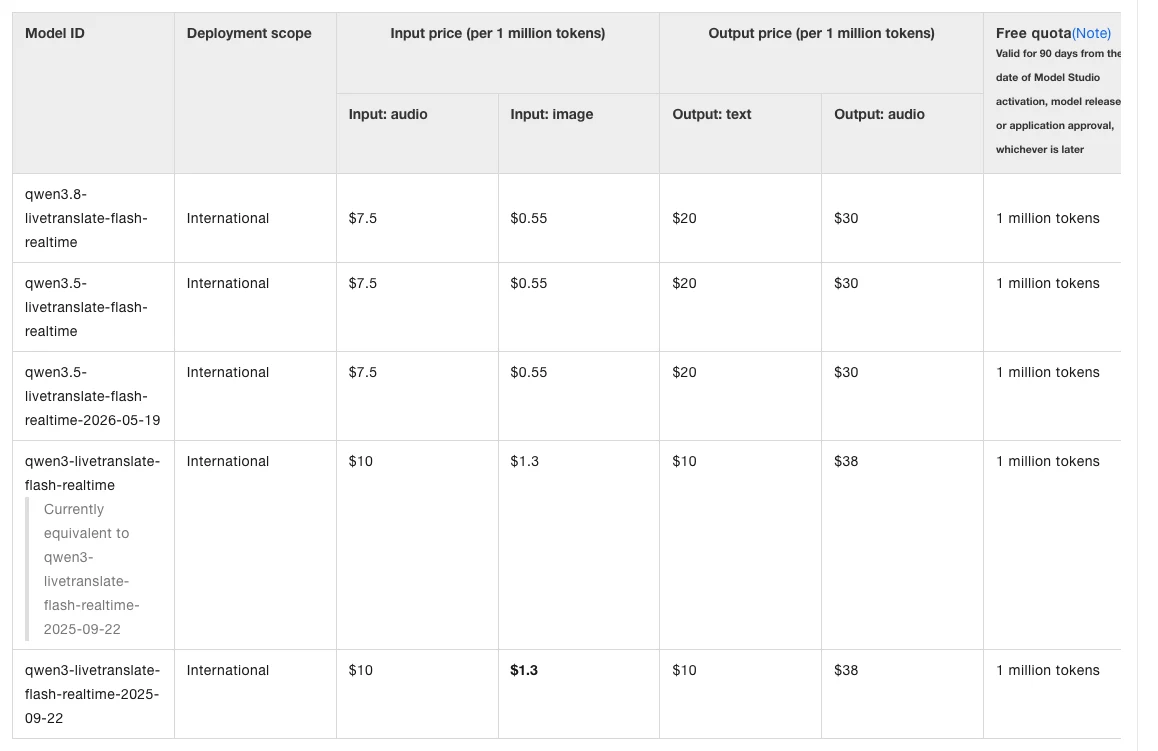
放回世代對照更有意思:新加坡區的上一代 qwen3.5-livetranslate-flash-realtime 與這次完全同價,延遲改進沒有加價;北京區的 3.8 比上一代略高(音訊輸入 5.653 對 5.501 美元,差約 3%)。再往前一代,2025 年 9 月上線的 qwen3-livetranslate-flash-realtime 在新加坡區音訊輸入要 10 美元、譯文語音輸出要 38 美元,一年內這條產品線的單位成本降了約四分之一。若需求不在即時,官方同頁還列了檔案模式的 qwen3-livetranslate-flash,走 Chat Completions 介面,新加坡區音訊輸入 1.577 美元,定位是延遲高一些、品質更好的影片配音與播客翻譯。
台灣讀者走國際站的 Model Studio(新加坡區)就能開通,免費額度也在這一區;北京區價目雖然同頁並列,連線時要走百煉業務空間的端點,兩邊帳務是分開的。
九天三發容易讓人以為三家在打同一場仗,任務其實不同。GPT-Live-1 與 Gemini 3.8 Live 是通用語音代理的前端:你說一段、它回一段,比的是對話手感、工具呼叫與推理,兩者的計費也圍繞對話設計(GPT-Live-1 每分鐘 0.05 美元只買語音層、推理後端另計;Gemini 3.8 Live 按單一價目表全包)。Qwen3.8-LiveTranslate 是專用同傳:講者不間斷、系統邊聽邊譯,延遲指標是 LAAL,評測軸是忠實度、流暢度、簡潔度與說話人分離錯誤率,計費分成兩種輸入與兩種輸出,共四個價目。把兩邊放進同一張對照表,數字看似可比,實際量的是不同的東西。
官方對成績的表述也要留意讀法:在官方自建的多說話人長音訊評測集 Omnilingua-MSpeaker(14 個語向)與公開的 FLEURS(70 個語向)上,官方宣稱翻譯品質、延遲、辨識與合成四個維度領先主流即時同傳系統,但公告與文件都沒有給出分數,也沒有列出比較對象名單。領先是官方自報,要驗收,得拿自己場景的語料實測,免費額度正是拿來做這件事的。
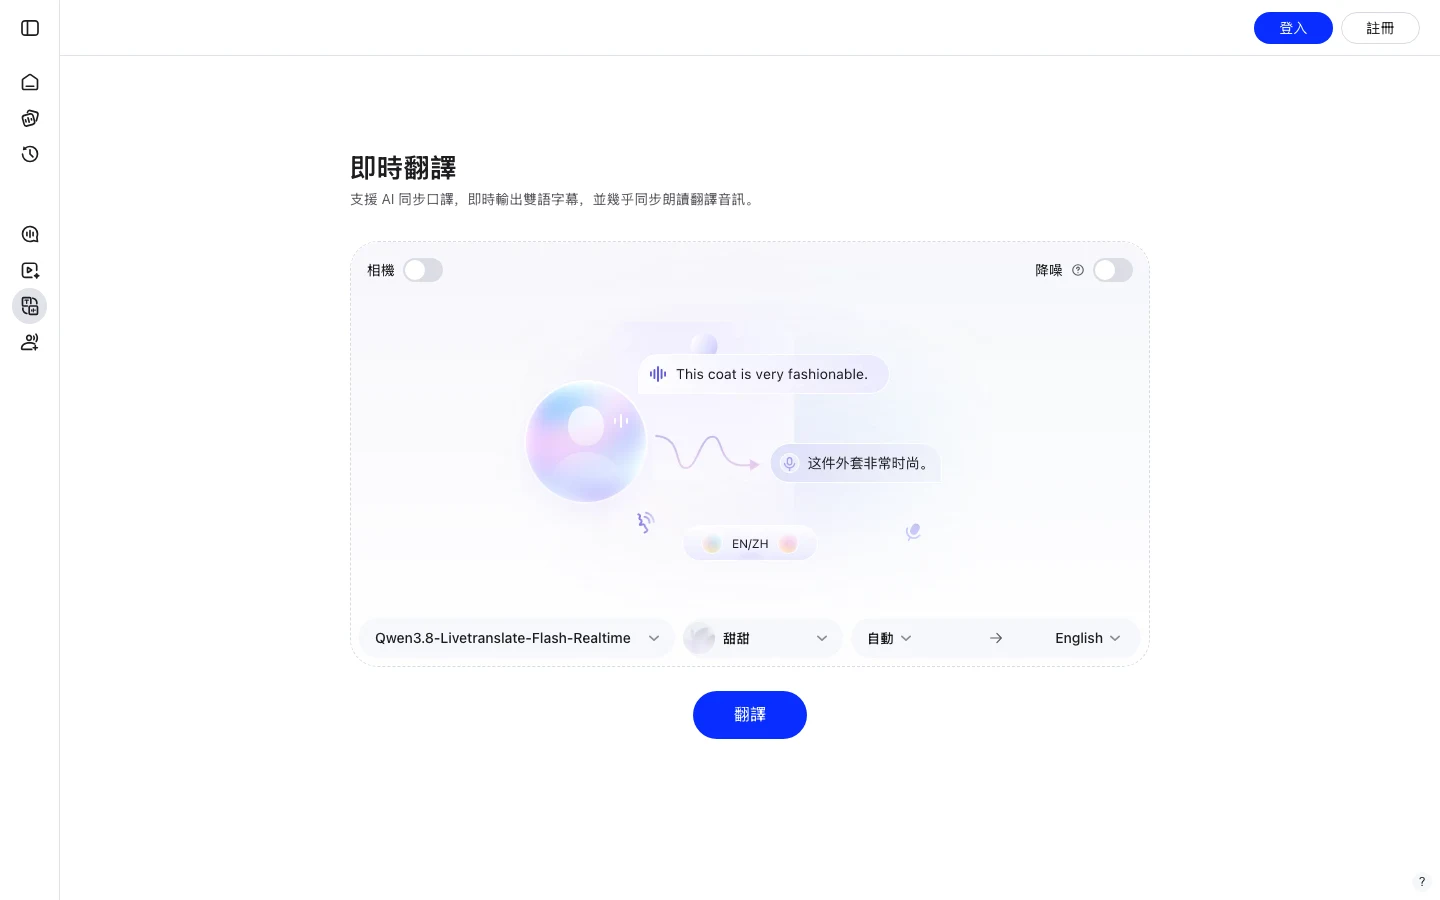
想先感受成品:官方的 Omni 即時翻譯示範頁(omni.qwen.ai/live-translate)已經上線,頁面載明即時輸出雙語字幕、近乎同步朗讀譯文語音,介面帶相機與降噪開關,模型選單就是這次的 Qwen3.8-Livetranslate-Flash-Realtime,打開就能對著麥克風試,不必先寫任何程式。
也有不必心動的人:已經用 GPT-Live-1 或 Gemini 3.8 Live 做對話代理的,任務不同不用換;只有純文字翻譯需求的,更便宜的文字模型很多,不必為了同傳付語音輸出的錢;要求離線或自架的,這一代沒有權重可下載,等官方後續動向再說。
開發者的下一步很明確:到 Model Studio 開帳、拿 API Key 與業務空間 ID,用 90 天內有效的 100 萬 tokens 免費額度,拿自己會議的錄音跑一輪,把真實的產品名與術語塞進 corpus 熱詞表測一致性,這比看任何評測都準。已經在用上一代的:新加坡區同價換型號名稱即可,行為相容的風險低,仍建議先抽測再全量切換。
還不能驗證的事也說清楚:LAAL 2.3 秒尚無第三方複測;官方評測集沒有公開分數與對象;權重未開放,無法自架;官方列出的下一步(壓延遲極限、跨會話長期記憶、更多長尾語種)都屬於方向宣示,官方未給時程,其中跨會話記憶若落地,長上下文消歧會再往前推一級。價格與規格以官方頁面 9 月 19 日刊載內容為準,若官方計費頁或文件更新,數字可能變動;免費額度的 90 天期限最早自模型發布日起算,大約到 12 月中旬。