TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

RLHF 與 InstructGPT 共同發明人結束兩年匿蹤,創立 TypeSafe AI 並推出首款 System One 模型 Jev:不生成文字,只回傳帶機率與信賴度的型別決策,輸入每百萬 token 0.042 美元、輸出免費,目前排候補制早期存取。官方宣稱回應時間 70 到 500 毫秒、比前沿 LLM 快 40 到 200 倍,全部數字尚無第三方驗證,定價是否補貼官方也自認待證。
用 AI 摘要這篇文章:
2026 年 9 月 15 日,匿蹤兩年的 AI 實驗室 TypeSafe AI 公開亮相,同時發表首款模型 Jev(官方部落格標示 9 月 15 日,頁面實際上架時間為台北時間 16 日上午 11 時 21 分)。這個模型最反常的地方在於它完全不生成文字:你丟給它一段狀態描述跟一組問題,它回傳帶機率與信賴度的型別決策,沒有開場白、沒有解釋、沒有可以引用的句子。共同創辦人 Diogo Almeida 正是過去在 OpenAI 參與 InstructGPT 與 RLHF 研究的人,官方團隊頁寫明這兩項研究成為 ChatGPT 與 GPT-4 背後的方法。帶著這個背景出來做一個不聊天的模型,本身就是這次發表最值得注意的訊號。Jev 目前採早期存取制,要排候補才拿得到 API key。
一句話定位 Jev:把 LLM 最擅長的語意判斷,包裝成軟體裡可以直接呼叫的決策函式。官網的說法是 Decisions, not strings,決策而非字串。輸入每百萬 token 0.042 美元,輸出免費,官方宣稱回應時間 70 到 500 毫秒。這些數字全部出自公司自己的頁面,第三方驗證目前一片空白,後面會專門拆開來講。頁面上沒有地區限制的說明,候補制本身就是主要門檻:官方只說會盡快把候補名單上的人放進來,沒有給時間表。這次發表直接相關的讀者,是把 LLM 當分類與路由引擎在用的後端與 AI 產品團隊;一般人日常用到的聊天與寫作場景,Jev 幫不上忙。
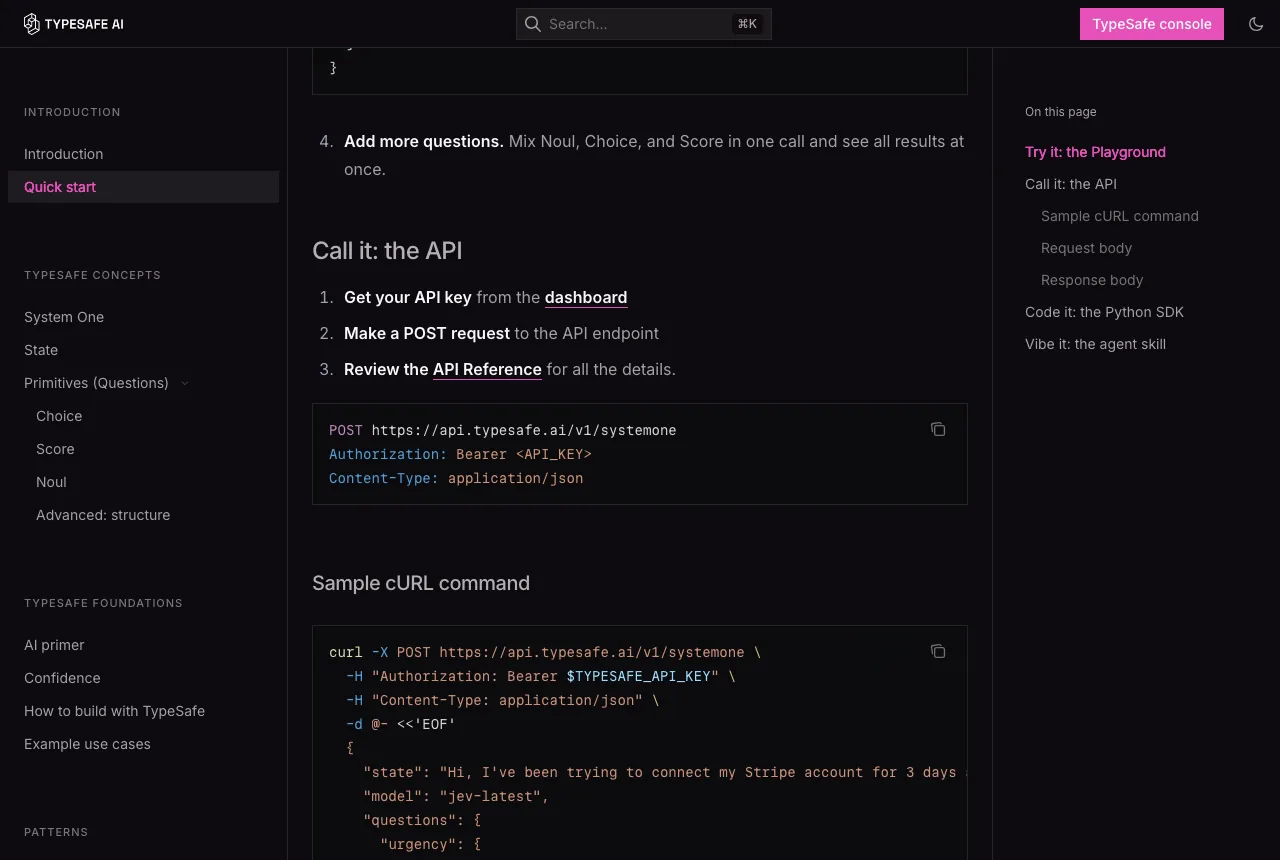
具體怎麼用,官方文件的快速上手給了一個客服工單的例子。你把一張客訴單全文當成 state 傳進去,附上幾種問題:Choice 問「這張單該誰處理」,你列出帳務、技術、銷售等候選與各自的描述,它回傳選中的那一項、每個選項的機率分布,再加一個 0 到 1 之間的 confidence;Score 問「客戶生氣程度」,你定義從平靜陳述到強烈措辭的等級,它回傳落在哪一級;Noul 問「這則訊息有沒有急迫性」,回傳就是一個 0.999 這樣的數值。整包回應的每個答案都是現成的資料結構,不是要你再解析一次的文字,尾端還附一個 usage 欄位記輸入輸出的 token 數。
這組設計裡有個容易被忽略的細節:所有問題是平行且隔離地對著同一份狀態評估,文件明白寫著多加問題幾乎不影響回應時間。這直接改變了用法。用 LLM 做路由時你會小心翼翼控制呼叫次數,深怕多問一句就多付一次錢、多等一次回應;Jev 鼓勵反過來操作,把所有可能要問的問題一次丟進去,事後再挑相關的答案用。官方文件把這叫投機式問句:在還不知道問題相不相關之前就先問,代價低到值得賭。他們的平行問句 cookbook 給過一組官方數字,批次問比起逐題分開問便宜 12.2 倍、快 10 倍。
API 端點是 POST api.typesafe.ai/v1/systemone,用 Bearer token 驗證,金鑰從 console.typesafe.ai 的後台發。官方提供 Python SDK(pip install typesafe-sdk)與 JavaScript SDK,也有給 Claude Code 這類代理環境用的 agent skill,加上 console.typesafe.ai 的 playground 可以直接試打。被丟掉的東西同樣明確:沒有推理過程的散文、沒有「以下是您的答案」的包裝,模型能回答的只有你定義好的欄位。單次 Choice 的候選上限是 255 個,超過要照官方建議走兩段式處理。
很多人第一個疑問會是:這跟 LLM 現成的 JSON mode、結構化輸出有什麼不同?官方 FAQ 把這題列在很前面。從文件看差異落在兩處:JSON mode 底層仍在生成文字,你拿到的是一段要祈禱它解析成功的字串,解析失敗是一整類真實存在的工程災難;Jev 回傳的本身就是型別值,官方宣稱 schema 配對有保證、型別錯誤為零。代價則是它真的不做生成,你要的任何一段文字它都給不出來。
價格是這次發表最有記憶點的部分。宣告文寫輸入每百萬 token 0.042 美元(首頁以每十億 42 美元呈現),輸出免費,官方的說法是 too cheap to meter,便宜到不值得計量。對照官方引用的行情,前沿 LLM 的輸入價落在每百萬 0.20 到 10 美元,輸出通常是輸入的 5 倍上下。首頁另放一組對比:輸入單價比 Claude Fable 5.1 低 238 倍。輸出為什麼能免費?官方給的解釋是架構性的:Jev 不做逐字生成,取樣時靠硬體感知的平行取樣器一次把所有候選的機率算完,沒有一個 token 接一個 token 的解碼成本可以計價。帳單掛在輸入端,每個回應的 usage 欄位會記下這次輸入與輸出的 token 數,對帳有依據。
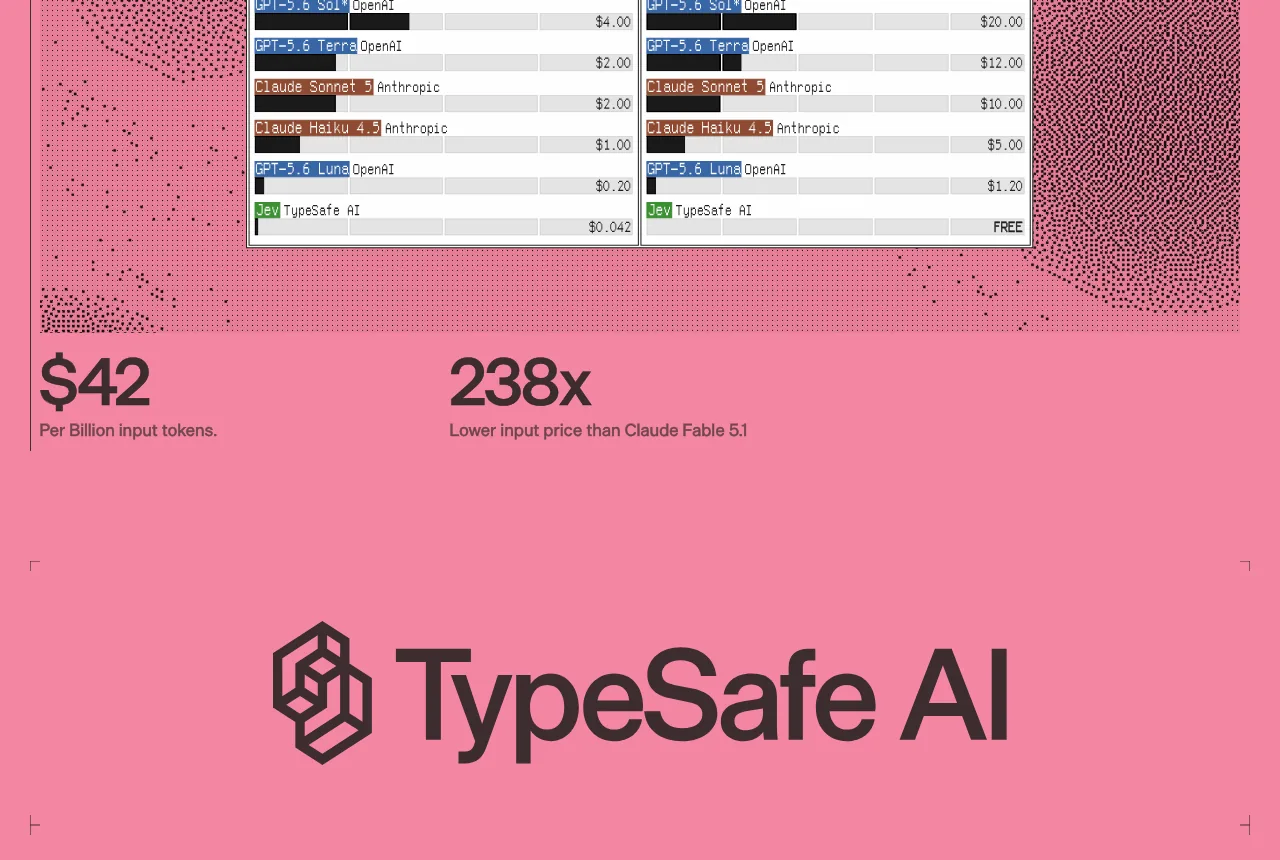
不過同一篇宣告文也自己承認:我們無法證明這不是補貼,需要更長的時間才能證明定價撐得下去。這句話值得原樣記下,它直接劃出這張價目表的有效期限。官方另外給了一個具體的用量感:用 Jev 玩經典遊戲 Doom 的示範,每秒下約 10 次決策,跑一小時的成本約 7 美元。
效能數字要全部當成官方宣稱來讀。宣告文寫 Jev 的端到端回應時間 70 到 500 毫秒,前沿 LLM 做同類任務是 3 到 329 秒;在官方所謂 System One 形狀的任務上,快 40 到 200 倍。首頁的工作流評測給出更具體的數字:193.6 倍快、444.6 倍便宜,單次 0.114 秒、0.000081 美元,對上傳統路徑的 8.566 秒、0.013880 美元。智力水準的對照組,官方選了 GPT-5.6 Terra,理由是平均而言與 Jev 的智力最相當,並附一段並排執行的錄影,兩邊的分歧只在客戶流失風險那一題。另一場維基百科條目競走(wikiracing)的比較裡,Jev 用比較少的步數抵達終點,官方自己也補了一句,對手跑的是非推理模式。
連評測的參考答案都有立場問題。官方做工作流評測時,參考答案取 GPT-6 Astra 與 Fable 5.1 兩家模型輸出的平均,他們自己註明這種做法偏向 OpenAI 與 Anthropic 的模型生態,可能低估 DeepSeek 與 TypeSafe。這些全是公司自跑的評測,發表當下沒有任何第三方複現,連 TechCrunch 都還沒有刊登相關報導。新模型發布時的官方基準該保留多少信任,可以參考我們先前整理 Atria Dawn 開源 Agent 模型時的同一個提醒:官方基準與獨立評測出現落差是常態,先等別人動手。
訓練方法上,TypeSafe 把 Jev 的最佳化目標命名為 RLCD,Reinforcement Learning for Calibrated Decisions,校準決策強化學習,用來取代自己創辦人參與發明的 RLHF 與近年的 RLVR。用他們的話說,是從討好人類評審,轉向認知上誠實的校準決策。翻成白話:模型答不準的時候,機率分布應該誠實攤開,而不是硬挑一個答案裝自信。
文件層的態度比行銷文案保守得多,這個落差本身就值得注意。confidence 那一頁從頭到尾沒有出現 calibration 這個詞,只說 confidence 是把機率分布的形狀壓縮成一個 0 到 1 的統計量,沒有給出公式或驗證方法,還特別註明你永遠可以不用我們的定義,完整機率分布都會附上讓你自己算。文件建議的用法是三段信賴度閘門:信賴度高就自動執行,中間地帶要求人工確認,低於門檻就轉給人。範例程式裡的門檻是 0.5 與 0.9:低於 0.5 視為模型真的不確定,直接轉人類處理;超過 0.9 才放行高風險操作,官方範例仍保留一道確認。另外 Noul 這種是非題的回應並不附 confidence,只有機率值本身,設計閘門時要分開對待。
團隊頁列出三位共同創辦人:CEO Diogo Almeida 在 OpenAI 參與 InstructGPT 與 RLHF,經歷欄也掛著 Google Brain;COO Sasha Sheng 來自 Meta FAIR;CTO Erik Gafni 是新創 Ravel 的創辦人。整個團隊的背景清單含 OpenAI、Google Brain、Meta FAIR、Stripe、Airbnb、Plaid 與 Docker。資金方面官方只說 backed by top-tier investors,金額與投資人一概未揭露,網路上流傳的融資數字查不到可靠來源,先不要當真。
兩個名字都是挑過的。System One 取自心理學家 Kahneman 的快思慢想,指人腦裡那套快速、自動、不經深思的判斷系統,對上慢想的第二系統;Jev 則是向十九世紀經濟學家 William Stanley Jevons 致意。命名把產品定位講得相當清楚:他們要做的從來就不是取代深思熟慮的推理模型,而是把那層快速判斷抽出來做成零件。
他們的論證核心放在宣言裡,一個比喻貫穿全文:汽車剛出現時,人們做的是沒有馬的馬車,高座椅、避震彈簧、甚至鞭子插座都照搬,把新引擎塞進舊時代的殼裡;AI 界把智慧塞進聊天框,在他們看來就是同一種過渡期形狀。宣言裡有兩句話把立場說得很直白:We’re building prod, not God,我們在做產品,不是在做神;Intelligence today is like databases before SQL,今天的智慧像 SQL 出現前的資料庫,強大,但每次使用都要手工打造。
TypeSafe 部落格另刊了一篇署名 Diogo 的隨筆 The Bitterest Lesson,把 Rich Sutton 的苦澀教訓再往前推一層:選對任務、資料、算力、演算法,重要程度依序遞減。他在 OpenAI 的親身經驗是,GPT-2 尺度的模型用 InstructGPT 的方法訓練,打敗了算力大得多的 GPT-3,關鍵就在最佳化的任務選對了。Jev 選的任務,就是軟體裡的決策這一塊。
現在就把 Jev 當萬用模型期待,會踩到幾個明確邊界。它不生成任何文字,摘要、改寫、寫信這類任務直接出局;官方的智慧家庭示範裡,需要自由文字回應的對話段落照樣轉給 LLM 處理,一句話裡含多個動作時也先讓 LLM 拆解成單一指令,Jev 負責的是前面的分類、評分與路由。號稱的零幻覺是設計論證:因為不輸出自由文字,所以沒有文字幻覺;schema 配對有保證,所以型別錯誤為零。但決策內容本身仍然可能出錯,官方 FAQ 也留了 Can Jev still get things wrong 這一題。換句話說,零幻覺不等於零錯誤。資料面還有一件事要自己盯:所有狀態文字都要送進 API 處理,隱私與合規的框架官方文件目前沒有特別著墨,企業採用前得自己評估。
市場面有三個未定因素:定價是否補貼、獨立評測何時出現、早期存取何時轉正式開放。任何一件塵埃落定,這篇文章裡的數字都要跟著更新。
按成本由低到高,開發者現在有幾個動作可以排。讀文件不需要帳號,docs.typesafe.ai 的快速上手、confidence 頁與十幾份 cookbook 全部公開,內容涵蓋重排搜尋結果、檢查引文、替 LLM 加護欄、多層分類、日期抽取這些任務範例。想動手試,先在官網排候補,同時用 Python 或 JavaScript SDK 把呼叫端寫好,等 key 下來直接接。如果你本來就在用 LLM 做代理的工具呼叫與路由,這類決策點正是 Jev 想接管的位置。
反過來說,需要生成內容的任務現在不用等它。官方自己的建議也是混合式:Jev 當快的決策層,LLM 當生成層,中間用信賴度分流量。要不要押注這個方向,更務實的時間點是等第一批獨立評測與真實帳單出現,一個月後再回來核對這篇的數字對不對得上。