TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

chinese-poetry 是 GitHub 上 53,684 星的開源古典詩文 JSON 資料庫,MIT 授權可商用;實算約 38.9 萬筆資料一半繁一半簡、靜夜思收的是宋本異文、唐以前的詩整段缺席,下載 454MB 前先看清三個邊界。
用 AI 摘要這篇文章:
如果你的專案需要一次拿到整套唐詩宋詞,chinese-poetry 大概是中文世界被引用最多的起點:GitHub 上 53,685 顆星、10,800 次 fork,MIT 授權,整包 JSON 免費帶走,商用也行。判斷先講:把它當「原料庫」用,值得拿;但「最全中文詩歌資料庫」這句自我介紹有三個邊界,最好在下載 454MB 之前先看清。三個邊界分別是:語料一半繁體一半簡體;最著名的詩收的是宋代版本,跟課本背的不一樣;唐以前的詩整段缺席。下面逐一攤開講。
chinese-poetry 是一個用 JSON 分發的中國古典詩文集資料庫,2016 年 9 月開張,維護者 JackeyGao 單人主導,61 位貢獻者零星補上修正。它不是給一般讀者瀏覽的網站。官方確實附了一個網頁版,但 chinese-poetry.github.io 已經轉址到 awesome-poetry.top,頁尾的版權年份停在 2019,收的文集只有十種(唐詩三百首、宋詞三百首、花間集、南唐二主詞、詩經、千家詩、聲律啟蒙、三字經等),跟資料庫本身的規模差一大截。把網站當贈品、把 JSON 當本體,定位就對了。如果你只是想查一首詩而不是搬整包資料,先前介紹過的 ggcha 漢語查詢工具箱那類查詢入口更省事。
拿資料有兩條主路。整包 git clone 下來目前約 454MB、2,246 個 JSON 檔;或只抓需要文集的 raw 單檔,每個檔案收 1,000 首上下,做小工具時這條路最輕。倉庫的 releases 頁只有 2017 年的 v0.1 佔位,沒有可用的打包下載,所以在 CI 裡建議用 sparse checkout,只拉會用到的目錄。懶得自己架服務的人也有現成路線:議題區有人用這份庫做了 Go 版 API 加 Docker 映像與 SQLite 匯出,也有人做成 MySQL 資料庫分享,等於伺服器端有人先替你踩過一遍。
資料結構很直白。以唐詩為例,每首四個欄位:作者、題名、段落、id。但不同文集的欄位並不統一:詞的欄位叫詞牌(rhythmic),沒有題名欄,等於一首詞的身分要靠詞牌加內容比對;御定全唐詩多出生平(biography)與註釋(notes);詩經、楚辭用的是章節結構。要跨文集統一處理,先寫好每種檔案的欄位對應表再動手,比事後補救省很多工。
檔案命名也值得先摸熟:詩文檔按類型加序號遞增,每滿一千首切下一個檔,詩人名冊與生平另存獨立檔。這個規律讓分頁載入與平行處理都很省事;要抽查資料品質,隨機挑幾個檔各讀幾首,就是有效率的抽樣方法。
我整包抓下來逐一清點,結果跟宣稱的落差都在個位數百分比內:
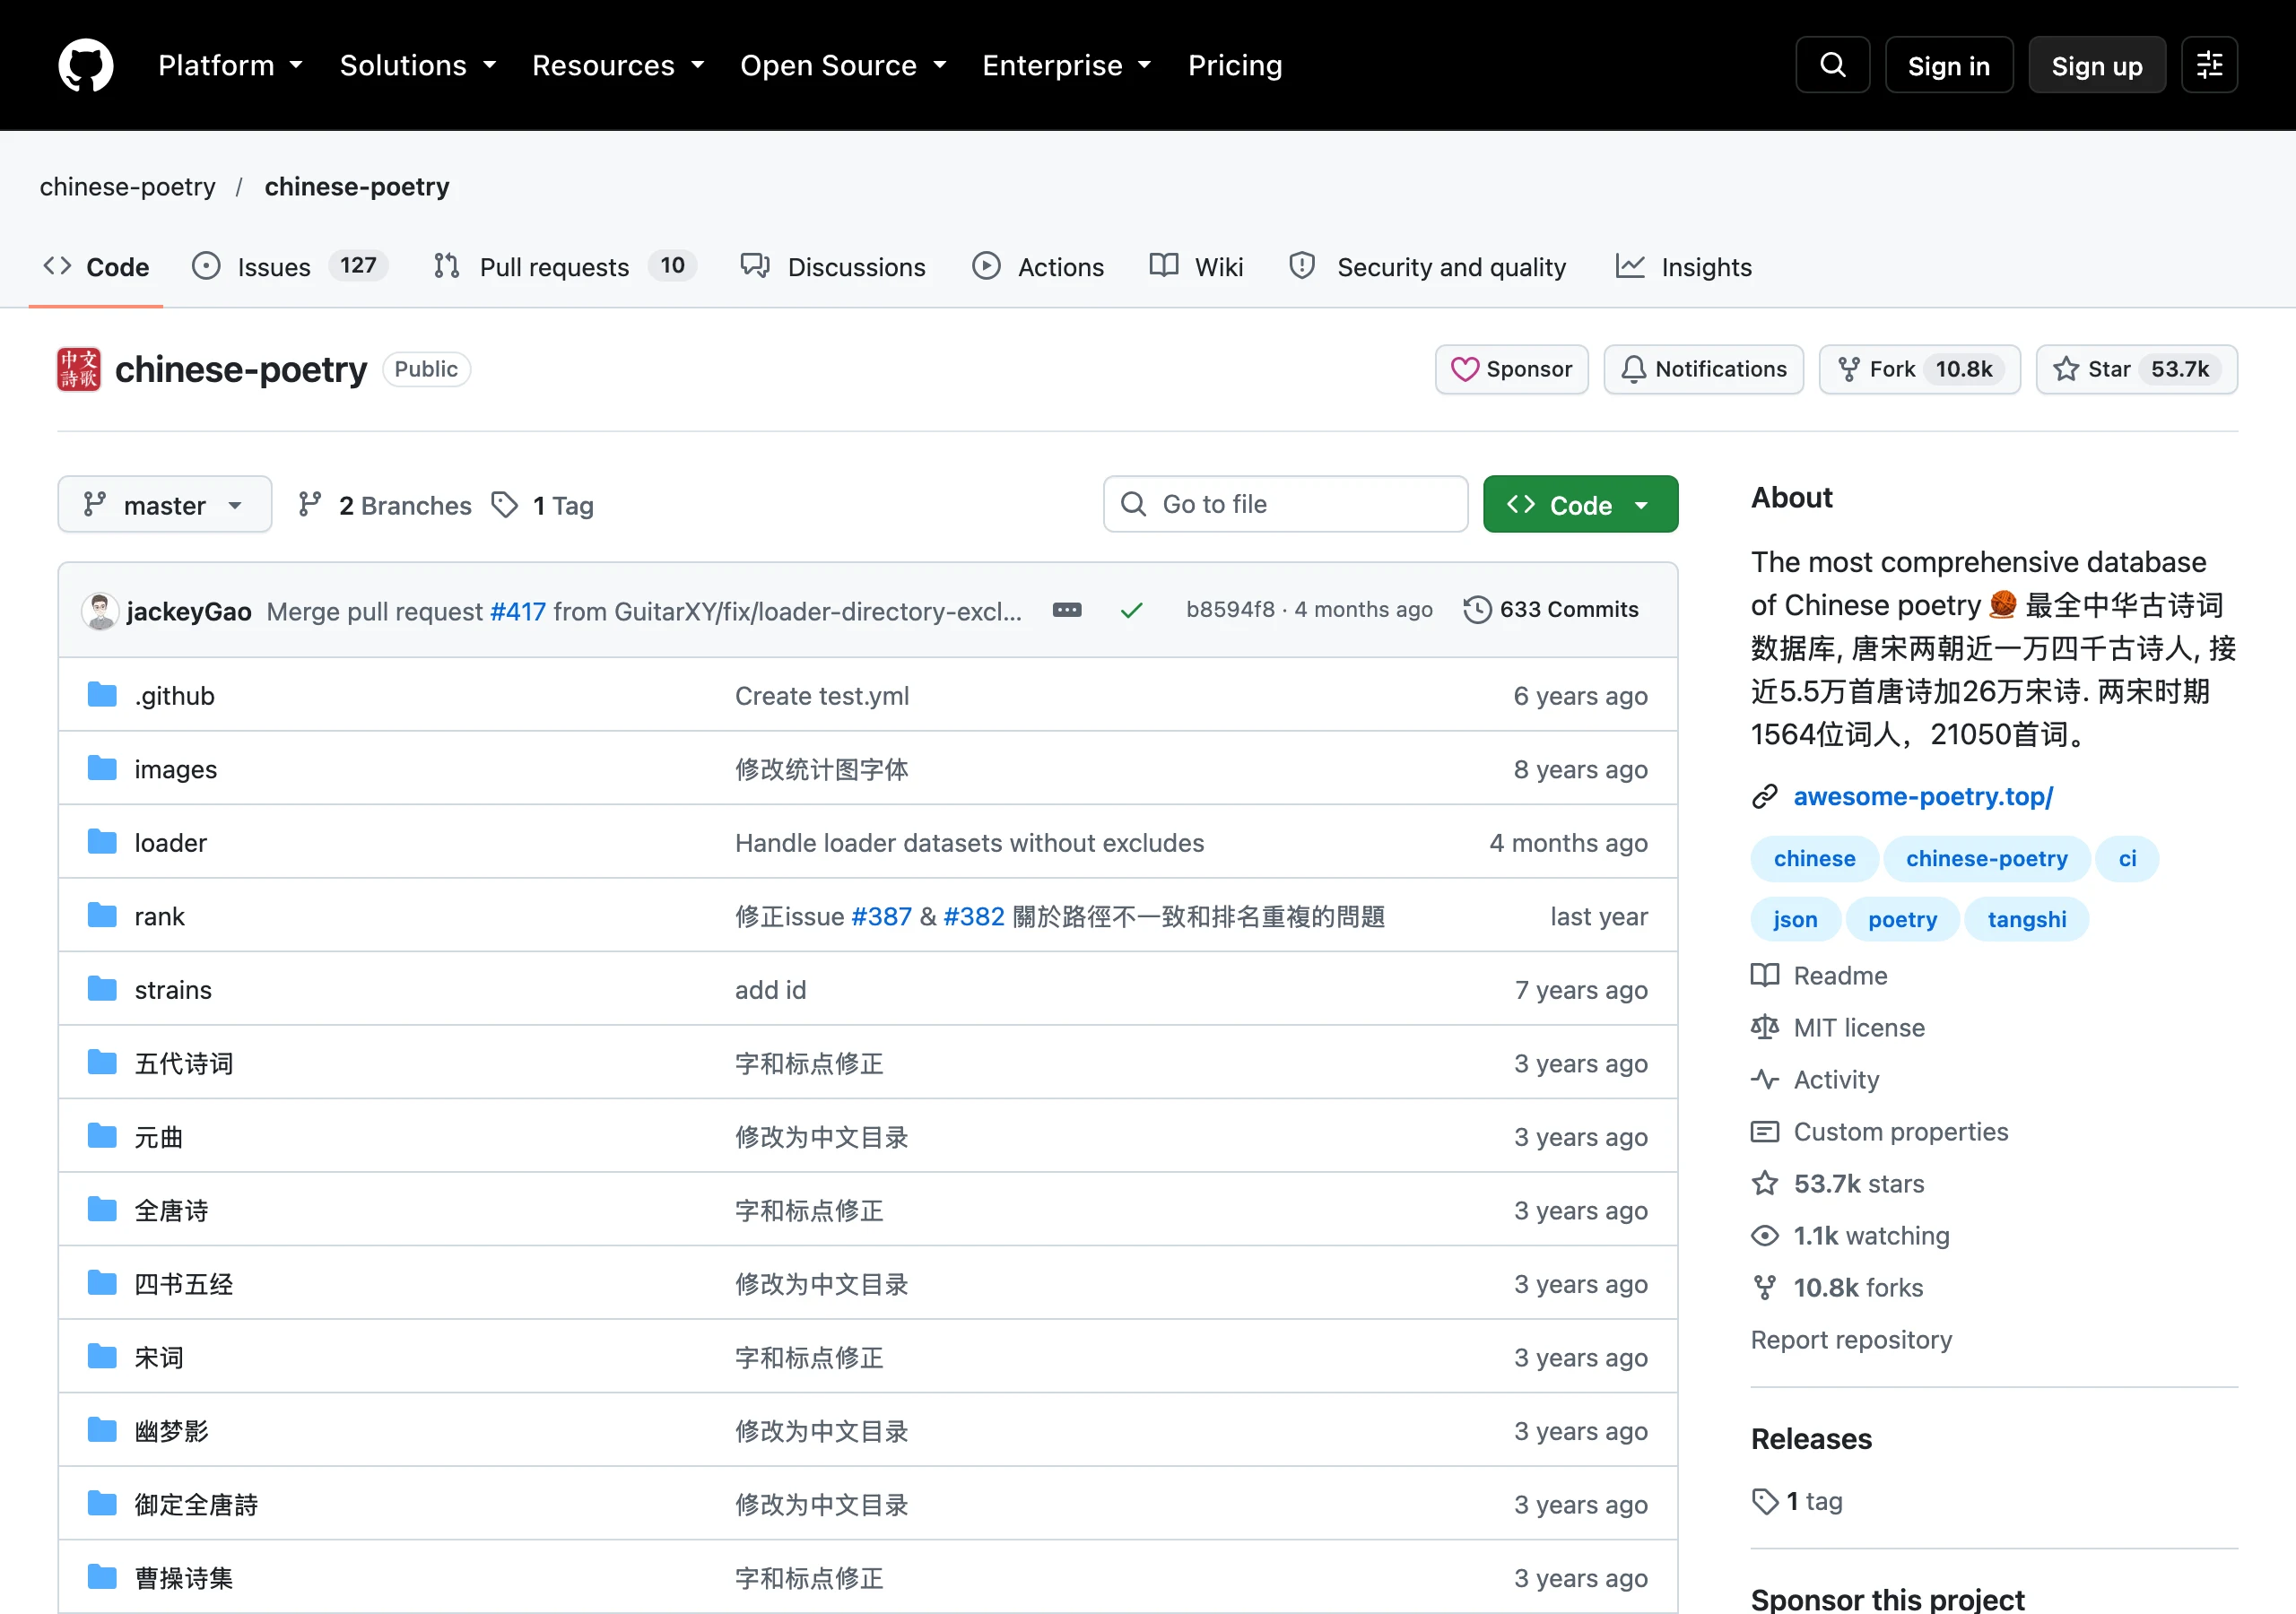
| 文集 | 官方宣稱 | 實際清點 |
|---|---|---|
| 唐詩(全唐詩) | 5.5 萬首 | 57,607 首 |
| 宋詩(全宋詩) | 26 萬首 | 254,248 首 |
| 宋詞(全宋詞) | 2.1 萬首 | 21,053 首 |
| 元曲 | 未宣稱 | 11,057 首 |
| 御定全唐詩 | 康熙刻本收 4.89 萬首 | 43,103 首 |
| 詩經 | 未宣稱 | 305 篇 |
| 唐宋詩人 | 近 1.4 萬人 | 12,609 人 |
| 兩宋詞人 | 1,564 人(倉庫簡介) | 1,563 人 |
當工程原料,這個準確度夠用;但要對外引用數字,請用實算值,不要引用 README 的行銷位數。有個小地方可以看出整理的品質:詩經恰好 305 篇,跟流傳的定數一致;詩人的生平檔也認真寫,宋太祖的條目從「宋太祖趙匡胤(九二七至九七六),涿州(今屬河北)人。生於洛陽。」起頭,一路寫到他的軍旅經歷,這種密度不像應付了事。
數字裡還藏著下載策略。宋詩 254,248 首佔了全庫約三分之二,只要你做的產品以唐詩或詞為主,整包 clone 就會把用不到的兩億多位元組一起拉下來;反過來說,做宋詩相關的應用,這份庫反而是最肥也最完整的一塊。另外標籤欄位別抱太大期望:全唐詩 57,607 首裡只有 4,132 首帶標籤,覆蓋率不到一成,想靠現成標籤做主題分類或年級分級的人,分類體系要自己建。
主力之外還有一圈小文集,合起來讓全庫到達約 38.9 萬筆:五代詞 543 首(花間集 498 闋含一篇序、南唐二主詞 45 首)、曹操詩 26 首、納蘭性德 258 首、水墨唐詩 176 首、幽夢影 219 則、楚辭 65 篇、論語 20 篇,加上四書五經與蒙學。選詩的口味偏正統文庫,不入庫的東西也查得到原因:維護方在貢獻規範寫明,有爭議的資料要社群投票決定。
唐詩其實收了兩套。全唐詩依詩人分檔,是資料量最大的那套;御定全唐詩依康熙 44 年(1705 年)敕編的 900 卷刻本逐卷分檔,多出生平與註釋欄位。御定版的 README 自述,整理到卷 796 時發現大量錯誤,整卷重做後才補回庫裡。做嚴肅引用時,御定版的卷號可以對回紙本,這是它比詩人分檔版好用的地方;至於倉庫簡介寫刻本「得詩四萬八千九百餘首」,實收 43,103 首,缺口就誠實當缺口看。
這份庫最容易被忽略的工程事實是編碼不統一。詩(唐詩、宋詩)與御定全唐詩的正文是繁體,打開全唐詩第一個檔案就是太宗皇帝的〈帝京篇〉:「秦川雄帝宅,函谷壯皇居。綺殿千尋起,離宮百雉餘。」李白〈將進酒〉也是繁體:「君不見黃河之水天上來,奔流到海不復回。」另一邊,詞(宋詞)、楚辭、論語、詩經、元曲的正文是簡體,蘇軾那闕水調歌頭在詞庫裡每個字都是簡體寫法;四書五經反而是繁體,兩套編碼的界線就畫在不同文集之間。蒙學的三字經還收了兩個版本並存:一千五百二十字的傳統本,與兩千零九十六字的增補本,結尾一個字之差。混雜甚至發生在同一個物件裡:靜夜思的段落欄位是繁體,標籤欄位卻是簡體詞。
這對搜尋與檢索是實際的坑。同一個詩人,在詩庫存繁體寫法、在詞庫存簡體寫法:我把蘇軾拿出來數,詩庫裡用繁體寫法收了 2,824 首、詞庫裡用簡體寫法收了 362 闋,跨文集用作者名搜尋會直接撲空,名單要先過一輪簡繁對照。實務上的作法是在匯入階段就畫好一張文集對照表:哪些目錄原樣保留、哪些目錄進轉換管線、轉換後另存一欄保留原字,方便日後回溯是原始資料就這樣寫,還是轉換環節出的差錯。
還有一個連繁體區都要注意的細節:繁體正文用的是古籍排版的用字習慣,跟台灣的教育部標準字不完全同一套。〈將進酒〉在庫裡寫「莫使金尊空對月」,尊沒有寫成樽,「為」這個字在部分詩行用的是古籍異體;靜夜思開頭的床也是同一類。做給本地讀者的繁體產品,呈現層要自己決定要不要再把這些古字換成通行寫法,這層轉換連簡繁問題都算不上,純粹是用字政策的選擇。
台灣讀者做繁體輸出怎麼辦?我拿詩經裡最容易踩雷的句子實測 OpenCC 的簡轉繁(s2tw):「壹發五豝」、「鬒髮如雲」、「宮商角徵羽」這些一個簡體字對多個繁體字的難例,全部轉對,連五音裡那個最容易轉錯的徵都轉對了。轉換管線的建議順序:先依文集畫好地圖,詩、御定與四書五經原樣過,其餘文集進簡轉繁;作者名冊單獨建一張簡繁對照表,檢索層全部走對照後的統一寫法;最後抽幾首名篇人工核對,像詩經裡一對多的字特別容易露餡。三步做完,混雜問題就從結構性風險降成一條可以寫進文件的已知事項。工具存在而且夠準,但倉庫本身不附轉換,這層工作責任在使用者。轉完之後若要講究網頁呈現,中文網字計畫的中文字型可以接著解決字體問題。
詩庫裡的靜夜思長這樣:「床前看月光,疑是地上霜。舉頭望山月,低頭思故鄉。」開頭那個床,庫裡用的是比通行字更古老的寫法,截圖裡看得很清楚;床前看月光對課本的床前明月光、舉頭望山月對課本的舉頭望明月,各差一個詞。這不是打錯字:它收的是宋蜀本的異文,今天大家熟悉的句子是明代通行本改定的,版本學上兩套並存。
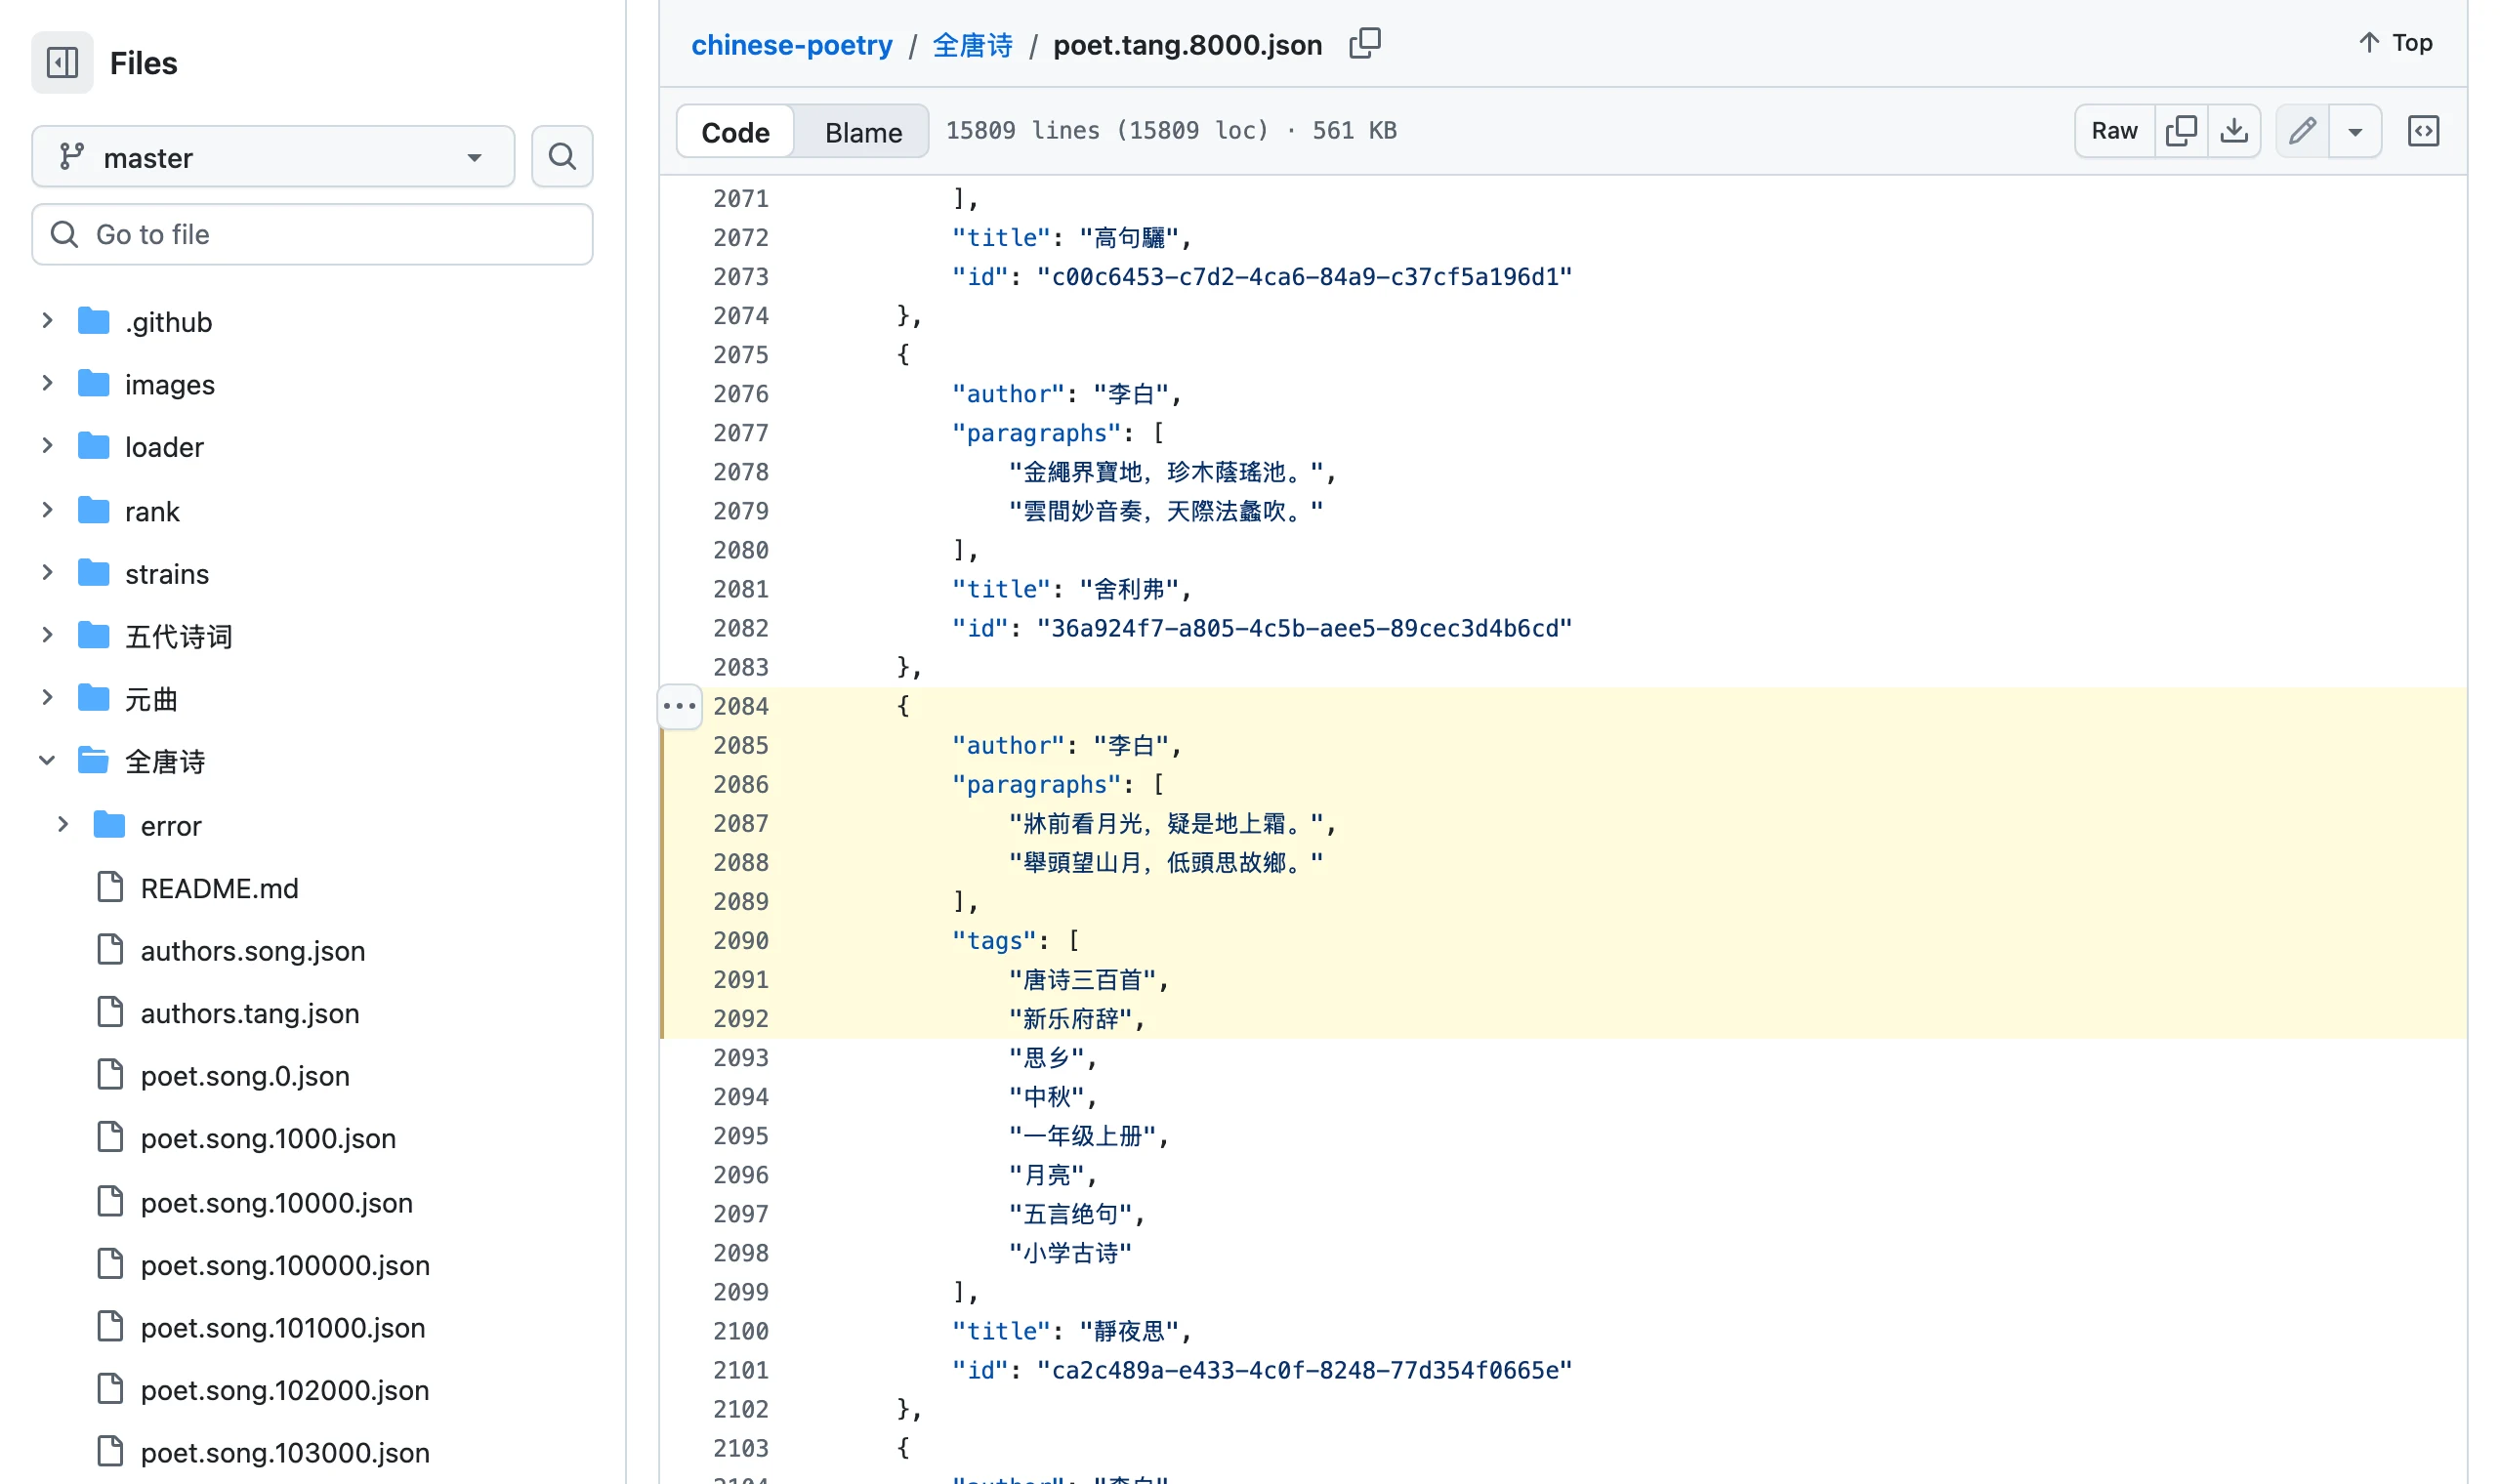
倉庫面對這首詩的態度值得看。2026 年 9 月有人開議題直問「確定是看月光?望山月?誰能告訴我正確答案?」,到目前無人回覆;更早的 6 月有人提交修正,把這兩句改成通行本,這個修正到今天沒有被合併。兩件事擺在一起,讀得出隱性的編輯立場:資料庫傾向保留所收刻本的原貌,不因為通行版熟悉就改寫。同段時間還有一個反向的提交,想把全庫繁體一次轉成簡體,同樣開著沒有動。三個方向不同的拉扯,說明這份庫的「正確」由版本忠實度定義,跟一般人的語感不一樣。
對讀者的影響很實際。拿它做教材、題庫或朗讀稿,輸出會跟課本對不上;要通行本,請自己在資料層替換那兩句。異文與通行本並存,其實是做版本比較教學的現成素材,國文老師拿宋本對明本講「課本為什麼長那樣」,比空講有畫面。
另一個邊界是收錄範圍。目錄結構裡沒有魏晉南北朝:陶淵明不在庫裡,他最著名的那首田園詩整首搜不到。這件事 2021 年就有人開議題反映,至今仍開著;2026 年又有人追問要不要收唐以前的詩,同樣沒有下文。「最全」的實際範圍是:唐宋兩代收得齊、先秦經部有(詩經、楚辭、論語、四書五經)、蒙學有、元曲有、清代的納蘭性德單獨收了一集,中間的魏晉南北朝整段空著。
不過蒙學那一櫃對家長和老師意外地有用:三字經、百家姓、千字文、弟子規、增廣賢文、朱子家訓、聲律啟蒙、幼學瓊林、文字蒙求都在,連古文觀止與千家詩也有。想做親子共讀 App 或寒暑假背誦表,這些是現成內容。
還有一條要先講的限制:這份庫沒有做過逐首對校紙本的工作,任何爬取整理的資料都可能留著錯字。全唐詩目錄裡甚至有一個 error 資料夾,收了 315 個抓取出錯的原始檔案,2024 年中才有人把它從官方載入器排除;如果你自寫解析器直接掃目錄,會把這些壞檔一起吃進去。宋詞的爬蟲腳本還留在倉庫裡,來源網站、編碼轉換都寫得清楚,想追資料出處的人有線索可查。要出書、出題的場景,引用前請自己再校一次。
主檔之外有兩層附加資料,設計得頗有想法。rank 目錄以「作者加作品名」當關鍵字,用搜尋引擎的結果數量當知名度維度,每首詩詞一筆,記了百度、360、Bing、Google 四個來源的數字;隨手翻到一筆,宋太祖的〈日詩〉在 Google 有 134 萬筆結果、百度 52 萬筆。要做熱門詩詞排序或推薦邏輯,原料已經附上,連同目錄裡一個小小的查詢伺服器腳本。不過這批數字有時效問題:搜尋結果數會隨引擎調整漂移,抓取又是多年前的事,把它當「相對熱門度」的排序訊號比當精確數字穩當。strains 目錄收每首詩的平仄譜,格式是「○仄仄,仄仄仄仄。」這樣的符號序列,檔案與詩文一一對應,第幾首對第幾首不會錯位;做對聯練習、聲律教學或寫詩輔助的工具,這層是現成的判斷原料。README 對這個拆法給的理由大意是:為了保持詩文資料本身的純淨,不是所有人都需要的資料就放在旁邊、用對應關係掛上。這個取捨讓主檔乾淨,代價是你得自己寫合併邏輯。
也因為資料本質上是靜態的,把它放進產品時建議直接釘住特定的 commit,資料層與程式層分開版本管理;倉庫 README 頂端的持續整合徽章還掛著早已收攤的 Travis CI,這種小地方提醒你:它更像一座整理好的圖書館,不是一套還在跑的服務。
### 拿它做商業產品可以嗎
可以。LICENSE 是標準 MIT(2016 年起),JSON 檔案可商用、可修改、可再散布;古典詩文的內容本身是公版。嚴謹一點的產品會在關於頁標註資料出處,這是學術禮貌,也讓你的使用者能回頭查版本;若你改寫或重編了資料再散布,留著原授權聲明、講清楚改了什麼,是 MIT 的慣例做法。
### 資料是簡體還是繁體
混合。詩、御定全唐詩與四書五經是繁體,詞、楚辭、論語、詩經、元曲是簡體。要做單一編碼的產品,先畫好編碼地圖再統一轉換;OpenCC 的簡轉繁我實測連詩經的一對多難例都轉得對。
### 靜夜思跟課本不一樣是錯字嗎
不是。那是宋本異文,資料庫傾向保留所收版本的原貌;要通行本,請在資料層自己替換那兩句。
MIT 授權,2016 年 9 月開張,53,685 顆星、10,800 次 fork、61 位貢獻者。維護是單人加社群零星提交的節奏:最新一筆合併在 2026 年 6 月(載入器修正),再往前要數到 2025 年 4 月。議題區有 137 個開著的討論,其中幾個資料修正與收錄範圍的提問已經放了好幾年。維護者靠 Patreon 與愛發電的贊助支撐這個專案,接受一次性贊助也接受定期贊助。這類專案的風險模型很清楚:資料已經穩定,不太會壞;但別期待快速修錯,重大缺口要自己動手補。
要做詩詞 App、AI 的中文語料、文學網站,或者像Z2H 字帖那類需要古詩文當內容的產生器,這份庫是最省事的起點,記得先處理編碼與異文兩件事。要把輸出排成美觀的版面,文顏這類排版工具接在後面剛好。反過來,需要跟課綱課本逐字對齊的教材,會多一道異文替換工;需要魏晉南北朝詩或逐字校勘保證的出版場景,這裡沒有,請直接找紙本或學術資料庫。一句話收尾:它把「唐宋以後看這裡」做到了開源世界最好用的程度,邊界也畫得清楚,先看邊界再下載,454MB 就花得值得;想先體感資料長什麼樣,到倉庫挑一個詩人檔讀十首,比讀完任何介紹都快。