TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

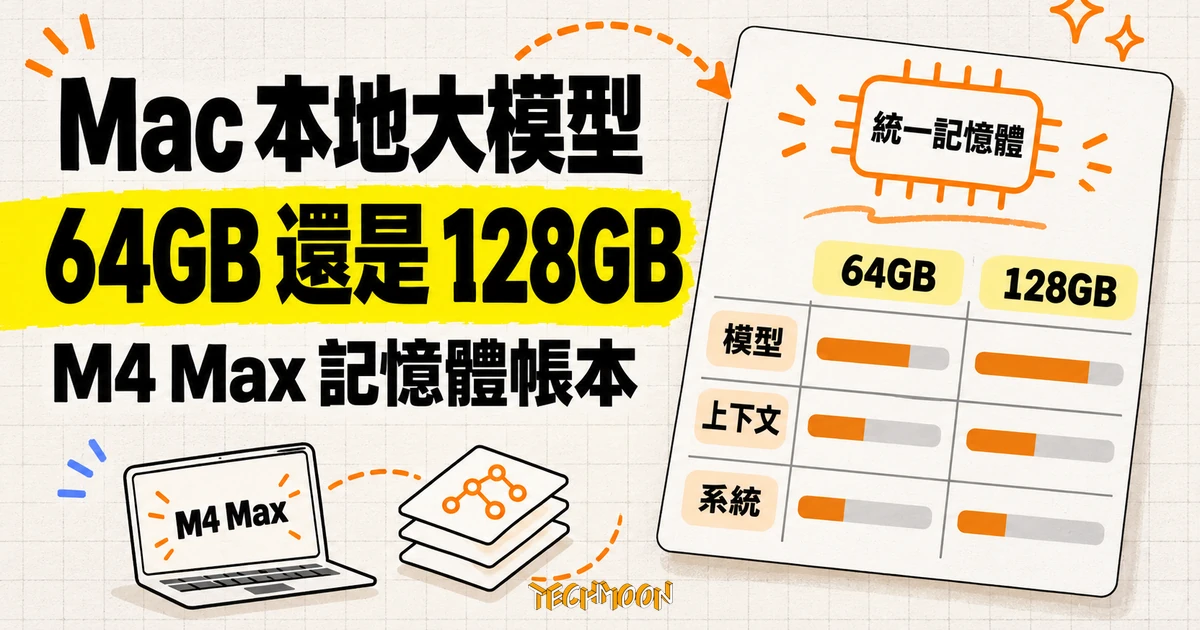
買 Mac 跑本地大模型,64GB 與 128GB 的差距可以用三層帳本算清楚:這台 64GB Mac Studio 實測 GPU 上限 51.84 GiB,4-bit 權重與 KV 快取逐項攤開後,27B 級主力在 64GB 寬裕,80B 級 MoE 才是 128GB 的真正戰場。
用 AI 摘要這篇文章:
先給短答案。如果你日常要跑的是 27B 級模型,寫程式、翻文件、整理資料,同時開著 IDE 和十幾個瀏覽器分頁,64GB 就夠,而且餘裕比你想像的大。如果你明確要離線跑 80B 級的混合專家模型(MoE)、想同時掛兩三個模型隨時切換,或者打算把上下文開到二十萬字以上,加價上 128GB 才有道理。至於想離線跑 235B 級旗艦的人,128GB 也救不了你,那是 256GB 以上 Mac Studio 的戰場。
這個問題現在特別值得算清楚,因為蘋果剛把整條產品線翻新過一輪:2026 年 10 月 28 日發表的新款 MacBook Pro 補齊 M6、M5 Pro 與 M5 Max 三款晶片,觸控的 PROLED XDR 款搭 M5 Pro 與 M5 Max,M6 留在非觸控的 14 吋,Mac Studio 也在八月換上 M5 Max 與 M5 Ultra。M5 Max 的 40 核心 GPU 版本提供 48GB、64GB、128GB 三個容量,128GB 相對基本 48GB 的加價是 2,000 美元,等於從 64GB 升上去再補 1,600 美元,兩種尺寸的升級價相同。這筆錢值不值得花,取決於三個可以算出來的數字,以下逐一攤開。
這份比較的對齊方式先講清楚:兩側用同一組開源模型、同樣的 4-bit 量化、同一天(2026 年 11 月 21 日)查核的檔案大小與規格。64GB 那一側的數字來自一台實際的 Mac Studio(M4 Max、40 核心 GPU、64GB),128GB 那一側沒有實機,全部是同一套公式推出來的推算值,表格裡會明確標示。
Mac 的統一記憶體讓 CPU 與 GPU 共用同一池記憶體,這是它能跑大模型的原因,也是帳本第一層折扣的來源。macOS 不會把整池記憶體都交給 GPU,而是保留一塊給系統與所有應用程式。實際數字可以直接問機器:在這台 64GB 的 Mac Studio 上,Metal 繪圖 API 給出的 GPU 建議工作集上限是 51.84 GiB(53,084 MB),約為帳面容量的 81%。模型權重、KV 快取、推論過程的暫存空間,全部要塞進這個上限裡。
作業系統留了一個調整閥(sysctl 的 iogpu.wired_limit_mb 參數可以把上限往上抬),但把閥開到底的代價是系統與其他應用程式被迫擠進剩餘空間,記憶體壓力一升高,整機會先卡後慢。把它當成除錯工具可以,當成日常配置是在跟系統搶資源。
同一個 81% 套到 128GB 機型,GPU 預設上限約 103.7 GiB。這個數字是推算值,蘋果沒有把各容量的實際上限寫進規格頁,不同機型與系統版本可能有一到兩個百分點的出入,但數量級不會變:128GB 的機器,推論引擎能自由運用的空間約 100 GiB 出頭。
模型能不能跑,第一關是 4-bit 量化後的權重檔案放不放得進 GPU 上限。這一欄不該用「參數量乘以 0.5 位元組」去估,直接看 Hugging Face 上 mlx-community 倉庫的實際檔案大小最準,以下是 2026 年 11 月 21 日逐檔加總的結果。
| 模型(4-bit 量化) | 權重實際大小 | 每 token KV 快取 | 32K 上下文合計 | 64GB 判定 | 128GB 判定 |
|---|---|---|---|---|---|
| Qwen3.5-9B | 5.54 GiB | 32 KiB | 約 6.5 GiB | 寬裕 | 寬裕 |
| Qwen3.8-27B | 14.95 GiB | 64 KiB | 約 17 GiB | 主力等級,寬裕 | 寬裕 |
| Qwen3.6-35B-A3B(MoE) | 19.00 GiB | 20 KiB | 約 19.6 GiB | 可用,餘裕中等 | 寬裕 |
| Llama-3.3-70B | 36.96 GiB | 320 KiB | 約 47 GiB | 貼邊,短上下文可行 | 可行 |
| Qwen3-Next-80B-A3B(MoE) | 41.76 GiB | 24 KiB | 約 42.5 GiB | 剛好塞入,無並行餘裕 | 舒適 |
| Qwen3-235B-A22B(MoE) | 123.16 GiB | 188 KiB | 約 129 GiB | 放不進 | 權重就超過上限 |
| Muse-Spark-Open-816B-A42B(MoE) | 496.19 GiB | – | – | 放不進 | 放不進 |
判讀這張表有兩個關鍵。第一,70B 這個等級在 64GB 上是「貼著上限可行」:36.96 GiB 的權重塞進 51.84 GiB 的上限後,剩下約 15 GiB 要同時養 KV 快取、推論暫存與你的瀏覽器分頁,短對話沒問題,上下文一長就開始緊張。第二,真正的斷崖在 235B:它的 4-bit 權重本身就 123.16 GiB,比 128GB 機型的 GPU 預設上限(約 103.7 GiB)還多出近 20 GiB,就算把上限開到底、整池記憶體都讓給它,扣掉權重也只剩不到 5 GiB 要養 macOS 與所有應用程式,實務上無從塞起。換句話說,128GB 的能力邊界畫在「80B 級 MoE 全速」與「235B 級旗艦」之間,多數人一輩子不會碰到後者。
KV 快取那一欄值得單獨說明,因為它藏著這一世代模型最大的帳本變化。KV 快取是模型邊生成邊記住前文的暫存空間,成本公式是每 token 位元組數等於 2(鍵與值)乘上 2 位元組的快取精度、全注意力層數、KV 頭數與每頭維度。新世代的 Qwen3.5、Qwen3.8、Qwen3.6 採混合架構:每四層只有一層是需要 KV 快取的全注意力層,其餘是狀態大小固定的線性注意力層。以 Qwen3.8-27B 為例,64 層裡只有 16 層要付 KV 帳,每 token 約 64 KiB,把上下文開到 32K 也只要 2 GiB。對照上一代的 Llama-3.3-70B,80 層每一層都要快取,每 token 高達 320 KiB,是 27B 新架構的五倍,32K 上下文直接吃掉 10 GiB。參數量更大的新模型,長上下文的記憶體成本反而更低,這是看規格表看不出來、卻直接決定你該買哪個容量的事。
容量決定能不能跑,速度決定用起來順不順。這部分用實測數字講:在這台 Mac Studio 上以 mlx-lm 的跑分工具量測,輸入 512 token、生成 256 token、跑三次取平均,macOS 與驅動全部維持出廠預設。
| 模型(4-bit) | 權重 | 生成速度(token/秒) | 峰值記憶體 |
|---|---|---|---|
| Qwen3.5-9B | 5.54 GiB | 54.9 | 5.93 GiB |
| Qwen3.8-27B | 14.95 GiB | 18.3 | 16.40 GiB |
| Qwen3.6-35B-A3B | 19.00 GiB | 76.4 | 20.19 GiB |
這組數字可以換算成使用感受。27B 每秒生成 18 個出頭的 token,大約是一般成人閱讀速度的兩倍,等答案的感覺是流暢的,幾乎沒有等待;9B 則快到接近即時。峰值記憶體 16.4 GiB 對上 51.84 GiB 的 GPU 預算,還剩 35 GiB 出頭可以養上下文與其他應用程式,這就是前面把 27B 列為 64GB 主力等級的實測依據。這個數字也能反向驗算頻寬:14.95 GiB 的權重乘上每秒 18.3 個 token,推論過程實際消耗的記憶體讀取量約為每秒 293 GB,同一顆晶片跑 9B 的數字是每秒 327 GB,兩者落在同一個區間,代表瓶頸確實在記憶體讀取這一關,帳本算式與實測互相吻合。
數字之外有兩個觀察。第一,峰值記憶體減掉權重檔案大小,就是推論引擎的計算緩衝與暫存開銷,9B 的例子裡不到 0.4 GiB,這一項通常被忽略,但它會在你以為「還有剩」的時候吃掉最後一格。第二,速度與模型大小的關係不是線性的下降,而是「每生成一個 token,被啟動的權重都要從記憶體讀一遍」的頻寬問題,這正是 MoE 模型在 Mac 上特別划算的原因:Qwen3.6-35B-A3B 每 token 只啟動約 3B 參數,實測生成速度每秒 76 個 token,是 27B 密集模型的四倍有餘,而它的權重檔其實更大(19.00 對 14.95 GiB)、峰值記憶體 20.19 GiB 也在 64GB 的預算內游刃有餘。知識量更大的模型跑得更快,這在顯示卡的世界很罕見,在統一記憶體上是日常。
把三層帳本疊起來,128GB 相對 64GB 多出來的東西就很具體了。
第一段是 80B 級 MoE 的完整體驗。Qwen3-Next-80B-A3B 的 4-bit 權重 41.76 GiB,在 64GB 上塞得進去但沒有並行空間,在 128GB 上則有 60 GiB 以上的餘裕,可以把上下文開滿、背景再多開一個模型。第二段是多模型並存:128GB 可以同時掛一個 27B 主力加一個 9B 快速模型,外加 Embedding 或語音模型,不用每次切換都等檔案重載。第三段,也是最貴的一段,是 235B 級的入場資格,但前面算過,4-bit 權重 123.16 GiB 已經超出 128GB 的 GPU 預設上限近 20 GiB,這段資格其實屬於 256GB 以上的 Mac Studio(M5 Ultra,1.2 TB/s 記憶體頻寬),或接受 3-bit 量化的品質折損。
生態系最近的動向也印證這條線畫在哪裡。11 月 10 日在 Hacker News 亮相的 Mac 原生推論引擎 Tokspur,把系統需求明白寫成「M5 Max 40 核心 GPU、128GB 統一記憶體」,它主打的 Qwen3.8 Flash-Next 模型 Q4 套件有 85.9 GB,正是標準的 128GB 級距樣本。這類工具的效能宣稱(在 Hacker News 的標題裡自稱比現有方案快三倍)尚待獨立驗證,但需求門檻本身透露的訊息很清楚:下一波 Mac 本地模型的重量級戰場,起步就是 128GB。再往上,Muse-Spark-Open-816B-A42B 的 4-bit 版本 496.19 GiB,連 512GB Mac Studio 的預設 GPU 上限(同比例推算約 415 GiB)都裝不下,那已經是 3-bit 量化或多機串聯的領域。
容量帳本之外,還有一條比較少人算的路:同樣的模型,買更高的量化等級。4-bit 把每個權重壓到約半個位元組,8-bit 用約一個位元組換更少的品質折損,檔案大小也跟著翻倍。實際檔案大小一樣查得到:Qwen3.8-27B 的 8-bit 版本是 27.48 GiB,Llama-3.3-70B 的 8-bit 版本是 69.82 GiB。
把這組數字放進帳本,會看到兩件事。64GB 的擁有者已經買得起品質:27.48 GiB 的 27B 8-bit 在 51.84 GiB 的預算內綽綽有餘,等於日常主力可以直接上更高量化,不必為了品質升級機器。而 70B 的 8-bit 是 128GB 獨有的選項:69.82 GiB 在 64GB 機型上連實體容量都超過,在 128GB 的推算預算內則放得進去。換句話說,128GB 的兩千美元買的不只是更大的模型,還有「同一個模型、換更高量化的品質」這條路。
這條路要付的速度代價要先想清楚。權重讀取量翻倍,生成速度大約砍半,前面 27B 4-bit 的實測速度換到 8-bit 大約只剩一半,長文件生成會明顯變慢。適合把品質看得比速度重要的人,例如翻譯或文件審閱這種一次跑完可以慢慢等的場景;對話式的日常使用,4-bit 的速度通常比較划算。
| 64GB | 128GB | Mac Studio 256GB(M5 Ultra) | |
|---|---|---|---|
| GPU 預設記憶體上限 | 51.84 GiB(實測) | 約 103.7 GiB(推算) | 約 207 GiB(推算) |
| 4-bit 可跑的最大等級 | 70B 貼邊、80B-A3B 剛好 | 80B-A3B 舒適 | 235B 可跑 |
| 27B 級長上下文(128K) | 可以(KV 約 8 GiB) | 可以,餘裕大 | 可以 |
| 多模型並存 | 一個為主 | 兩到三個 | 多個 |
| MacBook Pro 相對 48GB 的加價 | 400 美元 | 2,000 美元 | 無此選項 |
| 實測狀態 | 本機實測 | 未測,容量推算 | 未測 |
表裡最後一欄是這份比較的誠實邊界:128GB 與 256GB 的欄位都是推算,沒有實機數字。速度欄刻意不列,原因見下一節。
生成速度的第一個約束是記憶體頻寬:每個 token 都要把啟動的權重讀一遍,頻寬除以啟動權重大小就是速度的理論天花板。M5 Max 的 40 核心 GPU 版本是 614 GB/s,32 核心版本 460 GB/s,M5 Ultra 是 1.2 TB/s,這些是蘋果規格頁的官方數字。用 27B 的 4-bit 權重(14.95 GiB)粗算,614 GB/s 的理論天花板約在每秒 38 個 token。本機實測可以當校準點:這台 M4 Max 跑 27B 每秒 18.3 個 token,換算實際讀取量約每秒 300 GB,理論天花板本來就該這樣打折。M5 Max 的頻寬更高,27B 只會更快,具體數字留給實機驗證,但量級不會跳脫這條算式。
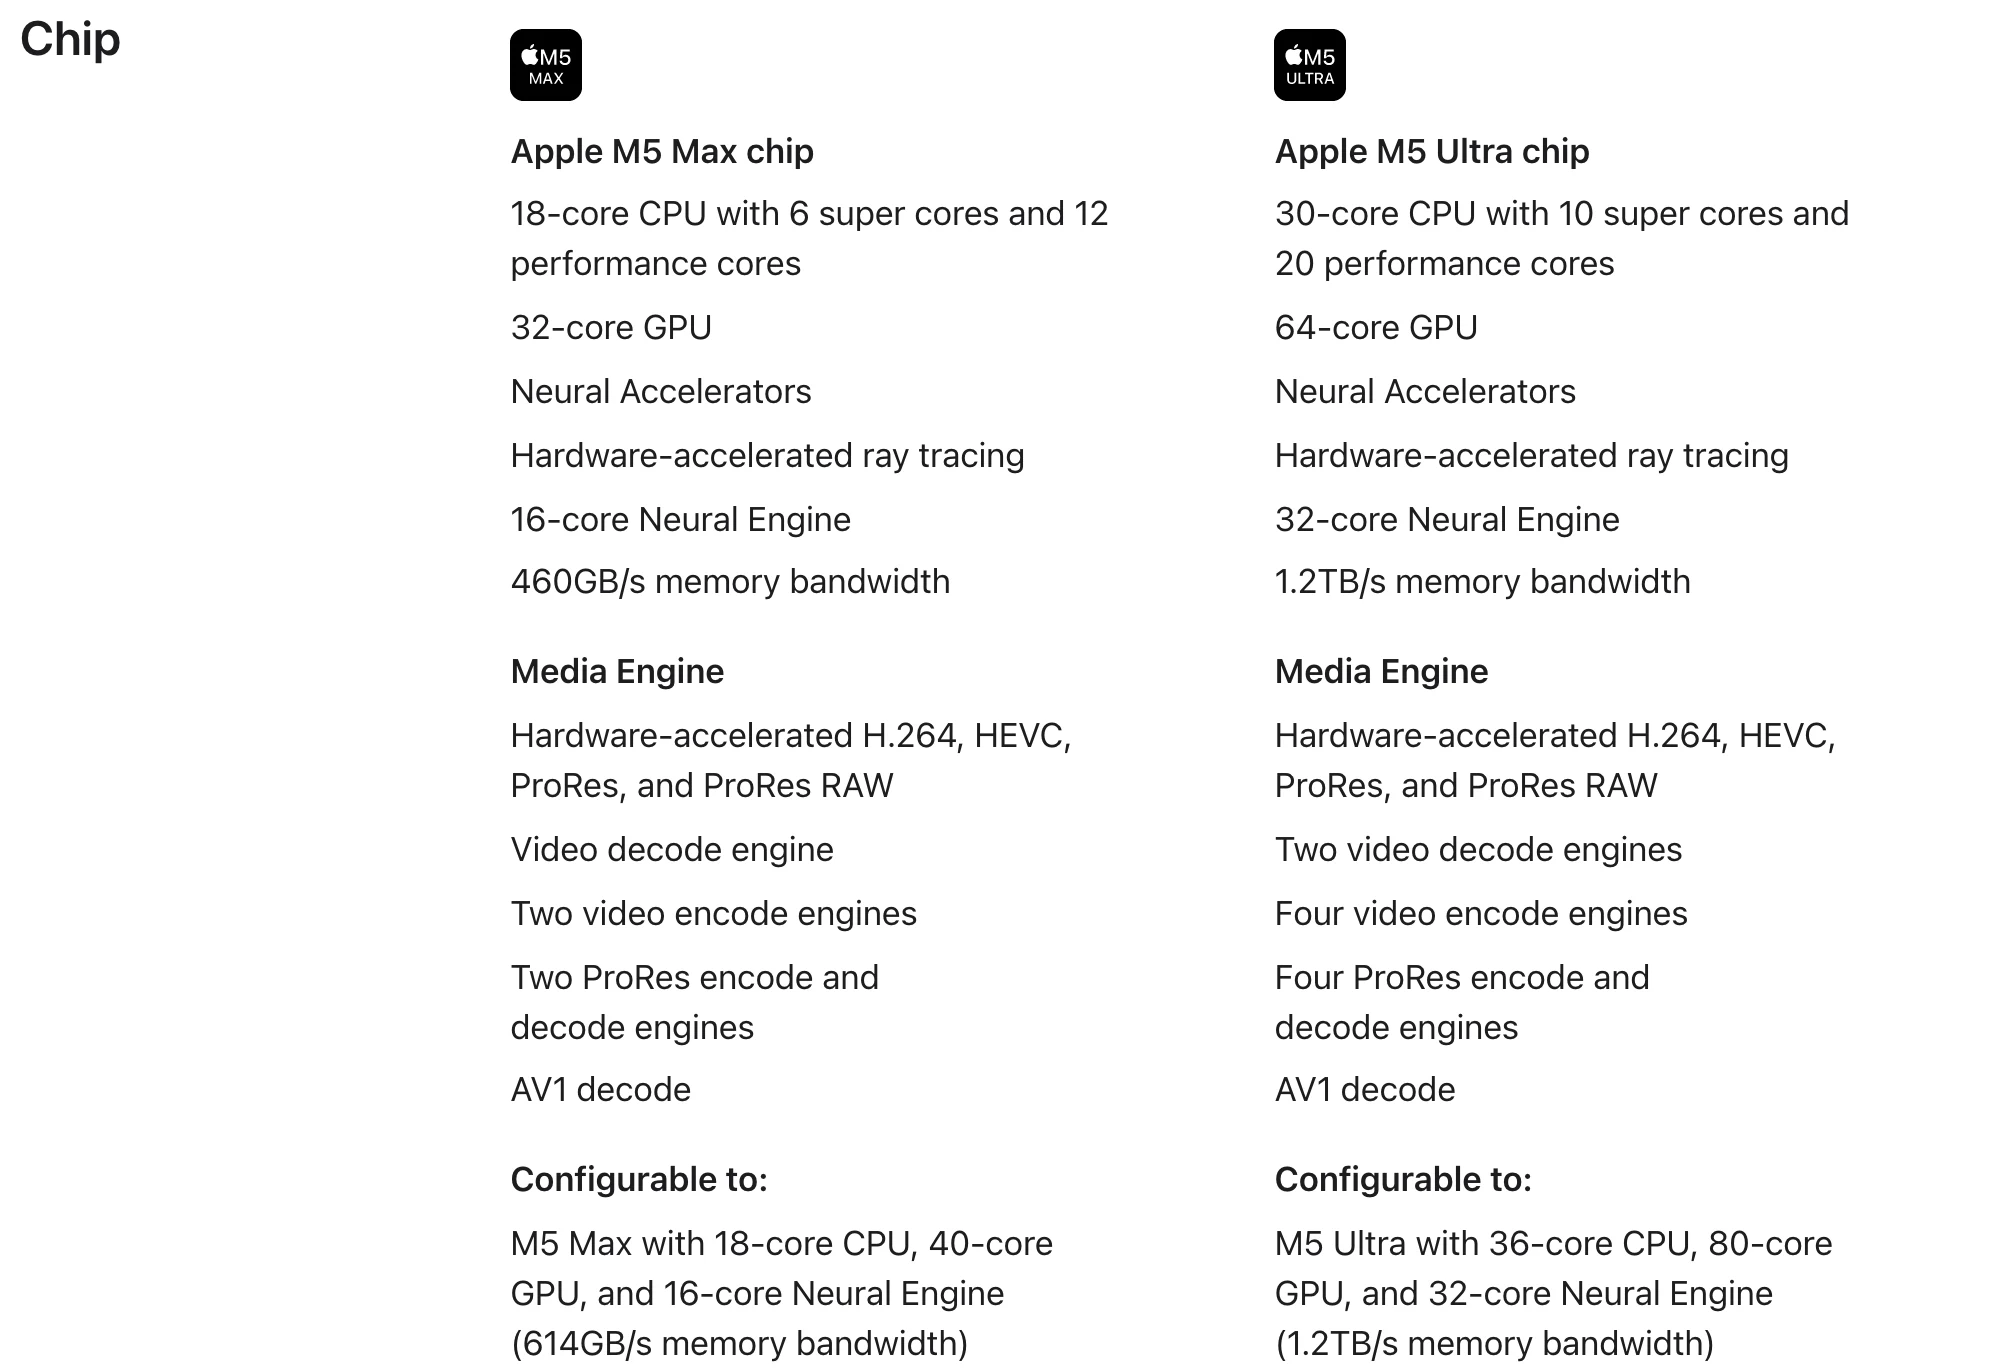
這帶出兩個選購判斷。晶片版本之間的頻寬差(460 對 614 GB/s)只影響全駐留時的速度檔次,救不了容量不足;反過來說,若你的模型裝得下,多核心數的邊際效益比帳面看起來小。MoE 模型則是這條算式上的例外:每 token 只讀啟動的專家,35B-A3B 的有效讀取量向 3B 級看齊,這是它在 Mac 上跑得又快又大的根本原因。想在 Mac 上體驗大模型的速度,挑 MoE 架構比砸錢上更強的晶片更有效。
已經有顯示卡的讀者可以對照先前算過的帳:一張 16GB 顯卡在 llama.cpp 1.0 時代能跑的模型,瓶頸在 PCIe 備援道;Mac 的統一記憶體沒有這條備援道,代價是容量上限焊死在主機板上。多人共用、要撐併發的場景,vLLM 的 PagedAttention 路線把配置交給引擎;Linux 小主機的路線,Omarchy 的 64GB 本機模型配方先前也整理過,64GB 在不同平台上的帳本結構可以互相對照。
第一,128GB 那一側全部是推算。權重與 KV 的公式兩側適用,但 81% 的 GPU 上限比例量自這台 64GB 機型,蘋果沒有公布各容量的官方值,不同系統版本可能微調。第二,檔案大小會漂。量化倉庫會更新版本、模型會改版,表裡的數字以 2026 年 11 月 21 日查核的版本為準,下單前值得重查一次你要跑的那個模型。第三,速度是單機樣本。同一張晶片在不同散熱環境(MacBook Pro 對 Mac Studio)可持續的頻寬輸出不同,筆電長時間高負載會先遇到溫度牆。
回到最初的問題。64GB 與 128GB 之間的 1,600 美元價差,買的主要是 80B 級 MoE 的完整體驗與多模型並存的自由,而不是「能不能跑大模型」的入場券。入場券 64GB 就有了,而且在新世代混合注意力架構把 KV 快取壓到每 token 幾十 KiB 之後,這張入場券比兩年前值錢得多。先把你真的會跑的模型列出來,對著上面的表查權重大小,答案通常就浮出來了。