TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

本機推理引擎 TensorFold 在 1.2.9 加入七條 Ollama 相容路由與 TOML 啟動設定檔,並帶多路解碼吞吐改善與多項預設值變更。相容範圍、效能數字的適用條件與升級前的行為差異,整理成可核對的升級判斷。
用 AI 摘要這篇文章:
開源推理引擎 TensorFold 在 11 月 15 日發布 1.2.9,一次放進三組東西:七條 Ollama 相容路由、可存檔的 TOML 啟動設定,加上多路解碼的吞吐改善。判斷可以先給:這版對「已經在用 Ollama 生態工具、又想換一顆引擎」的人是實質利多,既有客戶端少改程式就能接;對單人使用、偶爾問一句的人,速度面幾乎無感,真正的收穫在錯誤處理變明確、啟動方式可以進版本控制。
先把最容易被誤讀的數字講清楚。發布說明裡的 3.2 到 3.5 倍,是 M5 Ultra 上特定 Nemotron 模型在二十四路同時請求下的合計吞吐,單一路串流幾乎不變,作者自己量到的是 -0.02% 與 -0.29%。這組數字對「一台機器同時服務多個代理或多位使用者」的場景才有意義,自己一個人問一句答一句,吃不到這個幅度。
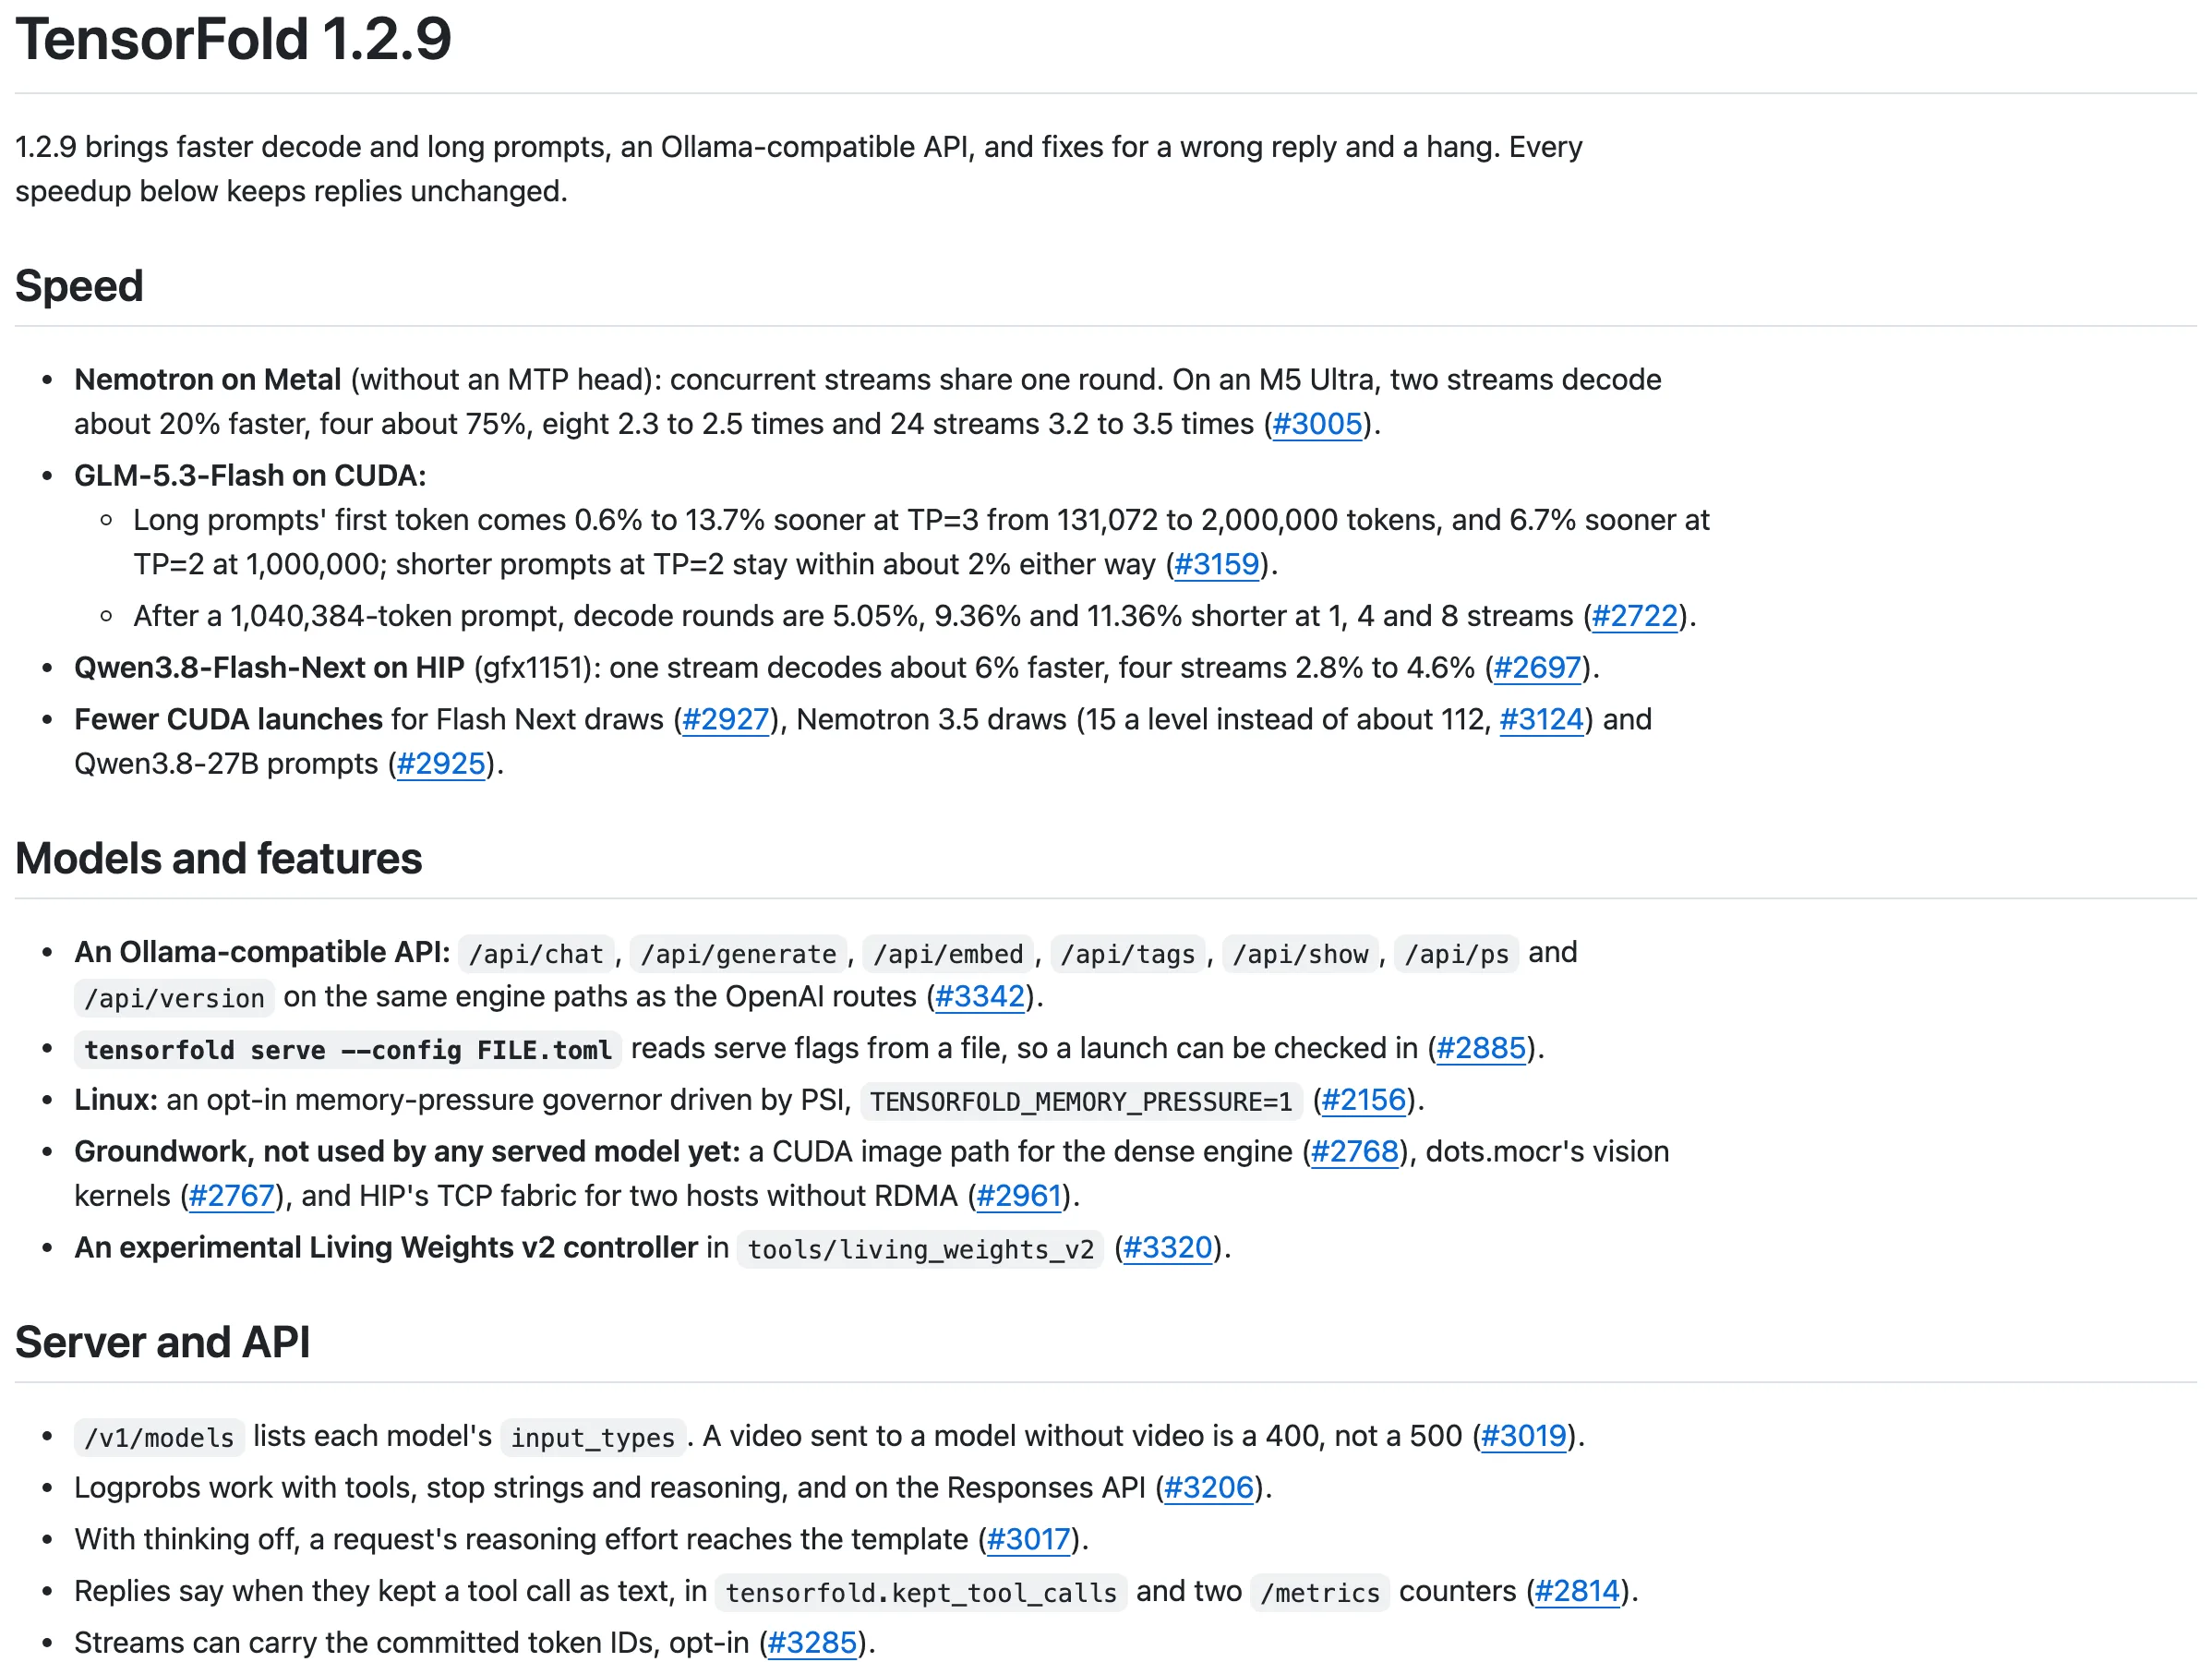
TensorFold 是用 Zig 寫的開源推理引擎(Apache-2.0 授權),以單一執行檔發布,走 Metal、CUDA、HIP 這些原生後端,支援 Qwen、Nemotron、GLM、Kimi、LFM 等模型家族。它就是 Omarchy 那批 NVIDIA 配方背後的執行引擎;TechMoon 先前介紹過64GB 機型的本機模型配方,當時配方釘住的還是 1.2.1 版映像檔。專案今年 6 月才建立,五個月累積超過兩千顆星,最近 13 天發了 8 個版本,節奏很快。
Ollama 有一套自己的 HTTP 介面,生態裡的客戶端、面板與代理工具都對著它講話。TensorFold 1.2.9 在自己的伺服器上加了七條同名的路由:/api/chat、/api/generate、/api/embed、/api/tags、/api/show、/api/ps、/api/version。關鍵在於這層只是翻譯:請求進來後走的是與 OpenAI 格式介面相同的引擎路徑,模型沒有換、引擎沒有換,也沒有安裝另一份 Ollama。
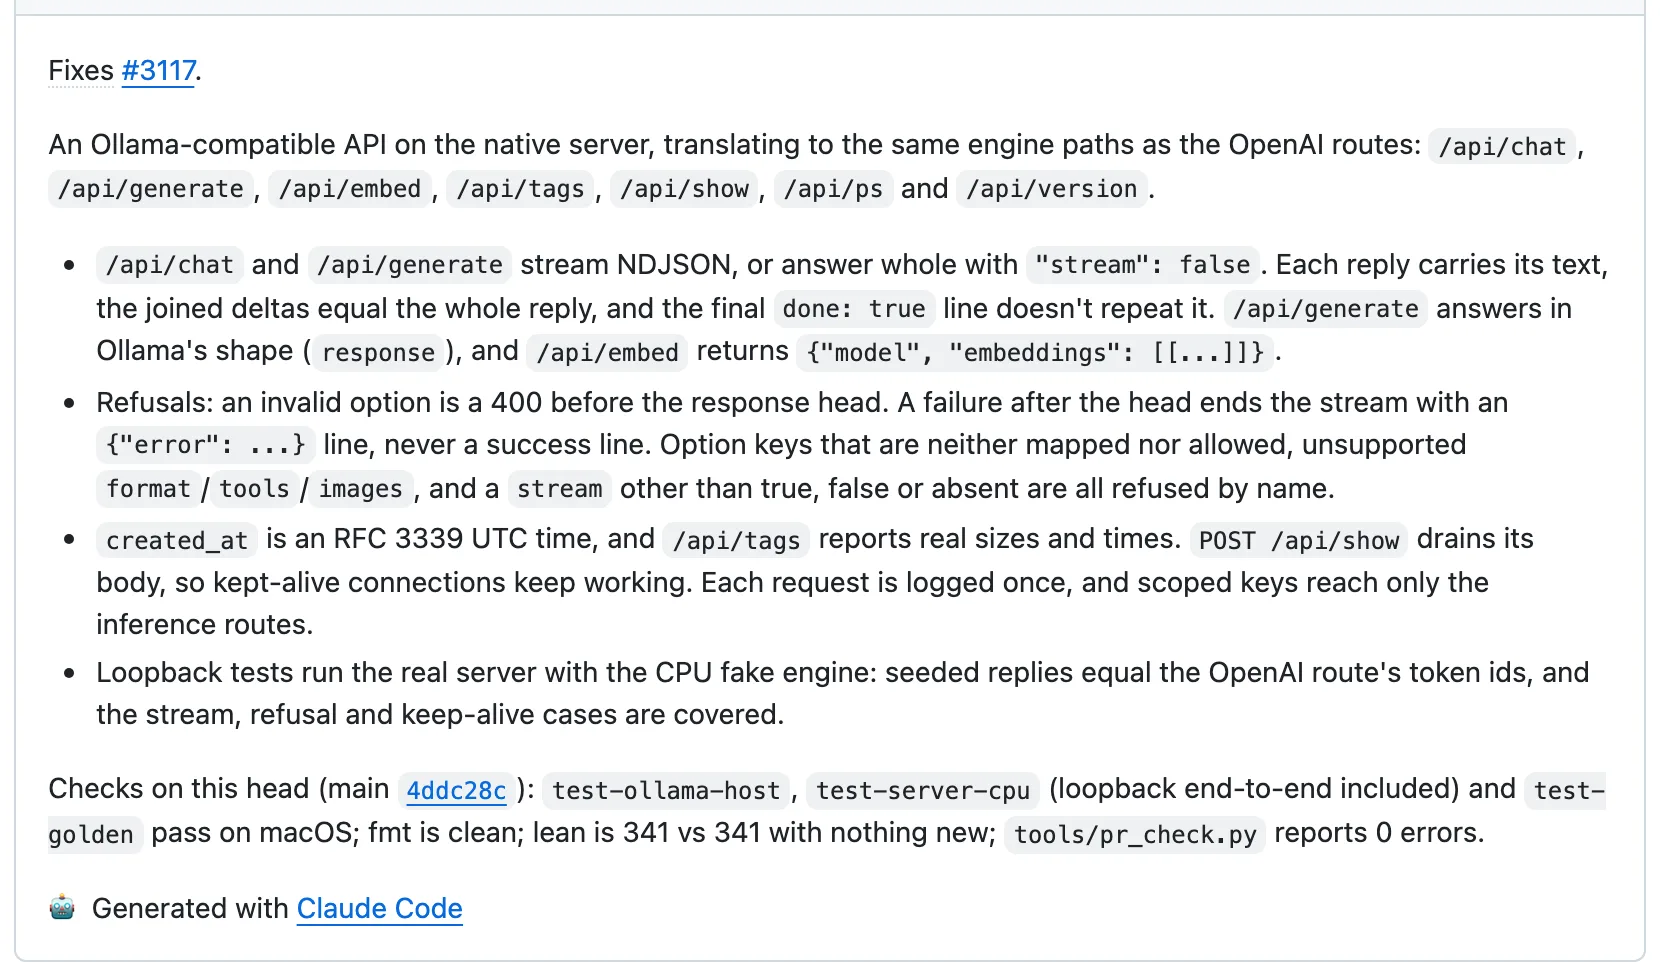
聊天與生成兩條路由支援 NDJSON 串流,也可以帶 stream: false 一次拿整包回覆;串流中每行帶上文字增量,接起來等於完整回答,結尾那行 done: true 不會把整段回答再重複一次。/api/generate 回 Ollama 形狀的 response 欄位,/api/embed 回模型與 embeddings 陣列,/api/tags 回報真實的模型大小與時間,時間戳是標準的 RFC 3339 UTC 格式;POST /api/show 會把請求內容收乾淨,長連線不會卡死。換句話說,本來接 Ollama 的工具(例如自架的Open WebUI 聊天介面)把主機指到 TensorFold 伺服器,就有機會直接用。
入口統一省下的是轉接層的維護負擔。本機模型服務要同時面對兩端:一端是實際執行模型的引擎,另一端是編輯器、聊天畫面與代理程式;兩端講的請求格式不同,中間就得自己寫一層翻譯,引擎一改版就要跟著修。相容路由等於把這層翻譯交給引擎作者維護,使用者的工具鏈留在原地。附帶一提,具有限制範圍的 API 金鑰在這組路由上只碰得到推論相關路徑,管理功能不在其中。
這組介面從規劃到落地只花了一天半出頭:作者 11 月 13 日開 issue 列出路由與選項對照,11 月 14 日合併,隔天隨 1.2.9 釋出。作者在合併記錄裡附了迴路測試:用 CPU 假引擎跑真伺服器,同一組種子輸入下,Ollama 路由回的 token 編號與 OpenAI 路由相同,串流、拒絕與連線保活的案例都覆蓋。
相容路徑不等於整個 Ollama 表面。合併記錄把邊界寫得很明白:溫度、top_k、top_p、min_p、num_predict、stop、seed、presence 與 frequency penalty、think 這些選項有映射;mirostat、repeat_penalty(引擎沒有這個機制)、超過模型上下文視窗的 num_ctx,以及沒有映射的選項鍵,一律用名字拒絕。format、tools、images 這三種用法同樣明確拒絕。
錯誤的時間點也分得清楚:無效選項在回應開始前就是 400;串流已經開始後才失敗,會以一行 error 物件結束,不會補一個假的成功行。對客戶端來說,這表示可以放心把「拿到明確拒絕」當成程式邏輯的一支,不用猜某個功能到底存不存在。
我下載了官方釋出的 macOS arm64 壓縮包,對過發布頁附的 SHA256 檔案,雜湊一致;解開主體是單一執行檔 tensorfold-native,另附一個文法共享庫與授權文件。執行 –version 回 1.2.9,在執行檔裡搜尋字串,七條 /api/ 路由全部都在。這組驗證只證明介面存在,各種 Ollama 客戶端的實際相容還是要逐個試,特別是依賴工具呼叫或圖片輸入的用法,目前會收到拒絕。
模型伺服器的行為有一半來自啟動參數:模型放哪、用哪個後端、記憶體怎麼分配。1.2.9 新增 tensorfold serve –config FILE.toml,把這些旗標收進 TOML 檔案;命令列參數的優先順序高於檔案,同一個值可以臨時覆蓋。幾個規則值得記住:檔案裡的相對路徑以檔案所在目錄為起點;可重複的旗標(例如 api-key)一旦出現在命令列,就整串取代檔案裡的清單,兩邊不會混著用;capabilities –json 會列出 –config 這個新旗標,方便腳本探測。原本十幾個旗標靠 shell 腳本或維基頁面傳承的團隊,現在可以把一份設定檔放進版本控制,重跑有相同起點,比較新舊版本時也有共同基準,不會把啟動方式的不同誤判成引擎的差別。
安全檢查比想像的細:群組或其他人可寫的檔案、符號連結都會拒絕;在別人可讀的檔案裡放 api-key 也會拒絕,訊息附檔名與行號,並提示改用 chmod 600 或 api-key-file。TOML 支援的是子集:字串、整數、浮點數、布林與字串陣列,表格、點式鍵與巢狀結構會用名字拒絕;它接受的每份檔案都是語意相同的合法 TOML 1.0。另外 TensorFold Web 版的設定介面刻意不接受 –config,原因是設定檔可能塞進介面沒在管理的項目,兩邊各管各的。
我也實際試了兩種寫錯的檔案。鍵名打錯(prot = 9999)會在嘗試載入模型之前直接退出,訊息是 bad.toml line 1: unknown key ‘prot’;把 port 寫成文字也一樣,會指出哪一行的哪個旗標拒絕了這個值。漏參數、抄錯參數這類啟動事故,從「上線後才發現怪怪的」提前到「起不來並告訴你原因」。
Metal 端的改善針對一個很具體的形態:沒有 MTP 頭(Multi-Token Prediction,一次猜多個後續文字單位的草稿機制)的 Nemotron 模型,每路串流是一列式的單行解碼,舊版在 Metal 上這些串流不共用回合,兩個、四個客戶端只能輪流上。1.2.9 讓這類串流共用同一個回合,每路的驗證視窗維持一列,不加草稿、不加複本,種子抽取仍按位置對齊,所以回覆內容理論上不變。
作者在 M5 Ultra、Nemotron 3.5 Lightning(MLX affine 4-bit)上量測,合計吞吐變化如下(token 是模型切分文字的單位,不等於一個中文字):
| 同時串流數 | 貪婪取樣 | 固定種子取樣 |
|---|---|---|
| 1 路 | -0.02% | -0.29% |
| 2 路 | +20.3% | +18.8% |
| 4 路 | +77.4% | +72.8% |
| 8 路 | +147% | +133% |
| 24 路 | +253% | +219% |
發布說明把 8 路與 24 路換算成 2.3 到 2.5 倍、3.2 到 3.5 倍的口徑。作者也說明了為什麼 8 與 24 路要另外驗:超過 16 列之後核心會換一種拼塊形狀,行為不同,值得單獨確認。正確性方面,每格的 token 雜湊相等,131,072 個 token 零差異,量測順序固定為基準版與新版交錯(base-new-new-base)以消掉機器狀態漂移。這些都是作者端的測量,我沒有重跑;但表格把「單路不變、路數越多幅度越大」的形態說得很誠實,合計吞吐(一段時間的總產出)與單一使用者感受到的等待時間,本來就是兩件事。
CUDA 端的 GLM-5.3-Flash 改善集中在很長的輸入。三台 GB10(DGX Spark 的核心晶片)以 TP=3(張量平行,把模型運算拆到多卡)跑 131,072 到 2,000,000 token 的提示,第一個 token 提前 0.6% 到 13.7% 出現;兩台 TP=2 在 1,000,000 token 時提前 6.7%。量測把 GPU 時脈鎖在 2,000 MHz,每格是兩次冷啟動取樣的平均,絕對時間不能拿去跟別人 2,200 MHz 的數字比。同一份表格裡有變慢的格子:TP=2 在 32,768 token 且關閉提示快取時慢了 1.7%,4,096 token 慢 0.5%。發布說明的摘要收在「短提示約正負 2% 內」,對照合併記錄才看得出這句話收納了哪些變慢的格子。另外,在 1,040,384 token 的提示之後,1、4、8 路的解碼回合分別縮短 5.05%、9.36%、11.36%;Nemotron 3.5 每層抽取動作的 CUDA 核心啟動次數,從約 112 次降到 15 次,核心啟動次數的節省對低延遲互動場景通常比峰值吞吐更有感。
HIP 端的對象是 gfx1151(AMD RDNA 3.5 內建顯示晶片,Strix Halo 這類)跑 Qwen3.8-Flash-Next:單路約快 6%(作者量到 code +6.2%、chat +5.8%),四路 2.8% 到 4.6%。這組數字裡同樣有一格倒退:兩路貪婪取樣的合計吞吐慢 0.9%,作者在記錄裡寫明原因還沒查出。同一張卡上,單獨服務時 MTP 草稿鏈的信心下限從 0.3 提高到 0.8,其他 HIP 卡維持 0.3,–mtp-confidence 仍可覆蓋;這個下限只決定草稿鏈送幾個猜測,回覆不變。
把三組數字放在一起看,結論很樸素:每一組都有硬體、模型、並行數與輸入長度的前提,升級前先找到自己那格,找不到就當成沒有改善,也不要把不同後端各自最好的數字拼成一張表。
這版有六項預設值變更,官方把它們的影響分了三類。前三項承諾回覆不變:GLM 在 CUDA 上的 TF_GLM_INDEX_CUDA 核心與 TF_GLM_DSEL 預設開啟;Flash Next 在 CUDA 上抽樣繪製預設批次化(TF_FLASHNEXT_BATCH_DRAWS=0 可退回逐路);Strix Halo 類單卡服務時 MTP 信心下限升到 0.8。
第四項會實際改變提示詞,對輸出敏感的流程要單獨驗證:–reasoning-effort 旗標不再改動「關閉思考」請求的提示詞。修正前的行為是個 bug:關閉思考時,請求自己指定的推理強度沒有進模板,GLM 還是拿預設的 Max 標頭,提示詞差了幾個 token。修正後,請求自帶的強度會進模板,伺服器層的旗標不會;回覆裡的 tensorfold.reasoning_effort 也改為回報模板實際拿到的值。
後兩項把失敗變成具名拒絕:把影片送給不支援影片的模型,從 500 內部錯誤改成 400(invalid_request_error),/v1/models 也會列出每個模型的 input_types;CUDA 發布版伺服器在啟動時就按名字拒絕沒有對應核心的 GPU。這兩項與錯誤修正放在一起看更完整:Nemotron Omni 在 CUDA 上一次失敗的圖片請求不再把殘留狀態帶進下一個回覆;GLM 在 TP=3 下超過約 100 token 的 prompt_logprobs 不再卡住。其他還有 logprobs 支援工具呼叫與 Responses API、回覆標注保留為文字的工具呼叫(tensorfold.kept_tool_calls 加兩個計數器)、串流可選攜帶已提交流的 token 編號,以及 Linux 上用 PSI(記憶體壓力資訊介面)驅動的選配記憶體調節器。
適合現在升級的三種人:一台機器同時服務多個代理或多位使用者(吃合計吞吐)、依賴明確錯誤碼做整合(400 與具名拒絕)、想把啟動參數收進版本控制的團隊。可以再等等的人:單人互動使用而期待變快的(單路幾乎不變);用 Ollama 的 tools、images 或 mirostat 這類用法的客戶端(會收到拒絕);Windows 使用者(這版沒有對應的發布資產,平台是 Linux aarch64、x86_64 與 macOS arm64,另有 darwin-arm64 的 Metal 引擎包;三個平台主包各附 SHA256 與簽章檔,Metal 引擎包除外)。
升級後的驗收建議分三輪:先固定一個模型與一條路由,重播相同短輸入,核對文字、欄位與串流行為;再用同一份設定加並行請求,每路用可辨認的內容,把回覆與錯誤都存下來;再補一個「失敗後接續」的案例,確認被拒絕的請求不會把殘留狀態帶到下一個回覆。量時間時把啟動、首 token、整段完成分開記,合計吞吐與單次等待一起看,才知道多開代理之後是服務更有效率,還是某個工作等更久。
還沒定案的部分也值得記住。三項底層工程(CUDA 影像路徑、dots.mocr 視覺核心、HIP 的雙主機 TCP 織網)官方自己標注還沒有服務模型在用;Living Weights v2 控制器列為實驗性質,這些今天的升級者都碰不到;效能數字全部是作者端測量,本站只驗了介面與設定行為。專案倉庫目前約 2,275 顆星、525 個 fork、600 多個未解 issue,發布當天仍有程式碼推進,是個活著但被大量需求追著跑的年輕專案;發布資產的三個平台主包各附 SHA256 與簽章檔,要驗真偽有現成材料。這個專案 13 天發 8 版的節奏意味著預設值可能再動,把這篇的數字當成 1.2.9 的快照就好,下一個版本發布時值得回查一次。如果你要找的是 Ollama 本體的動態,它先前的語音生成更新我們另有一篇;想在 12GB 顯卡上跑大模型的讀者,也可以參考Strata 跑 DeepSeek V4.1 Flash 的硬體帳。