TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

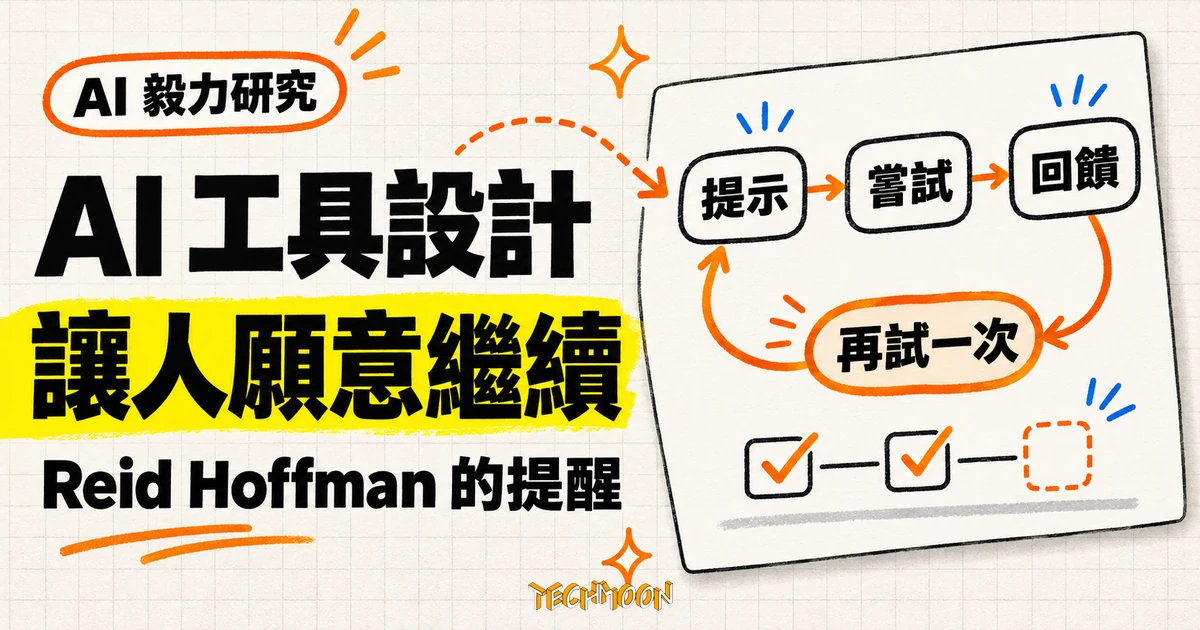
Reid Hoffman 在 2026 年 10 月 21 日上架的 Possible 節目回應一篇 1,222 人的 AI 毅力研究:跳題率的傷害集中在直接取答案的用法,他沒有停在少用 AI,而是把問題轉向工具設計。本文核對節目逐字稿與論文第六版的三個實驗數據、五處出入與證據邊界。
用 AI 摘要這篇文章:
Possible 節目在 2026 年 10 月 21 日上架,這一集裡主持人 Aria Finger 把一份剛修訂完的研究端到共同主持人、LinkedIn 共同創辦人 Reid Hoffman 面前:隨機試驗顯示,AI 協助會讓人在失去 AI 之後更容易放棄難題。Hoffman 沒有順著勸大家少用的方向走。他把問題換成另一個:工具能不能被設計成讓人更願意堅持。
先釐清事件與研究本體的時間關係。這則新聞的事件是 10 月 21 日那一集,同一天 Hoffman 的官方 YouTube 頻道放出約 26 分鐘完整影片。被討論的論文《AI Assistance Reduces Persistence and Hurts Independent Performance》早在 2026 年 4 月 6 日就首次上傳 arXiv,10 月 13 日更新到第六版,作者群來自卡內基美濃大學、UC 柏克萊、牛津、MIT 與 UCLA 五個機構。該留意這則新聞的,是日常用聊天模型做推理與文字工作、以及設計這類產品的人;本來就少用者,它暫時沒有提供需要行動的訊息。

Aria 引述版本如下:1,200 人隨機試驗,來自 CMU、牛津、MIT 與 UCLA,只要 10 分鐘 AI 使用就侵蝕毅力,移除之後人們放棄難題頻率約兩倍,而且作者把它稱為 cognitive debt(認知債)。她還說,這是眾多討論裡第一個確立因果關係而非相關的研究。
對照論文第六版,這段話有五個地方需要校準。參與者總數 1,222 人。作者機構有五所,節目上漏了 UC 柏克萊。效果出現在 10 到 15 分鐘任務階段之後,並非精確 10 分鐘。「放棄頻率約兩倍」只貼合第一個實驗數字。至於 cognitive debt 這個詞,它在論文裡只出現在參考文獻清單,是另一篇腦電與寫作研究的標題;這份論文從頭到尾沒用它命名任何發現。
這些差距都算不上錯誤,而是口語傳播難免壓縮。但每一段壓縮都會改變結論強度,想在團隊或文章裡引用它的人,值得回到原文核對。
整套設計可以一句話講完:參與者先做學習階段題目(一部分人隨機分派到可用 AI 條件組),測驗階段所有人都得收起 AI 獨立作答,研究者統計解題率與跳題率,把「選擇跳過題目」當成還願不願意投入的行為指標。三個實驗都招募美國 Prolific 平台使用者,總數 1,222 人,單一實驗報酬介於 2.6 到 3.4 美元。Aria「第一個確立因果」的說法,根基也在這裡:隨機分派發生在「有沒有 AI 可用」這一層,所以可用性對後續表現的因果效果可以被乾淨估計;至於使用者拿到它之後怎麼用,那是自己選的,屬於另一層。
值得先記住學習階段結果:有助理的人答對更多、跳過更少。當下幫助是真的,量到的是幫助消失後的代價。也要先定義清楚「放棄」在這裡的意思:跳題率統計參與者選擇不作答、直接略過的比例,與答錯是兩回事;它被當成持續投入的行為代理指標,本身就帶著解釋彈性。
第一個實驗用分數數學題,剔除未通過基本能力篩選者後,分析樣本 305 人。測驗階段:學習時有助理的人平均解題率 57%,對照組 74%,差距達統計顯著;跳題率是 20% 對 11%,同樣顯著。Aria「約兩倍」之說就從這裡來,20 除以 11 約 1.8 倍。作者也自承這個實驗一個潛在混淆:剔除標準沒處理「能力不足但靠助理答對」的人,實驗組可能因此留下較多低能力參與者。這個疑點正是第二個實驗要處理的對象。
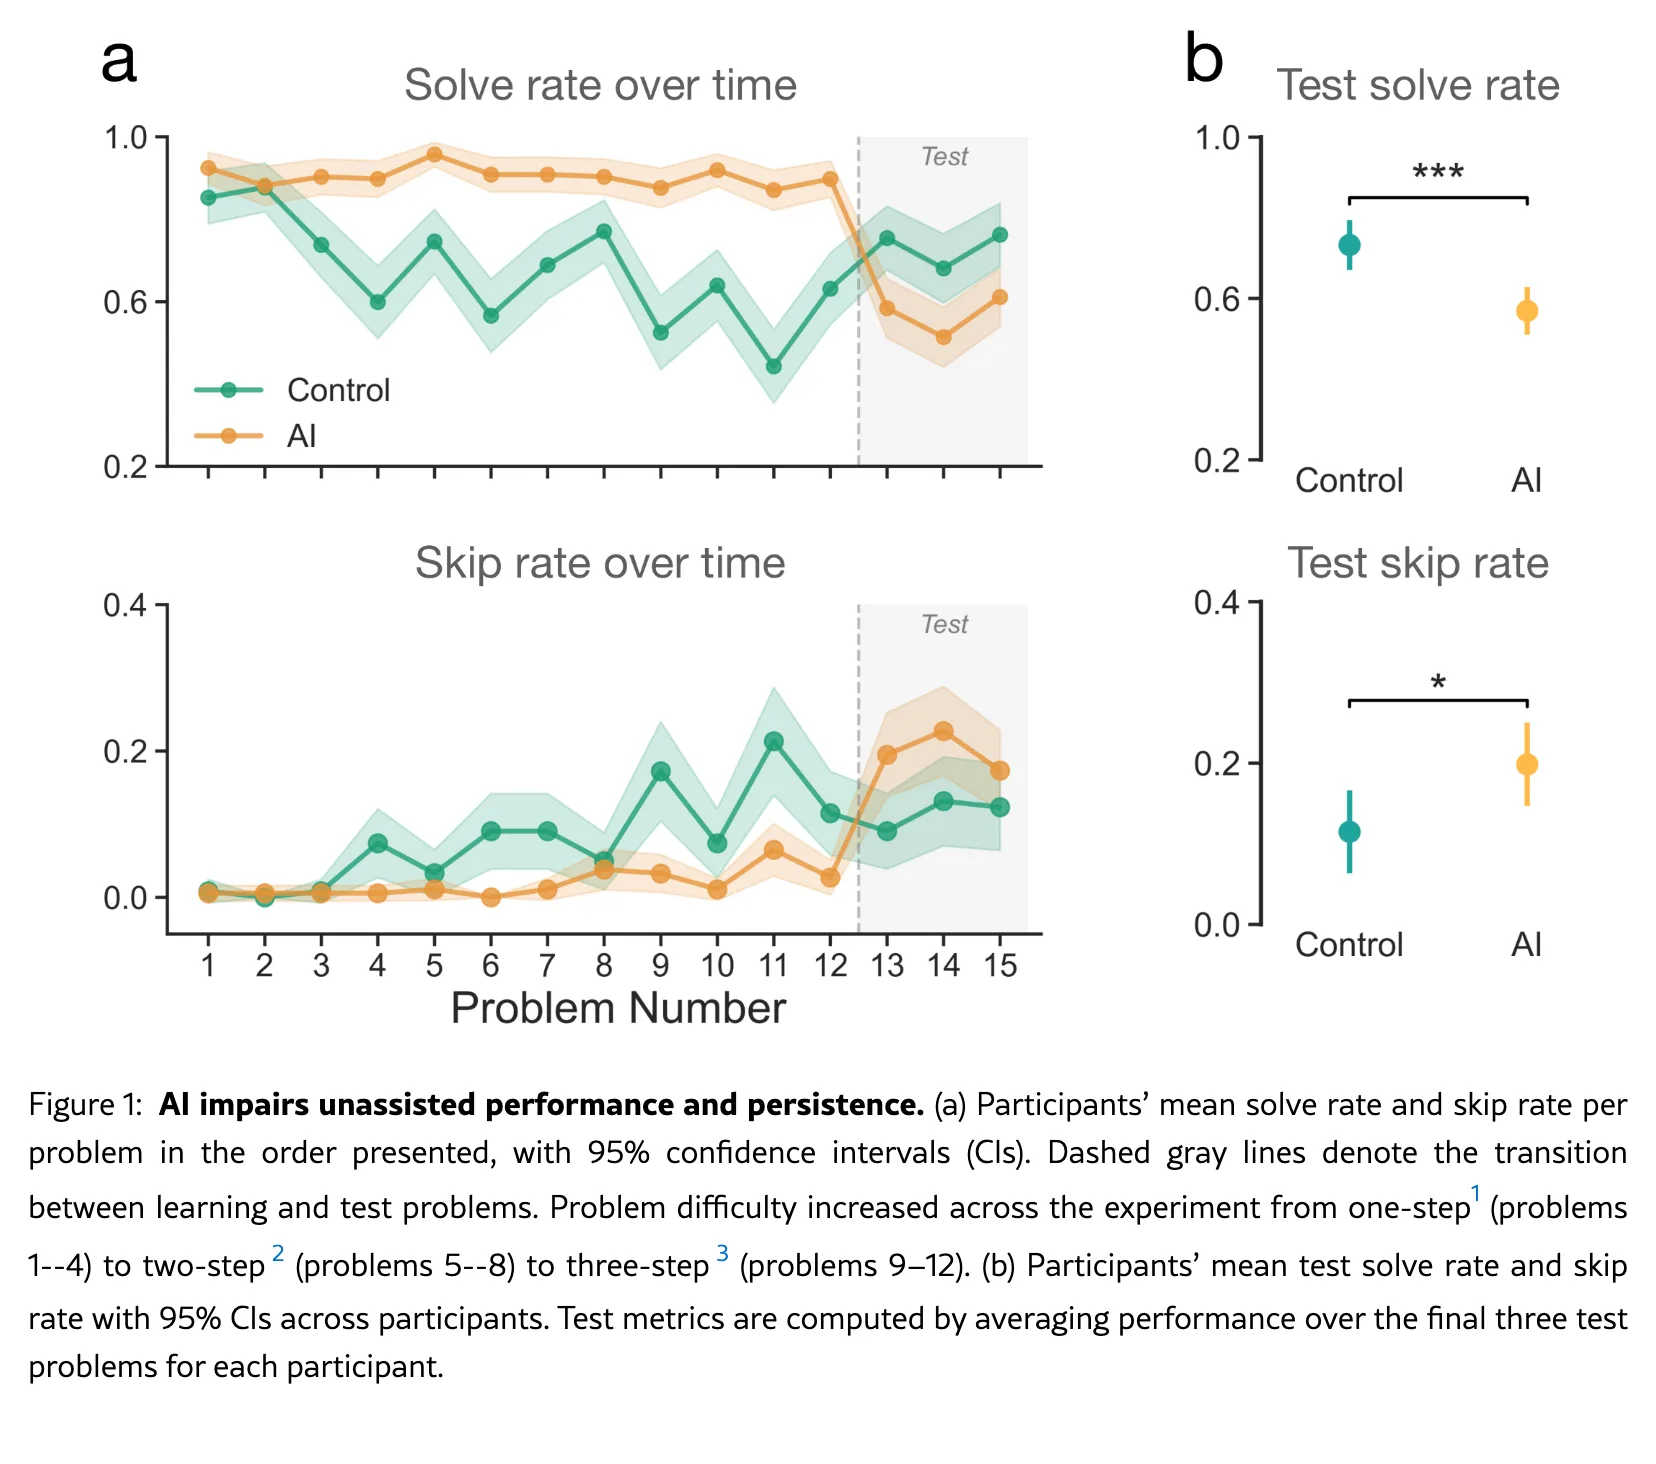
第二個實驗擴大到 667 人,加入前測階段來排除初始能力差異,把混淆一項項收緊。結果也支持這層設計:兩組前測的解題與跳題表現沒有顯著差異,等於帶著相近起點進入實驗。結果解題率差距仍然顯著(71% 對 77%),但跳題率 10% 對 7%,未達統計顯著。換句話說,三個實驗裡樣本最大、設計最乾淨的一個,「更容易放棄」這項行為證據反而沒有站穩。
第三個實驗換成閱讀理解題,分析樣本 168 人。解題率 76% 對 89% 顯著;跳題率 8% 對 1% 也顯著,但兩邊的絕對值都很低,控制組幾乎沒有人跳題。
三個實驗並列,可以得到比「AI 傷毅力」更準確的讀法:解題率下降在三個實驗都顯著且方向一致,跳題率則是一份幅度大、一份未達顯著、一份顯著但基數極低。論文作者自己也寫了但書,提醒不要把這些結果擴大解讀成全面降低毅力與獨立能力的證據;而且所有測量都只發生在 10 到 15 分鐘階段結束後的當下,長期使用會產生什麼變化,論文明說沒有回答。
全文最有內容的一段,是對「怎麼用」做拆解。研究者在第二個實驗裡,依照參與者實際的使用方式分組觀察:直接要助理給答案的人,測驗階段跳題率 13%;對照組 7%;要 AI 給提示、引導理解者最低,只有 5%,甚至比全程沒有 AI 的對照組略低。解題率也是直接取答案的組別墊底,平均 65%。
也就是說,傷害最集中處,是「把 AI 當答案產生器」的用法。不過這段分析有一個必須記住的性質:這些分組是研究者看完互動紀錄後歸類的,不是事先分派;怎麼用是參與者自己選的,隨機化只發生在「有沒有助理」這一層。所以它是相關證據,能指出方向,不能證明只要改成要提示就一定免疫。
把「怎麼用」放進視野之後,單純爭論「要不要用」就顯得太粗。這正好接到 Hoffman 的回應。
Aria 提問前先鋪了路。她提到常見批評是認知卸載(cognitive offloading),也預先回了「計算機出現後我們也不再心算兩位數乘法」這類類比,然後把問題收窄成一個取捨:AI 讓人更有能力,會不會同時讓人少了咬牙撐下去的勁。
Hoffman 的回應從接受證據分量開始。他說研究者「可能真的發現了一個問題」,沒有迴避統計結果,接著把話題導向產品:如果挑戰存在,重點就在於怎麼塑造 AI,「應該把 AI 塑造成能夠增進毅力的工具」。
他隨即畫出一條很多人沒畫的界線。他舉例:只有腳踏車時,他願意騎一小時進城;有了汽車後,某天車不在,他就不去了,等車修好再說。在他看來這不算毅力出了問題。真正的毅力問題,是大腦不再運轉、不再想讓自己變好。工具暫時不在而選擇等待,與根本不想動腦,是兩種不同狀態,前者判斷甚至可能是對的。
他再把毅力放回判斷力脈絡:智慧的一部分,正是判斷哪些問題值得堅持、哪些該放下去做別的事、哪些該找人討論、哪些確實超出自己能力範圍。盲目撐在不會成功的難題上,並不是美德。他也重複過去說法,把 AI 稱為認知外骨骼(cognitive exoskeleton):外骨骼讓人發現自己能做更多事,於是更有興趣去做。他以學習為例:有無限耐心的家教,人反而想學更多原本覺得太難的東西。節目尾聲他補了一個比喻:沒看過電視的人第一次看到電視會著迷;問題在與它相處之後,毅力會變成什麼樣子,而這正是 AI 設計該回答的問題。
同一集裡 Aria 也補了一個方向一致的故事:數學家 George Dantzig 在 1939 年把黑板上兩道其實是未解難題的題目,當成遲交的作業帶回家解開了,因為他不知道「不該堅持」。她隨即反問:若 AI 能反過來增加人的毅力,會多出多少個解開難題的人。這個故事在流傳中已有傳說成分,她自己也這麼標註,引用時保留這個但書。
Hoffman 的「塑造 AI」聽起來像願景,但其結論就指向同一個方向:AI 開發應該把長期能力的鷹架(scaffolding)與當下完成任務放在同一個優先順序。論文開頭其實把對比寫得很直白:好導師搭鷹架、追蹤進度,把對方成長放在立即結果前面,不會只給答案;現在的 AI 系統則被描述成短視合作者,被優化成即時吐出完整回應、從不說不。研究對傷害來源的假設也建立在這裡:助理讓人習慣期待立即答案,也就拿走了親自熬過卡關的經驗。而且這個方向已經有隨機試驗的先例。論文引用 Bastani 等人研究發現,高中生用 GPT-4 做數學練習,之後無輔助表現變差;採用鷹架式家教設計的條件組,傷害獲得部分緩解。這是轉述自論文文獻回顧,原始研究場景在教學,不宜直接推廣到所有工具類型。課堂端的隨機試驗結果其實也是混合的:Gemini 走進英國課堂的輔導試驗追平真人教師,標準化測驗卻未見優勢。
動機這一端也有獨立證據。2025 年 4 月 29 日發表在《Scientific Reports》的另一份研究做了四項線上實驗、總計 3,562 人,任務涵蓋報告寫作、點子腦力激盪與問題解決。它發現與生成式 AI 協作能提升當下產出品質,但提升並未延續到後續獨立作業;協作結束、轉回獨力工作時,參與者內在動機顯著下降、無聊感上升,四項實驗裡反而只有控制感上升。這份研究量自述感受,跳題那份量行為;兩種指標從不同側面指向同一方向,共通短版也相同:都在短時間任務裡測量。這也與 Addy Osmani 談代理時代如何保留批判性思考時的擔憂相接:產出變快與理解變深,本來就是兩回事。
多數讀者的答案是不用立刻動。證據邊界(短任務、立即反應、跳題指標)還支撐不起「全面少用 AI」結論,論文作者與 Hoffman 在這點上意外一致。
若想做小檢查,可以觀察一個具體行為:當 AI 給不出可用答案時,自己會換方法、找資料、換問題,還是只反覆用不同句話重問。舉工程面例子:AI 給的修正方案編譯仍失敗,下一步是回頭讀錯誤訊息、縮小問題範圍,還是把同段描述再貼一次等它重擲答案。前者接近論文裡跳題率最低使用型態,後者接近傷害最集中型態。這個檢查不必裝工具、不必改流程,只需要在下次卡住時留意自己的下一個動作。
對設計產品的人,可操作訊號是使用模式資料:直接給答案與引導理解兩種介面,關聯到的後續行為不同。但要誠實面對其性質:那是相關證據,不是因果保證;寫進產品決策時,應該連這個但書一起寫進去。
有三件事目前沒有答案。長期使用 AI 對毅力與獨立表現的影響,三個實驗都沒有觸及;提示式用法能不能防止傷害,需要隨機分派的後續研究;Aria 說這份研究已在 COLM 會議發表;這一點在 arXiv 頁面與論文內文都查無紀錄,只能以節目說法視之。Hoffman「把工具設計成讓人願意繼續」目前是方向而非結論,等更多像 Bastani 那樣的隨機試驗補上證據。
本文時間基準是 2026 年 11 月 8 日,事件(節目上架)為 2026 年 10 月 21 日。若預印本再推出修訂版或正式會議版,後續數字以 arXiv 最新版本為準。在證據補齊前,這份研究最穩用法,是把它當成一個提醒:工具的下一步建議與自己的下一步判斷,值得分開保存。這也與 Lex Fridman 談 AI 時代數學證明與理解的結論遙遙相呼應。