TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

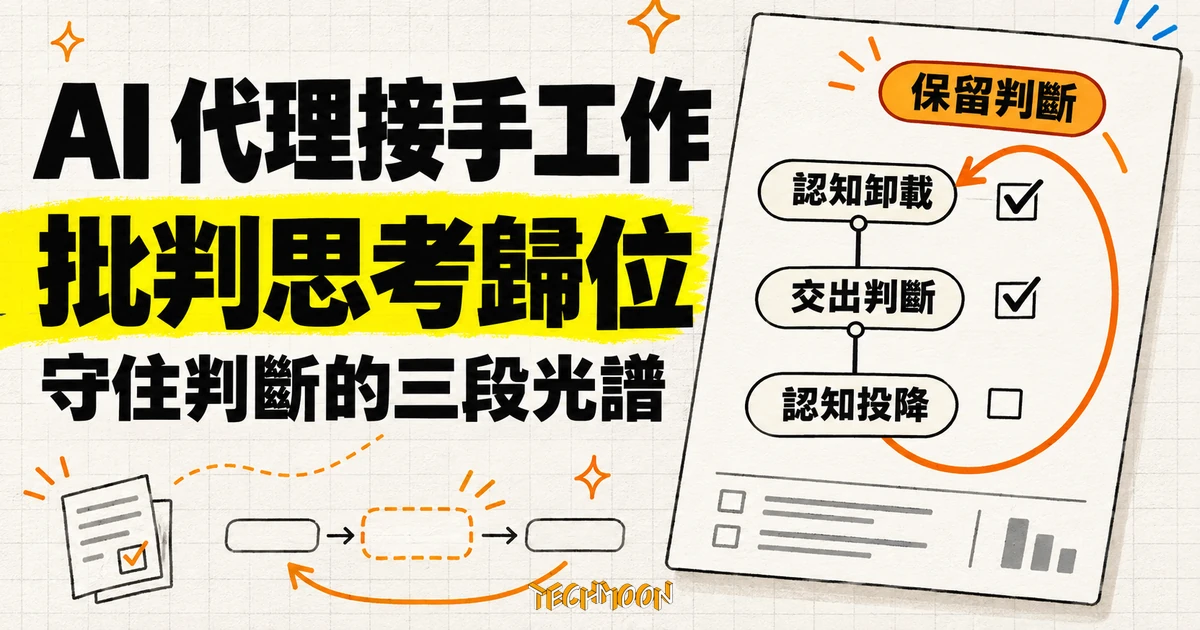
在 Anthropic 參與 Claude Code 開發的 Addy Osmani,11 月 3 日在 X 發表長文《Critical thinking when agents do the work》,把人與代理的關係畫成認知卸載、交出判斷到認知投降的三段光譜;他引用的監督悖論出自 Anthropic 對 132 位自家工程師的調查:監督 Claude 所需的技能,正是過度使用會萎縮的技能。
用 AI 摘要這篇文章:
11 月 3 日下午 3 點(台北時間),Addy Osmani 在 X 發表長文《Critical thinking when agents do the work》,談代理接手工作之後,批判性思考要放在哪裡。到 11 月 5 日凌晨,這篇長文累積超過一萬六千個讚、近五百則留言。Osmani 這個名字對網頁開發者並不陌生:他的個人網站自述,他目前在 Anthropic 任 Member of Technical Staff、參與 Claude Code 開發,更早之前在 Google 待了超過十四年,帶過 Chrome 的開發者體驗,最後職務是 Google Cloud AI 的 Director。
這篇長文值得台灣讀者花時間讀的原因有兩個。其一,它把散落在半年文章裡的概念收成一條線:從認知卸載到認知投降的光譜、交辦前的假設、驗收時的證據,每一環都有出處可以追溯。其二,發言位置很少見:提醒你監督能力會萎縮的人,正是在做代理工具的公司裡寫代理工具的人,而且他引用的證據是雇主對自家工程師的調查。
長文的核心主張一句話可以說完:過去,批判性思考是被工作本身逼出來的;代理把工作接走之後,那個逼迫消失了,所以思考要自己排進流程裡。他在文首寫得很直接:批判性思考過去被教成帶著謙遜的好奇與健康的懷疑去接近新資訊,這仍然成立,但「我的日常裡已經幾乎沒有什麼會強迫我做批判性思考,因為我的大部分工作都經過代理」。
立場需要先講清楚:Osmani 不是反對代理的人。他在文中明言自己是代理式工作流程的重度使用者,要講的是判斷力現在必須被主動安排、不會自己長出來,並沒有要人重拾手工作業。
Osmani 用一段三階段的光譜描述人與代理的關係。光譜的起點是認知卸載(cognitive offloading):把工作交出去,但對結果的判斷還在自己手上。中段是交出判斷(deferral):工具的輸出直接成為你的輸入,結果不再是待檢驗的假設。末端是認知投降(cognitive surrender):代理的輸出悄悄變成你自己的結論,你不再覺得需要檢查。
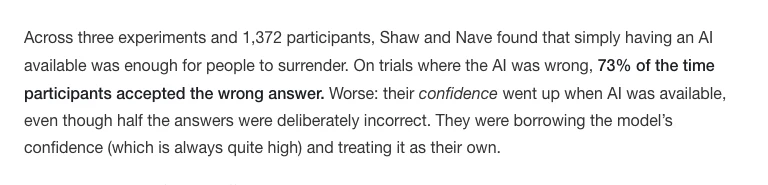
「認知投降」不是他發明的詞。他在文中註明,這個詞出自賓州大學華頓商學院 Steven Shaw 與 Gideon Nave 的研究,兩人 2026 年在 SSRN 發表論文,題名 Thinking, Fast, Slow, and Artificial,副標講的就是人工智慧如何重塑人類推理、帶來認知投降。Osmani 今年 5 月曾為這項研究寫過專文,其中引述研究設計:三個實驗、1,372 位參與者;AI 在場時,即使答案有一半是刻意做錯的,參與者仍在 73% 的錯誤試次裡直接接受錯誤答案,而且信心不降反升。他把這種現象稱為借來的信心:模型的自信被拿來當成自己的自信。
光譜往下走,代價會從個人擴散到團隊。Osmani 引用學者 Margaret-Anne Storey 的觀察:這種流失在團隊裡會表現為對系統的共享理解逐漸侵蝕;他也轉引 Jeremy Twei 提出的理解負債(comprehension debt):程式產生的速度與人真正理解它的程度之間,缺口會像技術債一樣累積。個人層面叫認知投降,團隊層面叫理解負債,講的是同一件事的兩種規模。
界線要畫在哪裡?Osmani 給了自己的例子。他會把「在三間評價相近的旅館裡挑一間錄課地點」交給代理,因為那種決定錯了代價很低;但他不交出投資決定、孩子的職涯方向、要做什麼產品、會影響使用者的變更、能不能安全出貨。他的原則是:「在出錯代價低的地方接受交付,在別人要承擔後果的地方保留自己的推理。」
他也在長文裡替代理說了公道話:注意力可以交給代理守。他自己參與的開源專案收到大量 pull request,讓代理先做初篩,人類的注意力才能留在真正需要判斷的地方。問題從來不是代理能不能用,而是判斷留在哪一端。
這篇長文裡最有分量的引用,來自他自己公司。Anthropic 在 2025 年 12 月 2 日發布內部研究《How AI is transforming work at Anthropic》:調查在 2025 年 8 月進行,對象是 132 位自家工程師與研究員,另外完成 53 場深度訪談,並分析內部 Claude Code 的使用資料。報告裡有一段被 Osmani 直接引用:「有效使用 Claude 需要監督,而監督 Claude 所需要的,正是可能因為過度使用 AI 而萎縮的程式技能。」報告把這個處境稱為監督悖論(paradox of supervision)。
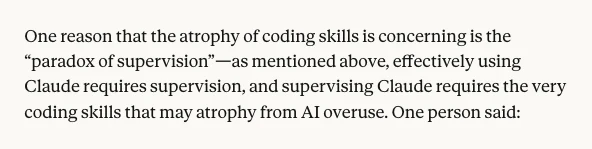
這段話的出處,讓長文的張力變得很具體:寫長文的人在 Anthropic 做 Claude Code,他引用的是自己公司對自家工程師的調查。代理商業模式的賣方,先承認了監督能力會在大量使用中萎縮。對正在擴大代理編制的企業讀者來說,這份調查比任何外部評論都值得讀一遍;Anthropic 先前也建議企業逐個收編多餘的子代理、先架好評測再談擴編,方向與這份調查一致。同一家的就業研究則顯示招募重心正轉向判斷力:初階新聘占比掉到 9%,能監督、能下判斷的人變貴了。讀者若在評估把代理接進工作流,Anthropic 夥伴生態怎麼用承諾額度跨工具採購,也值得對照。
Anthropic 的 Claude Code 團隊把同一件事寫成了審查規則。團隊 10 月 15 日在 claude.dev 發表《How the Claude Code team does code review》,其中一條是:「如果你說不出這些檢查會漏掉什麼,就要求一次真正的審查,而不是匆匆放行。」Osmani 在長文裡補了實務面的觀察:瓶頸已經從寫程式移到確認自己是對的,而測試可能跟功能帶著同一個錯誤一起過關。他給的對應動作很簡單:「當檢查變綠,先問它證明了什麼,再問它沒有證明什麼。」他的隊友還有一個務實的折衷:與其要求自己隨時保有完整心智模型,不如按需重建理解,要動哪個環節,就請 Claude 把那一段講一遍。
長文中段是一串可以在下次交辦前直接用的自問,Osmani 列了六個,其中五個值得留在手邊:
交辦文件那一側,他用了意圖負債(intent debt)的概念:目標、限制與決策理由如果只存在你腦裡,接手的人就找不到,缺口會一路累積。這個詞出自他 6 月的專文《The Intent Debt》。他的建議是把期待寫成一份短說明,涵蓋讀者是誰、什麼不在這次範圍、做到什麼程度算完成。長文裡還有一句容易被略過的提醒:你的提示就是你對問題理解的鏡子,寫不清楚交辦單,通常表示你自己還沒想清楚問題。他引哲學家 Andy Clark 對「委派」與「協作」的區分:把 AI 當協作者,互動會放大彼此的理解;當成委派對象,理解就只往一個方向流。
還有一個反向技巧:與其自己憑空寫交辦單,不如讓代理先來訪談你,把目標與限制問出來再開工;也要留意輸入端:代理之間若只傳遞摘要,傳到後面時接手的代理可能早已沒讀過原始文件。
Osmani 把驗收階段的風險稱為驗證投降:「有沒有支持我結論的證據」這個問題,會慢慢變成「檢查是不是綠的」。他的解法是把完成的定義弄得很具體:測試通過、有截圖、有 log 或 trace,三者至少居一,而且要在事前就定好,不是事後再看。
他有幾個寫進長文的習慣。看彙總之前,先看代理執行過的指令與輸出原文;讀一份長的修改稿時,先請代理列出它做的決定與假設,然後拿這份清單考自己,答得上來才算讀完。他舉的例子是一份六百行的 pull request:與其從頭滑到尾假裝看過,不如讓代理先說明每個決定,再由維護者抽問,問不倒才算審過。他也會讓另一個代理在乾淨的脈絡裡自我批評,問它「有沒有漏掉什麼」,並引用同事 Boris Cherny 的提醒:給 Claude 一個能驗證自己工作的方法。
這一側還有他自己 5 月提出的編排稅(orchestration tax):代理產出的東西,與你願意掛名背書的東西之間,有一段必須自己消化的差距。長文裡語氣最重的一句就是它的後果:「當你產出的東西多到你背書不完,你就不是在審查,你是在期望它別出事。」他對成品的門檻也一樣直接:就算 AI 讓產出變快了,只要他不願意把成品掛上自己的名字,就不該送出去。
維持練習的建議同樣具體:一週挑一天不帶代理寫一段程式;一個月寫下一次自己停掉了哪些事;對自己問一句「如果 AI 不存在,我會有多迷失」。他甚至建議把檢查時間當成行事曆上的獨立項目,避免用剩下的時間順手做。
把引用攤開看,這篇長文是 Osmani 半年概念線的收束,而且每個術語都有自己的出處:
| 概念 | 提出者 | 出處與時間 |
|---|---|---|
| 認知投降(cognitive surrender) | Steven Shaw、Gideon Nave | 華頓商學院研究,2026 年 SSRN 論文 |
| 理解負債(comprehension debt) | Jeremy Twei | 長文轉引 |
| 編排稅(orchestration tax) | Addy Osmani | 個人部落格,2026 年 5 月 24 日 |
| 意圖負債(intent debt) | Addy Osmani | 個人部落格,2026 年 6 月 5 日 |
| 監督悖論(paradox of supervision) | Anthropic | 內部調查報告,2025 年 12 月 2 日 |
他自己 5 月的《Cognitive Surrender》專文,比這篇長文更早把華頓研究講完;這次的新增內容,主要是光譜的整理、六個自問,以及把自己前後幾個概念接在同一條線上。發表一天半累積的一萬六千多個讚,也說明這組概念在開發者社群踩到了共同的痛處:代理越用越多,共識卻還很分散,這篇長文剛好給了大家一套共同的詞彙。還有一個發表位置的細節:截至 11 月 5 日,這篇長文只發在 X 的文章功能,Osmani 的部落格最新一篇仍停在 9 月中旬;X 的文章可以被作者事後編輯,引用時值得留意。
這套整理屬於個人實務觀察,長文沒有提供採用率或前後對照的量化結果;華頓研究證明的是認知投降會發生,並沒有證明這六個自問能防止它。Anthropic 的調查也有邊界:132 人的樣本全部來自同一家公司的工程與研究部門,生產力相關數字屬於自我報告,報告本身在附註裡也承認這個限制。方向有初級證據支撐,具體做法的效果,目前只有作者的經驗背書。
概念本身沒有地域限制,中文工作環境一體適用。如果要挑一個最低成本的起點,長文結尾的建議大概最容易:交辦之前,先寫下你認為會發生什麼;代理完成之後,寫下一件它沒有檢查的事。這兩行字不會讓代理變聰明,但它們會把判斷留在你這一端。