TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

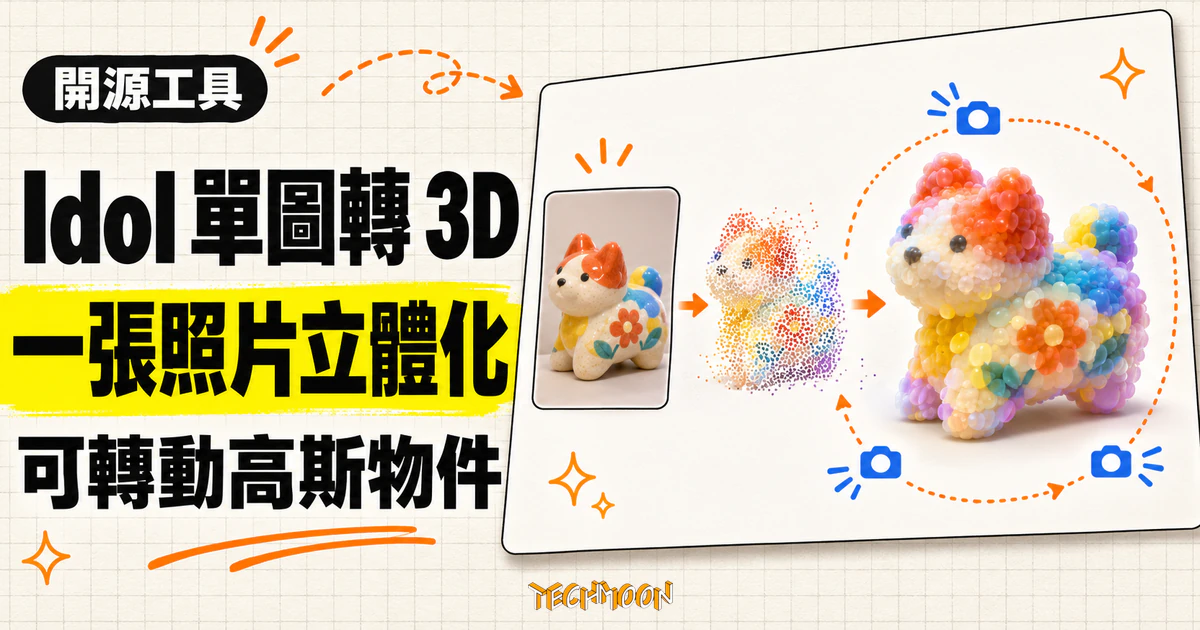
Speridlabs 於 2026 年 10 月 28 日開源 Idol:一張照片轉出可轉動的 3D Gaussian splat 物件,權重與 SDK 採 Apache-2.0 免費下載。官方文件拆開看,600M 是生成本體、完整流程約 18 億參數、7.2GB 是峰值顯示卡記憶體,而「3 秒生成」在唯一載明條件的測時表裡,最快是資料中心卡的 3.4 秒,消費級 RTX 4090 要 19.1 秒;兩個必要編碼器也是要先申請的 gated 模型。
用 AI 摘要這篇文章:
2026 年 10 月 28 日(UTC),舊金山與馬德里兩地辦公的 Speridlabs 公開了 Idol,一個把單張圖片變成 3D 物件的開放模型。當天下午 3 點 55 分,Hugging Face 上的權重庫先建立;十分鐘後展示用的 demo 上線;晚上 GitHub 的 SDK 倉庫跟著開張,程式碼在隔天補齊。換算台北時間,這一輪發布動作落在 10 月 28 日深夜到 10 月 29 日凌晨之間。
它做的事情一句話講完:給它一張物件照片、一張渲染圖,或另一個影像生成模型的輸出,它交回一個副檔名 .ply 的 3D Gaussian splat 檔案,放進支援的檢視器就能轉著看,連照片裡沒拍到的背面與側面也一併生成了出來。權重、推理 SDK 和 demo 三件全部免費開放,授權都是 Apache-2.0。
單圖轉 3D 這條路上已經有閉源服務,也有先前的開源模型;Idol 這次把三件事湊在同一個包裹裡:直接輸出 splat 格式(部分同類管線交的是網格或需要多階段轉換)、權重完整下載、峰值顯示卡記憶體壓在 8GB 以下。對架不起高階工作站的人,這個組合是新的取用條件。受影響的族群也很好畫線:手上有 NVIDIA 顯示卡、平常就寫 Python 的人,拿到兩份存取權當天就能上手;沒有對應硬體的人,走 demo 或雲端,本體開放與否暫時不影響你。
不過發布宣傳裡的三個數字,「只有 600M 參數」「用少於 7.2GB 的顯示卡記憶體」「3 秒生成百萬個 splat」,在官方文件裡各自對應更精確、條件也更窄的版本。把它們拆開看,你才能判斷自己的顯示卡夠不夠、單張要等多久、跑之前得先接受哪些條款,以及轉出來的檔案不能拿去做什麼。
官方快速開始指南的順序值得照著讀一遍,因為第一個動作不是複製程式碼。
Idol 讀圖要靠兩個別家的模型:Meta 的 DINOv3 負責把影像編碼成特徵,FLUX.2 的 VAE 負責影像與壓縮特徵之間的轉換。這兩個模型庫在 Hugging Face 上都設了存取閘門,而且等級不同:DINOv3 要送出申請、等人工審核;FLUX.2-dev 是登入帳號按下同意就通過。還沒申請通過的話,這兩個庫的權重檔案一個都拿不到。Idol 的處理方式是在下載任何東西之前先停下來,明確告訴你缺哪個授權,免得下載到一半才失敗,這個設計省掉不少摸黑的時間。
過了這一關,剩下是例行公事:clone idol-sdk 倉庫、pip install -e .,環境條件是 Python 3.10 以上、PyTorch 2.5 以上、一張支援 CUDA 的 NVIDIA 顯示卡。Mac 和純 CPU 的機器不在官方支援範圍裡。注意力計算有兩條路:裝了 flash-attn 就用它,沒裝就退回 PyTorch 內建的注意力,官方說兩者結果相同、後者較慢,想指定可以用環境變數切換。第一次執行時,Idol 自己的權重(約 3GB,含打包在裡面的去背模型)和兩個編碼器會自動抓進本機快取,不用另外找檔案。
生成指令一行:python -m idol.sample --image photo.jpg --mode real。每次執行交出三個檔案:.ply 是成品;_input.png 是去背、裁切之後模型真正看到的那張圖;_camera.json 記錄它為輸入猜測的相機角度。第二個檔案比想像中有用,官方對它的定義就一句話:去背與裁切之後,模型真正看到的那張圖。如果生成的物件缺了一截把手,回頭看 _input.png,就能分辨是把手本來就被裁掉了,還是模型沒把它生出來。
輸入要選對模式。synthetic 模式給渲染圖和生成圖,物件會被裁得貼近畫面邊緣(大約佔滿畫面的 1/1.2);real 模式給實拍照,四周留白多一點(約 1/1.7)。模式選錯,模型看到的構圖就和你想給它的不一樣,結果好壞會差一截。研究頁還展示了一條更省事的串法:先讓影像生成模型 Iris-3B 照提示詞畫一張圖,再把那張圖直接餵給 Idol 做成物件,從一句話到能轉的 3D 中間不用人工修圖。
帳號這關有兩種過法:在終端機跑 hf auth login,或設定 HF_TOKEN 環境變數,兩者擇一,官方文件都寫在快速開始的第一段。
等不及裝環境的人,官方在 Hugging Face 上掛了 demo Space,內建九十多個範例圖可以直接跑,也接受上傳自己的圖片,先看看成品長什麼樣再決定要不要本地部署;研究頁的展示廊同樣每件都附一個「Open 3D」連結,點開就能拖著轉,不必先裝任何東西。
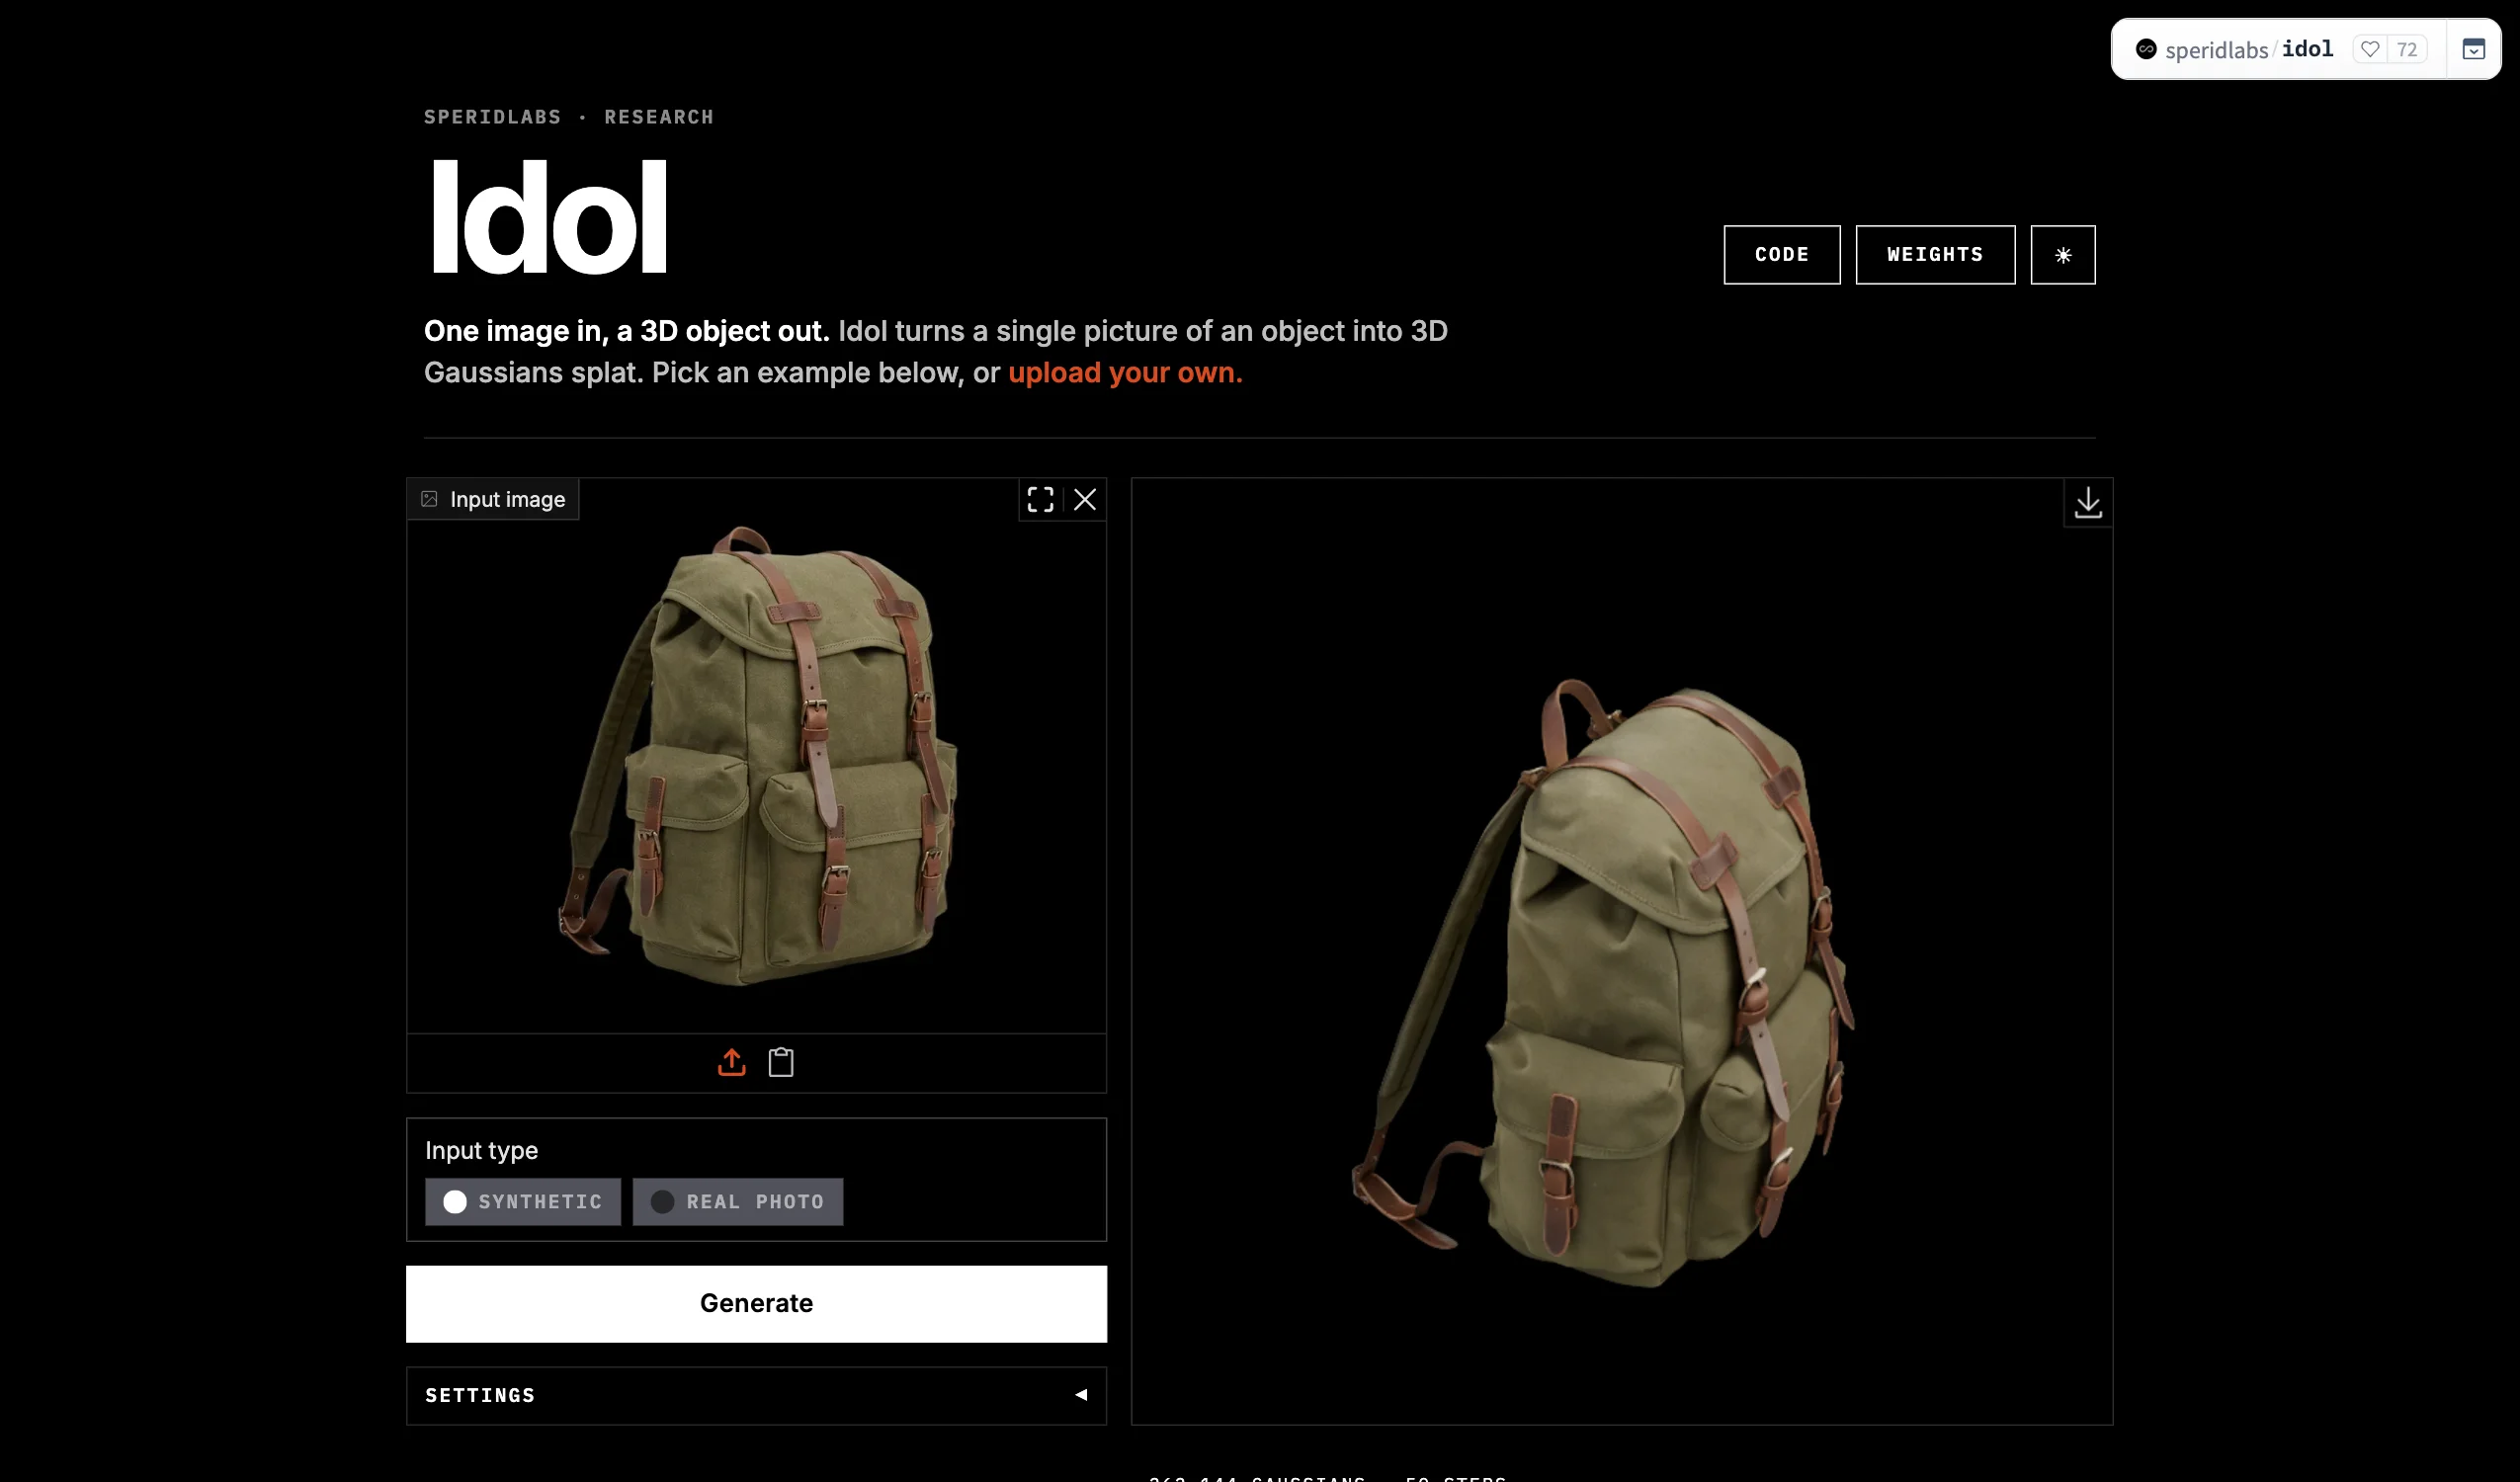
到這裡可以整理出三條取用路徑,適合三種人:只想看看效果的,開 demo Space 上傳一張圖,幾分鐘有答案;有 NVIDIA 顯示卡、想把生成包進自己流程的,走 SDK 本地部署,一張圖的邊際成本是電費;連顯示卡都沒有但要批次產出的,fal 的雲端版按張計費。三條路 outputs 都是同一個模型,差別在誰出算力、誰保管圖片。
發布貼文寫「只有 600M 參數」,研究頁寫 0.66B,模型卡的元件表則把這個數字的內涵攤開:
| 元件 | 參數量 | 角色 |
|---|---|---|
| 去噪擴散變換器(DiT) | 370.6M | 生成的核心 |
| 八元樹解碼器 | 50.8M | 決定 Gaussians 的分佈 |
| Gaussian 解碼器 | 237.3M | 輸出最終的 3D Gaussians |
三項合計 658.7M,這是 Speridlabs 自己訓練的生成本體,0.66B 指的就是它;600M 是把六億五千八百七十萬再往下取整的說法。同一個數字在三份官方文件裡有三種寫法:發布貼文寫 600M,研究頁寫 0.66B,模型卡給到小數點一位的元件明細。精度往文件深處遞增,這幾乎是模型發布的通則,讀數字的時候值得多點進一層。
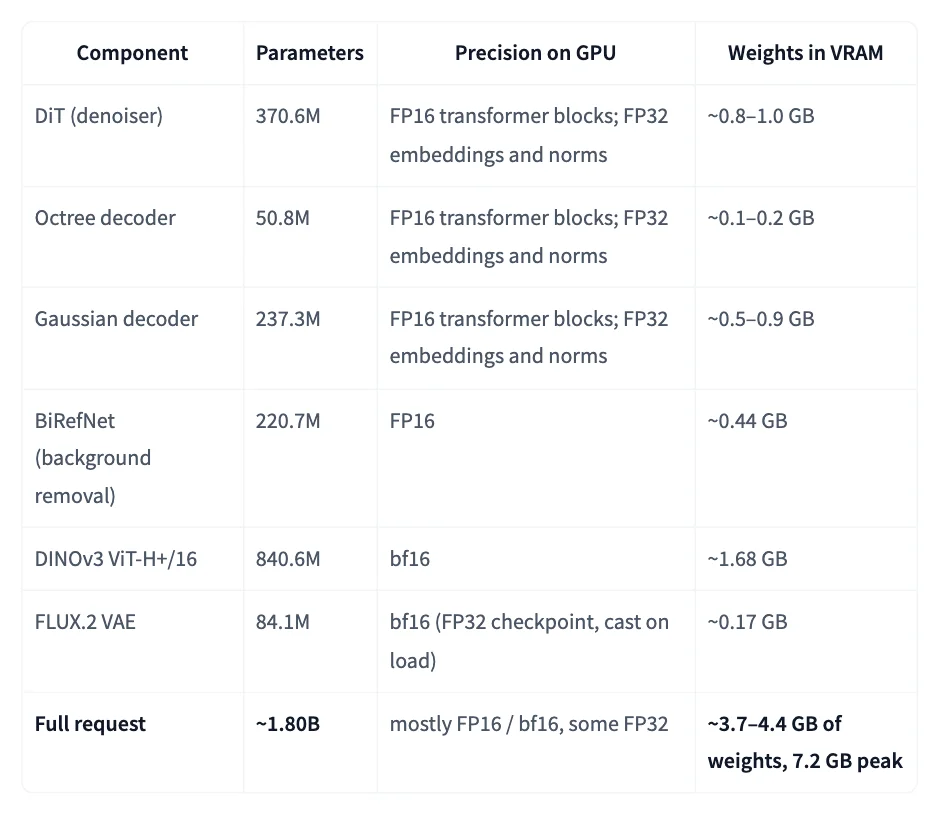
但一次完整的請求,本體之外還有三個既有模型要一起跑:DINOv3(840.6M)做影像編碼、FLUX.2 的 VAE(84.1M)做特徵轉換、BiRefNet(220.7M)做去背。整條鏈合計約 18 億參數,是本體的 2.7 倍左右。「小模型」的印象只對了一半,挑硬體時更不能拿 600M 當依據。
顯示卡記憶體同樣要分三層看:模型權重本身佔約 3.7 到 4.4GB;一次完整請求的峰值是 7.2GB;而官方測試表裡 B300 旁邊標的 269GB、RTX 4090 旁邊標的 24GB,是那張卡的容量,不是每次請求的需求量。判斷自己的卡能不能跑,看的是 7.2GB 這個峰值,官方自己的說法是「8GB 以下就能跑」。另外參數量也不能直接換算成記憶體用量,精度(FP16、bf16 加上部分 FP32)和運算過程的暫存都會改變實際佔用;把 DINOv3 編碼器切成全精度 FP32 執行的選項存在,代價是再多 1.7GB。
其他可調項也值得認識:--seed 固定種子可以重現同一顆物件;--cfg_strength 是物件跟隨輸入圖的強度;--rescale_t 控制步數花在整體輪廓還是細節的比例;--no_optimize 可以關掉加速取樣。要寫進自己的程式,官方也給了 Python 介面,從 IdolPipeline.from_pretrained("speridlabs/idol") 載入後一行呼叫,Gaussians 數量、模式、種子都當參數傳。
發布貼文說「3 秒生成 1M 個 splat」,模型卡的簡介寫「2 秒內」。這兩句話都沒有附量測條件。官方文件裡條件寫得最完整的一組測時是另一組數字:50 個採樣步驟、輸出 262,144 個 Gaussians(預設值,不是百萬)、8 張輸入取中位數、每台機器一張卡、程式與設定全部相同。
| 顯示卡 | 卡上記憶體 | 單張請求時間 |
|---|---|---|
| B300 | 269GB | 3.4 秒 |
| B200 | 179GB | 3.6 秒 |
| H200 | 140GB | 6.6 秒 |
| H100 | 80GB | 6.7 秒 |
| RTX 5090 | 32GB | 14.1 秒 |
| A100 | 80GB | 16.3 秒 |
| L40S | 45GB | 16.6 秒 |
| RTX 4090 | 24GB | 19.1 秒 |
| RTX 3080 | 10GB | 46.2 秒 |
| L4 | 22GB | 54.6 秒 |
在這組條件下,最快的 3.4 秒出自資料中心等級的 B300。買得到的消費級顯示卡裡,RTX 5090 要 14.1 秒,RTX 4090 要 19.1 秒,RTX 3080 得等上 46 秒。這些是官方量測後公布的數字,量的是這組輸入的中央值,不代表每張圖都會落在那裡。換算成工作量比較具體:一批 100 張商品照,用 4090 大約 32 分鐘,用 5090 大約 24 分鐘,這才是拿宣傳句「3 秒」去乘數量會嚴重失真的地方。
那「3 秒」和「2 秒內」從哪裡來?模型卡的參數表給了線索:採樣步數預設 50,「減少會更快,但會損失部分細節」。換句話說,降低步數確實可能把時間壓進個位數秒,但那已經離開 50 步的量測條件,表格連同它的品質證據都不能跟著搬過去。宣傳句省略的正是這個但書。
第一次執行還有兩段帳要另外算:約 3GB 的權重下載,以及 GPU 取樣路徑的編譯,官方明說第一張圖會比較慢。預設開啟的加速取樣(核心編譯、引導與非引導兩段合併成一批、注意力改走 cuDNN)官方量到的加速幅度約 1.7 倍,表格裡的成績已經是加速後的。把這些條件擺在一起,「3 秒」可以當成行銷上限來聽,排工作時還是拿自己那張卡對應的秒數來算,兩者不衝突。
研究頁給了一張四模型對照(單張 H100、各模型用自己的設定)。指標分兩組:輸入視角一組量的是「轉回原角度像不像」(PSNR、SSIM、LPIPS、IoU),七個新視角一組量的是「沒看過的角度畫得對不對」(DINOv2、CLIP、銳利度距離)。Idol 請求時間 6.8 秒,從 SSIM 到銳利度距離的六項指標都排第一;TripoSplat 同設定 9.9 秒,TRELLIS 7.1 秒,LGM 最快只要 1.1 秒。
這張表最有教育意義的一格是 LGM。它最快,輸入視角的 PSNR 也最高(12.46,Idol 是 12.25,TripoSplat 11.76,TRELLIS 11.89),但官方加了星號註記:結果「看起來明顯模糊」,因為 PSNR 平均的是逐像素的平方誤差,一份平穩但糊掉的輸出可以在這個指標上贏過細節豐富的輸出。LGM 預設只輸出 65,536 個 Gaussians,是 Idol 預設值的四分之一。挑模型的時候這格值得記住:先確認指標量的東西跟你在乎的外觀是不是同一回事,再看排名。
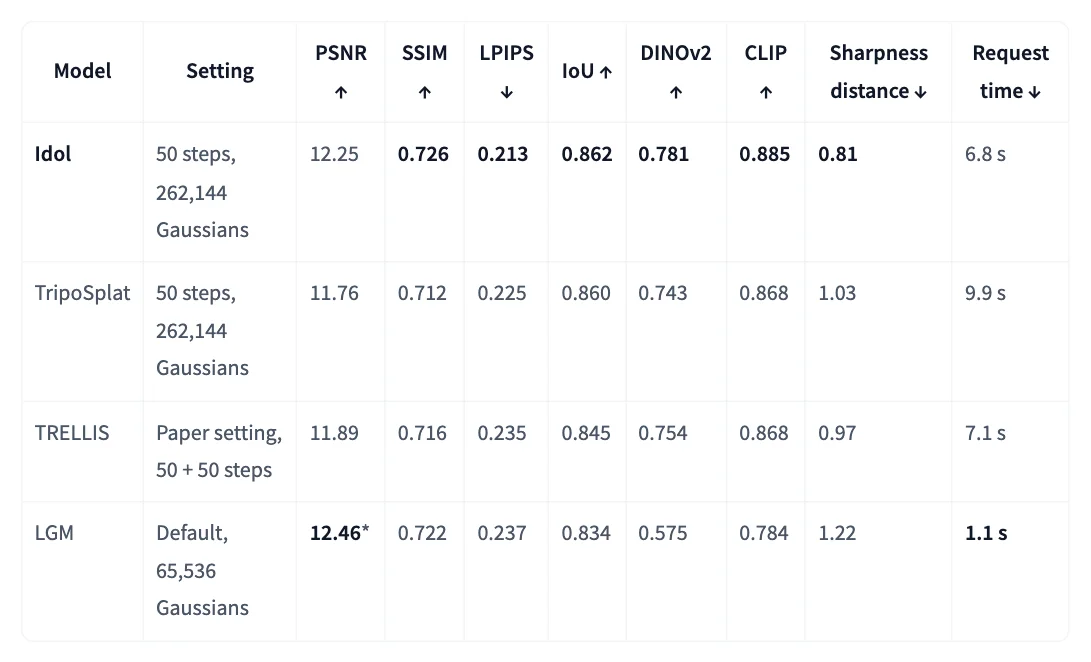
TRELLIS 是同一條路線上的前輩,TechMoon 先前介紹過它把圖片轉 3D 的開源做法。這次官方對照表把各模型使用的設定(步數、輸出密度)一一列在表內,比較時這些條件要一起看,跨設定的成績不能直接相減。
Idol 本體的授權很乾淨:權重庫和 SDK 都掛 Apache-2.0,去背模型 BiRefNet 的權重直接包在 Idol 的下載裡(原始專案以 MIT 釋出)。真正要另外處理的是前面那兩個輸入編碼器:DINOv3 在 Hugging Face 上標示的是自訂的 dinov3-license,FLUX.2-dev 標示的是 flux-non-commercial-license,頁面自述這是「支援第三方研究與開發的非商業授權」。Idol 雖然只下載 FLUX.2 的 VAE 部分,存取條款照樣得先同意。
所以「Apache-2.0 開源」這幾個字覆蓋的是 Idol 本體;打算做商業部署的人,DINOv3 和 FLUX.2 這兩份條款要分開讀完再決定。這裡不是法律意見,只是提醒授權鏈比標籤複雜:一個名字掛 Apache-2.0,不等於推理路上每個零件都跟著同一份條款走。申請本身免費,等不等得到核准是另一回事,DINOv3 那一關的人工審核要等多久,官方沒有給承諾。
不想碰條款和顯示卡的人有第三條路:fal.ai 已經上架雲端版,每生成一張收 0.1 美元,輸出 .ply 之外還附一份 GLB 點雲預覽、前處理後的輸入圖和相機資訊,密度一樣能選。那份 GLB 可以直接丟進一般的 3D 檢視器,但 fal 標明它是點雲預覽,方便沒裝 splat 檢視器的人先看成果,拿到引擎裡用的網格還是要自己轉。成本換算很快:同樣一批 100 張,雲端是 10 美元,本地 4090 是半小時出頭的電費,量大的時候這筆帳會自己說話。下載權重免費和雲端服務免費是兩回事,價格是 fal 訂的。
.ply 這個副檔名容易造成誤會。3D Gaussian splat 檔案裝的不是網格,而是幾十萬個各自帶著位置、形狀、顏色與透明度的小斑點;可以把成品想成一片由色斑組成的薄霧,從正面看是實物,繞到側面,霧裡沒有斑點的地方就什麼都沒有。檢視器每次轉動視角,就用這些斑點即時合成畫面,速度快到可以拖著轉。這種表示法很適合展示,近期從單人物到整個場景的生成研究都在用它,例如讓生成的 3D 場景回頭看還能保持一致的研究,或讓數位人在手機上離線呈現的應用。但它不會因為看起來立體,就自動具備封閉的表面、可綁定的骨架,或符合尺寸公差的工程幾何。要餵給遊戲引擎做動畫、要 3D 列印,都還缺一段 splat 轉網格的後處理,這一步 Idol 不提供,轉換的損失也要自己驗。兩種格式各有各的位置:splat 檔案小、轉動順,天生適合網頁展示與提案;網格能編輯、能綁骨架、能進引擎,是工程交付的通用語。Idol 只站前一側。
單視角的限制更要放在桌上:背面與側面是模型生成的補全,不是量測出來的。一張照片沒拍到的標籤、花紋,轉過去看到的那一面是合理的猜測,官方文件用的動詞是生成,談不上重建。要交付「與實物一致」的 3D 模型,需要更多角度的照片或實際量測,這個工具補不了那些證據。
輸出密度是個可調的旋鈕:32,768 到 1,048,576 個 Gaussians,預設 262,144,必須是 32 的倍數。它控制的是表示的細密度,不是真實度,把猜測出來的背面用一百萬個斑點畫得更細,它仍然是猜測。官方用燈、武士、樹屋三件物件做密度對照:32,768 個 Gaussians 約 0.4MB,262,144 個約 3.2MB,1,048,576 個約 12.2MB。密度的選擇應該跟著觀看情境走:畫面只會在商品列表的小卡片裡旋轉,觀看距離遠、卡片小,最密的設定未必看得出差異,卻讓每個頁面多背好幾 MB;鏡頭會貼到物件邊緣、或在大型展示牆上放大的場合,薄邊、曲面輪廓這些細節才會現形,多出來的密度才開始有意義。官方網站放了同一顆物件在兩種密度下的對照,可以放大比較再決定。
適合先接的人:做商品展示、提案視覺、需要快速取得多視角外觀的創作者與設計團隊。硬體門檻按官方數字是一張 8GB 級 VRAM 的 NVIDIA 顯示卡(官方測試裡最小的卡是 10GB 的 RTX 3080),等得起單張十幾秒到幾十秒的生成,輸出用在展示與溝通場景剛好。還有一個不常被講的加分:權重抓進本機快取之後,生成就在自己的 GPU 上跑,輸入圖不必再交給誰的雲端;對商品照、未上市設計圖這類不想外流的素材,本地部署本身就是功能。判斷標準很簡單:你要的是「看起來就像」的多視角外觀,還是「量得出來」的幾何,前者 Idol 現在就能上工。
再等等的人:需要可編輯網格或骨架的動畫管線、需要尺寸精度的工程與列印用途,還有 Mac 和純 CPU 環境的使用者。SDK 的 issue 追蹤區已經有人問了 Apple Silicon 支援,也有人提出讓編碼器可以從本地資料夾載入(等於把最後一段對 Hugging Face 的依賴也拿掉,方便私有部署),兩個都還沒有官方回應。
這個模型的作者是 Speridlabs 的兩人小組:計畫主持人 Alejandro Cañada 與 Chema Garabito,公司自我定位在空間智慧,官網上的說法是「語言有了大型語言模型,視覺還沒有對應的幾何基礎模型」,Idol 是研究頁目前主打的最新釋出。
發布五天後的社區數字,截至 11 月 3 日:GitHub 上 615 顆星、49 次 fork;Hugging Face 權重庫近一個月 7,787 次下載、408 個讚。這些量的是關注度,量不出品質。
還沒確認的事集中在三件:訓練資料的組成與規模沒有揭露,研究頁只給了引用格式,沒有正式論文;「3 秒」與「2 秒內」的量測條件官方沒有寫下來;SDK 還在 0.1.0 版,長期維護節奏未知。對應的觀察動作也簡單:模型卡哪天補上測時條件,宣傳句就能對回表格;Apple Silicon 與本地編碼器兩個 issue 有官方回應,取用面積會再放大一圈;版本號開始跳動,維護承諾才算有第一個證據。兩週後回來看這三件事,比現在猜測有用。權重就在那裡不會跑,晚一點採用,代價只是兩週的嘗鮮。