TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

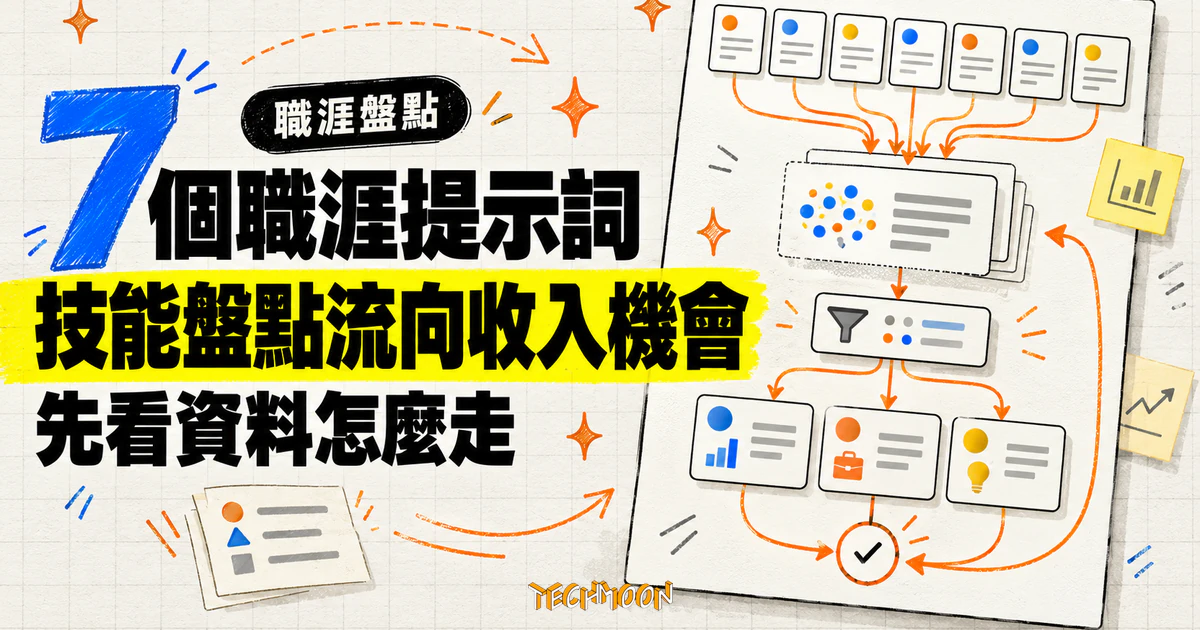
2026 年 7 月一位 X 使用者把七個職涯盤點提示詞分享上網,三個月累積超過 124 萬次觀看。本文核對九則推文原文與 OpenAI 說明頁,整理七個提示詞實際在問什麼、個人方案預設可用內容訓練的資料流向與退出設定,以及 AI 收入答案該由誰驗證。
用 AI 摘要這篇文章:
2026 年 7 月 29 日傍晚,X 使用者 Priyank Ahuja 貼出一段開場白:「我把薪資和職涯經歷給了 ChatGPT,它讓我看到自己原來坐著一堆沒發現的收入機會。」(I gave ChatGPT my salary and career history. It showed me income opportunities I didn’t know I was sitting on.)他在同一串推文裡附上七個提示詞。到 10 月底查證時,開場推文已累積超過 124 萬次觀看。
這串提示詞值得看,但值得看的原因和那句開場白不一樣。它真正做的事,是把「我到底會什麼、還能靠什麼多賺一份錢」這種想不清楚的問題,拆成七個 AI 接得住的具體提問,從盤點技能一路排到 90 天行動計畫。它的目標讀者也明確:有一份全職工作、想弄清楚下一步的人,而不是已經有明確副業方向的人。至於 AI 的答案算不算數,推文沒有處理,這篇文章會處理。
接下來回答三個問題,答案都對照過九則推文的原文與 OpenAI 兩份關於資料使用的說明文件:七個提示詞實際在問什麼、把薪資貼進對話之前該知道的資料去向,以及 AI 給出的收入數字該由誰驗證。
七個提示詞各有名字,原文都是英文,以下用忠實中譯說明每個實際在做什麼。和常見的提示詞收藏庫比起來,這七個的價值在於先後順序被設計過:七題共用同一份輸入,也就是你的經歷自述,順序把發散的盤點收斂成具體行動。
使用前要準備的輸入只有一份:你對自己工作經歷的描述。建議先在別處寫好再整段貼上,因為後面幾個提示詞的回答會引用你前面給過的條件,中途換說法或漏掉背景,答案品質會先掉一半。要寫什麼,從提示詞的用語就能推回來:職涯經歷、工作經驗、目前技能、背景與時程,這些就足以啟動整套盤點。
Find My Hidden Skills(找出隱藏技能)。 你先貼上自己的職涯經歷,AI 被要求從裡面找出十項你最被低估、但最有價值的技能(identify the 10 most valuable skills I’m underestimating),並逐一說明為什麼有價值、誰會付費、AI 能怎麼幫你變現。它是整串的起點:先交代你做過什麼,再談你能做什麼。
Find Income Opportunities(找出收入機會)。 這個提示詞要求 AI 依據你的經歷,提出十種現實上可行的方式,每月額外賺進 1,000 到 3,000 美元,並附上啟動成本、時間投入、難度與收入潛力(include startup cost, time commitment, difficulty level, and earning potential)。注意那個金額是提示詞裡寫死的目標參數,並不是 AI 估出來的市場行情。
Monetize My Experience(把經歷變現)。 這個提示詞要 AI 擔任商業策略顧問(act as a business strategist),從你的工作史提出可販售的服務、諮詢、數位產品或接案機會。角色設定讓輸出從清單變成商業提案,但也讓 AI 更容易把假設講得像結論。值得注意的是它的範圍就四種形態:服務、諮詢、數位產品、接案,AI 是在這四個商業形態裡找組合,不會替你發明新的生意模式。
Find My Highest-Leverage Opportunity(找出最高槓桿的機會)。 前面幾個提示詞會給你一堆選項,這個只問一件事:如果得用我現有的技能、盡快幫我提高收入,你會先做哪一件、為什麼(what would you focus on first and why)。它是收斂器,把發散的清單壓回單一行動。
Show Me What Pays More(找出薪資更高的出路)。 要求 AI 依據經歷指出薪資明顯高於現職的職位、產業與機會,並說明我哪裡符合資格(explain what makes me qualified)。這題的答案最容易摻水:模型沒有你所在市場的即時薪資行情,它給的是訓練資料的統計印象,加上你自己的敘述。
Create an AI-Powered Side Hustle(設計 AI 輔助副業)。 要求提出五種 AI 能幫上忙、起步每週投入低於五小時的服務。每週五小時是第二個寫死的參數,提示詞並沒有要求 AI 回頭驗證五小時到底夠不夠用,這個假設要自己補測。
Build My 90-Day Plan(建立 90 天計畫)。 最後一個提示詞要求依據你的背景、時程與經歷,把整套盤點收成 90 天的逐步計畫,目標是職涯安全感與額外收入。整串到此收攏:盤點、選項、變現、收斂、排程。
整串看下來,有兩個寫死的參數值得停下來想。每月 1,000 到 3,000 美元是提示詞指定的目標,AI 接到指令後會圍繞這個數字組合選項,數字本身沒有經過任何市場驗證;每週五小時是另一個,它決定了副業清單的形狀,超過五小時的選項會被排除,但被留下的選項是否真的裝得進五小時,提示詞沒有要求檢查。用這串提示詞的人,等於先用兩個未驗證的假設框住了所有後續答案,這件事推文裡不會有人提醒你。
推文串的最後一則不是提示詞,而是作者的自我宣傳:追蹤我、轉推這串貼文。作者在 X 有約 13.5 萬名追蹤者,簡介自稱 AI 教育者並附上合作信箱。看提示詞之前先知道這個背景,判斷會更準:這是內容行銷的一部分,提示詞本身值不值得用,還是要回到它的結構來評。
到查證當天為止,開場推文有 1,241,282 次觀看、2,179 個讚、7,362 個書籤,另有 41 則回覆與 5 次引用。書籤是按讚的三倍以上,這個比例並不常見:會留下互動的人,多數不是按讚,而是把它存起來,打算之後照著做。也要留意觀看數是七月發文以來三個月的累積,單一時間點的快照看不出成長的節奏,數字之後也會繼續變動,查證時以推文頁面為準。
把熱傳還原成行為訊號,對讀者有兩個意義。一個訊號是,這串提示詞被當成工具收藏,被當成觀點討論的成分很低,回覆與引用的數字說明了這點。另一個訊號是,存起來不等於用過:七個提示詞要貼上你的真實經歷才會動作,而那個動作正是下一節要拆的問題。
七個提示詞的第一步都是貼上職涯經歷,通常包含職稱、年資、專案與薪資區間。在貼上去之前,OpenAI 的資料說明頁對這些內容的去向,寫得比推文清楚。
個人方案(Free、Plus、Pro)的預設是:OpenAI 可能用你的內容來訓練模型,說明頁原文寫得很直白(we may use your content to train our models)。不想被訓練有兩條路:在 ChatGPT 的 Settings 頁面裡的 Data controls 分頁關閉 Improve the model for everyone,或到 OpenAI 隱私入口網站選 Do not train on my content,兩者擇一即可,之後的新對話就不會用於訓練。
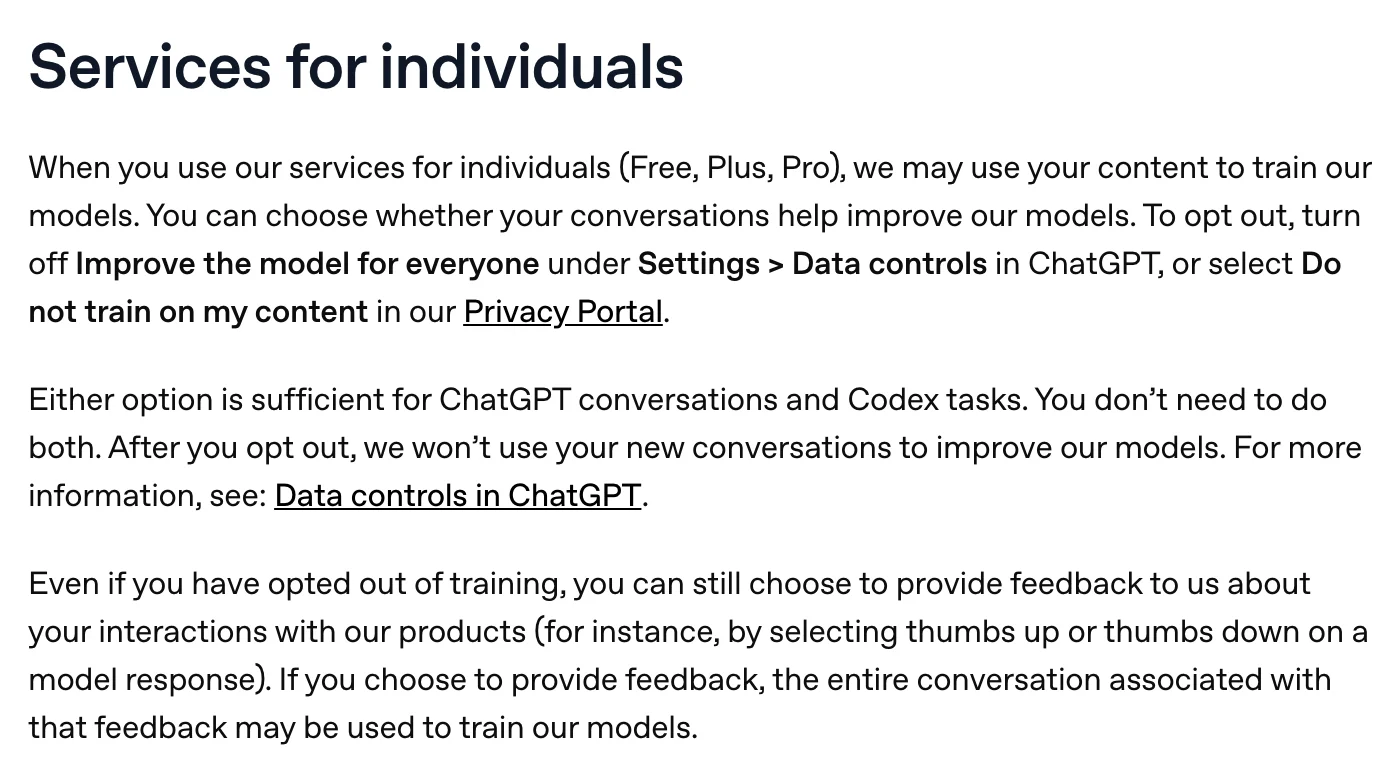
有一個例外容易漏掉:就算已經退出訓練,只要對某個回應按了讚或倒讚,整段相關對話仍可能被用來訓練模型。把薪資貼進對話的人,等於把這個開關留在那裡。
暫時聊天是另一個常被誤解的選項。它不會出現在聊天紀錄,也不會用於改善模型,但說明頁寫明 OpenAI 可能保留一份副本最多 30 天作安全用途;一旦把暫時聊天另存成一般對話,就回到帳號的一般設定。它不是消失模式。暫時聊天開始前也能選擇要不要個人化,個人化的暫時聊天仍可能用到記憶、自訂指令與外掛,不想把背景帶進去,就把個人化關掉再開始。至於一般聊天紀錄,手動清除後原則上 30 天內會從系統刪除,除非內容已先被去識別化並與帳號分離,或有安全與法律上的保留理由。
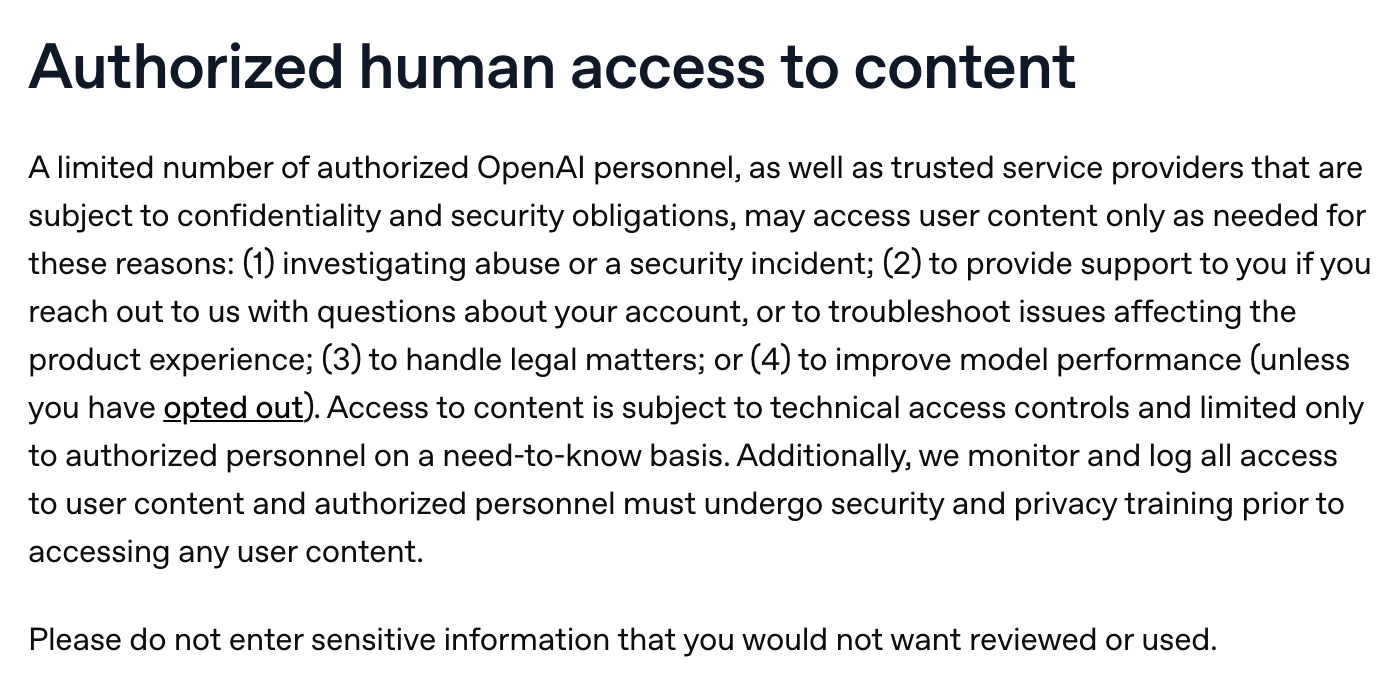
最有分量的提醒,出現在消費者服務說明頁:請不要輸入你不願被檢視或使用的敏感資訊(Please do not enter sensitive information that you would not want reviewed or used)。這句話的重點在劃分責任:官方說清楚了資料會去哪、哪些人基於哪些理由可以看,要不要把薪資數字放進去,決定權在使用者手裡。同頁也寫明,獲授權的人員基於調查濫用、帳號支援、法律事務與模型改善等理由可以存取內容,其中模型改善這一項在你退出訓練後就不適用。
方案不同,預設也不同。ChatGPT Business、Enterprise 與 Edu 工作區,以及 API 平台的內容,預設不用於改善模型。用公司帳號做職涯盤點,資料後果和用個人免費帳號不同,ChatGPT Work 與個人 Chat 的差異我們先前拆過,公司自己的資料規範也要另外確認。同一份說明頁也寫明,OpenAI 不會販售使用者資料、不會把對話內容分享給廣告商,內容儲存在 OpenAI 與其服務供應商位於美國及世界各地的系統。看得到邊界,才有得選擇。
開場推文最有煽動力的句子,是作者宣稱 AI 讓他看到自己坐著一堆沒發現的收入機會。整串九則推文裡,這句話之後沒有任何可核對的成果:沒有他做了什麼、花了多久、收入有沒有變化。讀者可以欣賞提示詞的結構,但不必把這句話當成效證據。
把七個提示詞拆開看,AI 實際能給的是三種東西:從你的自述整理出的技能清單、依統計印象組合出的收入選項、一份排程。它沒有的東西也一樣明確:你所在市場的即時行情、你所在地區的職缺結構、你的服務有沒有人願意付錢。提示詞要求的誰會付費與更高薪職位,在模型端都是推測,這也是把個資交給 AI 的提示詞熱傳時,我們同樣強調過的驗證責任問題。從動詞看更清楚:七個提示詞多數用的是 identify 與 suggest 這類字,AI 被要求從你給的材料裡辨認與建議,能不能辨認出你沒發現的東西,取決於你給的材料夠不夠細,而不取決於模型多聰明。
第五個提示詞是個好例子。它要求 AI 說明你哪裡符合更高薪職位的資格,但模型手上只有兩種材料:你自己的描述,加上訓練資料裡的統計印象。它寫出來的符合資格三個字,沒有對過任何一個真實職缺,也沒有對過任何一位招募人員的判斷。把它當成履歷調整的方向可以,把它當成錄取機率就是誤讀。
所以合理的用法,是把 AI 的輸出當待驗證假設。它點出一項你自認擅長的能力,就拿本地職缺平台上的真實描述比對,看雇主實際怎麼寫;它說某項服務有人會買,就把最小版本做出來,直接拿去問潛在客戶願不願意付費;它排出 90 天計畫,第一個月的指標就該放在接觸市場的次數,而不是收入數字。這些驗證動作 AI 都做不了,而它們才是這套方法的真實成本。
先去識別化再貼。職能、年資、專案類型與成果量級,通常足以讓 AI 做出有用的盤點;公司名稱、精確薪資、可識別到個人的專案名稱,可以先用代稱或區間取代。盤點的品質來自經歷的結構,不是來自可識別的細節。這裡有個對照值得寫清楚:開場白說把薪資交給 ChatGPT,但七個提示詞的原文,沒有任何一個要求提供目前的薪資數字;第五個提示詞問的是薪資明顯高於現職的職位,需要的是職級與經歷的描述,不是你現在領多少。把這兩件事分開,多數盤點其實不必把最敏感的數字交出去。
調整設定再開始。想降低對話進入訓練集的機會,先在設定裡關閉 Improve the model for everyone,或到隱私入口網站選 Do not train on my content,兩者擇一。若不打算留下紀錄,暫時聊天是折衷:對話不進帳號歷史、不用於改善模型,但官方仍可能保留副本至多 30 天作安全用途,它不是消失模式。要貼的內容涉及現職機密時,改用公司核可的工具或先取得同意,這不是個人帳號的設定能解決的問題。
把輸出當清單查證。對 AI 給的每個有人會付費與更高薪職位,至少配一個現實世界的核對動作:一份職缺描述、一份產業薪資報告、一次真實的客戶訪談。七個提示詞能產生的價值,取決於這一步有沒有做。
這串推文留著三個沒有答案的問題。作者宣稱的收入機會是什麼、後來有沒有變成真收入,推文串內沒有後續。七個提示詞在台灣職缺市場的適用性未經檢驗,美元金額與每週五小時的假設,對應到本地勞動市場都要重新校準。最後,觀看與書籤的累積數字會持續變動,這則推文後續會怎麼被傳播,從單一時間點的快照看不出來;若再出現大規模轉傳,數字以推文頁的即時顯示為準。
另外會隨時間改變的,是設定介面與方案組合。文中引用的設定路徑與方案清單,對應的是 2026 年 10 月的 OpenAI 說明頁,產品改版時這類細節會跟著調整,實際動手設定時,以當下的官方說明頁為準。
把這串提示詞拿來用的最低風險方式,其實和它的設計一致:挑一個你真的想不清楚的問題,貼上去識別化後的經歷,拿到 AI 的答案後,再拿一個現實世界的訊號去對它。AI 負責把你的經歷整理成結構,市場負責告訴你,結構裡哪一段是真的。