TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

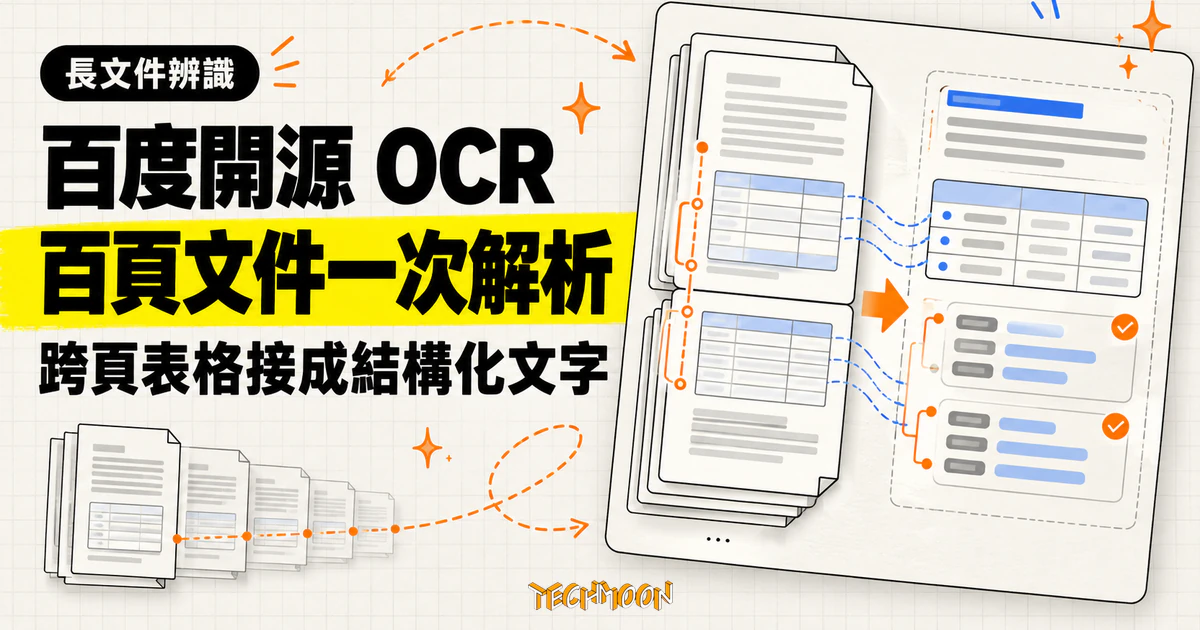
百度 10 月 27 日宣布開源文件辨識模型 Unlimited OCR 2,以 SR-SWA 稀疏注意力把每步解碼的工作參照固定住,前代的 40 頁輸入上限改寫為可調的部署參數,並同步發布百頁級評測集 MarathonDocBench。本文核對模型卡、技術報告與榜單,整理 MIT 授權分層、單頁場景分流與繁中驗收要點。
用 AI 摘要這篇文章:
一份兩百頁的掃描合約,最麻煩的環節從來不是把字讀出來,而是把讀出來的字放回正確的位置。表格從上一頁延伸到下一頁,第十二條的但書接在下一頁開頭,章節標題和正文隔了好幾張紙,每頁各自辨識正確,合併後的欄位照樣錯位,人工還是得翻回原稿核對。
百度在 10 月 27 日上午 10 時 41 分(台北時間)於官方 X 帳號宣布開源文件辨識模型 Unlimited OCR 2,模型權重前一天上午已先放上 Hugging Face,搶在貼文之前。模型權重與程式碼採 MIT 授權,規模約 33 億參數,負責的團隊署名為 Baidu ERNIE Team。同一波還發布了用來評測百頁文件的 MarathonDocBench 資料集。這次升級可以用一句話總結:把「文件可以多長」從模型的能力上限,移到部署時可調的參數欄位裡。
先把痛點說具體。採購清單第一頁留下品項與數量,小計和備註出現在第二頁;辨識系統若把每一頁當成互不相關的圖片,下一頁的數字就會被當成新表格,欄位對不上。法律文件也一樣,例外條款接在下一頁開頭,兩頁拆開存檔後,檢索系統查到的條文就少了限制條件。
這也是 OCR 與文件解析的分界:把圖片裡的字轉成可編輯文字,只是第一步;標題層級、欄位、表格與閱讀順序能不能正確重組,才決定下游能不能用。把掃描檔轉成 Markdown 餵給知識庫的流程(例如之前介紹過的 Zerox OCR),輸入端的段落一旦接錯,問答就會跟著錯。合約審閱、財報與年報數位化、標案文件整理、館藏檔案轉檔,這些場景的共同點是文件長、跨頁結構多、出錯的代價高。
逐頁辨識再加規則拼湊,是大多數既有流程的做法,優勢是單頁出錯容易定位、可以只重跑那一頁;代價是跨頁關係要靠標題比對或人工接回,文件越長,接回的成本越是線性上升。另一條路是讓模型一次讀完整份有序文件,直接在解碼時使用跨頁上下文,輸出裡為每一頁保留對應標記,事後能把結果逐頁對回原稿,百度的 Unlimited OCR 系列走的是這條路。
前代 Unlimited OCR 今年 6 月發布,同樣開源,採用 R-SWA(Reference Sliding Window Attention,參照滑動視窗注意力)維持恆定的 KV 快取,在 32K 的標準上下文長度內一次轉錄數十頁,Hugging Face 上的下載次數累積超過 330 萬,生態已經成形。論文裡對它的定位,是把 DeepSeek-OCR 的壓縮率與恆定 KV 快取結合,往長文件再推一步。
技術報告的評測表附註寫得直接:前代因為 40 頁的輸入限制,並未在百頁級基準上回報成績。報告也點出殘留問題:R-SWA 讓記憶體不再隨頁數膨脹,但解碼時注意力仍要計算所有頁面的視覺 token,頁數一多,視覺冗餘讓每一步解碼越來越貴。瓶頸從記憶體搬到了計算量,前代把輸入畫在 40 頁,很可能是在這條計算曲線下的權衡。
Unlimited OCR 2 把解碼端的注意力全部換成 SR-SWA(Sparse Reference Sliding Window Attention,稀疏參照滑動視窗注意力),設計直覺來自人工抄書:抄寫者盯著眼前這頁,需要時回看前一頁的接續處,不會把整本書攤在腦中。報告把機制拆成兩道閘門。
在外的這道閘門叫 Page Gate(頁面閘門):解碼進行到某一頁時,先把這一步能回頭參照的視覺範圍,從整份文件縮限到相關頁面,同時保留多頁之間的位置關係。在內的第二層是 Token Sieve(token 篩):在剩下的遠距內容裡,挑出前 k 組 token 桶納入參照,用來捕捉跨頁的長程依賴。兩層疊加的結果,是模型手邊的工作參照有固定大小,模型卡舉的例子是 512 個 token:無論文件 30 頁還是 300 頁,每一步解碼要看的基本盤被定住了。官方在宣布貼文裡的說法,是把文字與影像之間的注意力互動,濃縮成一組固定大小的工作參照。
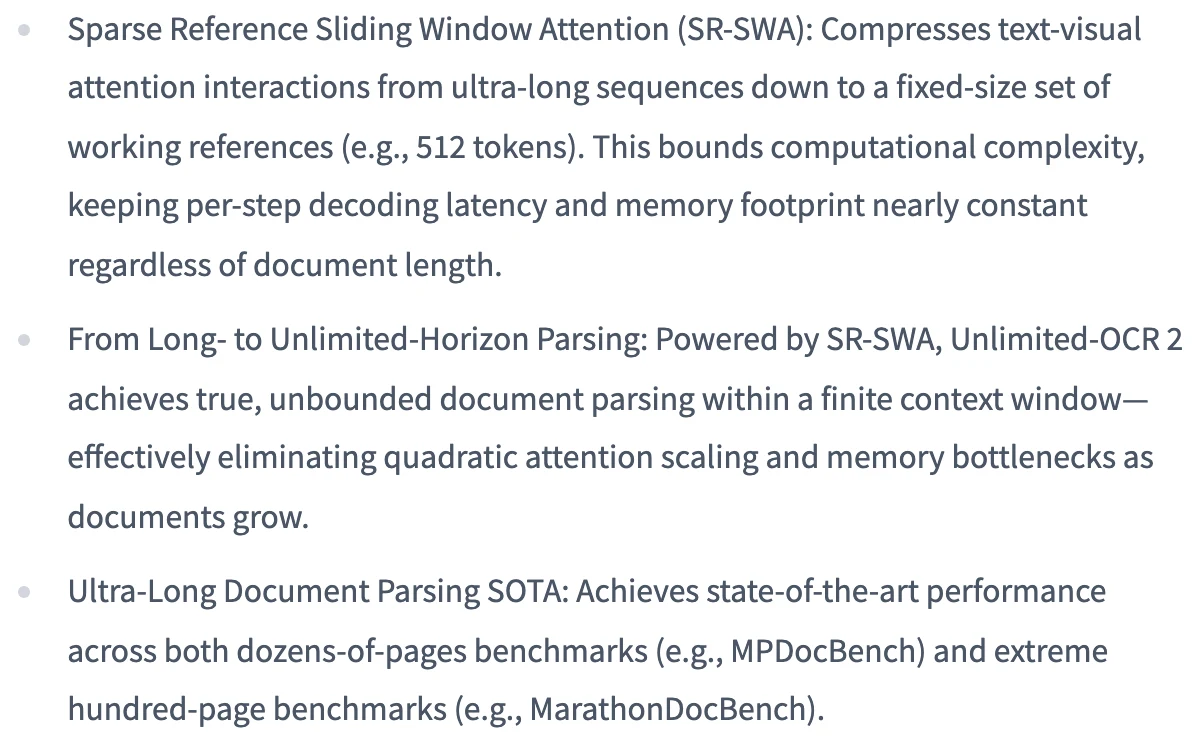
三種注意力模式的行為差異,報告的延遲曲線畫得很清楚:Full Attention 的每步延遲隨文件變長一路上揚,因為每個新 token 都要回頭看所有視覺內容;R-SWA 靠局部視窗壓住了大部分開銷,但遠距視覺範圍仍隨長度成長,百頁之後累積出可見的落後;SR-SWA 把每個 query 的有效注意力範圍嚴格限住,曲線從短文件到百頁文件貼著水平線走。
效率數字來自官方技術報告的量測,屬於開發團隊公布的結果:在百頁規模下,每步解碼延遲約為 Full Attention 的七分之一(7.0 倍加速)、為前代 R-SWA 的 5.6 分之一,量測條件是 Gundam 模式、批次 3、每頁固定輸出 1,024 token;搭配頁級分塊與邊界頁 KV 快取重用,單一序列的峰值 KV 記憶體從 47.00 GB 降到 1.77 GB,併發 16 時的端到端吞吐從 360 提升到 1,315 TPS。後面這組數字值得注意:它意味著百頁文件解析不再需要把整份文件的注意力狀態塞進顯示卡記憶體。
有個界線要畫清楚:每步延遲趨近恆定,不等於總處理時間不變。頁數越多、輸出越長,總步數照樣增加,影像載入與輸出長度都計入實際耗時。「無限」兌現的是解碼視野不再隨頁數撞牆;整份文件會不會更快,是另一回事。
模型卡與報告列了兩份成績單,閱讀方式不同。在 MPDocBench(數十頁級、出自阿里通義 Qwen-Doc 工具鏈的外部評測集)上,Unlimited OCR 2 總分 84.59,高於 Qwen3.8-Max 的 78.30、Gemini-3.8-Flash 的 76.25 與 Kimi-K3 的 60.77,也大幅超前自家前代的 61.89。這份榜單的評測集與工具都是第三方所出,是兩份成績裡參考價值較高的一張。
| 基準 | Unlimited OCR 2 | 同榜最高對手 | 口徑備註 |
|---|---|---|---|
| MPDocBench(數十頁) | 84.59 | Qwen3.8-Max 78.30 | 外部評測集與工具 |
| MarathonDocBench(百頁級) | 77.06 | Kimi-K3 33.74 | 自家新基準、開發團隊自評 |
| OmniDocBench v1.6(單頁) | 94.02 | TeleOCR 96.91 | 該榜首位是 TeleOCR |
另一份是這次同步發布的 MarathonDocBench:100 份文件、每份 100 至 300 頁、合計約 1.8 萬頁與 20.5 萬個標註元素,中英混合,刻意收錄密集的跨頁文字與跨頁表格;標註先由頁級解析器初始化,再交人工細部修訂,內容轉錄經視覺模型迭代校驗、有分歧的項目由人工仲裁,總分取八項指標的平均。Unlimited OCR 2 總分 77.06,次高的 Kimi-K3 為 33.74。細看單項更能對準它的賣點:純文字轉錄 TextEdit 拿到 89.6,跨頁文字與跨頁表格兩項(T-TextEdit 87.7、T-TableTEDS 71.1)都以兩倍以上的差距領先對手,而通用對手在同一份基準上連文字轉錄都普遍落在約 10.8 到 52.5 分的區間。
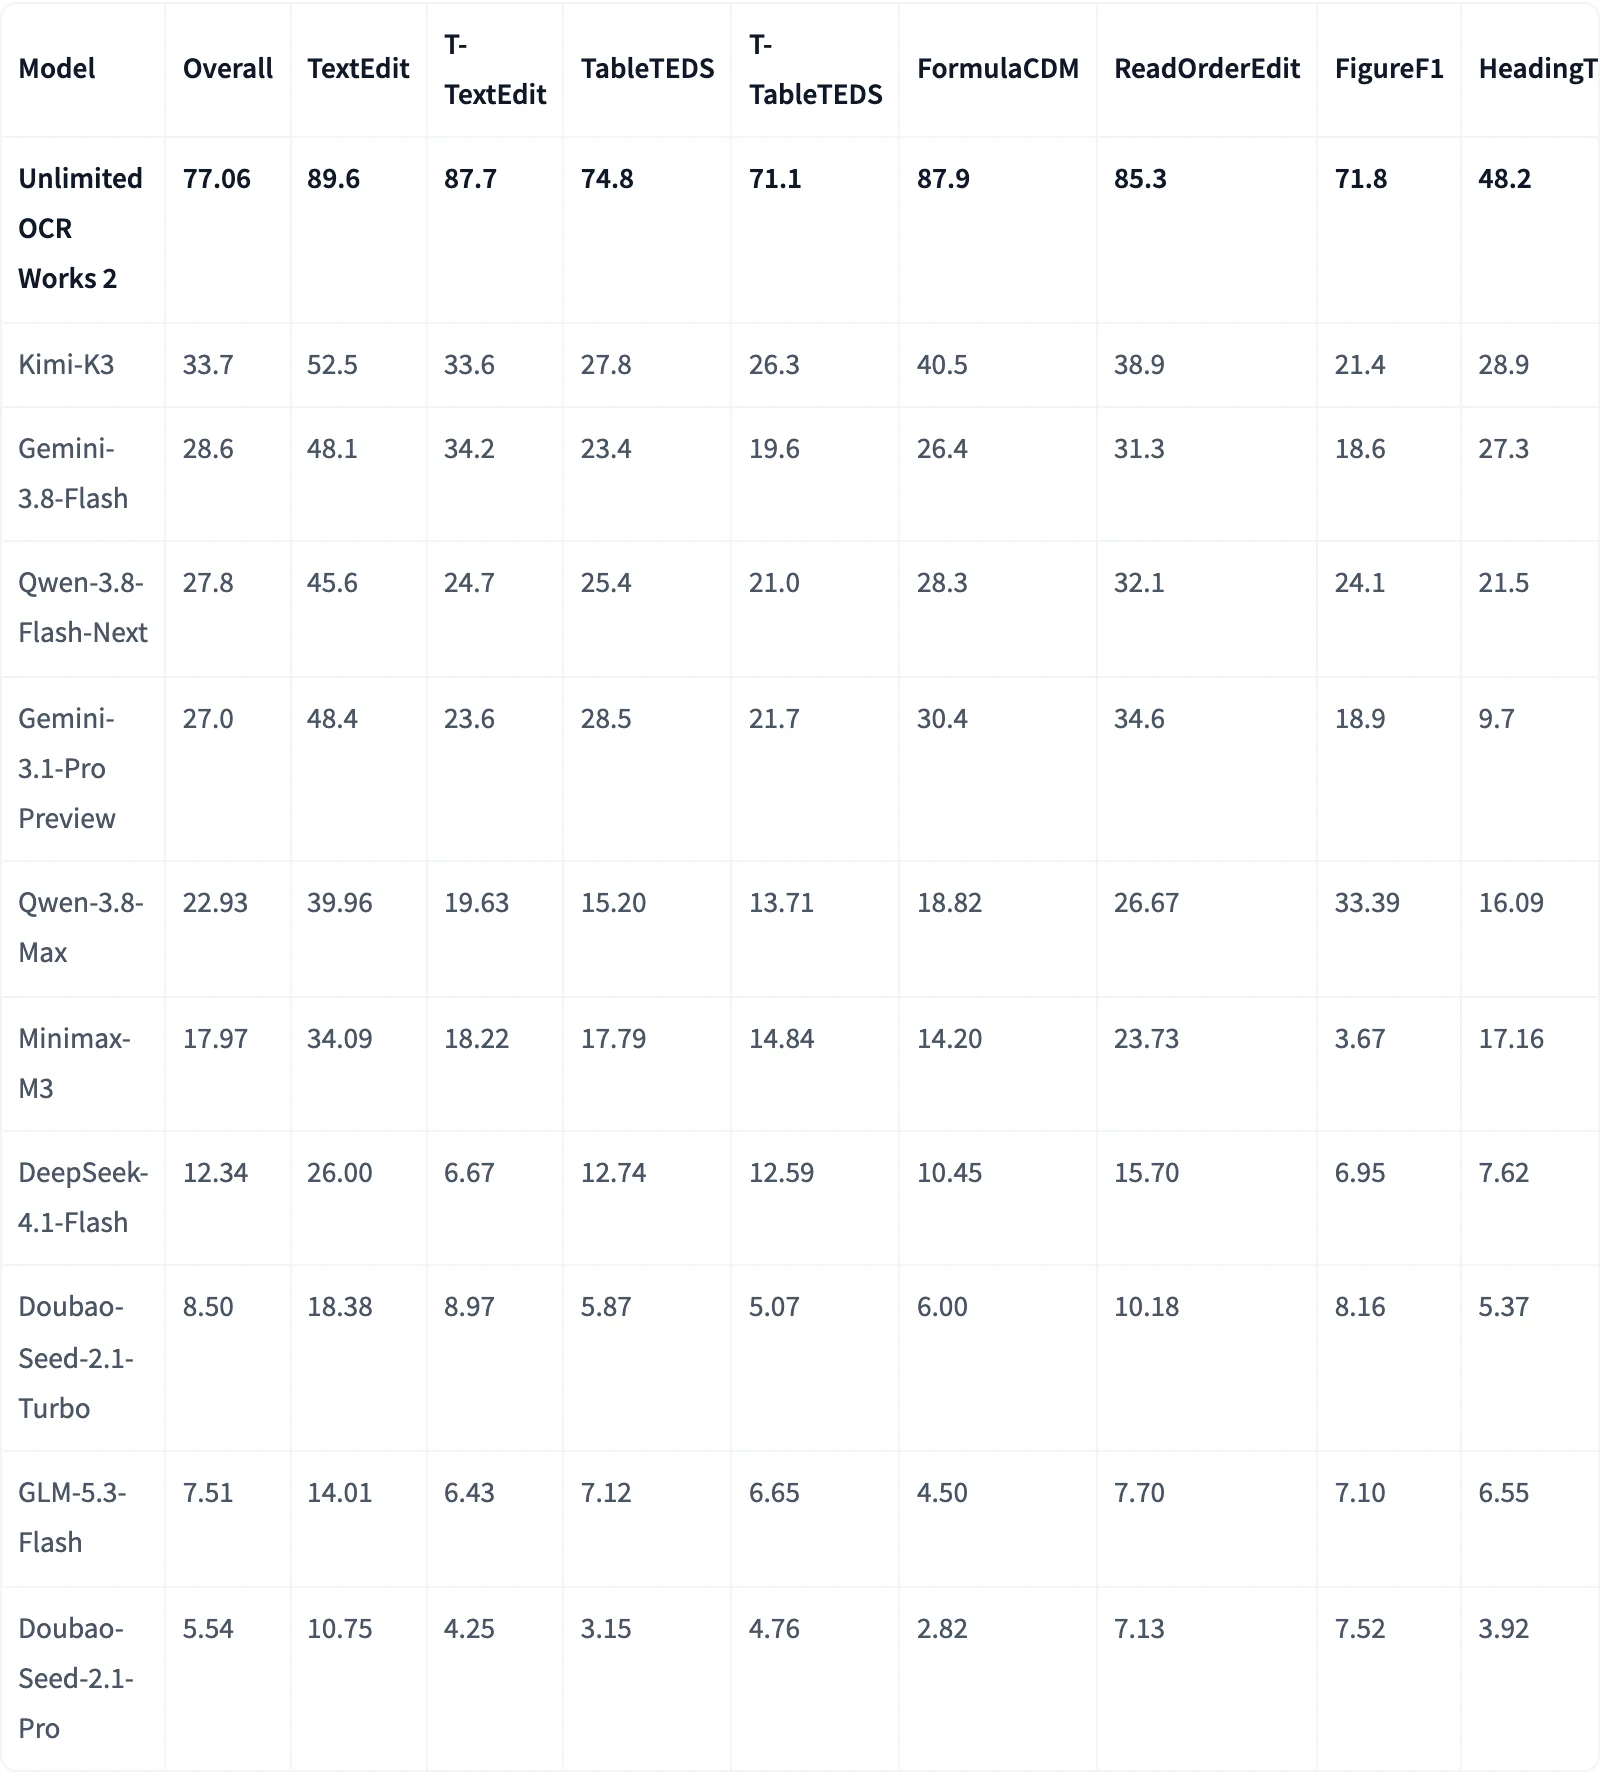
差距確實大,但資料集卡誠實寫明了對手的量測方式:通用模型把整份文件一次送出、太大就漸進調降解析度重試、超過圖片上限就跳過、失敗的文件留空計分、分母維持 100。換句話說,分差裡有一部分是對手在請求上限與輸出截斷上失敗造成的,全部讀成能力差距會高估。報告的長度曲線圖也標注了 Gemini-3.1-Pro 在 223 頁之後失敗,而自身到 300 頁維持精度平穩,這些同樣是作者宣稱。
如果需求以單頁為主,榜單給了相反的答案。在單頁口徑的 OmniDocBench v1.6 上,Unlimited OCR 2 得 94.02,低於 OvisOCR2 的 96.47 與 TeleOCR 的 96.91,和自家前代的 93.92 幾乎持平。這款模型是用單頁的峰值表現,換多頁的規模能力,發票、收據、單頁表單這類場景,輕量的離線方案(例如 RapidOCR 或 OnnxOCR)仍然是更務實的選擇。
更值得記下的是報告限制段的自我坦白:目前的稀疏注意力機制不保留全域文件資訊,限制了標題層級這類文件級結構的理解,訓練資料的多樣性也還有限,未來可能引入線性注意力之類的架構來補。這句話和榜單互相印證:MarathonDocBench 上它自己的最低分項正是 HeadingTEDS 的 48.2。長文件自動化最怕目錄與層級亂掉,這一項在導入驗收時要自己盯,不能只看總分。
想動手試的人有四個入口。Hugging Face 模型頁是主下載點,至 10 月 29 日已有 8,357 次下載、322 個讚;AK(@_akhaliq)蓋的瀏覽器示範空間直接跑在 Hugging Face 的 ZeroGPU 共享顯示卡池上,檢視時狀態為執行中,適合零安裝先看效果;中國境內有 ModelScope(掛在 PaddlePaddle 組織下)與百度雲的說明文件頁。官方 README 還放了一段把整本書用單一請求解析重播的示範影片。
本機部署有兩條官方路徑,官方標示的測試環境是 NVIDIA A800-80GB:Transformers 路徑適合快速驗證,但要開 trust_remote_code 載入遠端自訂程式碼,等於執行模型倉庫附帶的程式;SGLang 路徑適合服務化,用的是倉庫內附的客製 wheel,對外提供 OpenAI 相容介面。官方在發布次日又補上 ms-swift 的訓練支援,想用自己的文件微調,這條路已經先鋪好了。
部署長文件時的頁面視窗是可調參數:官方範例每個視窗 10 頁、跨視窗沿用前一段的 KV 尾端,另有每頁輸出 2 萬 token 的保護上限;把視窗調小可以降低峰值記憶體,代價是跨過視窗邊界的表格會失去上下文、跨頁合併變差;也可以設成整份文件單一視窗,回到記憶體吃緊的那一端。多頁請求的輸入格式很單純:頁面依序編成圖片、一次送進模型,輸出為每個輸入頁保留一個頁面標記,順序與輸入一致,事後核對可以逐頁對回原稿。這正是開頭那句總結的落點:頁數不再是模型畫出來的紅線,而是工程師按記憶體預算搬動的滑桿。
授權要看兩層。模型權重與程式碼是 MIT,商用與修改的空間明確。MarathonDocBench 則是混合式:標註與評測工具以 Apache-2.0 釋出,但頁面圖片本身限學術研究用途,未授權再散布,想直接把這 1.8 萬頁拿來當商業流程的驗收素材,要先看清楚這條線。
對台灣的團隊,真正的未定項是繁體中文。模型標示 multilingual,基準集中英混合,但官方對繁中、直式排版與台灣常見文件格式零宣稱,自建驗收樣本時,直式文字的閱讀順序、公司名稱與地址裡的相似字、跨頁表格的金額欄位,都是值得優先放進測試集的項目;如果要把辨識結果的品質把關也自動化,可以搭配對輸出逐區打品質分的獨立模型(例如 OpenBMB 的 Jev),先挑出低分區域再人工覆核,比整份從頭讀更省力。
後續值得回看:榜單分數會隨對手更新變動;技術報告目前以 PDF 形式放在倉庫,arXiv 上掛的仍是 6 月的前代論文;示範空間的運作狀態與繁中第三方實測,幾週後適合再查一次。眼下的判斷可以先做:手上有百頁級文件流程的團隊,從瀏覽器示範或 A800 級環境跑小樣本,重點盯跨頁表格與標題層級兩項;以單頁為主的流程,沒有為了它搬家的理由。把頁數從模型的能力欄位移到部署的參數欄位之後,接下來輪到文件流程的設計者按記憶體預算重新排隊。