TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

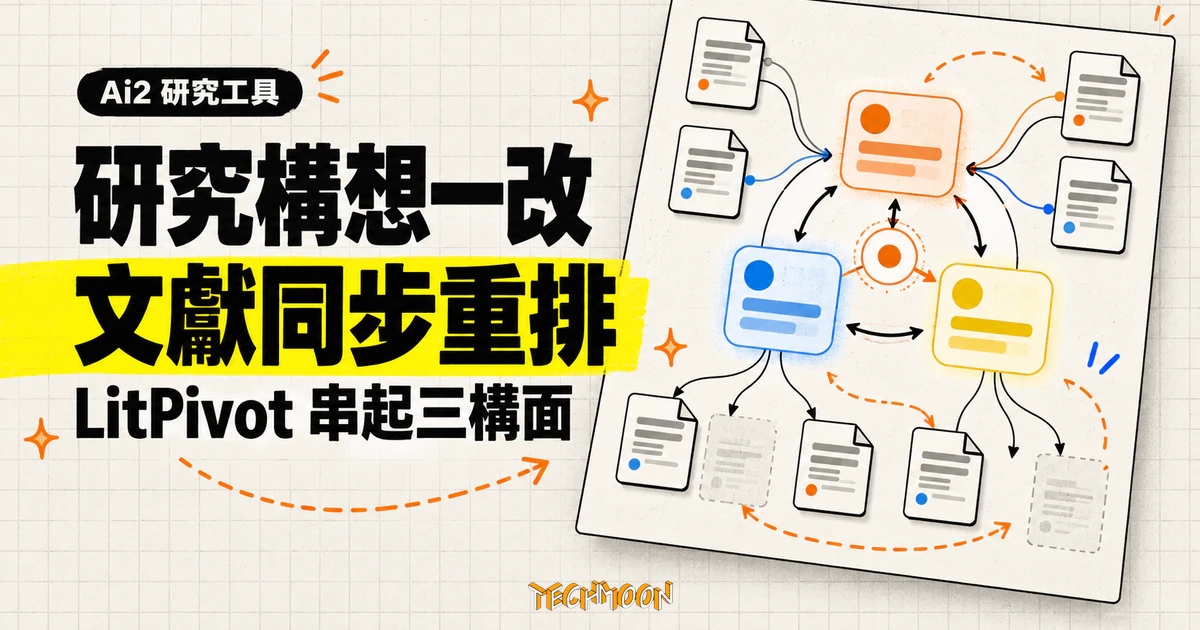
Ai2 於 2026 年 10 月 23 日介紹與賓夕法尼亞大學合作的研究系統 LitPivot:構想拆成研究問題、預期貢獻與評估計畫三部分,每修改一段就重排對應文獻並附摘錄評論;17 人盲評實驗中,專家評的有據程度中位數從 2 分升到 5 分。本文核對官方部落格與 UIST 2026 論文,整理系統機制、實驗界線與尚無公開版本的限制。
用 AI 摘要這篇文章:
Ai2(Allen Institute for AI,艾倫人工智慧研究院)在 2026 年 10 月 23 日於官方部落格,介紹與賓夕法尼亞大學(University of Pennsylvania)合作開發的研究系統 LitPivot。它處理的環節很具體:研究者修改研究構想的時候,文獻清單跟著構想一起變動。構想被拆成研究問題、預期貢獻與評估計畫三個部分,點選其中一段,側邊面板就重新整理屬於那一段的論文,評論與修改建議都附上論文摘錄當依據。在 17 位研究者參與的盲評實驗中,用 LitPivot 發展的構想在「有據程度」這一項拿到中位數 5 分,對照工具是 2 分(7 分制)。
有兩個界線要先說清楚。其一,這不是論文首度公開:描述這套系統的論文早在 2026 年 4 月 3 日就登上預印本平臺 arXiv(編號 2604.02600),9 月 22 日更新到第三版,11 月 2 日至 5 日將在美國底特律舉行的 UIST 2026(ACM 使用者介面軟體與技術研討會)正式發表,10 月 23 日的部落格文屬於把研究帶向大眾的官方介紹。其二,LitPivot 本體沒有公開版本,官方頁面上找不到試用入口或原始碼下載;研究者現階段能動手用的,是它底下的開源檢索引擎 Asta Paper Finder,以及「構想與文獻一起改」這套工作方法本身。
這篇部落格文由 Ai2 掛名發布,合作對象是賓夕法尼亞大學。論文作者共七人:第一作者 Hita Kambhamettu 是賓大研究生,這項工作在 Ai2 實習期間完成;Andrew Head 是賓大教授;其餘五位作者任職於西雅圖的 Ai2,其中一位(Bhavana Dalvi Mishra)已轉職 Google,工作是在 Ai2 期間完成的。時間線上的四個節點分別是:4 月 3 日論文第一版、4 月 13 日修訂、9 月 22 日第三版(對應研討會版本)、10 月 23 日官方部落格介紹。論文將以 DOI 10.1145/3830398.3830577 發表於 UIST 2026 議程,依 CC BY 4.0 授權,註明出處後即可合法引用與轉載全文。
官方對 LitPivot 的定位寫得很保守:它是給早期研究構想發想階段用的系統,作者並在部落格文中表示,同樣的做法未來可能延伸到更長的寫作任務,例如論文導言的撰寫。這兩句都屬於作者宣稱,特別是後半段的延伸方向,目前沒有對應的評估研究。
LitPivot 的出發點是一個研究者都遇過的經驗:讀到某篇論文之後,原本的研究方向整個變了。可能是發現想做的貢獻已經有人做完,也可能是從別人留下的限制裡看到更值得做的題目。研究團隊給這個現象一個名字:文獻啟動的轉向(literature-initiated pivot),意思是閱讀文獻觸發了構想修改,而且修改之後,哪些文獻變得相關也跟著改變。
這個概念有實證出發點。團隊分析了四個已完成的電腦科學專案(兩個 HCI、兩個 NLP)的會議紀錄,整理出 21 次這樣的轉向,並分成兩型:九次是把構想與既有工作拉出差異,以建立新穎性;十二次是把構想對齊既有工作,站在別人的基礎上往前走。文獻平均出現在每個專案的 7.5 次會議討論裡。有趣的是,團隊在部落格文中自曝,LitPivot 這個研究本身在定案之前,也經歷了兩次轉向。
既有工具在這個環節上是斷開的。文獻搜尋工具(如 Google Scholar)檢索的是固定語料庫,不會因為你的構想改了就重排;構想發想類 AI 工具則是對著靜態、預先選好的論文集檢查構想,構想改了之後文獻集合不動。LitPivot 想補的就是這條縫:讓構想修改與文獻重排變成同一個動作。
實際介面是這樣運作的。研究者在編輯器裡寫下簡短的研究構想,開啟「構面標示」(facet highlighting)功能後,系統把句子標成三種顏色:紫色的問題描述、綠色的預期貢獻、橘色的評估計畫。研究者點選某一段,旁邊的面板就根據那一段的用途分群、排序論文;例如點選評估計畫時,論文會按評估方法分組。想檢查貢獻是否有人做過,就點貢獻那段,看系統排出的既有方法與作者自己留下的限制。
文獻從哪裡來?系統把研究者當下的構想當成查詢種子,丟給 Ai2 自家的開源論文搜尋引擎 Asta Paper Finder,再透過學術資料庫 Semantic Scholar 的 API 抓論文全文與引用網路,被引用的文獻會遞迴補進候選清單。研究者可以手動增刪論文,決定讓系統參照哪些資料。論文內文的處理鏈圖揭開了分工:Asta 負責初始檢索,GPT-4o 從每篇論文抽出對應三個構面的關鍵句,Sonnet-4 把論文按構面分群,Asta 的片段搜尋再把被引用的相關文獻拉進來,構想一改就重新繞一圈。
評論與建議的產生方式也有設計。系統用大型語言模型針對選定的構面生成評論,搭配一張把「既有論文的貢獻」與「它們留下的限制和未來工作」連起來的對照圖,判斷你的貢獻和已發表工作有哪裡重疊、哪裡有缺口。論文對新穎性的判定規則寫得很機械:你的貢獻若對應到某篇論文的未來工作或尚未被解決的限制,就算有新穎性;若與既有貢獻重疊,就不算。每則評論有長度上限與固定格式,附支持它的論文摘錄與出處,修改建議給一到三種可直接替換的改寫句,且禁止編造論文裡沒有的名稱或數字。研究者可以接受、編輯或拒絕。系統還會提示構想裡缺少或不一致的部分,例如研究問題改了、評估方法卻還停在舊問題上,並在修改某段時指出其他受影響的段落。
證據面來看,團隊設計了一場 17 人實驗:參與者是電腦與資訊科學背景的研究者,82% 為博士班學生,另有一位博士後與兩位業界研究員;領域分布以 NLP 九人最多,其次是人機互動三人、機器人與強化學習兩人、生醫與健康 AI 兩人、機器學習一人。實驗在 Google Meet 上進行,每人獲得 75 美元報酬,通過研究倫理審查;流程是把兩個任務順序打亂,兩種條件各花 30 分鐘發展一個指定構想。構想不是參與者自己的題目,而是依熟悉領域指派的標準種子構想,用意是把「本來就進行到一半的專案成熟度」這個變因控制掉。對照工具官方部落格稱為「文字編輯器加上 AI 聊天工具」,論文細節寫明:那個問答介面與先前研究工具 IdeaSynth 使用同一種文獻問答後端,且兩種條件共用同一批約 100 篇論文的語料庫。換句話說,比較集中在工作介面與流程,而不是誰能搜到更多論文。
評分由兩位領域專家盲評(不知道構想來自哪種條件),標準只有一項,7 分制量表上的「這個構想是否有據、有論地運用相關文獻」。結果:LitPivot 條件的中位數 5 分,對照條件 2 分;平均數 5.18 對 2.59,統計檢定達顯著(W=4.5,p<.001,效應量 dz=1.29)。兩位評分者先各自評出偏低的一致性(Krippendorff’s α 0.389),討論校準後提高到 0.804。參與者選進構想的論文數中位數是 7 篇,對照條件是 3 篇。
參與者自評提供了另一面的數字:使用 LitPivot 後對文獻的理解自評 5.71 分(對照 3.88),修改後構想的新穎性提升 2.29 分(對照 0.47),實用性提升 0.53 分(對照是下降 0.76)。但要注意兩件事:新穎性與實用性是參與者自己的感受,不是專家判定;而構想的可行性在兩種條件間沒有顯著差異。專家實際評過的只有有據程度這一項,重要性、有趣程度都不在評分範圍裡。
論文裡一位編號 P1 的參與者留下了完整的轉向紀錄。他原本的貢獻構想是產生「一致且符合事實的合成醫療病歷」,起初選了三群共 12 篇論文。系統在一次評估中指出,「跨多次就診且時間連貫的病歷語料」仍是開放問題;P1 逐篇看過摘要後,取消勾選六篇只處理單次就診的論文,改寫貢獻描述,再跑一輪評估,構想收斂成「偵測多次就診病歷之間矛盾的檢查與獎勵訊號」。這正是系統想放大的那種轉向:文獻集合跟著構想一起縮,缺口跟著浮上來。
實驗之外,團隊另做了開放式觀察:五位參與過前項實驗的研究者各花 30 分鐘,把 LitPivot 用在自己正在進行的計畫上,系統預先載入他們指定的文獻。五位之中,兩位拿它檢查新構想是否站得住,三位拿它把比較成熟的構想重新框架。幾個具體例子能看出用法。一位相信自己的貢獻只適用於微調(fine-tuning)情境的參與者,在貢獻分群裡看到強化學習的相關工作後,把構想改成同時涵蓋兩種情境。另一位用三次不同文獻組合的評估檢驗一個問題生成構想,三輪之後判定這個貢獻過於漸進,於是轉向定義「情境適切性」,收斂出一組跨領域的問答限制條件,過程中存了七篇論文、採用五條改寫建議。五人中有四人表示會在研究寫作中再用這個工具。這個觀察說明工具可能適用於研究的不同階段,但樣本只有五人、時間只有半小時,團隊自己也寫明,長期使用對研究發展的影響還沒有被研究。
官方部落格與論文都沒有提供 LitPivot 的試用入口、demo 或原始碼,何時釋出也沒有時間表。想現在就動手的研究者,能碰到的相關資源有兩個。一是 Asta Paper Finder:它是 LitPivot 的檢索引擎,以開源專案形式釋出,GitHub 上可找到 allenai/asta-paper-finder,也可直接用 asta.allen.ai 網頁版,用自然語言描述主題就能搜論文。二是這篇論文:CC BY 4.0 授權允許完整取用系統細節與實驗資料。
即便等不到工具本體,這套方法裡有可以直接搬進現有工作流程的東西。把構想明確寫成研究問題、預期貢獻、評估計畫三個部分,取代一整段模糊的敘述;三個部分各自配一批文獻,不共用同一份搜尋結果;構想改寫某個部分之後,回頭重查那個部分的文獻,舊清單未必還適用;收到 AI 給的引用建議時,回到論文原文核對摘錄的上下文,因為系統產生的摘錄每則僅一到兩句、每篇論文上限三則,未必涵蓋原文的完整脈絡。這些原則用任何文獻工具都能執行,LitPivot 的價值是把它們做成了同一個介面裡的連續動作。
若想找能立刻跑類似流程的替代品,開源深度研究工具(/local-deep-research/)可以把多輪文獻調查搬進自己的機器。想看生成假設到跑實驗整段自動化的極端版本,可參考 Lila Sciences 在 GTC 展出的 AI 科學工廠(/lila-sciences-ai-science-factory/)。另一個值得對照的變革把審查工作從逐行讀程式碼改成核可形式化規格,詳見 PDD Kit 的研究預覽(/pdd-kit-verus-rust-proof-driven-development/)。
論文的限制節寫得相當誠實:結果未必能類推到 HCI 與 NLP 之外的研究文化;實驗是單人、限時的任務,不是真實的長期研究;系統只評估構想的證據基礎與差異化,沒有評重要性或可行性;判斷新穎性的對照圖模型抓不到「用新框架重新詮釋舊問題」這一型的新穎;工具的效果也取決於文獻語料庫的涵蓋面。對想引用這些結論的人,這份清單就是引用的上限。
尚未確定的事還有四件:LitPivot 何時或是否會公開釋出;其他學科、多人協作的研究場景是否同樣受益;AI 引用摘錄的正確率(論文沒有提供量化);以及長期使用是否真的讓研究發表更快或更好。最近的一個回看時間點是 11 月 2 日至 5 日的 UIST 2026,研討會版本發表後,官方是否順勢釋出 demo 或程式碼,值得在那之後再查一次;Asta 的開源倉庫動態則可以當作先行指標。