TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

Easy Scraper 是評價五顆星的免費 Chrome 爬蟲擴充,一鍵抓取網頁列表與詳情頁,資料匯出 CSV 或 JSON。2026 年現況整理:Chrome 商店暫停供應中、已安裝者可續用,隱私承諾拆成資料、遙測、宣稱三層來看最準確。
用 AI 摘要這篇文章:
打開 Easy Scraper 的 Chrome 商店頁面,第一眼看到的不是安裝按鈕,而是一條紅色警告:Item currently unavailable,請查閱疑難排解指南。旁邊的「加到 Chrome」按鈕是灰色的,點不動。這個在商店掛著五顆星、約 1,300 則評分、標註 10 萬用戶的免費網頁爬蟲擴充,目前處於無法新安裝的狀態。先把結論說清楚:已經裝過的人短期內可以繼續用,擴充的更新檔還下載得到;還沒裝的人,正規入口目前都走不通,只能等它恢復上架,或者直接考慮替代工具。至於它最出名的「隱私優先」宣稱,從擴充的程式碼來看要拆成三層讀:抓下來的資料確實留在本機,但遙測是預設開著的,而且介面裡沒有關閉的開關。
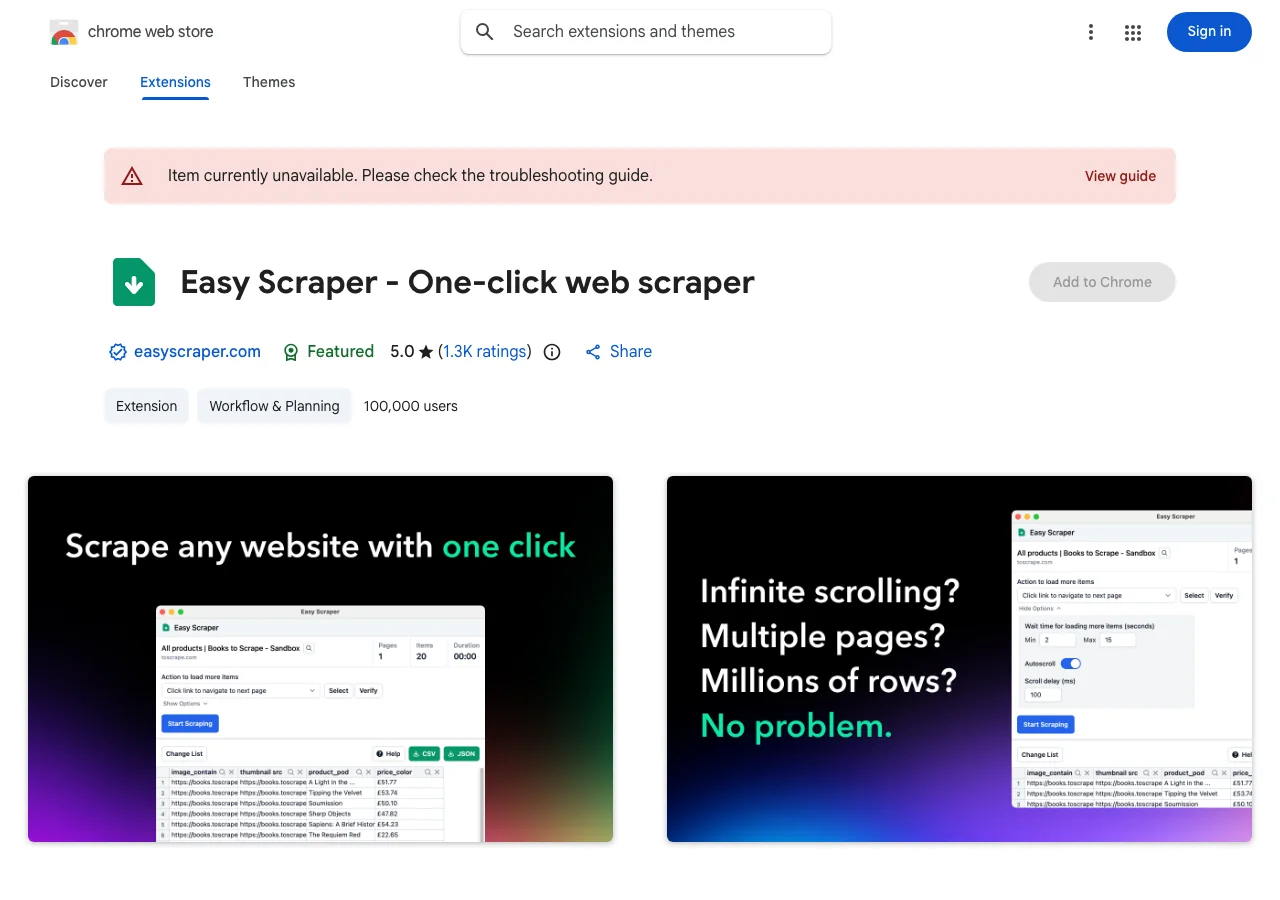
這個工具的現況有一個很奇特的斷層,值得先把時間線講清楚。
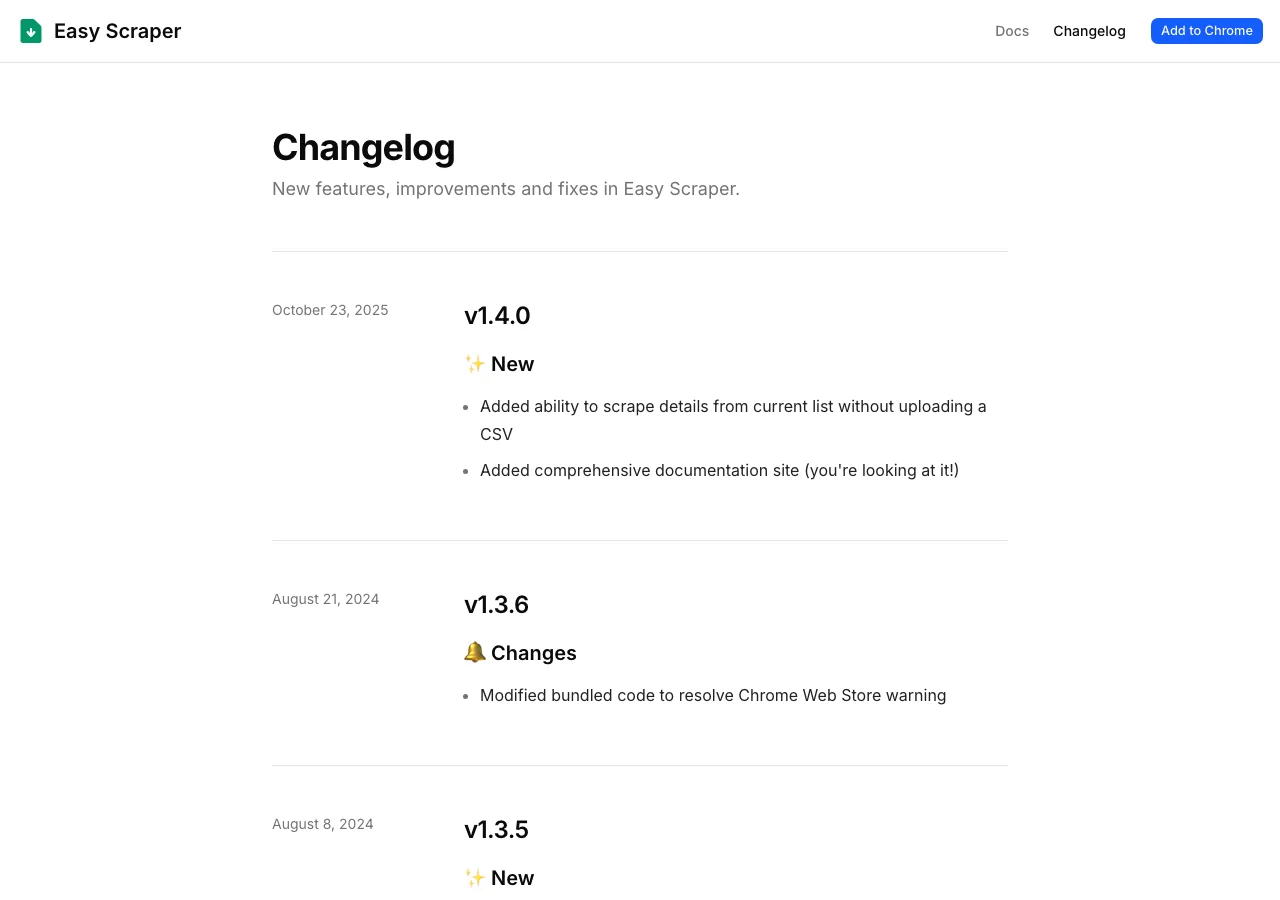
Easy Scraper 是 2024 年 2 月開始密集開發的擴充,2024 年 2 月到 8 月之間發布了二十個版本,中間經歷過幾次有趣的轉折:2024 年 4 月初加入中文介面支援,幾天後又移除了對 Google 地圖的限制。2024 年 8 月之後開發停了十四個月,2025 年 10 月接連推出 1.4.0 和 1.4.1 兩個版本,順帶上線了完整的文件網站。商店頁顯示的最後更新時間是 2025 年 10 月 31 日,版本 1.4.1。
順帶一提,這不是它第一次跟商店審核打交道。更新日誌顯示 2024 年 8 月的 1.3.6 版整條更新說明只有一句話:修改打包程式碼以解決 Chrome 商店的警告。開發者當時選擇正面處理,而這次「無法供應」的時間點距離最後一次版本更新只隔了幾個星期,兩件事有沒有關聯,沒有公開資料可以判斷,這裡不猜。
根據網際網路檔案館的快照,2025 年 11 月 17 日的商店頁還完全正常,沒有任何警告,當時的評分是 919 則。也就是說,「無法供應」的狀態出現在 2025 年 11 月中之後的某個時間點,到現在至少持續了好幾個月。至於原因,商店頁沒有說明,開發者也沒有在任何官方管道發布公告,這段只能保持未知。
但專案並沒有跟著商店一起消失。擴充本體的下載端點目前仍然回應正常,能完整取回 1.4.1 版的安裝檔。這代表已經安裝的人,瀏覽器要檢查更新時走的通道還是通的,舊用戶不會突然失去功能。官網也持續在運作,頁尾版權年份標到 2026 年,文件站、更新日誌、隱私政策、服務條款一應俱全,首頁甚至還掛著「加到 Chrome,免費」的大按鈕。只是那顆按鈕連到的商店頁,就是上一段那個灰色的畫面。
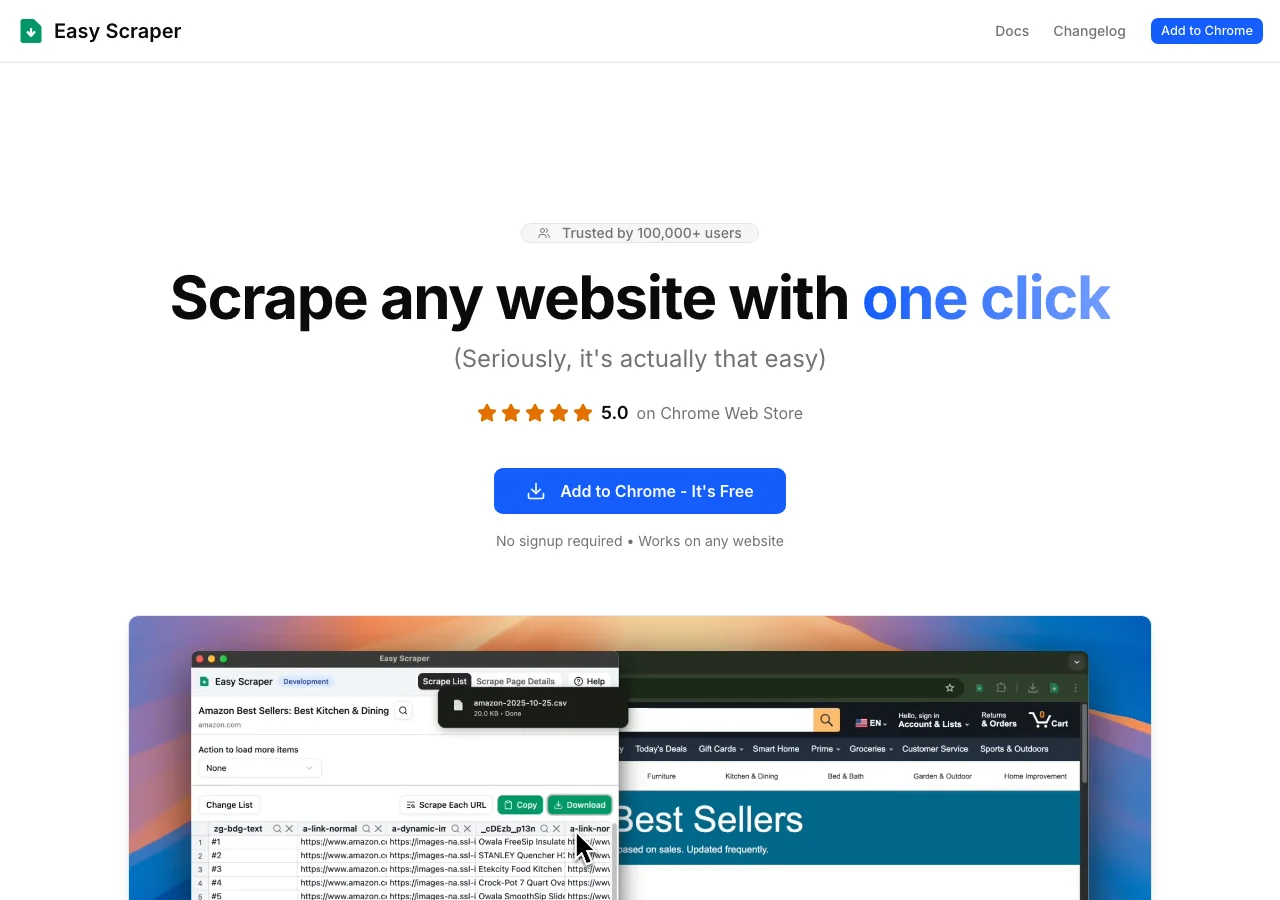
一個工具的商店狀態和官網狀態脫鉤這麼久,對讀者的實際意義是:不要把「官網還在」當成「可以安裝」的保證。安裝任何瀏覽器擴充前,先點進商店頁確認按鈕是藍色的,這個習慣在 2026 年的擴充生態裡越來越重要。
如果之後恢復上架,它值不值得裝?先看官方文件描述的能力樣貌。
Easy Scraper 的核心是兩種抓法。第一種是列表抓取:到你想要收集資料的頁面(商品清單、搜尋結果、目錄頁都算),點選擴充圖示,它會自動偵測頁面上的重複列表結構,讓你預覽、編輯欄位,然後一次匯出。無限捲動、下一頁按鈕、載入更多這三種分頁方式都支援,也能設定最大筆數上限。第二種是詳情頁抓取:先從列表拿到一整批網址(或直接上傳 CSV 網址清單),然後用點選的方式在範本頁上指定要抓的欄位,擴充就會逐一拜訪每個網址,把每頁的資料抓下來。這個範本可以命名保存,下次遇到同一個網站的頁面直接重複使用,也能匯出成 JSON 檔備份或分享。
匯出格式有三種:CSV、JSON,以及直接複製到剪貼簿貼進試算表。介面支援 52 種語言,中文在 2024 年 4 月就加入了,而且開發者在 1.3.1 版特別修過 CSV 檔的 UTF-8 編碼問題,非拉丁字元(中文就是最大宗)的亂碼情況大幅減少,官方 FAQ 仍提醒在 Excel 裡與其雙擊開檔,不如用匯入精靈指定編碼。這兩個細節對中文使用者是真實的加分。
詳情頁抓取還有幾個實務設計值得知道。範本是綁定網域的:在一個網站上錄好的範本,換到結構不同的網站通常要重錄,官方文件的說法是它們本來就只為「結構相似的頁面」設計。範本錄製時可以按「驗證」按鈕確認選到的欄位抓得到資料。跑完之後有些欄位空白是正常現象,官方文件直接把這件事寫進常見問題:不是每個頁面都有每個欄位,例如有些商品沒有評論數,匯出後該格就是空的,需要事後自己清理。列表抓出現重複項目也有官方解法:分頁方式可能把已經抓過的項目再載入一次,文件建議匯出後在試算表裡去重。
速度方面,官方文件的建議很保守:多數網站抓每一頁間隔 2 到 3 秒算安全,容易被擋的站拉長到 5 秒以上。文件也老實提醒,遇到驗證碼就代表網站不歡迎自動化存取,該放慢或停手。以 2 到 3 秒的間隔估算,100 個網址大約要 3 到 5 分鐘,1,000 個網址半小時起跳。這類在瀏覽器裡跑的爬蟲,本質上是把你的瀏覽器當機器人用,快不起來是正常的。
哪些瀏覽器裝得起來?官方文件列出的相容範圍是所有 Chromium 系瀏覽器:Chrome、Edge、Brave、Opera、Vivaldi。Firefox 和 Safari 明確不支援。要注意這個「相容」的前提是它回到商店貨架上;目前 Chrome 商店頁停用中。Edge 的附加元件商店確實搜得到一個同名條目,但頁面上的開發者名稱和官網登記的營運公司對不上,用戶數也只有一千多,無法確認是開發者自己發布的還是別人搬運的,這種情況下不建議賭。
為什麼偵測不到頁面上的列表?官方常見問題列了幾種原因:頁面還沒載完、頁面沒有重複的列表結構、列表用了非標準的排版,或者內容是動態載入的。解法是捲動一下頁面、等載入完成再開擴充,確認頁面真的有重複元素。如果都試過還是抓不到,這個頁面大概就不是它的菜。
抓下來的檔案存在哪?下載的 CSV 和 JSON 會存到瀏覽器預設的下載資料夾。還沒匯出的資料和錄好的範本都放在瀏覽器的本機儲存區,解除安裝擴充或清除瀏覽器資料就會消失,重要範本記得用它的匯出功能備份成 JSON 檔。
有沒有抓取筆數上限?官方說法是沒有硬性上限,實際的上限來自三個地方:瀏覽器記憶體(抓太大頁面可能變慢或崩潰)、目標網站的封鎖機制、以及你的時間。官方建議大任務用最大筆數限制分批抓,一次抓幾百筆、匯出、再抓下一批,比一口氣抓幾萬筆穩得多。
官網首頁寫著「所有爬取都在本機發生」,商店描述也說「在你的瀏覽器本機運作,資料不經網路傳送」。這句話對不同層面的真實程度差很多,拆開看才公道。
第一層,你抓的資料。這一層的承諾在程式碼裡站得住腳。把 1.4.1 版的擴充安裝檔解開檢查:擴充呼叫外部服務的程式碼裡,找不到任何把表格內容送出去的路徑。它確實內建了統計追蹤的程式庫,但送出的事件內容經得起檢驗:整份程式碼裡的遙測事件總共只有十幾個,全部是操作層的計數,例如「執行了一次爬取」,附帶的欄位只有爬取類型、花了幾秒、抓了幾筆、匯出什麼格式。看不出你爬了哪個網站,也不含欄位內容或資料本身;唯一會帶網址欄位的事件,是你在不支援注入的分頁上打開擴充的那一刻,它會附上該分頁的網址,屬於錯誤回報性質。錯誤回報服務 Sentry 的金鑰在正式環境設定裡是空的,等於停用。爬下來的資料存在瀏覽器本機儲存區,登出帳號時會整個清空。「資料不上傳」這四個字,這一版是兌現的。
第二層,遙測。這一層就沒有那麼漂亮了。正式環境的設定把統計服務打開:Amplitude 和 PostHog 兩套分析服務同時啟用,擴充安裝的那一刻就開始回報操作事件,不需要你同意,也沒有地方可以關。擴充的儲存區裡有一個名為 analyticsEnabled 的設定項,預設值是開啟,但翻遍介面的 52 種語言字串,找不到任何讓使用者切換這個設定的選項。也就是說,遙測是內建且單向的:你知道它會回報操作計數(如果你讀過隱私政策的話),但你關不掉它。如果你在擴充裡登入網頁版帳號,它還會把你的帳號識別碼和信箱綁進遙測資料,從匿名計數變成可識別的使用紀錄。公平地說,這套遙測的配置算收斂:Amplitude 關掉了自動捕捉、不儲存身分資訊,PostHog 不記錄頁面瀏覽、資料只存在記憶體裡。它追蹤的是「這個功能被用了幾次」,追蹤不到你的資料。但如果「隱私優先」指的是零遙測,那它做不到。順帶一提,造訪它的官網也一樣會被統計:網站掛了一套頁面瀏覽追蹤服務,這在 2026 年的網站裡是常態,只是和「注重隱私」的招牌擺在一起看,味道難免複雜。
第三層,官方說法。這一層最亂,四個官方位置的口徑互相打架。Chrome 商店頁的隱私欄位寫「開發者已聲明不會收集或使用你的資料」。官方常見問題寫得更滿:不收集個人資訊、不與第三方分享。但官方隱私政策白紙黑字自承:會自動收集使用資料、設備資訊、IP 位址與擴充使用設定,並使用 Amplitude、PostHog、Stripe、Vercel 等第三方服務。哪個才是真的?從程式碼層看,實況介於兩者之間,而且更靠近隱私政策那一側:遙測存在、預設開、關不掉,只是內容貧瘠到不構成隱私災難。給讀者的實用結論是:這個工具的隱私承諾,不能只看行銷頁面,四個頁面裡最保守的那份(隱私政策)最接近真相。
常見問題把「存取所有網站」列為必備權限,這個說法反而低估了它的權限設計。
擴充安裝清單(manifest)裡的必備權限只有三項:activeTab(你正在看的那個分頁)、scripting(注入腳本)、storage(本機儲存)。「讀取及變更所有網站上的資料」這個聽起來最嚇人的權限,被放在選用欄位:平常不要求,當你用到需要批次拜訪多個網址的詳情頁抓取時,才臨時跳出來問你一次。tabs 權限也是選用的。
這是瀏覽器擴充裡相對乾淨的權限結構。安裝的當下它拿不到任何網站的存取權,你要它做事、它才向你借當下需要的部分。對照常見問題把所有網站存取寫成必備,比較合理的解讀是文件寬鬆、實作嚴謹。這在免費爬蟲擴充裡算少見的正向訊號:同類工具為了方便,常見的做法是一安裝就要走全部網站的權限。
另外一個值得記下的技術細節:擴充只接受來自 easyscraper.com 網域的跨頁面訊息。它的網頁版平台可以和擴充溝通(登入時把帳號傳進擴充、登出時清空本機資料),其他網站做不到。這個邊界畫得清楚,沒有留給第三方網站呼喚擴充的後門。
「Easy Scraper 免費嗎?」官方常見問題的回答是肯定的,而且用詞很講究:目前免費,可以盡量抓,不收訂閱也不收付款。抓取筆數沒有硬性上限,方案不分級,商店頁也看不到應用內購買的提示。
但把官方文件拼起來看,收費的軌道其實已經鋪好了。服務條款裡有完整的訂閱條文:按月或按年計費、自動續約、付費後不退款,調價前會事先通知。隱私政策則寫明付款資訊由第三方支付服務(Stripe)處理。官網和它的網頁版平台都掛著同一套計費系統的程式碼。網頁版平台 app.easyscraper.com 是一個需要登入的完整應用,用 Google 或電子郵件註冊,登入後帳號會同步進擴充,背後有帳務、組織管理這些企業級功能模組。擴充程式碼裡也保留著登入與登出的訊息介面。
把這些放在一起,「目前免費」四個字裡的「目前」不是客套話。開發者自己寫下的措辭就是一個誠實的時間戳:功能現在全部免費、全部在本機,但帳號體系和計費基礎設施都在位,哪天推出付費方案,不需要重新架構。重度依賴它做例行資料收集的人,心理上要有「規則可能改變」的準備。
Easy Scraper 的營運主體是 Road to Ramen LLC,服務條款指定美國德拉瓦州法律管轄,聯絡地址登記在德州一個帶室號的街道地址。開發者署名 Namu,個人網站上列著一整排作品:專注力工具 Intention、自動化工具 Browserflow、讓 AI 操作瀏覽器的 Browser MCP,以及 Easy Scraper。商店頁標記它是非交易者,歐盟消費者保護權利不適用。
有趣的後續是,這位開發者正在做的新產品叫 Extension Stack,一個 Chrome 擴充開發的樣板包,行銷頁面直接拿 Easy Scraper 當活廣告:五顆星、數百則評論。擴充官網頁尾那句「以 Extension Stack 建置」,講的就是這層關係。一人公司把招牌產品的成功經驗打包成下一個產品,這條路線本身合理,但對使用者的意義是:資源有限,商店頁從 2025 年 11 月中之後就無法安裝,既沒有恢復也沒有公告,八成就是沒有餘力處理,不像策略性下架。
最後回到那組數字:10 萬用戶、5.0 顆星、約 1,300 則評分。滿分評分在 Chrome 商店裡極為罕見,用戶數字則從 2025 年 11 月的快照到現在都停在整數十萬,配合無法新安裝的狀態,這組數字應該解讀為凍結的歷史成績,而不是持續成長的現況。
把現況整理成一個決策。
已經安裝的人:可以用,而且短期內沒有迫切的移除理由。資料在本機、更新通道還活著、功能完整。唯一該做的是定期看一眼商店頁有沒有恢復,以及別把重要資料 workflow 全壓在一個商店狀態不明的擴充上。真的在乎遙測的人要知道:它回報操作計數這件事你關不掉,能接受的底線自己畫。
還沒安裝的人:不要花時間找側載安裝檔。側載繞過商店審核,等於把信任鏈交給來路不明的檔案,為一個免費工具冒這個險不值得。合理的做法是把它放進觀察清單,等商店恢復上架再評估。
等不及的人,現成的替代品不少,而且各有所長。想要中文介面、視覺化操作的平台型爬蟲,KSpider 可視化爬蟲平台把整個資料收集流程做成了中文產品;想要用自然語言下指令讓 AI 幫你抓資料,BrowserAct AI 網頁爬蟲走的是另一條路線。抓商家名單這類地圖資料的需求,Map Lead Scraper 是專門工具;要是願意寫一點程式換最大的控制權,開源框架 Crawl4AI 的能力上限比任何瀏覽器擴充都高。
一句話收尾:Easy Scraper 的程式碼層比它的行銷頁面誠實,資料隱私是真的,遙測也是真的;它暫時買不到這件事,反而是 2026 年認識它時最該知道的事實。