TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

思通數科 StoneDT 曾以免費多模態 AI 平台之名被推薦,2026 年 10 月實查:官網 nlp.stonedt.com 已無 DNS 紀錄,雲端入口連不上;Gitee 開源倉庫仍在,但 20 條開源 API 全是文字處理,語音、圖像、OCR 引擎從未開源。簡易版 Docker 映像檔雖可拉取,容器裡卻沒有 Python 引擎,完整功能的模型檔下載點也已失效。這篇整理授權、安全與部署現況,給想自架的人判斷。
用 AI 摘要這篇文章:
思通數科 StoneDT 在網路上流傳的身分,是「免費的語音、影片、文字、圖片多模態 AI 能力引擎平台」:自然語言處理、情感分析、實體識別、圖像識別、OCR、語音識別都算在內,而且註冊就能體驗。我在 2026 年 10 月把這套東西整個查了一遍,結論先講:它的雲端入口現在已經沒有 DNS 紀錄,瀏覽器打不開;還能用的是 Gitee 上那個 GPL-3.0 開源倉庫,但倉庫真正裝的引擎只處理文字,語音、圖像、OCR 那一半不在這個開源倉庫裡。接下來講三件事:官網發生了什麼、引擎是誰的、自架會碰到什麼。
先講怎麼確認「網站沒了」這件事,因為它跟「網站掛了」不一樣。我對 nlp.stonedt.com 查了 DNS,用 Google(8.8.8.8)、Cloudflare(1.1.1.1)跟阿里 DNS(223.5.5.5)三個公共解析器輪流問,再透過 Cloudflare 的 DNS-over-HTTPS 補一次,答案全部一樣:這個網域查不到任何紀錄。這代表問題不在伺服器臨時掛了在修,而是這個主機名稱在 DNS 裡已經不存在。README 裡提到的另外兩個入口,AI 演算法商城 aistore.stonedt.com 跟新版產品的 aiv.stonedt.com,查出來也是同樣的結果。主網域 stonedt.com 本身還解析得到一個阿里雲上海的位址,但從台灣這邊連過去會一直等到連線逾時,連 TCP 握手都完成不了。
對照時間軸,這個變化不意外。2024 年 3 月網路上流通的介紹,還把它當成「註冊即可體驗」的免費平台;倉庫的程式碼最後一次實質更動是 2024 年 9 月的一個參數修正,11 月改了安裝文件,2025 年 4 月 26 日同一天連改兩次 README,之後就停了。入口先於宣告消失,這種事在開源圈不孤單,之前 B 站最大的非官方 API 文檔庫也是一紙律師函之後兩天內清空,想找的人只能靠倉庫的歷史紀錄拼湊。倉庫本身還活著:Gitee 上的 stonedtx/free-nlp-api 有 915 顆星、411 個 fork,2022 年 2 月開張,授權條款 GPL-3.0,LICENSE 全文就放在倉庫根目錄。想接觸這個專案,今天只剩這個入口。
把倉庫的檔案清單跟關鍵原始碼抓下來看,410 個檔案裡最大宗是 262 個前端與網頁檔(ROOT 目錄),再來是 75 個 Java 檔(Spring Boot,套件名 com.yqt),而真正的 AI 引擎只有一個檔案:Python 目錄下的 NLPTextService.py,全部 205 行。
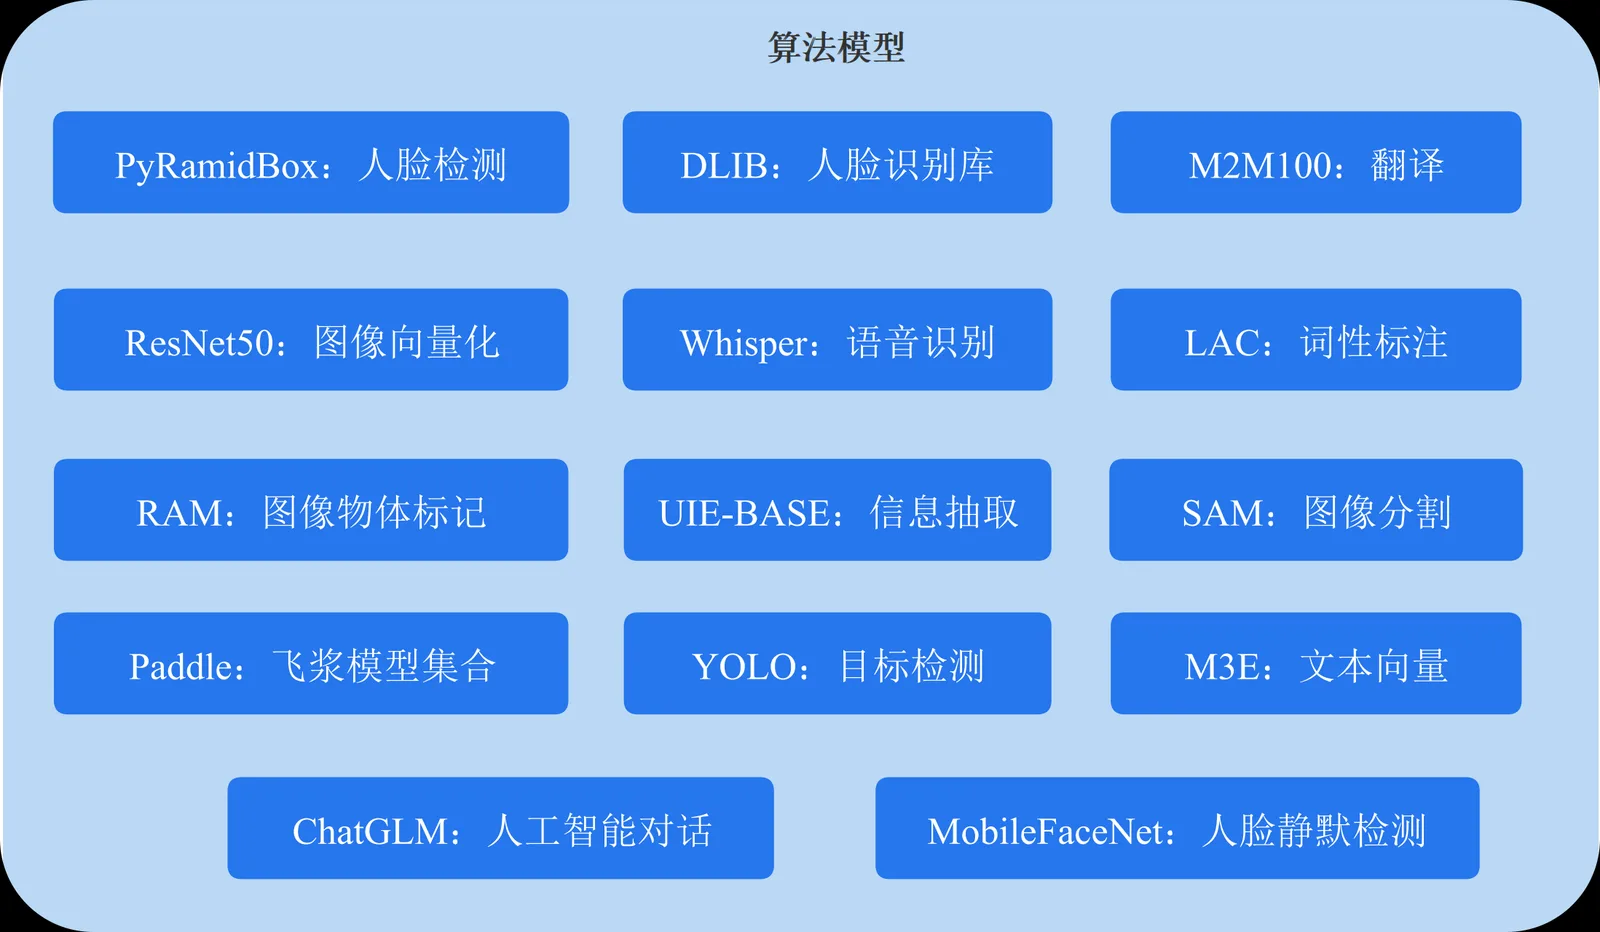
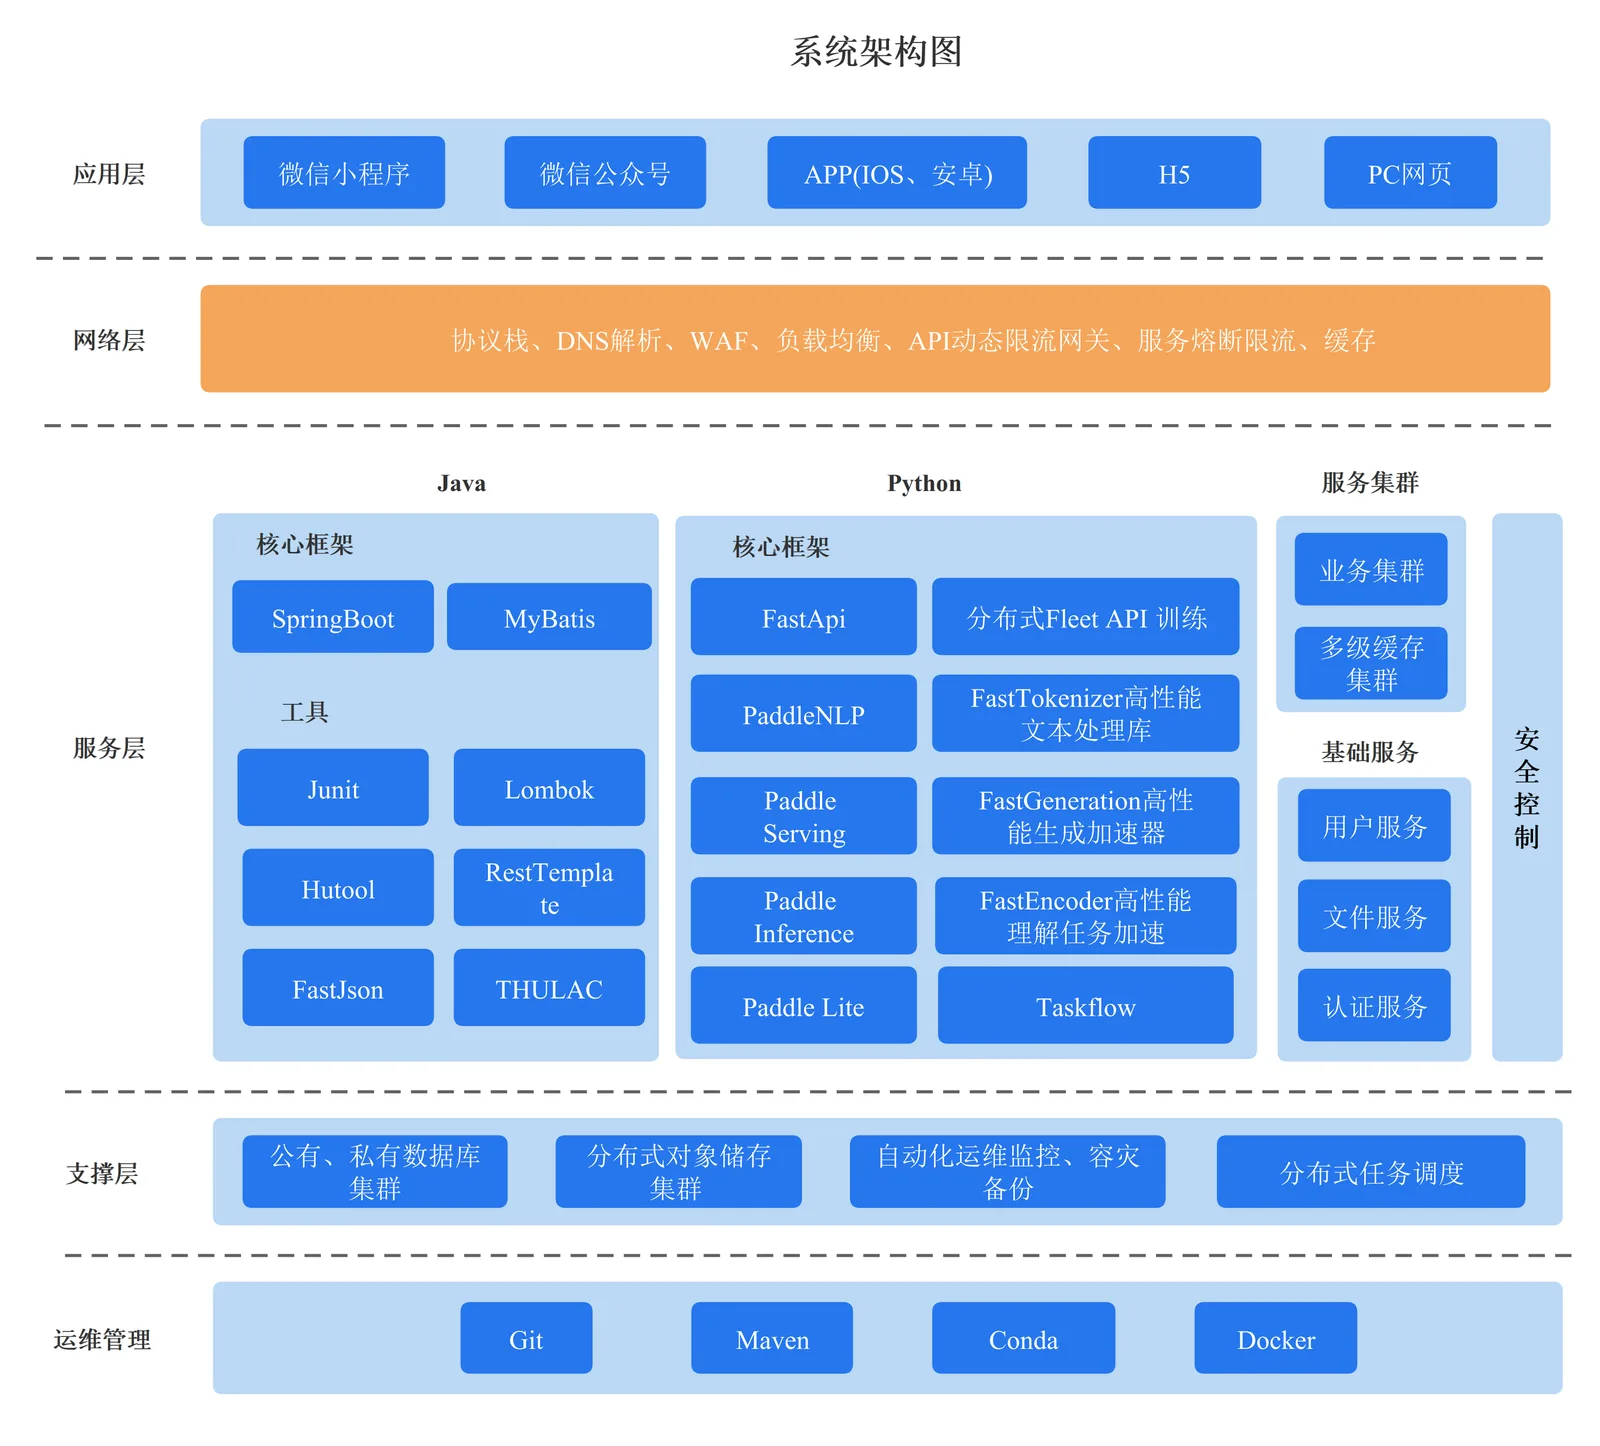
這 205 行做了什麼?它是一個 FastAPI 服務,把百度飛槳(PaddlePaddle)生態的現成模型包成 15 個 HTTP 端點,跑在 8801 埠。資訊抽取用 UIE(uie-base),而且作者自己微調了四組領域模型:履歷抽取餵了 51 個欄位的資料結構、招標抽取 46 個欄位、合同(合約)抽取 24 個欄位、法律文書 18 個欄位;情感分析用 SKEP ERNIE 大模型;另外還有命名實體識別、詞性標註、自動摘要、文字相似度、文字糾錯(pycorrector)、關鍵詞摘要(jiagu)。Java 那層做的事情是包裝:Spring Boot 在 8090 埠開 20 個 API 端點,AI 相關的多數轉手丟給 Python 服務,通用分類這類則用 Java 自帶的分類模型在本地跑,再加上帳號、統計這些企業功能需要的周邊。對照倉庫裡那張「開源演算法模型」官方圖,上面列的 14 個模型裡找得到 Paddle、Whisper、YOLO、DLIB 這些名字;圖上 Whisper、YOLO 這些語音視覺模型,正是開源程式碼裡缺席的那一半,真正在跑的文字引擎,心臟是 Paddle。這個專案自己的工程,在於把借來的現成模型裝進一套企業用的 Java 外殼。
那四組抽取資料結構,比任何行銷文案都誠實地暴露了客群。履歷那組裡有身分證號、政治面貌、籍貫這些欄位;招標那組採購單位、投標保證金、招標代理機構一字排開;合同那組是甲方乙方那一套;法律文書抽的是原告被告案由。這是一套為中國大陸的人事、採購、法務流程設計的工具,台灣的履歷跟合約丟進去,欄位對不對得上、模型認不認得台灣的用語,都是沒有人驗證過的。中文開源庫的兩岸用語落差是實際存在的成本,之前實測拼音轉換庫時,繁體詞的讀音就整批出錯,得靠外加詞庫救。
UIE 這個引擎的用法得用白話講清楚,它是整個專案最有價值的部分。你在程式碼裡看到的呼叫長這樣:指定一個模型,附上一份欄位清單,把文字丟進去,它就回傳每個欄位抽到的內容。欄位清單可以自己換,這就是那個「自訂抽取」端點在做的事。四組領域模型(履歷、招標、合同、法律文書)跟自訂抽取,本質是同一招:同一個底模,餵不同的欄位定義。真正的差異在前者用作者微調過的權重(模型檔放在 uie_modle 目錄,這也是全服務部署要抓的那些檔案),後者用通用權重當場跑。把它當 28 個獨立功能會估錯價:真正的內容是一個抽取引擎、幾組預先調好的欄位定義,再加一組情感分析、實體識別這類現成任務。
README 的應用場景清單一路編號到 27(中間 19 號用了兩次,所以實列 28 項),裡面有自動會議記錄、文字轉語音、以圖搜圖、圖像識別、OCR、支援 99 種語言的自動翻譯、私域 GPT,還有兩項驗證碼識別。但我把 Java 控制器跟資料庫種子表(api_info)逐條對過:開源版本實際提供的 API 是 20 條,每一條都是文字處理,一條語音、一條圖像都沒有。這 20 條的組成是:抽取家族就佔 8 條(合同、招標、法律文書、履歷、觀點、事件、關係、自訂),分析家族有情感、通用分類、合規檢測、主題、摘要、相似度、高頻詞,工具家族是實體識別、機構識別、詞性標註、糾錯、文字對比。全站介面簡體中文,選單裡找不到語言切換。
另外有兩個文件沒寫的硬限制,藏在程式碼裡。通用分類端點會把輸入文字截斷在前 1000 字,所有抽取端點截斷在 5000 字,超過的部分直接丟掉,回應裡不會告訴你。拿它跑長文件的人,會以為模型只讀了開頭就下結論,實際是後面的內容根本沒送進引擎。這種靜默截斷在批次處理場景是最難抓的那種坑。
這 20 條裡有一條特別能說明產品基因:合規檢測。它對應官方文件裡的內容合規審核場景,README 列的判別類別是色情、政治敏感、暴力恐怖、辱罵、廣告與垃圾訊息這一組,這是中國大陸平台營運的標準合規分類法。對台灣讀者來說,這條端點的用處有限,但它跟履歷欄位裡的政治面貌一樣,都是這套工具為誰設計的訊號:一套長在中國大陸企業合規與人事流程裡的工具,抽掉那個環境,它的預設值就不一定對得上你的需求。
自架版打包的前端選單裡,OCR、人臉偵測、圖像分類、機器翻譯、ChatGLM 這些頁面通通都在,長得很像一回事。我特別把驗證碼識別那頁的 JavaScript 抓下來看:內建的 12 張示範圖片,按下去會跳出辨識結果,但程式碼裡根本沒有發任何請求,結果是寫死在陣列裡的;上傳自己的圖片時它會去呼叫 /captcha 端點,而後端控制器裡不存在這個端點。講白了:頁面示範的是雲端版的樣子,自架版拿到的是空殼。行銷數字跟實際內容的落差,之前檢查另一個號稱八百多支影片的開源專案時也遇過,前端給的永遠比後端真實擁有的多。這裡不是猜測,issue 區也有對得上的紀錄:有人問文字轉語音模組怎麼沒開放、質疑當初說好的開源,這條 2025 年 2 月的提問到今天沒有回覆;更早還有人回報文字轉語音呼叫直接回 501。
安裝文件給的路徑分兩種。簡易版是一行 docker 指令,把 8866 埠映射出來,起容器後打開 http://IP:8866 就進系統,預設帳號 admin、密碼 123456(資料庫種子裡存的密碼就是 123456 的 base64)。我實際去查了那個放在阿里雲杭州個人版鏡像倉庫的映像檔:它存在、公開可拉,清單(manifest)正常回應,10 個層加起來約 323MB,建立時間 2024 年 11 月 19 日,跟安裝文件最後一次更新的日期同一天。這裡有個文件裡沒寫、部署前必須知道的細節:兩個版本標籤其實是兩種架構,1.0.11 是 arm64(對應鯤鵬這類 ARM 伺服器),1.0.10 才是 x86 的 amd64。安裝文件示範的指令寫的是 1.0.11,拿去一般的 x86 機器上跑,按 docker 的平台比對規則會直接告訴你沒有符合的映像檔,要自己換回 1.0.10。
至於「從台灣拉不拉得下來」,我試了三次,三次都卡在同一個地方:docker 跟鏡像倉庫要清單都正常,但下載分層資料時會被轉到阿里雲的物件儲存(OSS),這一段的 TLS 握手每次都逾時斷線。用 curl 直接去碰那個儲存節點,時通時不通,通的時候握手也要三秒。鏡像沒有被下架,卡的是跨境網路品質這一段;有代理或大陸境內機器的讀者,拉起來應該是順的,登入畫面之後的行為,也得靠那樣的環境自己驗證。從映像檔的設定看,簡易版是一個容器包全部:Java 8 的執行環境、前端頁面都在裡面,對外只開 8866 一個埠;從倉庫的前端檔案看,自架版的登入是單純的帳號密碼表單(雲端版才是微信掃碼),登入頁的標題寫著「語音影片與文字圖片多模態 AI 能力引擎平台」(原文為簡體)。
全服務部署是另一個故事。文件說除了 docker 簡易版,還可以從原始碼跑完整版,條件是 JDK 1.8 加 MySQL 5.7.24 以上(強制),Python 那側要準備至少 12GB 記憶體,設定檔裡的資料庫預設是 root/root,一堆工作路徑寫死成 D:/nlp/ 開頭的 Windows 路徑,官方的教學影片放在 B 站。而全服務要用的模型檔,issue 區的紀錄是:模型檔放在一個裸 IP(118.184.157.251 的 8866 埠)上,2024 年 12 月起有人回報抓不到,官方回覆模型可以下載、請對方用桌面瀏覽器抓,接著一個月內三個不同使用者陸續確認瀏覽器也抓不到、連 ping 都不通,這條到今天還開著。同類的還有全服務部署時 docker 提示鏡像不存在的回報,2024 年 11 月跟 2025 年 7 月各一條,都沒有下文。把這幾條時間線疊起來看:簡易版鏡像 2024 年 11 月打包上架後,全服務路徑依賴的那些下載點就陸續失效,之後再也沒有人修。官方在資料庫種子裡留下的公司資訊是南京湧億思資訊科技有限公司(蘇 ICP 備 17066984 號-1),跟 README 裡的「思通數科」招牌掛在同一個 Gitee 組織底下,看起來是同一家公司的兩個名字。
兩種部署方式的差異:
| 部署方式 | 入口 | 需求 | 現況 |
|---|---|---|---|
| 簡易版 | docker 一行指令,容器開 8866 埠 | 裝好 docker 即可,映像檔約 323MB(1.0.11 實測值) | 鏡像在庫(x86 拉 1.0.10、ARM 拉 1.0.11;本機實拉三次卡在 OSS) |
| 全服務版 | 原始碼自建,Java 在 8090、Python 在 8801 | JDK 1.8+MySQL 5.7.24 以上(強制)、Python 側至少 12GB 記憶體 | 模型檔下載點失效、部分鏡像不存在,issue 無人回 |
而且簡易版跟全服務版裝出來的東西,差距比文件暗示的更大。我把映像檔裡的啟動腳本抓出來看:它只拉起 MySQL、Redis、Nginx、Tomcat 跟 Java 後端這五件事,Python 引擎跟 PaddlePaddle 模型根本不在容器裡。這解釋了兩件事:為什麼簡易版只有 323MB、全服務的 Python 側卻要 12GB 記憶體;以及為什麼資訊抽取與情感分析那組功能在簡易版環境裡沒有本地引擎可用,介面再完整,那幾頁點下去也不會有本地結果。想在 2026 年把這個專案跑起來,簡易版是唯一現實的路,而它跑起來的其實是「介面加上不依賴 Python 引擎的部分」。
一筆是授權。專案本身是 GPL-3.0,這代表你拿去做對外服務,衍生作品也得用同一套條款開放出來,這對大多數商業場景是個硬限制。而且 GPL 之外還有依賴的問題:lib 目錄裡捆了 10 個 jar,其中 aspose-words 14.9 是 Aspose 的商業授權元件,spire.barcode 免費版有自己的使用條款,把商業元件捆進 GPL 專案散布,這件事本身就該讓法務看一眼。另一筆是安全。預設帳號 admin/123456、資料庫 root/root、會把上傳檔案落到本地路徑的設計,在內部網路的受限環境湊合可用,放到有對外風險的環境就是標準的初始化漏洞清單;簡易版容器還會更進一步,第一次啟動時自動建一個開放遠端連線的 MySQL 帳號,帳號 root111、密碼就是 root,直接寫在啟動腳本裡。這些不是要勸退所有人,而是接手一套停更專案的成本,本來就包含這些。
把 stonedtx 這個組織的倉庫列表拉出來看,會看到故事的另一半:同一個組織還有一個 stonedtaiv「AI 影片監控系統」,655 顆星,v1.2 是 2025 年 7 月發的,v2.7 在 2026 年 4 月、v2.7.4 在 2026 年 5 月,倉庫活動一路到 2026 年 10 月都還有。對照 NLP 這邊 2024 年 9 月之後程式碼就沒動過,合理的解讀是:開發組織沒有消失,開源的心力整個搬到了影片監控產品線上。這對想採用 NLP 平台的人是重要訊號,你等的那些修不完的部署問題、抓不到的模型檔,短期內不會有人來救。
講白了,2026 年的現在,這個專案對三種人有不同意義。如果你當年是被「免費多模態平台」吸引來的,那個東西已經不在了,註冊頁面連不上,不必再找。如果你是想找一套現成、有介面、可以放進內部網路的文字處理工具,殘酷的是這條路也打了折扣:抽取與情感分析那組核心功能靠 Python 引擎驅動,Python 引擎不在簡易版容器裡,全服務版需要的模型檔下載點又已失效,等於完整功能目前沒有一條官方路徑能照文件跑通,要嘛自己想辦法補齊零件,要嘛接受簡易版只跑部分功能。如果你是台灣的開發者,真正想做的事其實是資訊抽取或情感分析,那跳過這層 Java 外殼、直接用 PaddleNLP 的 Taskflow,或找持續維護的替代品,工程上乾淨得多。
「直接用引擎」具體長什麼樣?參考 NLPTextService.py 裡真的在跑的呼叫:情感分析就是指定模型叫一次 Taskflow,自訂抽取就是帶上欄位清單叫一次,絕大多數端點是這種形狀的 Taskflow 呼叫,少數走 pycorrector、jiagu 這些現成工具,差別只在模型跟參數。你的替代方案等於是把這 205 行依自己的需求重寫一遍,去掉 Java 中介層跟通用帳號系統,換上你自己的 API 包裝。對會寫 Python 的人,這是幾小時的工作量,而且拿到的是官方持續更新的模型版本;對不寫程式的人,留著思通的介面才有意義。這個分界線,比任何「推不推薦」的結論都實用。
三個常見問題,直接回答。
官網還會回來嗎? 沒有人宣布下線,DNS 紀錄也隨時可以加回來,但對照開發組織已經把產品重心移到影片監控,以及 README 停更的事實,把「隨時會回來」當計畫依據是危險的。
簡體介面有繁中版嗎? 沒有。全站簡體,官方文件放在騰訊的文件服務上,支援管道是微信跟微信群(群超過 200 人要加產品負責人微信拉進去),這些都是為中國大陸使用者設計的。
直接用 PaddleNLP 會不會比較好? 要看你要不要那層介面。PaddleNLP 是這個專案的引擎本體,官方持續維護、文件完整,缺的是現成的網頁操作介面跟帳號管理;思通給的正是那層殼,代價是接手一套停更的 GPL 專案。要介面留思通,要引擎用源頭,這樣選就不糾結。