TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

Recursive 發布開放權重編碼模型 Flint:398 億總參數、每詞元約啟用 25 億的 MoE,Apache 2.0 釋出。本文回到模型卡與官方文件,釐清量化版本選擇、評測分數的同級範圍、512k 與 262,144 的上下文落差,以及 48GB 記憶體起的硬體門檻。
用 AI 摘要這篇文章:
10 月 21 日(台北時間 22 日凌晨),AI 研究公司 Recursive 發布了該公司第一個模型 Flint:總參數 398 億、每次生成一個詞元約啟用 25 億的混合專家編碼模型,權重以 Apache 2.0 授權在 Hugging Face 完整公開。要在自己的機器上跑起來,官方文件給出的最短入口是一行指令:已經在用 Ollama 的人執行 <code>ollama run flint:40b-a2b-qat-int4</code>,Mac 使用者執行 <code>rec launch pi</code>,工具會自己下載模型並接上代理介面。
比指令本身更值得先弄清楚的,是它背後的三件事:你實際下載的是哪個版本(80GB 的原始權重與 23GB 上下的量化版是不同入口)、官方分數宣稱裡的「同級」畫在哪裡,以及公告文案寫的 512k 上下文,和可下載檔案裡的 262,144 並不是同一個口徑。
Flint 這次釋出分成四個儲存庫。原始的 BF16 版本約 80GB,切成 15 個 safetensors 分片,附上分詞器、對話模板與一套 SGLang 服務套件,模型卡寫明的起跑線是一張 B300 或 H200。這是規格的源頭,也是一般開發者最不會直接碰到的版本。
實際會被下載的是兩個量化版。Apple Silicon 走 MLX 格式的 INT4 版,投影層與專家用 group-64 affine INT4、嵌入層用 INT8,整包約 22.6GB;NVIDIA 走 llama.cpp 的 NVFP4 GGUF 版,單一檔案 22.9GB,官方建議至少 48GB 的 GPU 記憶體,已在 B300、RTX PRO 6000 Blackwell、RTX Spark 與 DGX Spark 上測過。Ollama 則把 QAT INT4 版打包成 <code>flint:40b-a2b-qat-int4</code>,一行指令直接對話;官方文件另提供 OpenCode、Pi、Codex、VS Code、Cline 與 OpenHands 六種代理介面的接入說明,走的是 Ollama 在本機開出的 OpenAI 相容端點。想自己控制版本與參數的人,llama.cpp 路線要留意兩件事:官方指定「與 Flint 相容的修訂版」而不是任意最新版,內容長度由 <code>–ctx-size</code> 決定且代理介面的預算要跟著對齊,否則模型看得到的能力會被介面截掉。
| 你手上的硬體 | 官方建議的入口 | 下載量級 |
|---|---|---|
| Mac(M4 Pro 以上、48GB 統一記憶體起) | <code>rec launch pi</code> 自動下載並接上 Pi | 約 30GB 磁碟空間 |
| Mac(想自選執行器) | LM Studio/Unsloth 走 MLX INT4;llama.cpp 走 Q4_1 GGUF | 22.6GB/26.0GB |
| NVIDIA GPU(48GB 記憶體起) | llama.cpp CUDA+NVFP4 GGUF | 22.9GB 單檔 |
| NVIDIA 伺服器 | SGLang(BF16,單 B300/H200)或 vLLM day-0 映像 | 約 80GB |
| 沒有對應硬體 | OpenCode 託管免費層、Pi 經 Radius 免費試 | 不下載 |
rec 是 Recursive 同日開源的命令列工具(Apache 2.0,GitHub 倉庫在公告前不到一小時建立),安裝前會先檢查晶片與記憶體:只支援 M4 Pro、M5 Pro、M5 Max,統一記憶體低於 48GB 會直接拒絕下載。想接自己的編輯器,<code>rec serve</code> 會在本機 11500 埠開出 OpenAI 相容的 Chat Completions 端點,金鑰用 <code>rec auth token</code> 取得,官方文件示範了 Cline 與 VS Code 原生聊天室的接法。它的伺服器一次只處理一個生成請求,重疊的請求會收到 HTTP 429;NVIDIA RTX Spark 的支援官方標註為即將推出,尚未包含在這次釋出。沒有這些硬體的讀者,官方另外提供 OpenCode 上的託管 Flint-40B 免費層(有容量與速率限制),Pi 也可以經由 Radius 免費試用,直接接 API 則限特定合作夥伴。
模型卡公布的三個代理評測成績是 Terminal-Bench 2.1 的 54.9%、SWE-bench Pro v2 的 89.7%、SWE-bench Verified 的 74.2%,比較圖上另有 LiveCodeBench v6 的 80.3%、IFBench 的 89.2% 與 IFEval 的 95.1%。這些是發布方自己的評估,而且每一項都有明確的量測條件:取樣設定固定在溫度 1.0、top-p 0.95、top-k 20;Terminal-Bench 用 Terminus 2 框架、允許連網,但透過網路直接取回解答的題目計為失敗;兩個 SWE-bench 用 mini-swe-agent、不連網;代理類評測的逾時上限放寬到五小時,成績是至少五次嘗試後的平均 pass@1,這個數字代表單次執行的成功機會,多次嘗試只是取平均的樣本。想重現比較的人,這組取樣參數與框架選擇都得照抄,換掉任何一項就換了一組條件。量化版的差距也有數字:NVFP4 版在同一組評測上分別是 53.7%、88.5%、74.1%,與 BF16 的落差都在一個百分點上下。
宣稱的範圍也寫得很清楚。公告原文的說法是:Flint 在總參數少於 500 億的 MoE 模型中,於這幾項代理編碼評測領先;與 25 至 400 億參數的 dense 模型相比,官方的賣點是編碼表現相當、速度快五倍以上,而非分數更高。對照官方發布的比較圖,Qwen 3.8 在 Terminal-Bench 2.1 拿 73.0、SWE-bench Verified 拿 75.6,多數單項分數高於 Flint 的 54.9 與 74.2;Flint 在 IFBench(89.2)與 IFEval(95.1)兩項則是圖上最高。圖上另一個細節是量測來源:標 † 記號的數字由 Recursive 自測,其餘引用各開發者回報,兩邊不是同一套重測條件。
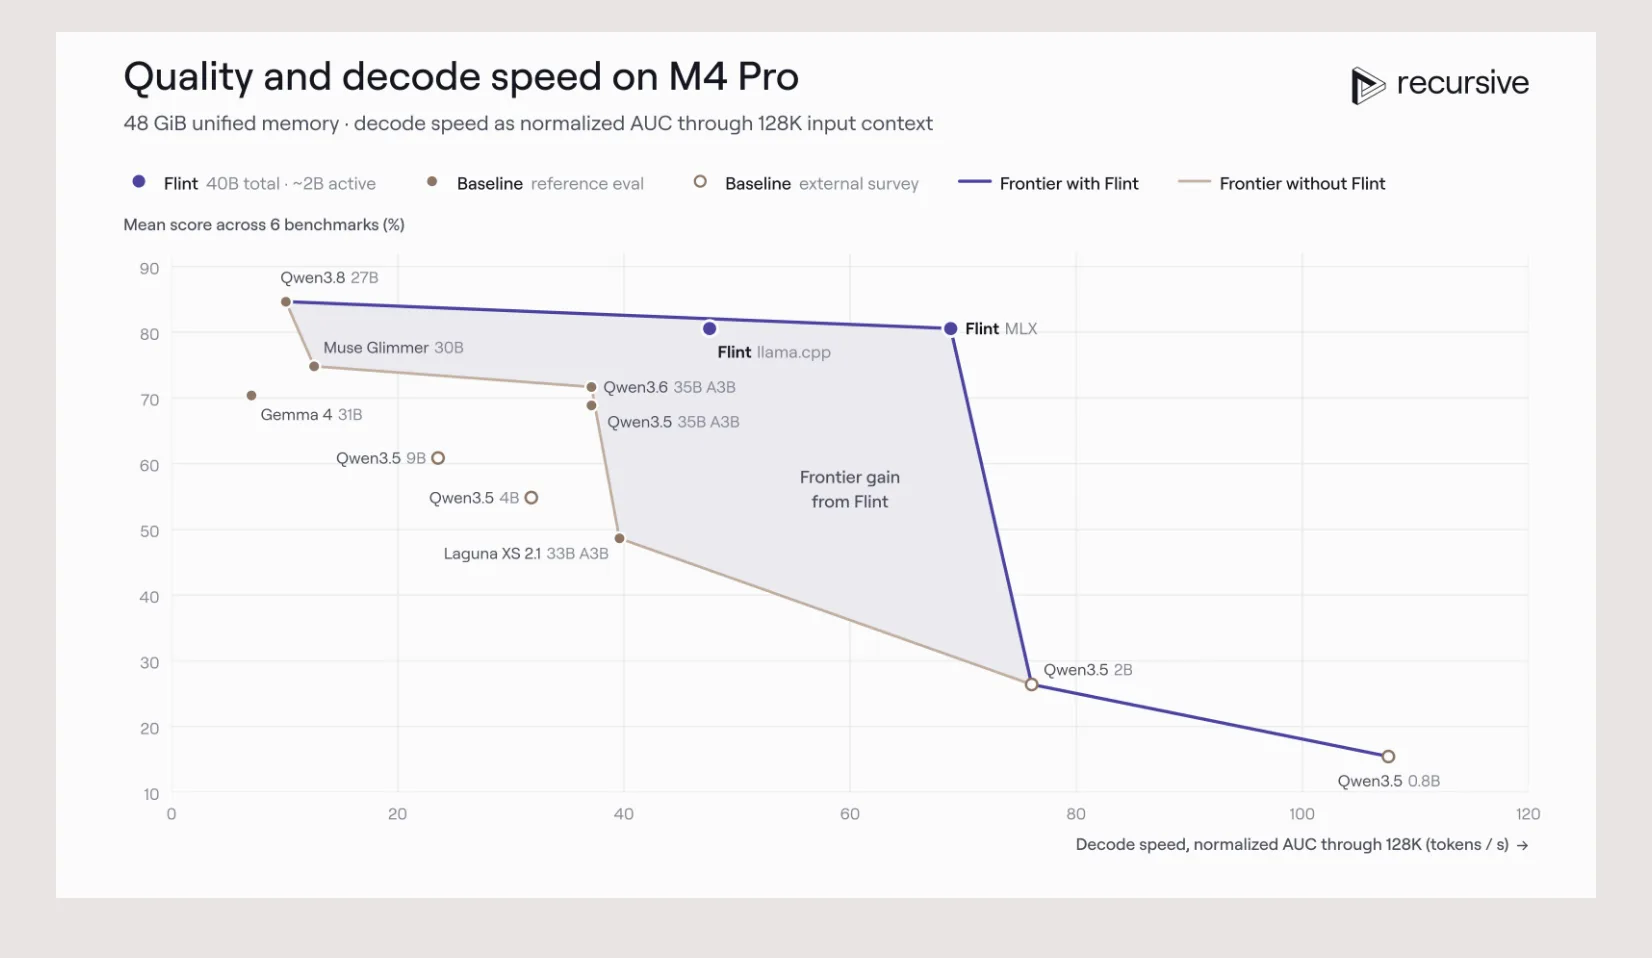
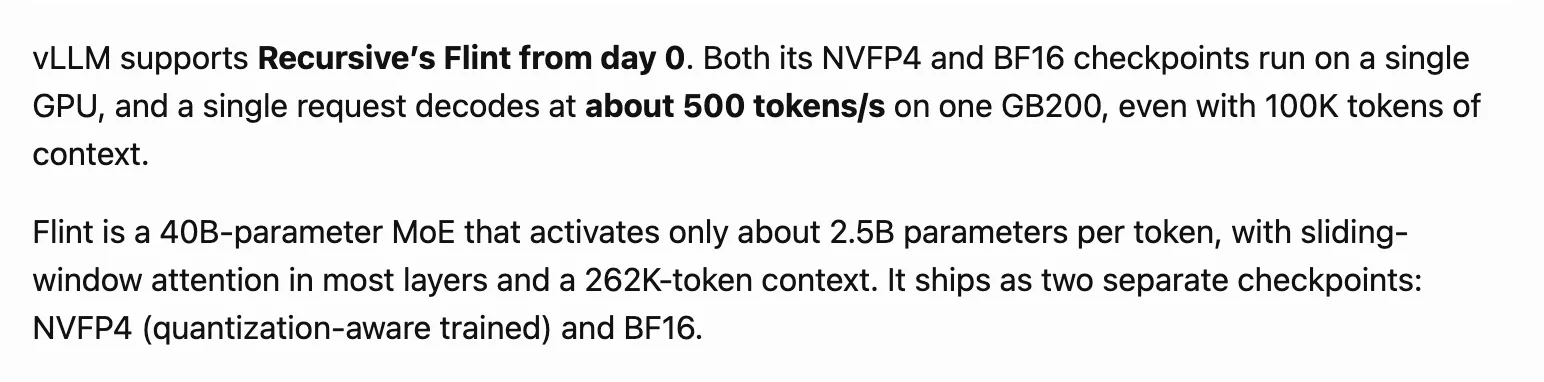
速度宣稱同樣出自發布方:短上下文下,M4 Pro MacBook Pro 超過每秒 125 詞元、64GB 的 NVIDIA RTX Spark 超過每秒 150 詞元,比同類模型快至多兩倍;圖表上的速度口徑是整段約 128k 詞元工作階段的平均生成速度,且排除預填(讀入提示的等待時間)。獨立於 Recursive 的旁證來自 vLLM 團隊的同日文章:在單張 GB200 上、帶著 100K 上下文解碼,一個請求約每秒 500 詞元。這些數字都值得用實際工作負載再驗,但至少量測條件是攤開的。
公告也給了使用建議:把它當日常工作用的本機編碼模型,複雜任務先拆成小任務、給明確指示;官方自己也說,它需要的引導會比大家慣用的大型閉源編碼模型多。這句話對想要「下載完就有雲端代理完整體驗」的人是重要的期待管理。
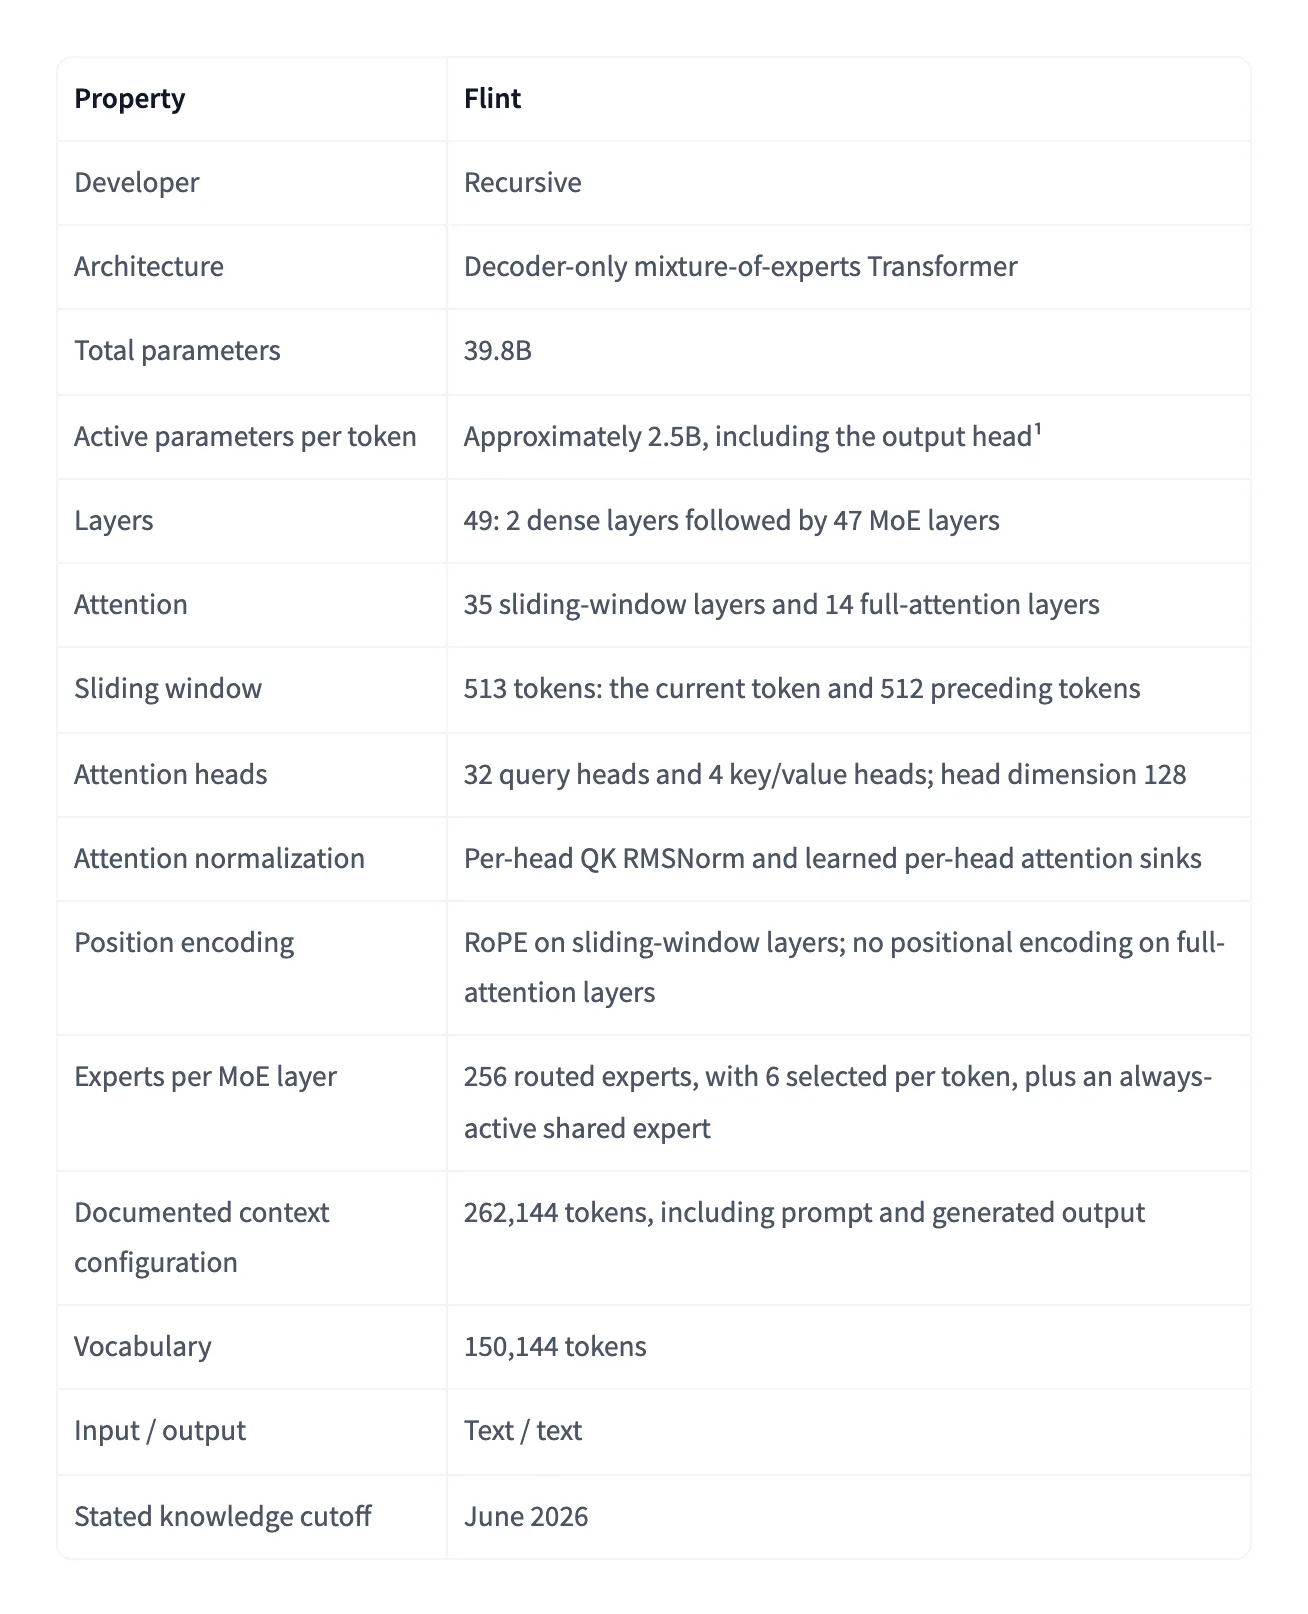
從 Hugging Face 上的 config.json 可以直接核對這個模型的骨架:49 層(前兩層 dense、其餘 47 層 MoE)、每層 256 個路由專家、每個詞元只挑 6 個加上一個常駐共享專家;注意力端 35 層用 513 詞元的滑動視窗、14 層看全文且不加位置編碼,查詢頭 32 個、鍵值頭只有 4 個,路由用 sigmoid 分數選前 6 名專家,前兩層不設專家、走一般的全連接層。vLLM 的整合文章補了一個成本視角:只有那 14 層全注意力需要為整段序列保留 KV 快取,每詞元約 28KiB,這是長上下文能在消費級硬體上站得住的結構性原因。
Recursive 把研發故事歸給該公司的自動化研究系統 Eureka Machine:提出想法、實作、測試,再用結果決定下一步,多條路線平行推進。官方對 Flint 的描述是「一小隊人與代理在四個月內從零訓練完成」,Eureka Machine 參與了「模型製作堆疊幾乎每個部分」,從資料、優化器、訓練配方到基礎設施與推論;這套系統六月中的初次成果(模型訓練與 GPU 核心任務)也列在官方部落格上。對應到可核對的環節有三個。架構搜尋:從 350 億總參數、30 億啟用的基線出發搜尋專家配置與寬度,最後採用 400 億、25 億的組合,官方稱這個組合在其測試過的配置中預期有最好的速度與編碼表現平衡。量化:把輸出層壓到 4 位元,官方說這與常見做法相反,理由是啟用參數只有 25 億時,輸出層佔每個詞元權重讀取量的比例相當大;再用 16 位元模型當老師做離線蒸餾,讓訓練步數相對原本的量化感知訓練基線近乎減半,最終 NVFP4 版在官方評測上與 16 位元版平均差距不到 0.7 分。核心程式:為 Apple Silicon 與 RTX Spark 產出特化核心,在 M4 與 M5 上把整個解碼前向融合成單一 Metal megakernel。
這段研發敘事是官方單方說法,沒有第三方重做驗證;但落地痕跡查得到。vLLM 團隊在發布同日刊出 day-0 支援文章,提供內建 Flint 的 Docker 映像,並揭露整合細節:Flint 發出的是 GLM-4.7 風格的工具呼叫與思考區塊、推理計入輸出詞元、核心程式針對單張 Blackwell GPU 最佳化(其他設定退回標準層),對應的支援 PR #62938 正在合併流程中。vLLM 團隊也把他們的最佳化過程寫成紀錄:直接用現成層組合的第一版,單次解碼要跑 1,096 個核心、小批量場景偏慢;換成 Flint 專用核心後降到 346 個,NVFP4 單步解碼從 4.81 毫秒縮到 1.78 毫秒。這也是辨識「第一天就能用」的實際依據:能不能跑,看的是執行器端有沒有把它的對話模板與工具解析接好。
公告寫 Flint 支援最高 512k 詞元的上下文,並建議日常使用留在 256k 以內。但翻開實際發布的檔案:BF16 的 config.json 裡 max_position_embeddings 是 262,144,INT4 版相同;模型卡規格表「記載的上下文設定」欄是 262,144;官方文件對託管服務的說明、以及隨權重附的 Pi 設定檔 contextWindow 同樣是 262,144。所有可下載與文件層的數字都指向 262,144(這個容量含提示、對話歷史、工具定義、工具回傳、推理與最終回答),512k 只出現在公告行銷文案裡,對應哪個 checkpoint、哪個執行器,官方沒有說明。
對部署者的實際建議因此很簡單:以你手上權重的設定檔與執行器限制為準,不要因為公告寫了較大的數字就預期每個版本都開得到同樣長度。官方文件自己也提醒,上下文容量是能力上限,不保證模型對其中每一段內容的掌握都一樣均勻,記憶體、量化與快取設定決定你的機器實際放得下多少。
另一個容易踩的坑是輸出預算。Flint 的推理功能永遠開啟,而且推理過程計入輸出詞元:模型卡建議困難問題至少保留 32,768 個輸出詞元,託管設定的輸出上限是 65,536。回應若以長度原因中斷,官方的建議是加大輸出預算或縮短對話;重問並不會放寬長度限制。
這次釋出適合的對象輪廓相當明確:想讓程式代理留在本機處理程式碼、硬體在門檻上(48GB 統一記憶體的 Mac,或 48GB 記憶體起的 NVIDIA 卡),而且願意自己管理執行器與權重版本的人。Apache 2.0 讓商用與修改都沒有授權障礙,訓練資料的組成(公開與爬取的網路文件、文字與程式、商業授權資料、AI 合成資料)也寫在文件裡。要留意的限制同樣具體:rec 一次只服務一個生成請求;模型知識截止 2026 年 6 月;Transformers 建模程式尚未併入官方套件,Python 直接載入還得靠整合 fork;模型卡的安全提醒直說,結構化的工具呼叫文法正確,不代表模型選的動作就是安全或正確的,應用層要自己管好權限邊界。也別忘了分工:Flint 只負責生成文字與工具請求,讀檔案、跑指令、套用修改的是外層的代理介面,模型在本機不代表你接的搜尋、外掛服務也都在本機。
公司本身的背景讓這次發布多了幾分看頭。Recursive Superintelligence, Inc. 的執行長是 Richard Socher(他同時掌管 You.com,九月的專訪裡介紹了他談自動化研究的新書,書名就叫 The Eureka Machine),公告頁同場連結的五月紐約時報報導描述這是一家由前 Google、Meta 與 OpenAI 研究者組成、參與 40 億美元級自進化 AI 競賽的公司。官方對 Flint 的定位說得很直白:這是起點,賭的是更強的模型讓 Eureka Machine 成為更好的研究者,再回頭把下一代做得更快。從讓代理在模擬經驗裡改進探索的 Dream-RSI,到開放 GPT-6 讓代理從糾正中學習的 ScienceBuddy,自動化研究系統的產出開始以可下載的模型形式落地,而為前沿 AI 設速的治理討論也因此多了一個具體案例。
發布當下的未確認事項,建議一週後回查:512k 上下文對應的版本何時落地、rec 的 RTX Spark 支援、vLLM PR #62938 的合併進度,以及 Transformers 建模程式的釋出。這四項任何一項更新,都會改變「現在就要不要抓 22.6GB 下來」的答案。