TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

NVIDIA 開源的 PersonaPlex 語音模型能邊聽邊說,插話與附和都做進模型本身,十月一則 X 貼文再把它推上熱門。這份資產其實一月就公開、倉庫三月後靜止,本文照官方研究頁、GitHub 與 Hugging Face 模型卡,把能力、成績單的贏面輸面、授權與英文限定攤開來讀。
用 AI 摘要這篇文章:
一套電話客服系統最讓人受不了的,往往不是答錯,而是它聽不見你接下來說的話。你報到一半的訂單號碼想改查另一筆,機器人還是照原稿唸完,你只好等它說完再重來一次。NVIDIA 在一月公開的開源語音模型 PersonaPlex,針對的就是這種卡住的片刻:模型說話的同時持續聆聽,你插話它就停,你停頓它就接。十月十一日一則 X 貼文讓這套模型再度衝上熱門,四千四百多個讚把它推回大眾視野,也讓不少團隊以為 NVIDIA「剛」開源了一個新語音模型。
把官方文件的日期攤開,時間軸其實很清楚:這是一份去年十二月三十一日就把權重放上 Hugging Face、一月十五日刊出研究頁的研究資產,倉庫最後一次更新停在三月二日。能力是真的,熱潮的時間感是錯的。想評估它的人,拿到的是一份完整但停在三月的研究快照。
這波討論的起點,是 X 帳號 Oliver Prompts 在十月十一日發的影片貼文,開頭寫著「NVIDIA really removed the biggest friction point in Voice AI」,接著介紹這套開源的全雙工對話模型 PersonaPlex-7B,說它可以邊聽邊說,用雙流架構同時處理輸入與輸出。到十月十三日,這則貼文累積四千四百多個讚,幾小時後也有科技媒體跟進報導。
貼文裡的「雙流」(dual-stream)並非行銷詞。Hugging Face 模型卡原文寫明 PersonaPlex 採用 dual-stream configuration,聆聽與說話同時進行:使用者的聲音持續編碼、增量餵進模型,模型一邊更新內部狀態、一邊串流輸出自己的語音,所以能處理插話、搶話、話語重疊與快速換手這些傳統語音助理做不好的動作。
「全雙工」是電話線路時代就有的概念:雙方可以同時講話,不必輪流。對照目前常見的語音助理做法,先把你說的話轉成文字、交給語言模型想答案、再合成語音播出,三段流程依序跑,每一段都在累積等待,人也只能在一句話完全結束後才插得上話。全雙工模型把聽與說放進同一顆模型,等於把對話的節奏感也變成模型要學的東西:什麼時候停、什麼時候插話、什麼時候只回一聲「嗯」。
這個「嗯」在官方文件裡有名字,叫附和(backchannel)。研究頁的示範段落裡,模型在對方講話時會自然冒出「oh okay」「yeah」「yeah, I think they do」這類短回應,標示自己還在聽,而且內容跟著對方的話題走。這種細節正是串接式系統做不出來的:轉成文字的中間層裡,沒有「正在聽」這個狀態可以表達。
把三個官方來源的日期排在一起,這份資產的年紀一目了然。模型權重 nvidia/personaplex-7b-v1 在 2025 年 12 月 31 日上傳 Hugging Face,換算台北時間正好是元旦凌晨;GitHub 倉庫 NVIDIA/personaplex 於 2026 年 1 月 5 日建立;論文 1 月 14 日提交到 arXiv(編號 2602.06053);NVIDIA 研究頁 1 月 15 日刊出。一月十七日起 MarkTechPost 等媒體就有首波報導,the-decoder 在一月下旬跟進;三月五日有人在 HN 分享把它移植到 Apple Silicon 的做法,拿下三百多分與一百多則討論;七月有科技媒體實際在本機跑起來的報導,同月甲骨文也發文教人用它搭配 LiveKit 架二十四小時醫療電話代理;八月有入門解說文。到了十月,它又迎來一整波重新發現。
更值得注意的日期是 2026 年 3 月 2 日。這是倉庫最後一次 commit,內容只是更新 README。此後七個月,NVIDIA 沒有再推送任何程式碼,但社群的動作沒停:截至 10 月 13 日,倉庫累積一萬一千一百多顆星、一千五百多次 fork,留著 32 個開著的合併請求,其中 17 個是四月以後才提交的,另有 38 個議題開著未結。最有存在感的一則議題從一月一路更新到七月:在 DGX Spark 上語音斷斷續續無法使用,累積五十八則討論,到十月仍開著未解。下載熱度倒是另一個故事,同一時間 Hugging Face 頁面過去三十天仍有超過十六萬次下載、兩千八百多個收藏,凍結的是上游,不是使用者的興趣。
換句話說,熱潮描述的「NVIDIA 開源了」,精確地說是「NVIDIA 在一月開源了,而且三月之後就沒再動過」。這不影響你下載使用,但影響你對它的期待:遇到問題時,上游不會有人接手。
PersonaPlex 並非從零訓練的新架構。官方 README 寫得直接:它以法國實驗室 Kyutai 的 Moshi 架構與權重為基底微調而成,底層語言模型是 Kyutai 的 Helium。模型卡標示參數量 7B,但實際下載的權重檔有 16.7 GB,以 bf16 精度換算約 83.7 億參數,比名字裡的 7B 多出一截。
它在 Moshi 之上多出來的能力,是把「扮演誰」拆成兩個獨立的輸入。聲音提示是一段音訊嵌入,決定音色、說話風格與韻律;文字提示用自然語言描述角色、背景與情境。兩者組合出完整的對話身分,而且可以分開替換:同一個客服角色換聲音,或同一個聲音換角色,都行。倉庫預先打包十八種聲音(自然女聲 NATF0 到 NATF3、自然男聲 NATM0 到 NATM3、多樣女聲 VARF0 到 VARF4、多樣男聲 VARM0 到 VARM4)。
官方給的角色提示範例,看得出微調時鎖定的場景。客服類的提示會把機構名、員工姓名、價目與規則整包寫進去,例如替垃圾清運公司接電話的 Ayelen Lucero,要核對客戶姓名、行程是隔週收運、堆肥桶加購每月八美元;替餐廳接電話的 Owen Foster,得記住兩款主菜的價差、單點品項與「沒有組合優惠」。研究頁還示範了銀行客服的情境:客戶一筆一千二百美元的交易被擋下,提示詞裡寫明交易發生在邁阿密、客戶平常在西雅圖消費,模型要照這些線索核對身分再回應。閒聊類的提示則從一句「你喜歡好好聊天」到附上姓名、職業、住處與好惡的完整人設都有,層次刻意拉開,用來平衡泛化與聽話程度。
訓練資料同樣攤得很開。真實對話來自 Fisher 英語語料庫,共 7,303 通、1,217 小時的真人電話對話,用 GPT-OSS-120B 回頭為每個說話者標上個性描述。合成對話則用 Qwen3-32B 與 GPT-OSS-120B 生成文稿、Chatterbox TTS 轉成語音,包括 39,322 段助理對話(410 小時)與 105,410 段客服對話(1,840 小時)。官方的說法是兩種資料各取所長:真人錄音提供了 TTS 做不出來的自然語氣與附和行為,合成資料提供了角色遵循與任務知識。有趣的是,官方還發現微調後的模型會表現出訓練資料沒有的行為,例如照著「太空反應爐事故」的提示進入緊急搶修角色,他們推測這是基底模型 Helium 預訓練留下的泛化能力。
NVIDIA 在研究頁給出的評比結論相當強:在對話動態、回應與插話延遲、任務遵循三個面向勝過其他開源與商用系統。數字本身有支撐,但分項讀會看到另一個故事。對話動態的成功率採用 Takeover Rate 指標衡量,也就是模型在該接話或該停下的時刻真的行動的比例,停頓處理則反過來算,不搶話才算成功。
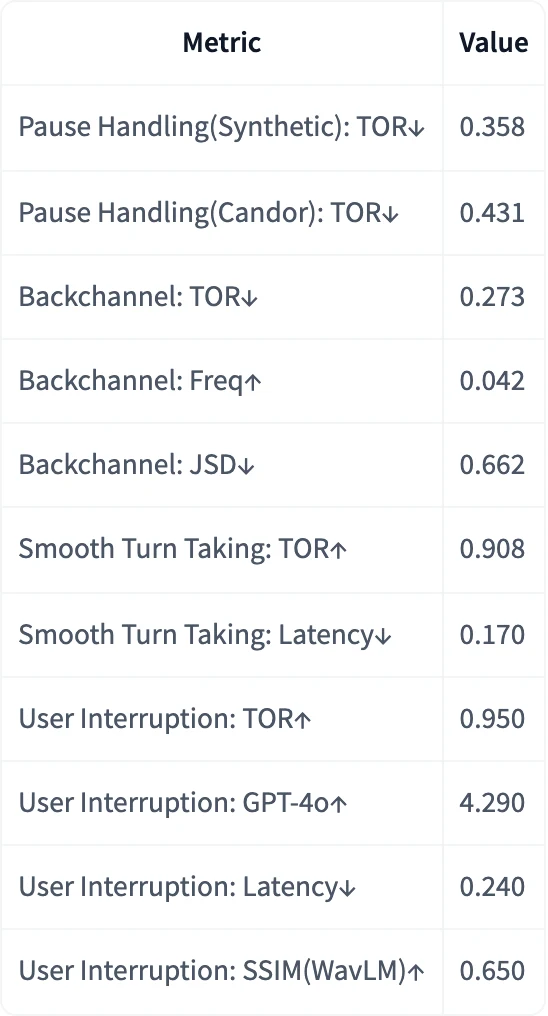
延遲確實是強項。在 FullDuplexBench 評測裡,順暢接話的回應延遲 0.170 秒、插話發生後停下來的延遲 0.240 秒,都是比較群中最低;對照組裡的 Gemini Live(gemini-2.0-flash-live-001)分別是 0.953 與 1.409 秒,Qwen 2.5 Omni 是 1.181 與 1.242 秒。對話動態的成功率也是冠軍:順暢接話 90.8、插話處理 95.0,Moshi 是 82.1 與 94.1,Freeze Omni 的順暢接話只有 1.8。
但有三個數字藏在「平均勝出」底下。停頓處理一項,PersonaPlex 拿 60.6,Moshi 是完美的 100.0,等於微調把基底模型最擅長的一項弄弱了。任務遵循用 GPT-4o 當裁判:在 FullDuplexBench 上 PersonaPlex 得 4.29,輸給 Qwen 2.5 Omni 的 4.59;在自家擴充的客服情境評測 ServiceDuplexBench 上得 4.40,輸給 Gemini Live 的 4.73。贏的是五個系統的平均值(4.34 對 4.05、3.82、3.68),單項其實互有勝負。
還有一個更實際的問題:這些客服情境的成績出自 ServiceDuplexBench,而這個評測集至今沒有公開。一月的研究頁寫「近期發布」,模型卡寫「即將推出」,到了十月,倉庫裡依然找不到它,八月還有人開議題直接問去哪了,無人回應。你想自己驗證「客服情境比較強」這個賣點,目前沒有材料。
授權面倒是不含糊,分三層。程式碼採 MIT 釋出;模型權重採 NVIDIA Open Model License,條文明載可用於商業用途、允許建立與散布衍生模型、NVIDIA 不主張對模型輸出的所有權;基底 Moshi 權重則是 Kyutai 的 CC-BY-4.0。想商用的人,這條路是通的,代價是權重放在設了閘門的 Hugging Face 頁面,下載前要登入帳號、勾選接受條款,再設定存取憑證。
官方 README 給的操作路徑完整但不花俏:先裝 Opus 音訊編解碼的開發套件,pip 安裝倉庫裡的 moshi 套件,之後一條指令啟動伺服器,瀏覽器打開本機 8998 埠的網頁介面就能對話。GPU 記憶體不夠可以加參數把部分模型層移到 CPU;也有離線評估腳本,串流讀入一段 WAV、輸出同樣長度的回應音訊與文字紀錄,適合反覆餵同一份素材比較修改前後的差異。音訊取樣率固定 24kHz,嫌指令流程麻煩的人,倉庫裡也附了 Docker 設定檔可以直接起環境。
硬體面要注意相容清單只列了 Ampere(A100)與 Hopper(H100)兩代架構搭配 Linux,測試硬體寫的是 A100 80GB;README 另外註明 Blackwell 顯卡要額外改裝 cu130 版 PyTorch 才跑得動,這條注意事項來自一則社群議題,不在模型卡的正式支援列表裡。想在 Mac 上跑的人,社群的 Apple Silicon 議題也還開著,答案同樣要自己找。
模型卡對使用範圍的描述只有一行,但這一行對要做中文服務的團隊很關鍵:英文語音輸入、英文語音輸出。訓練裡唯一的真實語料是 Fisher 英語語料庫,官方文件裡看不到任何中文、台語夾雜或混合語言場景的測試。把它放進中文客服流程之前,你得自己準備中文錄音驗收,官方文件幫不上忙。這與主打繁中同傳的 Qwen3.8-LiveTranslate 或把語音層與推理層分開計費的 GPT-Live-1 語音 API 是不同的定位,前者一開始就把中文同傳當賣點。
把全部邊界攤開,PersonaPlex 的樣貌是:一份公開透明、授權乾淨、能力有數字支撐的研究資產,只支援英文,需要 A100 等級的顯卡才順,上游三月後不再維護,承諾的客服評測集沒有兌現,社群的修正持續堆在門口沒人收。十月那則貼文說它移除了語音 AI 最大的摩擦點,就「模型聽得懂節奏」這件事,它確實做到了;但採用決策的另一個摩擦點,也就是這個專案還有沒有人在顧,答案寫在倉庫的 commit 紀錄裡。對想做全雙工語音體驗的團隊,它適合當研究與原型的起點,權重、程式碼與論文都攤在可核對的位置;要扛上線,先想清楚你接手的是一份凍結的快照,後續的修補、調校與硬體適配都會落在自己團隊身上。