TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

MIT 實驗室的 PDF2Audio 能把論文轉成雙人播客音檔,模型、聲音與五段 prompt 都能自選。不過 GitHub 開源版停在 2025 年 4 月,持續吃到新模型的版本只在 Hugging Face 線上版,要用之前值得先分清楚兩者差異。
用 AI 摘要這篇文章:
2024 年 9 月,MIT 的原子與分子力學實驗室(LAMM)把一個能把論文變成雙人播客的網頁工具放上 GitHub,兩年累積到 1,384 顆星,Hugging Face 上的展示頁也收了 462 個讚。這個叫 PDF2Audio 的工具現在還在、還能用,但它已經悄悄變成兩個東西:一個是 GitHub 上停在某個春天的開源專案,另一個是 Hugging Face 上持續改版的線上服務。想用的人該走哪一邊,差別比多數人以為的大。
會有這個工具,背景是實驗室的研究計畫而非創業案。它隸屬 Buehler 團隊的 SciAgents 系列(用多智慧體做材料發現的研究),README 引的兩篇論文都在講知識圖譜推理,附的樣本音檔轉的也正是自家論文;程式碼也以另一個開源專案 pdf-to-podcast 為底改出來。這種出身影響了它的長相:功能前沿、prompt 全部攤開,但安裝體驗和長期維護都是實驗室規格。
GitHub 上的 main 分支,最後一次 commit 停在 2025 年 4 月 18 日,訊息是「Add files via upload」。往後一年半,issue 一個一個開進來,沒有任何一筆新的 commit。36 個 commit 全部來自同一個帳號:LAMM: MIT Laboratory for Atomistic and Molecular Mechanics,Markus Buehler 實驗室的組織帳號。這是很典型的學術展示程式:論文發完、展示做完,原始碼就地封存。
但同一時間,Hugging Face Space 上的那份 app.py 一直有人改。Space 的版本歷史顯示,2025 年 8 月 30 日、12 月 30 日、2026 年 5 月 2 日、7 月 17 日、9 月 11 日,各有一次實質更新,全部只發生在部署端,一次都沒有同步化到 GitHub。
兩份 app.py 的大小差了 11.5 KB,差的不只是體積。打開模型選單:GitHub 版的文字模型清單停在 o1、o3、o4-mini、gpt-4.1、gpt-4o 那個世代,介面預設值是 o3-mini;Space 版的清單多了 gpt-5.2、gpt-5.5、gpt-5.6-sol、gpt-5.6-terra、gpt-5.6-luna、gpt-6-astra 等一整排新模型,預設值直接指到 gpt-6-astra。內建模板的數量也不同:GitHub 版 11 種,Space 版 13 種,多出來的兩種是「深度研究報告」和「逐字朗讀」,後面會講到它們在做什麼。Space 版還多了 GitHub 版完全沒有的連網搜尋開關,生成講稿時可以讓模型自己去查資料補充。
換句話說,PDF2Audio 的「開源」是真的(Apache-2.0 授權,LICENSE 檔完整),但開放出來的是 2025 年 4 月的身體。持續吃新模型、長新功能的版本,只活在別人雲端上的那個部署,而且那個部署跑的是 Hugging Face 免費帳號等級的 cpu-basic 硬體;反正運算都發生在使用者自己的 API key 上,實驗室出的只是介面。服務會不會一直開著,取決於實驗室還願不願意按那個更新按鈕。
從程式碼看,生成管線分成幾步。pypdf 先把上傳的 PDF 抽出文字,副檔名也接受 Markdown(.md、.mmd)和純文字檔;接著用 OpenAI 的文字模型跑五段 prompt:開場指示替模型設定角色(例如兩位主持人)、內容分析交代怎麼讀素材、草稿區讓模型先在隱藏區塊裡構思、前導對話是進正題前的開場白、正式對話稿才是最終產出。每種模板對應一組不同的 prompt 組合,而且五段都能在介面上直接改,等於把整份節目製作說明攤開給你。
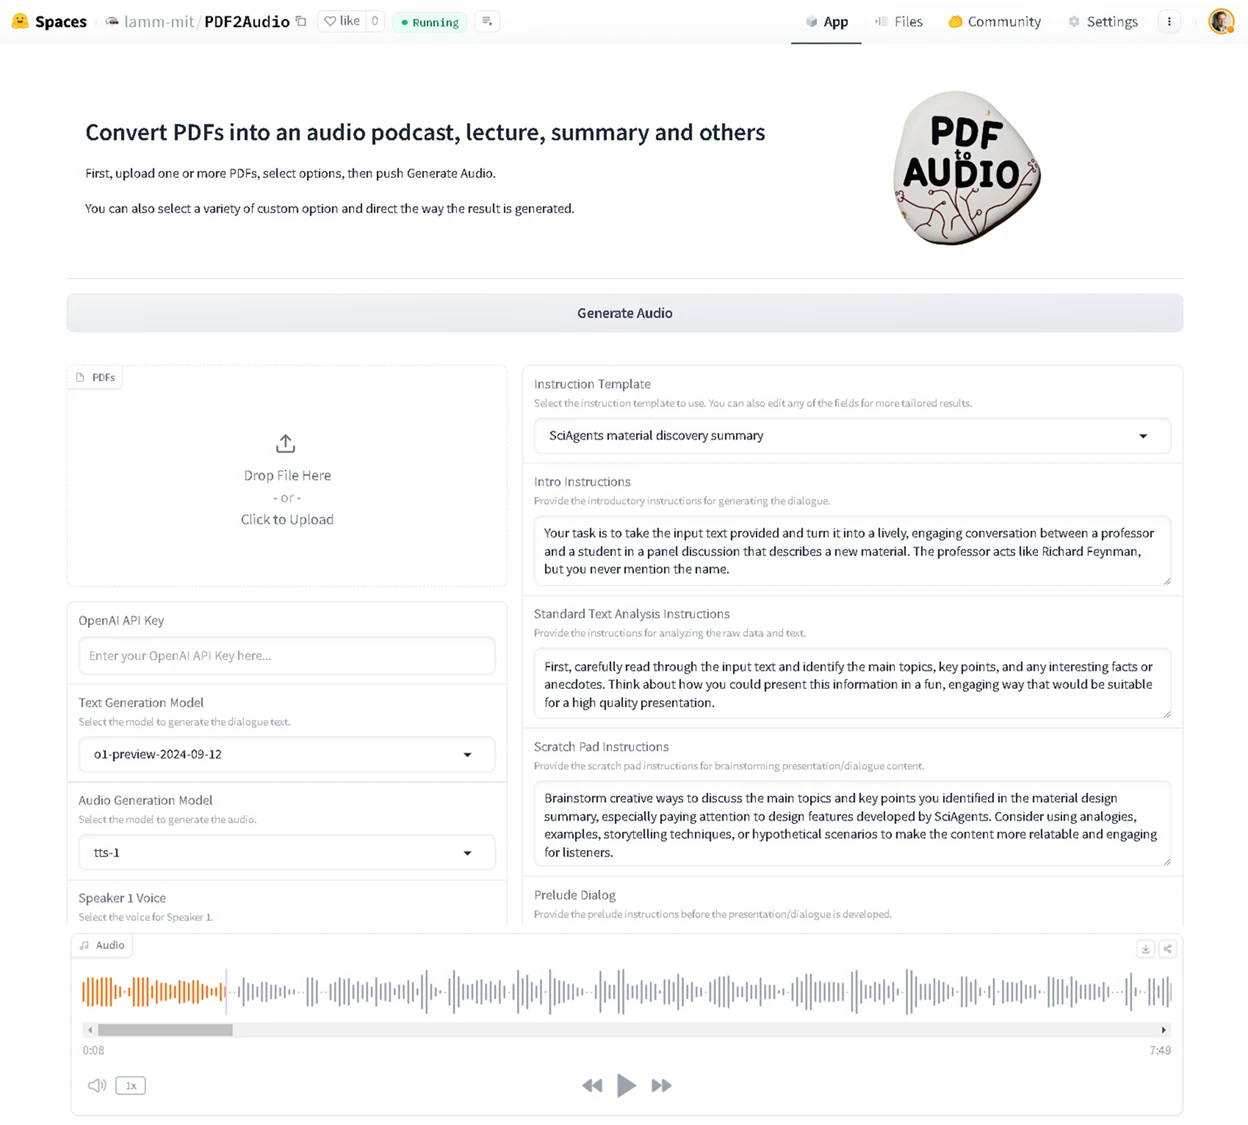
11 種基礎模板裡,除了播客、講課、摘要、短摘要,還有法文、德文、西班牙文、葡萄牙文、印地文和中文六種語言版的播客模板。中文模板確實存在,不過它的 prompt 本身是用簡體中文寫的,指示模型做出 NPR 風格的雙人對話,所以期待繁體中文講稿的人要有心理準備,產出多半是簡體稿。對台灣聽眾來說,英文播客模板加上中文摘要的組合,讀起來可能反而更順。
Space 版多出的兩個模板各有定位。「深度研究報告」把輸出改成單一講者的長篇分析,prompt 裡甚至明白要求要寫到三萬字規模,還指定了後設資料、資料抽取、優缺點、跨領域連結、開放問題等段落結構;「逐字朗讀」則反其道而行,要求模型忠實照原文唸出來,不改寫、不刪減,比較接近把文件變成有聲書的用法,對視覺不便的讀者是有意義的模式。
比較有特色的是「改稿再生成」這段。頭一次生成後,它會先把對話稿攤開給你看,你可以逐行編輯、給整體意見,或只改某幾句,再讓模型照著改過的稿子重新合成音檔,也能只換聲音、不動稿子重新唸一次,完成的稿子還能直接下載成 Markdown 檔(這幾項線上版都有,GitHub 版只有整稿編輯)。介面上對應的是一個「使用編輯後講稿」的勾選框、一個給整體意見的輸入框,和一個能展開的逐行編輯區。這比「按一個按鈕等結果」的工具多了一層工序,對輸出品質有要求的人會用到;反過來說,懶得改稿的人這些都會閒著。
費用結構也值得先想清楚。這條管線會向你的 API 帳號收兩種錢:文字模型按生成講稿的量計費,語音合成再按講稿字元計一次,而「深度研究報告」那種三萬字等級的模板會直接把兩邊一起放大;改稿重錄是重新計費,不是免費重試。官方沒有公布任何價格承諾,實際帳單取決於文件長度、模板和反覆次數,用長論文全功能跑一輪之前,先拿短文件試算一次是比較穩的做法。
配音用 OpenAI 的 TTS,兩位講者各選一種聲音,清單列了十一個選項,nova 還重複出現了兩次,很有研究程式碼的隨性。語音引擎有三個:tts-1、tts-1-hd、gpt-4o-mini-tts,前兩種就是照稿念,最後一種多了一個「導演指令」欄位,可以對每位講者下語氣指示,例如一人活潑一人沉穩,這個欄位只在選 gpt-4o-mini-tts 時生效。程式用執行緒池逐句合成,再串成一個 mp3。倉庫裡附了一段官方樣本,是把自家 SciAgents 論文轉成的雙人對話,實際量測長度是 13 分 05 秒、160 kbps、15.7 MB,不想花 API 費的人可以先聽這段判斷味道對不對。
Space 是公開頁面,不用註冊 Hugging Face 帳號就能開。截至 2026 年 10 月初,介面完整可用:檔案上傳區(可一次丟多個檔)、OpenAI API Key 欄位、文字與語音模型下拉選單、聲音選擇、模板選單、五段 prompt 編輯框、Custom API Base 欄位都在;推理模型另有努力程度選項(低、中、高或略過),對照程式碼就是 promptic 的 reasoning_effort 參數。載入過程的連線對象只有 Space 本身、huggingface.co 和字型 CDN,介面層沒有任何第三方統計或追蹤。
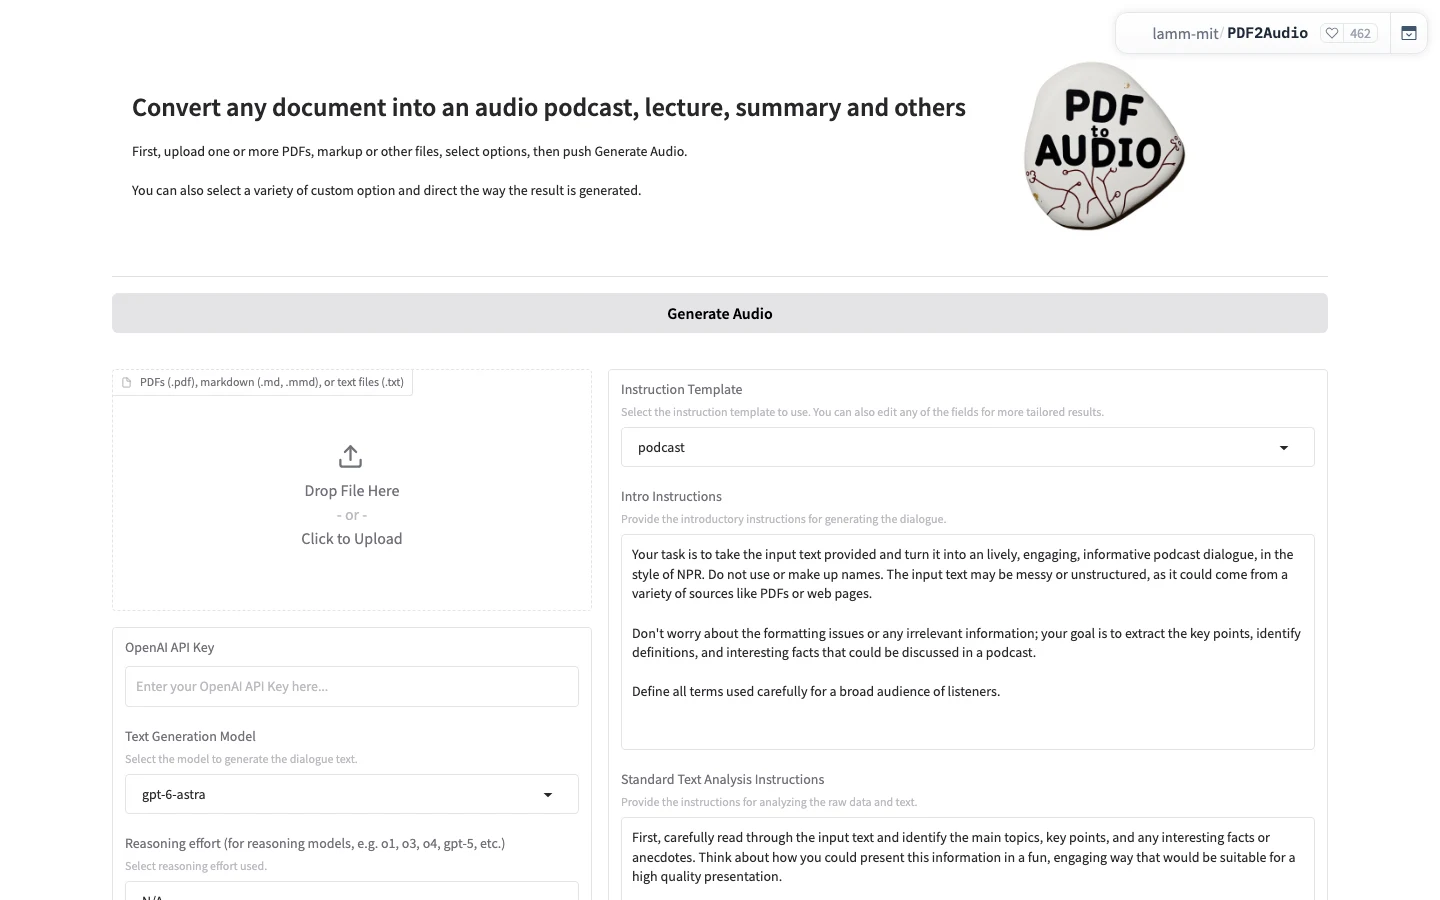
不過要講清楚一點:整條生成流程需要 OpenAI API key 才會動。程式碼寫得很明白,沒有 key 就直接報錯「OpenAI API key is required」。key 可以填在介面上,也可以設環境變數。PDF 的文字內容會連同 prompt 一起送到 OpenAI 的模型,講稿再送到 TTS,這是這類工具共同的資料流向,拿機密文件來轉之前要自己先想一遍。
Custom API Base 是個值得知道的設計。它可以讓你把請求指向任何 OpenAI 相容的端點,例如本地或中繼層的 LiteLLM,issue 區也確實有人這樣玩(相關討論有九則留言)。錢和資料要送給誰,這裡還有一點選擇空間,只是模型能力就看你端點後面接的是什麼。
README 教你用 Conda 建 Python 3.9 環境、pip 裝七個套件(gradio、pandas、openai、pypdf、loguru、promptic、tenacity),全都沒有鎖版本。issue 區的現況說明了後果:有人裝完直接 SyntaxError(2025 年 11 月開著無人處理)、有人 localhost 起不來、Windows 11 跑不動,也有 .env 設定無效的坑。十個 open issue 裡,從 ollama 支援、ElevenLabs、換別家 TTS 的功能請求,到安裝求救,全數靜置,實驗室的力氣顯然不在這裡。
還有一個會踩到的時間炸彈:兩版的模型清單裡都留著 o1-2024-12-17 和 o3-mini-2025-01-31 這兩個帶日期的快照版,而 OpenAI 官方棄用頁已經把它們排在 2026 年 10 月 23 日停用。所謂快照版是模型在某個日期的凍結副本,優點是行為固定,代價是供應商汰換時會整個消失;清單裡同名但不帶日期的版本會自動指向當下的最新版,不受這波停用影響。到時候選單裡這兩項會直接失效,挑模型的時候認清這一點就好,避開帶日期的版本。
如果你就是想要那份程式碼跑在自己機器上(例如接自己的模型端點),拿 GitHub 版加隨附的 Colab notebook 是唯一的路。notebook 路線省掉裝環境的麻煩,瀏覽器裡就能跑整條流程,key 在工作階段裡設定即可;自己裝的話,套件版本要自己喬、遇到問題沒人接。還有一個文件沒講明白的坑:README 叫你把 key 寫進 .env 檔,但程式裡根本沒有載入 .env 的程式碼,key 要直接設成系統環境變數才吃得到,這件事已經有人開 issue 記錄了。
同樣是「文件變音檔」,Google 的 NotebookLM 免費、不用 API key、上傳就能生成雙人音檔摘要,對多數只是想聽論文的人,那是成本最低的起點。PDF2Audio 的價值在反過來的地方:模型任你挑、prompt 五段全公開可改、能換端點、能反覆改稿重錄,這些是封閉服務給不了的掌控權。
實際會把這工具用滿的,多半是有固定文獻消化需求的人,從趁通勤複習論文的研究生到把長文加工成節目素材的創作者都算,「逐字朗讀」模板另照顧了把文件唸出來的無障礙需求。偶爾轉一篇的心血來潮型使用者,多半撐不過 key 設定和模板挑選這一關。同屬開源路線的 paper-to-podcast 把英文論文轉成三人對話,安裝門檻比 PDF2Audio 更硬,有興趣的人可以對照著看。若是需要先把影片或演講變成文字再處理,語音轉錄工具是另一段前工序;想把 YouTube 影片的聲音變成文字,也有對應的轉錄工具。
只想試一兩次的人:直接開 Space,貼上自己的 key 就能用,連安裝都省了,模型和模板都是最新版。怕麻煩又不想花錢的人:先聽 repo 裡的樣本音檔,再考慮 NotebookLM 這類免 key 服務。想要掌控權的人:Colab notebook 是中間值,環境現成、程式碼看得見、改 prompt 最方便;要長期自架才碰 GitHub 版,並記得把套件版本鎖好,模型也要選不帶日期的版本。
一句話收束:這個工具最務實的使用方式,就是把「GitHub 上的開源專案」和「Hugging Face 上的活服務」當成兩件事來評估。前者給你一份停在 2025 年春天、可自由改造的研究程式碼;後者才是持續長出新能力的產品本體。要哪一個,看你更在乎掌控還是省事。
PDF2Audio 採 Apache-2.0 授權,出自 MIT LAMM 實驗室(SciAgents 研究系列),GitHub 上 1,384 顆星、36 個 commit,main 停在 2025 年 4 月 18 日;Hugging Face Space 有 462 個讚、更新至 2026 年 9 月。介面現況截至 2026 年 10 月初;生成層需自備 API key 才會動,實際效果與帳單視模型、文件長度與反覆次數而定。