TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
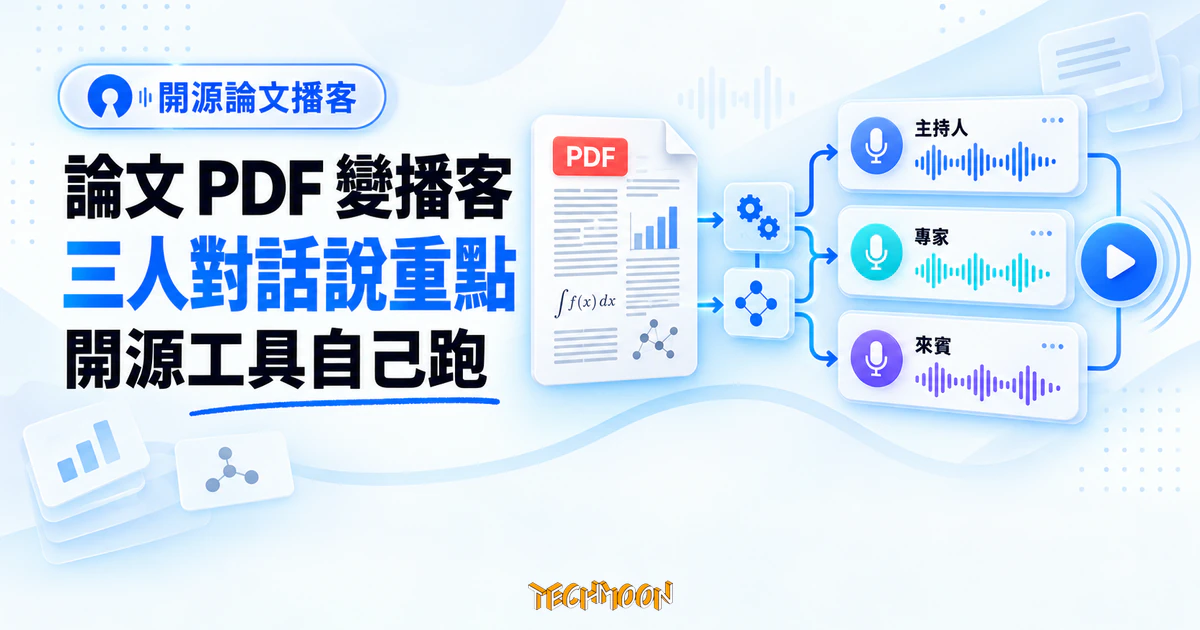
Paper-to-Podcast 是開源 Python 工具,把英文論文 PDF 轉成主持人、學習者與專家輪流講解的播客。2026 年 10 月實測照官方說明安裝會先撞到 PyPDF2 套件錯誤,補裝一個套件就能修好;文字與語音生成都走自備的 OpenAI key 計費,19 頁論文一集官方估 0.16 美元,專案最後提交停在 2024 年 12 月。
用 AI 摘要這篇文章:
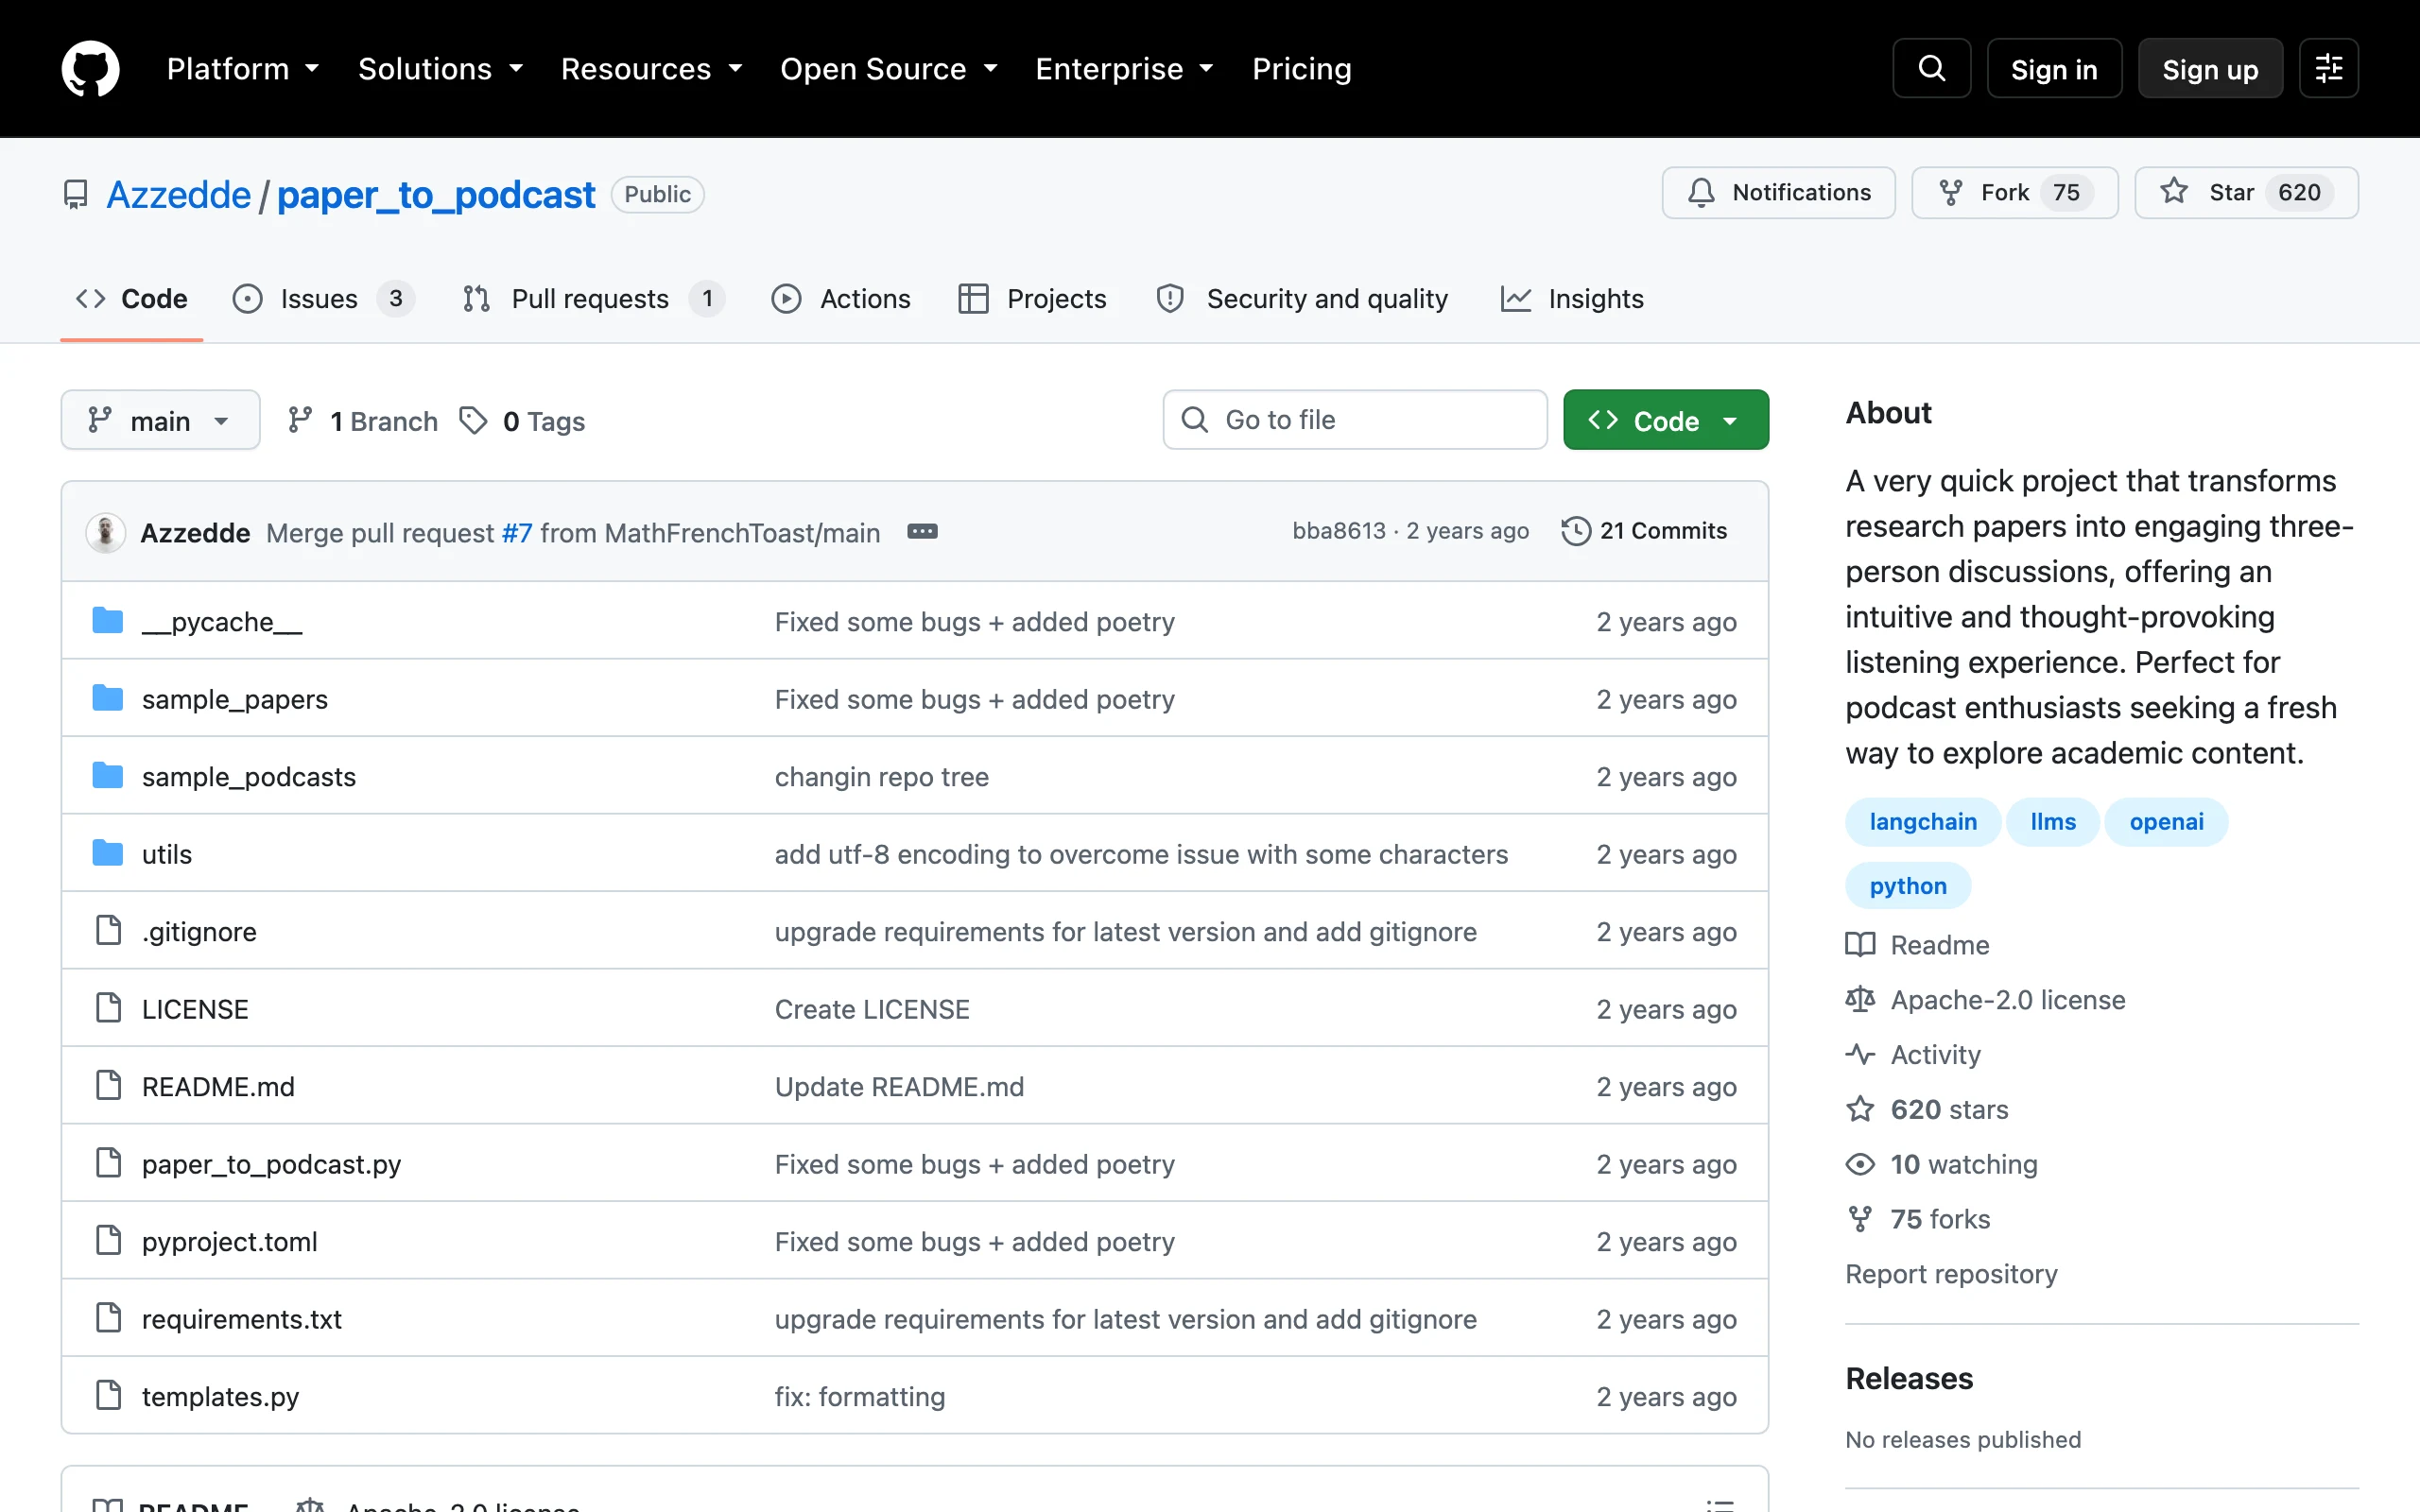
待讀清單裡堆著的 arXiv 論文永遠比看得完的多,這大概是這類工具存在的理由。把一篇 19 頁的英文論文餵給 Paper-to-Podcast,官方說法是換一集九分鐘、三個聲音輪流講解的播客。這個開源工具在 GitHub 累積了 620 顆星(截至 2026 年 10 月),原理拆開不難懂:四段 prompt、一套檢索、三個 OpenAI 語音。我用 macOS 加 Python 3.11 把它 clone 下來裝了一輪,照官方說明走會先撞到一個套件名稱錯誤,修好之後 PDF 解析層確實能跑,語音生成層則需要自備 OpenAI key 才會啟動。這篇把整段安裝路、工具的結構設計與帳單一起攤開,順便說明哪些宣稱只能聽作者自己說。
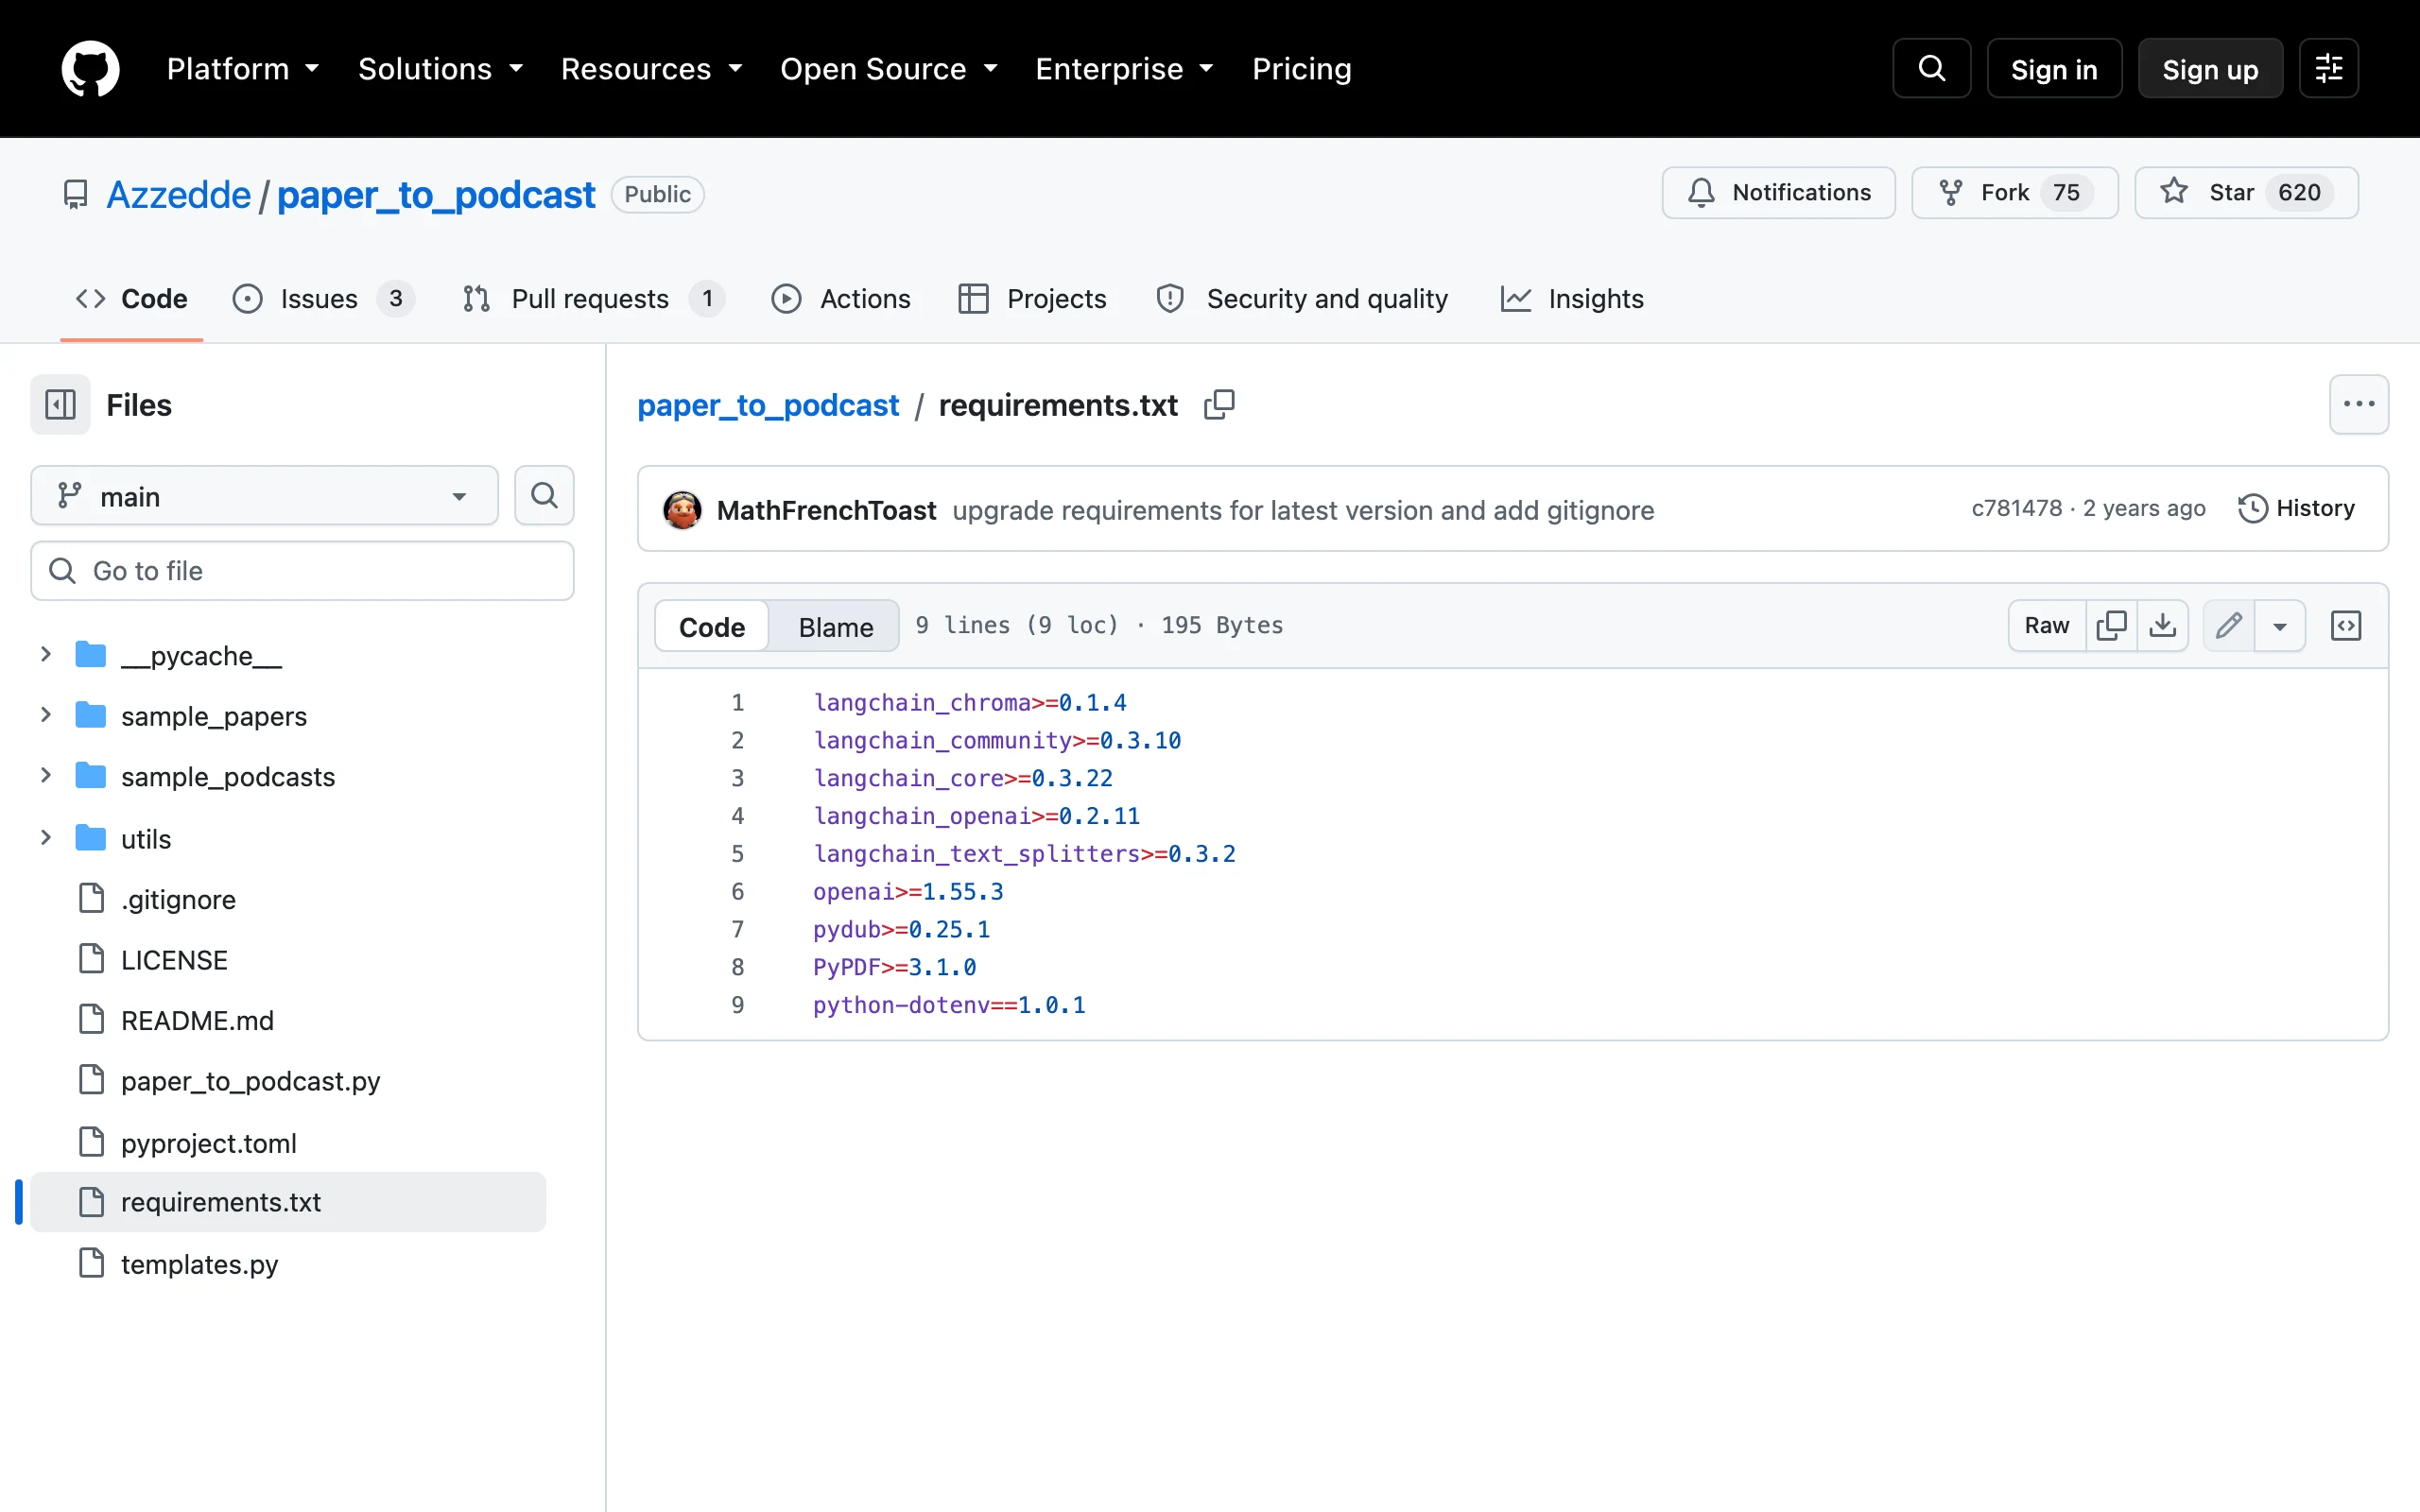
clone 儲存庫、進目錄之後,Python 的慣例下一步是 pip install -r requirements.txt,README 本身半個安裝步驟都沒寫,這份清單是倉庫唯一的手冊。安裝本身會成功,接著執行:
python paper_to_podcast.py path/to/your/research_paper.pdf第一個畫面是一整串 traceback,結尾寫著 ModuleNotFoundError: No module named 'PyPDF2'。
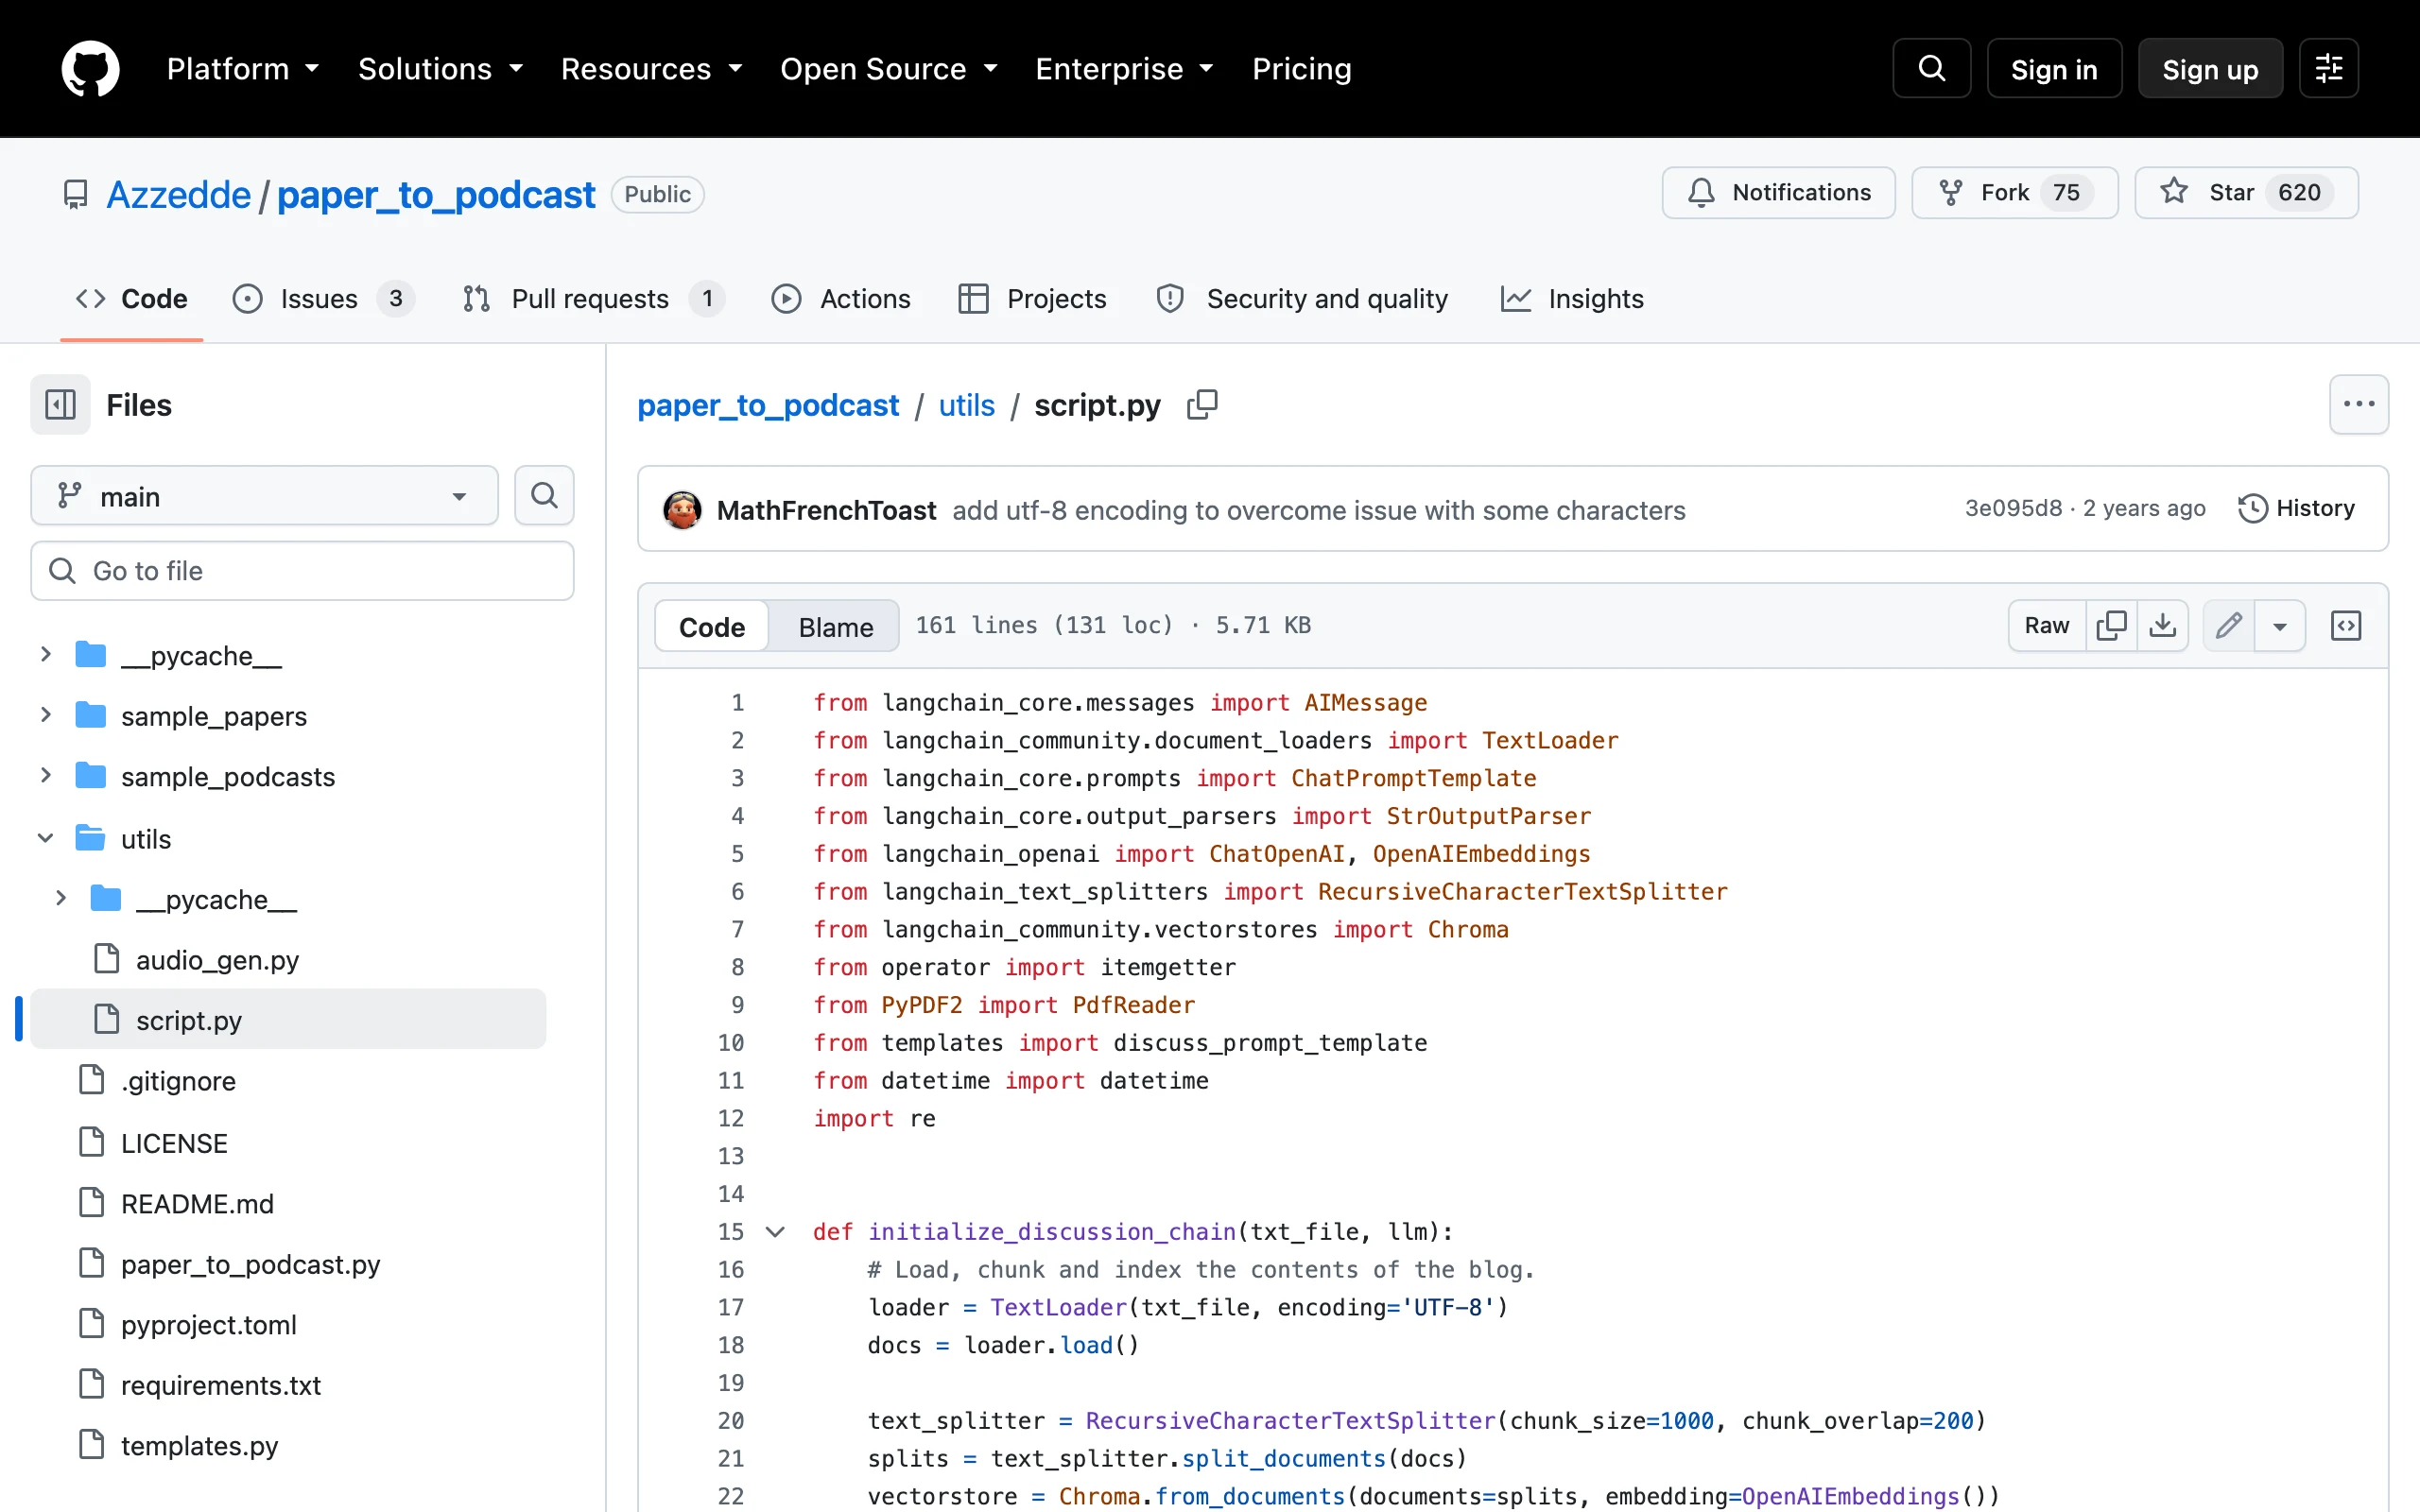
原因藏在兩個檔案的不同步,而且這個專案其實留了兩份依賴清單。pyproject.toml 給 Poetry 用,釘的是 PyPDF2 3.0.1 這組 2024 年 12 月的版本,走這條路不會炸;多數人走的 pip 路線用的是 requirements.txt,只寫下限,安裝的是 PyPDF>=3.1.0,這是 2023 年之後的新套件名;但 utils/script.py 第 9 行引用的是舊名:
from PyPDF2 import PdfReader新套件裝了、程式碼找的卻是舊名字,於是起手就斷。修法只要一行:
pip install PyPDF2裝上 3.0.1 版之後,整條 import 鏈都過了。這裡有個值得記下的細節:requirements.txt 用大於等於的下限寫法,pip 實際裝到的是 2026 年的最新版,我這輪是 langchain-core 1.6.6、langchain-community 0.4.2、openai 3.22.1,比 pyproject 釘的版本新了一到兩個大版本,程式用到的 API 面(ChatPromptTemplate、StrOutputParser、Chroma 向量庫)恰好都活了下來。LangChain 生態這兩年改版劇烈,同期的教學專案不少已經整組報廢,這個能動算是運氣加基本功。驗證方式很直接:重跑同一個指令,錯誤訊息會從 PyPDF2 換成下一關的 API Key not found,看到這行代表套件問題已經排除。
這個坑不是我個人的環境特例,安裝失敗在這個倉庫有前例:GitHub issue #4 從 2024 年 10 月開了一串 langchain_core 模組找不到的討論,六則留言往復後才關閉,同樣是依賴對不上的病。一個凍結的專案配上會漂移的依賴,這類斷點之後只會多不會少。
API Key not found 之後劇情不會溫柔收場。主程式在模組載入階段就建立 OpenAI 客戶端,key 不存在時直接拋出 OpenAIError: Missing credentials 整支程式就崩掉,連 PDF 解析這種純本機工作都不會執行。也就是說 key 是硬前提,不是可選功能。
解法照 README:在專案目錄放一個 .env 檔,內容一行:
OPENAI_API_KEY=你的金鑰重新執行主程式,開頭印出 API Key retrieved successfully 就過了這關。金鑰安全這件事作者有想到:儲存庫的 .gitignore 排除了 .env、text_paper 開頭的中介檔與 podcast 開頭的成品資料夾,照預設流程走,金鑰與產物都不會被 commit 進版本庫。要留意的是 fork 之後自己加檔案時別破壞這三條規則。
值得在這裡停下來想清楚資料流向。這個工具的每一層智慧都外包給 OpenAI:論文文字交給 gpt-4o-mini 生成對話腳本、交給 embeddings 模型做檢索索引、腳本再交給語音模型合成聲音。把文件整理成模型好消化的輸入,這件事在 Gitingest 把 GitHub 儲存庫轉成餵 LLM 的文字檔時也看得到。你的論文全文會完整送出 OpenAI 帳號,若是還沒公開的手稿或內部文件,這一點要先想過再餵。Chroma 向量庫存在記憶體裡、跑完就消失,常駐在本機的只有 PDF 原檔、中繼文字檔與成品的 mp3。
打開 templates.py,會發現「三個人討論論文」這件事全靠三段 prompt 在撐。每段開頭都把角色設定寫得明白,用詞直接得有點可愛:主持人要 professional, friendly, warm and enthusiastic,學習者被定義成 curious and funny、專門問出有感的問題,專家 talks less than the two other、開口就是深度補充。三個角色的台詞比例就靠這幾行英文設定在控制。
整條流程走下來是這樣:規畫鏈先讀完論文,產出一份「標題加條列」的大綱,這一步的用意是讓模型照論文結構走、減少胡編;接著逐段生成對話,每一段都先從向量庫撈出原文相關段落當上下文,避免腳本飄離論文內容;最後再跑一次潤飾鏈,刪掉贅字與括號裡的音效指示(比如笑聲標記),因為純文字轉語音念不出這些東西。
聲音配置在 utils/audio_gen.py 寫死:主持人用 alloy、專家用 fable、學習者用 nova,全是 OpenAI tts-1 的固定語音。想要換聲音,沒有設定檔可調,只能改原始碼。文字模型同樣寫死 gpt-4o-mini,好處是這個等級的計費便宜,想換更強的模型一樣要動程式碼。
生成流程沒有進度條、沒有圖形介面,從原始碼看,就是終端機裡一連串 print:先印出 Generating podcast script,大綱出爐後印 plan generated,逐段對話安靜地跑,語音逐句落地成檔案,最後以 Time taken 的耗時統計收尾。全程看不到百分比,適合放著去忙別的事。跑完之後專案目錄會多出一個帶時間戳的資料夾,裡面是逐句的 mp3 與合併後的完整檔案。
parse_pdf 有個值得注意的設計:文字抽取會在碰到 Conclusion 區塊後收工,後面的參考文獻整段丟棄。儲存庫的 sample_papers 資料夾放了四份論文,我挑了兩份單獨測這一層:15 頁的論文抽出 23,189 個字元,92 頁的 Llama 3 論文抽出 262,589 個字元,截斷點都正常發揮。解析結果會存成一份帶時間戳的 txt 中介檔留在專案目錄,重跑幾次就累積幾份,介意雜亂的話記得定期清。丟掉參考文獻是聰明的省法,播客聽眾不需要聽四十頁文獻清單,token 帳單也直接瘦身。
負責抓開場素材的 get_head 是反向操作:只取 Introduction 出現之前的內容,我測到的結果在一千到一千三百字元之間,正好涵蓋標題與摘要,拿來當開場介紹的素材剛好。但這個機制有個邊界:Introduction 與 Conclusion 都是寫死的英文字串比對。拿中文論文、或章節標題不是這兩個字的文件去餵,截斷永遠不會觸發,全文連同參考文獻一起進流程;抓開場素材的 get_head 函數找不到 Introduction 這個字時,會把整份文件都當成「開場簡介」送進 prompt。從程式碼邏輯推論,中文論文的 token 消耗會比英文論文高不少,開場內容的掌握度也會打折。想聽中文論文,這個工具目前不是好選擇。真的要試,改動點也單純:parse_pdf 與 get_head 各有一個字串比對,把 Introduction 與 Conclusion 換成你論文的章節標題就能生效,但要連帶接受中文內容在英文 prompt 環境裡的生成品質變數,以及全沒有截斷保護的 token 消耗。
README 的說法是:19 頁論文生成九分鐘播客,成本約 0.16 美元。這是作者宣稱的數字,我沒有實測生成層,僅供量級參考。帳單結構可以從程式碼推,分三塊:文字這塊由 gpt-4o-mini 負責大綱、逐段對話與潤飾,呼叫次數隨論文章節數增加;檢索這塊先把論文切塊、每一塊都要過一次 embedding 才能建向量索引;語音這塊走 tts-1、按字元計費且逐句呼叫。論文越長、對話段數越多,三個數字一起往上飄。
速度是另一個已知痛點。README 的 roadmap 自己承認 process takes times,issue #1 從 2024 年 10 月開著到現在,標題就叫 Reduce processing time,留下一句縮短生成時間的願望沒有兌現。逐段生成加上逐句呼叫語音 API,每一段對話都是一次獨立的模型往返,等一集的時間以分鐘起跳,把它當背景批次跑比較合理,這種用法和自架的 TubeTube 這類命令列工具是同一套節奏。
先聽成品再決定要不要裝,值得嗎?
值得。儲存庫的 sample_podcasts 資料夾放了兩集官方樣本,GitHub 的檔案預覽器對音檔有內建播放列,不用下載就能直接聽:一集用 92 頁的 Llama 3 技術報告生成(約 6.0MB 的 mp3),來源正是上面解析測試用的那份 PDF;另一集用對比學習主題的論文(約 2.9MB),對應資料夾裡另一份 16 頁的論文。直接在 GitHub 上就能播放,三分鐘就能判斷這種三人對話的形式合不合你的耳朵,不用先撞安裝牆。
完全免費在本機跑有可能嗎?
程式碼現況沒有。roadmap 上列了改用 Ollama 與開源語音的計畫,issue #5 的標題就是 Making it 100% free,但自 2024 年 12 月之後沒有任何提交,計畫停在紙上。想不花錢,要自己 fork 來改。
最後一次提交停在 2024 年 12 月 9 日,距今 22 個月。以學生 side project 的標準看,620 顆星與 75 個 fork 算是有群眾,但倉庫主人之後沒有再動過它,三個 open issue 全數晾著,外加一個想把它免費化的 PR 也從沒被併入。用它的心理準備是:遇到問題上游不會修,依賴的 OpenAI 或 LangChain 介面哪天變了,只能靠自己或社群。好消息是 75 個 fork 裡可能藏著接手的人,哪天壞了的第一時間可以到 fork 清單找救兵,而不是從零開始除錯。
授權狀態有個小矛盾:倉庫裡的 LICENSE 檔是 Apache 2.0,pyproject.toml 的 license 欄位卻寫 MIT。一般認定以授權檔為準(Apache 2.0),兩者都允許商用與修改,但 Apache 2.0 多了專利授權與商標條款,要做商業整合前值得花五分鐘看清差異。會出現這種矛盾,通常是把別的專案模板拿來改、改到一半沒檢查的痕跡,對個人使用沒有影響,但拿到正式場合引用授權前值得先確認清楚。
把文件變成對談音檔這件事,已經有大型平台做成產品,Google 的 NotebookLM 就有類似的音檔摘要功能,點一下就能聽。開源路線的意義不在更方便,而在三件服務給不了的事:腳本生成邏輯全部攤在 templates.py 裡,想調角色性格、對話節奏都改得到;語音與文字模型雖然寫死,但換模型的改動點清楚;處理過程不經過固定平台的帳號體系,該給誰看由自己決定。代價則是所有安裝、維護、帳單都自己來,這篇前半段的折騰就是入場費。
適合的場景很具體:你有 OpenAI 帳號、不介意開終端機、手上是英文論文,而且想用聽的消化長文(反方向把聲音變成文字的需求,可以另看 ReadLecture)。安裝的坎就一個套件,十分鐘內可以排除,成本按作者的數字是一篇幾毛美元。
以下三種情況先繞路:想要圖形介面或手機 App 的,這是純命令列工具;主要讀中文論文的,章節關鍵字比對會失效,成本與效果都不對勁;堅持完全免費本地運行的,等 issue #5 有進展或自己動手改。另外若論文還未公開,全文外送 OpenAI 這一步需要你自己的判斷。
對符合條件的人,這個凍結專案依然是把「讀論文」變成「聽討論」最短的路之一:先去 sample_podcasts 聽一集樣本,喜歡再照上面的修法安裝。裝好之後第一批該餵什麼?建議從自己領域最近想讀卻一直沒讀的那篇開始,九分鐘的對話能不能讓你決定要不要讀全文,就是這工具對你最有價值的那個瞬間。