TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
FluentRead 是 GPL-3.0 開源的瀏覽器雙語翻譯擴充,安裝後不用金鑰、不用帳號就有可用的免費翻譯。實際把它原始碼裡的免費端點拿出來呼叫,微軟、騰訊、Yandex 三條線路全部可用,但這些線路大多借的是各大服務的網頁端點,文字照樣出門、也隨時可能被封。這篇把三種引擎模式的資料邊界、官方隱私明細與安裝前該知道的限制一次說清楚。
用 AI 摘要這篇文章:
想在瀏覽器裡讀英文網頁時,原文譯文上下對照著看,這件事的解法很多,但多半有個門檻:要嘛綁帳號,要嘛訂閱,要嘛「免費試用」期一過就跳出付款頁。FluentRead(中文名「流暢閱讀」)走的是另一條路:裝完就能用,不用註冊,也沒有付款頁。我把它的原始碼完整讀過一遍,並把它使用的免費翻譯線路拿出來直接呼叫,三條全部零金鑰可用,最快 0.36 秒就收到繁體中文譯文。
不過「免費」的形狀值得先看清楚。讀完程式碼與官方說明後可以確認兩件事:這些免費線路大多借的是各大翻譯服務的網頁端點,並非對外開放的官方 API,你的文字照樣會送到那些公司手上;線路本身也隨時可能被對方封起來,專案甚至為此在程式裡寫了一整套備源調度機制。實測結果、三種引擎模式的資料邊界、安裝前該知道的事,接下來一次說完。
FluentRead 是一個以 GPL-3.0 授權公開的瀏覽器雙語翻譯擴充功能,2023 年 12 月開張,到 2026 年 9 月底已有 8,214 個 GitHub 星標、421 次 fork。專案幾乎由一位開發者(Bistutu,署名 ThinkStu)獨力推進:貢獻紀錄上他累積了 1,736 次提交,其餘貢獻者最多只有 8 次。安裝管道有四條:Chrome 線上應用程式商店(20,000 位使用者、4.5 星、49 則評分)、Edge 附加元件、Firefox 附加元件(709 位使用者),以及 Greasy Fork 上的使用者腳本版(2,238 次安裝)。
如果你在網路上看過它的舊介紹文,功能描述很可能已經過時。這個專案原本的樣貌是「滑鼠移到段落上按快速鍵就翻譯」的懸浮翻譯擴充功能;現在的它已經長成一套雙語閱讀工作台:整頁雙語對照、懸浮翻譯、劃詞翻譯之外,還有結合上下文解釋選中文字、可連續追問的 AI 閱讀卡片;能收藏單字片語並保留原文語境的學習中心;用本機 OCR 辨識圖片或圈選區域文字再翻譯的圖片翻譯;PDF、ePub、DOCX 的文件雙語閱讀與校訂匯出;YouTube 與 X 的雙語字幕(部分 X 影片還能靠本機模型生成字幕);2026 年 9 月底合併的程式碼甚至加上了 Thunderbird 郵件翻譯。
AI 閱讀卡片的來歷值得一提:它移植了 DeepSeek 官方開源的 DeepSeek Harness 對話核心中「事件投影」那一小部分,改造成瀏覽器裡的閱讀問答。專案文件對這件事交代得相當老實,寫明了只移植了附加式的子集、釘住了上游版本 dsh-v0.1.3-alpha.1、連參考檔案的 SHA-256 雜湊值都記錄在案,也聲明上游升級不會自動進到擴充功能裡。這種「用了多少、來自哪裡」的交代方式,在瀏覽器擴充功能圈並不常見。
FluentRead 最有記憶點的主張是「免費翻譯服務」:不填任何金鑰、不登入任何帳號,裝完就有可用的翻譯。為了驗證這句話,我從它的原始碼裡挖出免費線路的端點與請求格式,照原樣直接呼叫,結果三條全通。微軟那條是 Edge 瀏覽器翻譯功能自己在用的介面,丟一句英文繞口令進去,0.36 秒就送繁體中文譯文,而且「那隻敏捷的棕色狐狸跳過懶散的狗」這種測試句的語序處理得乾淨;騰訊 TranSmart 的網頁端點花 1.62 秒,指定的繁體中文目標語言如實兌現;Yandex 那條花 1.25 秒(程式碼註明它暫不支援繁體中文目標語言)。「免費、免設定、裝了就能用」這幾個字,實測層面成立。
但程式碼同時也說明了這些線路的真實身份。預設的免費備源順序有九條:微軟 Edge、騰訊 TranSmart、字節跳動火山引擎、Google、有道詞典、金山愛翻譯、Yandex、DeepLX、MyMemory,設定頁裡還能再打開搜狗、Reverso 與幾個開源翻譯服務(Apertium、Lingva)作為額外候選。九條裡有八條是各家翻譯網站自己網頁在用的介面,沒有服務水準保證,對方隨時可以改掉或擋掉;MyMemory 是唯一例外,程式碼把它標為官方 API,匿名使用每天有 5,000 字元額度。DeepLX 免費版的預設端點更明確,程式碼註解直接寫著「公共 endpoint 是非官方 DeepLX 部署」。
正因為知道線路會斷,專案在程式裡養了一套調度系統。每次請求失敗會被分類成限流、額度用盡、被擋、暫時故障等類型,各自套用不同的冷卻時間(預設一分鐘,最長七天);背景持續記錄每條線路的成功率與延遲,用指數移動平均算動態權重,自動把流量導向健康線路,一條失敗就換下一條;單次請求的逾時是 5 秒,整批文字的總預算 20 秒,超過就換線路。專案自己的開發報告也寫得直白:新增免費候選時逐一實測了真實翻譯請求,同時註明「實測不代表長期可用性或無限額度」。換句話說,「免費」的成本被工程手段消化了,但本質沒變:你讀的每一段文字,都送到了那些公司的伺服器。
官方隱私說明對此也沒有避而不談,明言免費翻譯的文字會送給已啟用的線路,由背景依成功率與延遲動態挑選;而且當一條線路失敗時,同一段文字可能被再送往另一家備源。對文字流向在意的人,這句要讀進去:收件者並非固定一家,而是一整串候選名單。
FluentRead 的服務清單共有 48 個欄位,按資料流向可以分成三種邊界截然不同的模式。上面實測的免費線路門檻最低,文字出門的對象也最廣。雲端廠商的官方機器翻譯是另一種:騰訊雲、Google Cloud Translation、Azure AI Translator、阿里雲、百度翻譯開放平台、火山引擎六家,用各自雲端控制台簽發的金鑰呼叫,程式碼註解註明各家都有免費額度。你的文字一樣出門,但對象是簽約的官方服務,帳單與用量都查得到。
大模型翻譯與本機模式則把選擇權還給使用者。AI 陣營從 OpenAI、Claude、Gemini、DeepSeek、Grok、OpenRouter 到騰訊混元、阿里通義、百度文心、字節豆包、智譜、小米 MiMo、零一萬物等三十多個欄位,全都要自帶金鑰(自架的 Ollama 是例外,連金鑰都不用):填自己的 API 金鑰,文字就送到自己選的那家。本機模式有兩層:Chrome 瀏覽器內建的 Translator API 讓翻譯直接在裝置上跑;更進一步,擴充功能把 WASM 推理引擎(wllama、ONNX Runtime Web)整包綁進安裝包,小模型與 Kokoro 語音模型在初次使用前另行下載,之後在瀏覽器的背景工作頁裡離線執行,程式碼註解明言本機模型的請求不送到雲端。習慣自架的話,本機的 Ollama 也在清單上。
本機模式有兩個但書。模型初次使用前需要連網下載,下載完才能離線;官方說明也特別提醒,選了本機翻譯模型,辭典查詞、朗讀、初始下載這些周邊功能並不會跟著離線。想要「文字完全不出門」的讀者,本機模式是唯一選項,而且要接受它的翻譯品質與速度都和雲端模型有落差。
| 模式 | 門檻 | 文字去了哪裡 | 適合誰 |
|---|---|---|---|
| 免費翻譯服務 | 零設定 | 微軟、騰訊、Yandex 等一串網頁端點,失敗時換下一家 | 不想付錢也不想管金鑰的人 |
| 雲端廠商官方介面 | 雲端控制台金鑰 | 簽約的六家官方翻譯服務,用量可查 | 有雲端帳號、要穩定與對帳的人 |
| 大模型(自帶金鑰) | 自填 API 金鑰 | 自己選的那家模型服務 | 已有 API 金鑰、重視譯文品質的人 |
| 本機模式 | 首次下載模型 | 不出門,在瀏覽器內離線執行 | 對隱私要求最高的人 |
閉源翻譯擴充最常見的問題,是你不知道文字被送去了哪裡。FluentRead 在官方文件上放了一頁資料與隱私說明,開頭就寫明「FluentRead 沒有自建翻譯伺服器,雲端翻譯由對應的第三方服務處理」,然後逐功能列表:整頁與劃詞翻譯送文字與語言資訊;AI 閱讀卡片送選中詞句、獲得授權的段落上下文與交談內容;圖片翻譯的辨識在本機跑,預設像素不上傳,辨識出的文字才送翻譯;文件解析在本機完成,只送要翻的文字。兩個預設值也交代清楚:「額外 AI 上下文」(把頁面標題、描述與部分正文一併送給 AI 服務)預設關閉;輸入框翻譯預設關閉,而且只處理一般輸入框、明確排除密碼欄位。
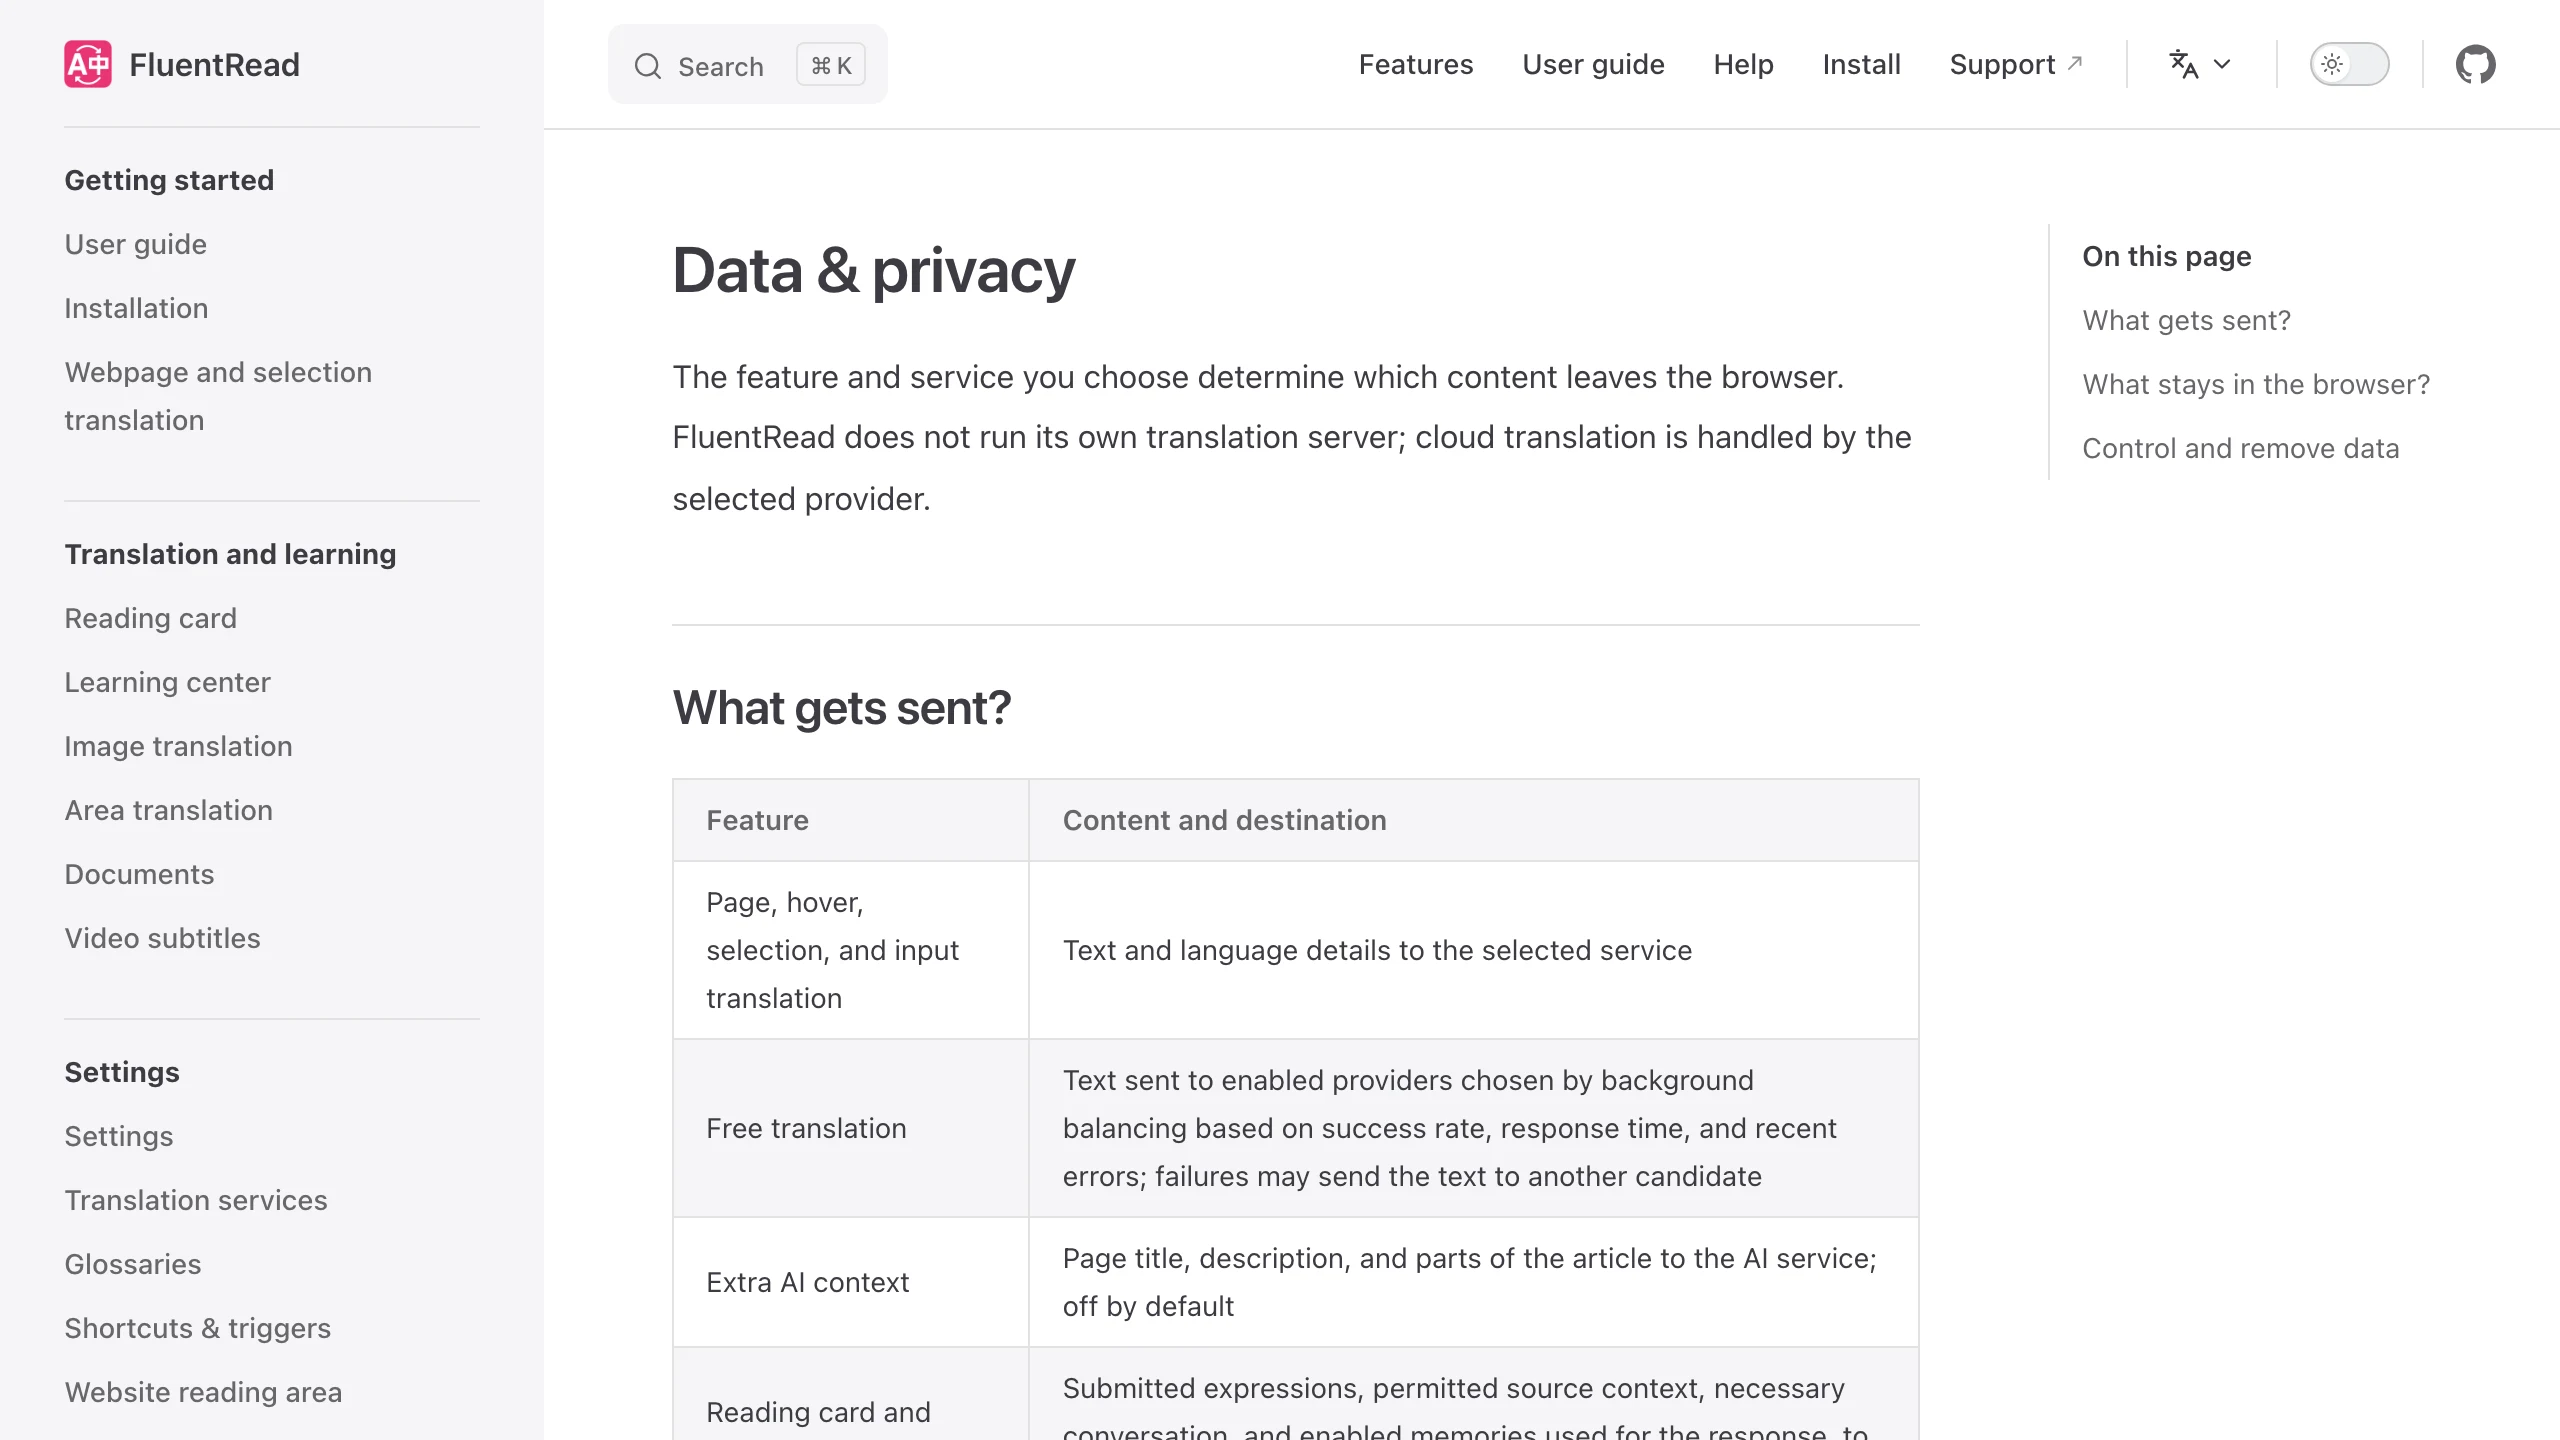
留在瀏覽器裡的資料也一樣有明細:設定、規則、術語庫與學習紀錄存在擴充功能的本機儲存空間;閱讀卡片的對話紀錄保留 30 天,可查看可刪除,無痕視窗不讀也不存;各服務的金鑰存在本機瀏覽器設定檔裡,文件也老實提醒「能存取瀏覽器設定檔或備份檔的人仍可能讀取這些內容」。X 影片的字幕快取上限是 32 部影片、保留七天。
官方文件與程式碼之間有一處落差:隱私說明寫翻譯快取「預設最多 5 MiB 或 2,000 條」,但程式碼裡的預設值是 10 MiB 與 10,000 條(兩邊的 24 小時到期一致,使用者也都能自己調整或清空)。差異不大,方向也是文件寫得比實際保守,但這種地方恰好說明:再透明的文件也要對著程式碼讀才算數。
權限方面,擴充功能要求的 API 權限清單相當節制(儲存、無限量儲存、提醒、右鍵選單、離屏頁),但主機權限涵蓋所有網站。這是整頁翻譯類擴充的必要形態:要在任意網頁上讀取與改寫段落,就得拿全站授權。對照 Firefox 版的商店申報,它也如實宣告了會處理網頁內容、憑證資訊與私人通訊三類資料,與實際行為相符。
TechMoon 先前介紹過幾款各走一條路的翻譯工具,與 FluentRead 的定位並不重疊。Read Frog 陪讀蛙同樣是開源雙語翻譯擴充,賣點是免帳號的整頁對照,適合想要單純網頁閱讀的人;FluentRead 的差異在引擎選擇的多樣性與閱讀之外的整套學習、文件、字幕功能。MTranServer 把翻譯引擎整個搬到自架伺服器,適合願意動手架站、追求文字完全不經過外部服務的讀者;FluentRead 的本機模式想解決同一件事,但靠的是瀏覽器內模型而非自架。Ries 的路數完全不同,它是把英文單字織進每天讀的中文網頁來學語言,與雙語閱讀互補而不互替。WinLens 針對的是螢幕上任何位置的文字原位覆蓋翻譯,管的是擴充功能管不到的桌面應用畫面。
簡單的分流:只想要網頁雙語閱讀,Read Frog 更輕;要離線保證且願意架站,MTranServer 更徹底;要學英文而不是讀文件,Ries 更對題;要翻瀏覽器之外的畫面,找 WinLens。想在同一個擴充功能裡同時拿到雙語閱讀、AI 講解、文件與字幕,FluentRead 是目前這幾款裡覆蓋面最寬的選擇。
這個專案的工程品質與文件誠意都在水準之上,但幾個現實也要放在天平上。它是單人專案:開發者用 AI 協作分支(專案裡放著給 AI 開發代理讀的開發規則檔,近期合併紀錄大量來自 codex 分支)維持著幾乎每天都有提交的節奏,2026 年 9 月一個月就出了至少三個正式版,但公車因子終究是一,興趣轉移就會停。
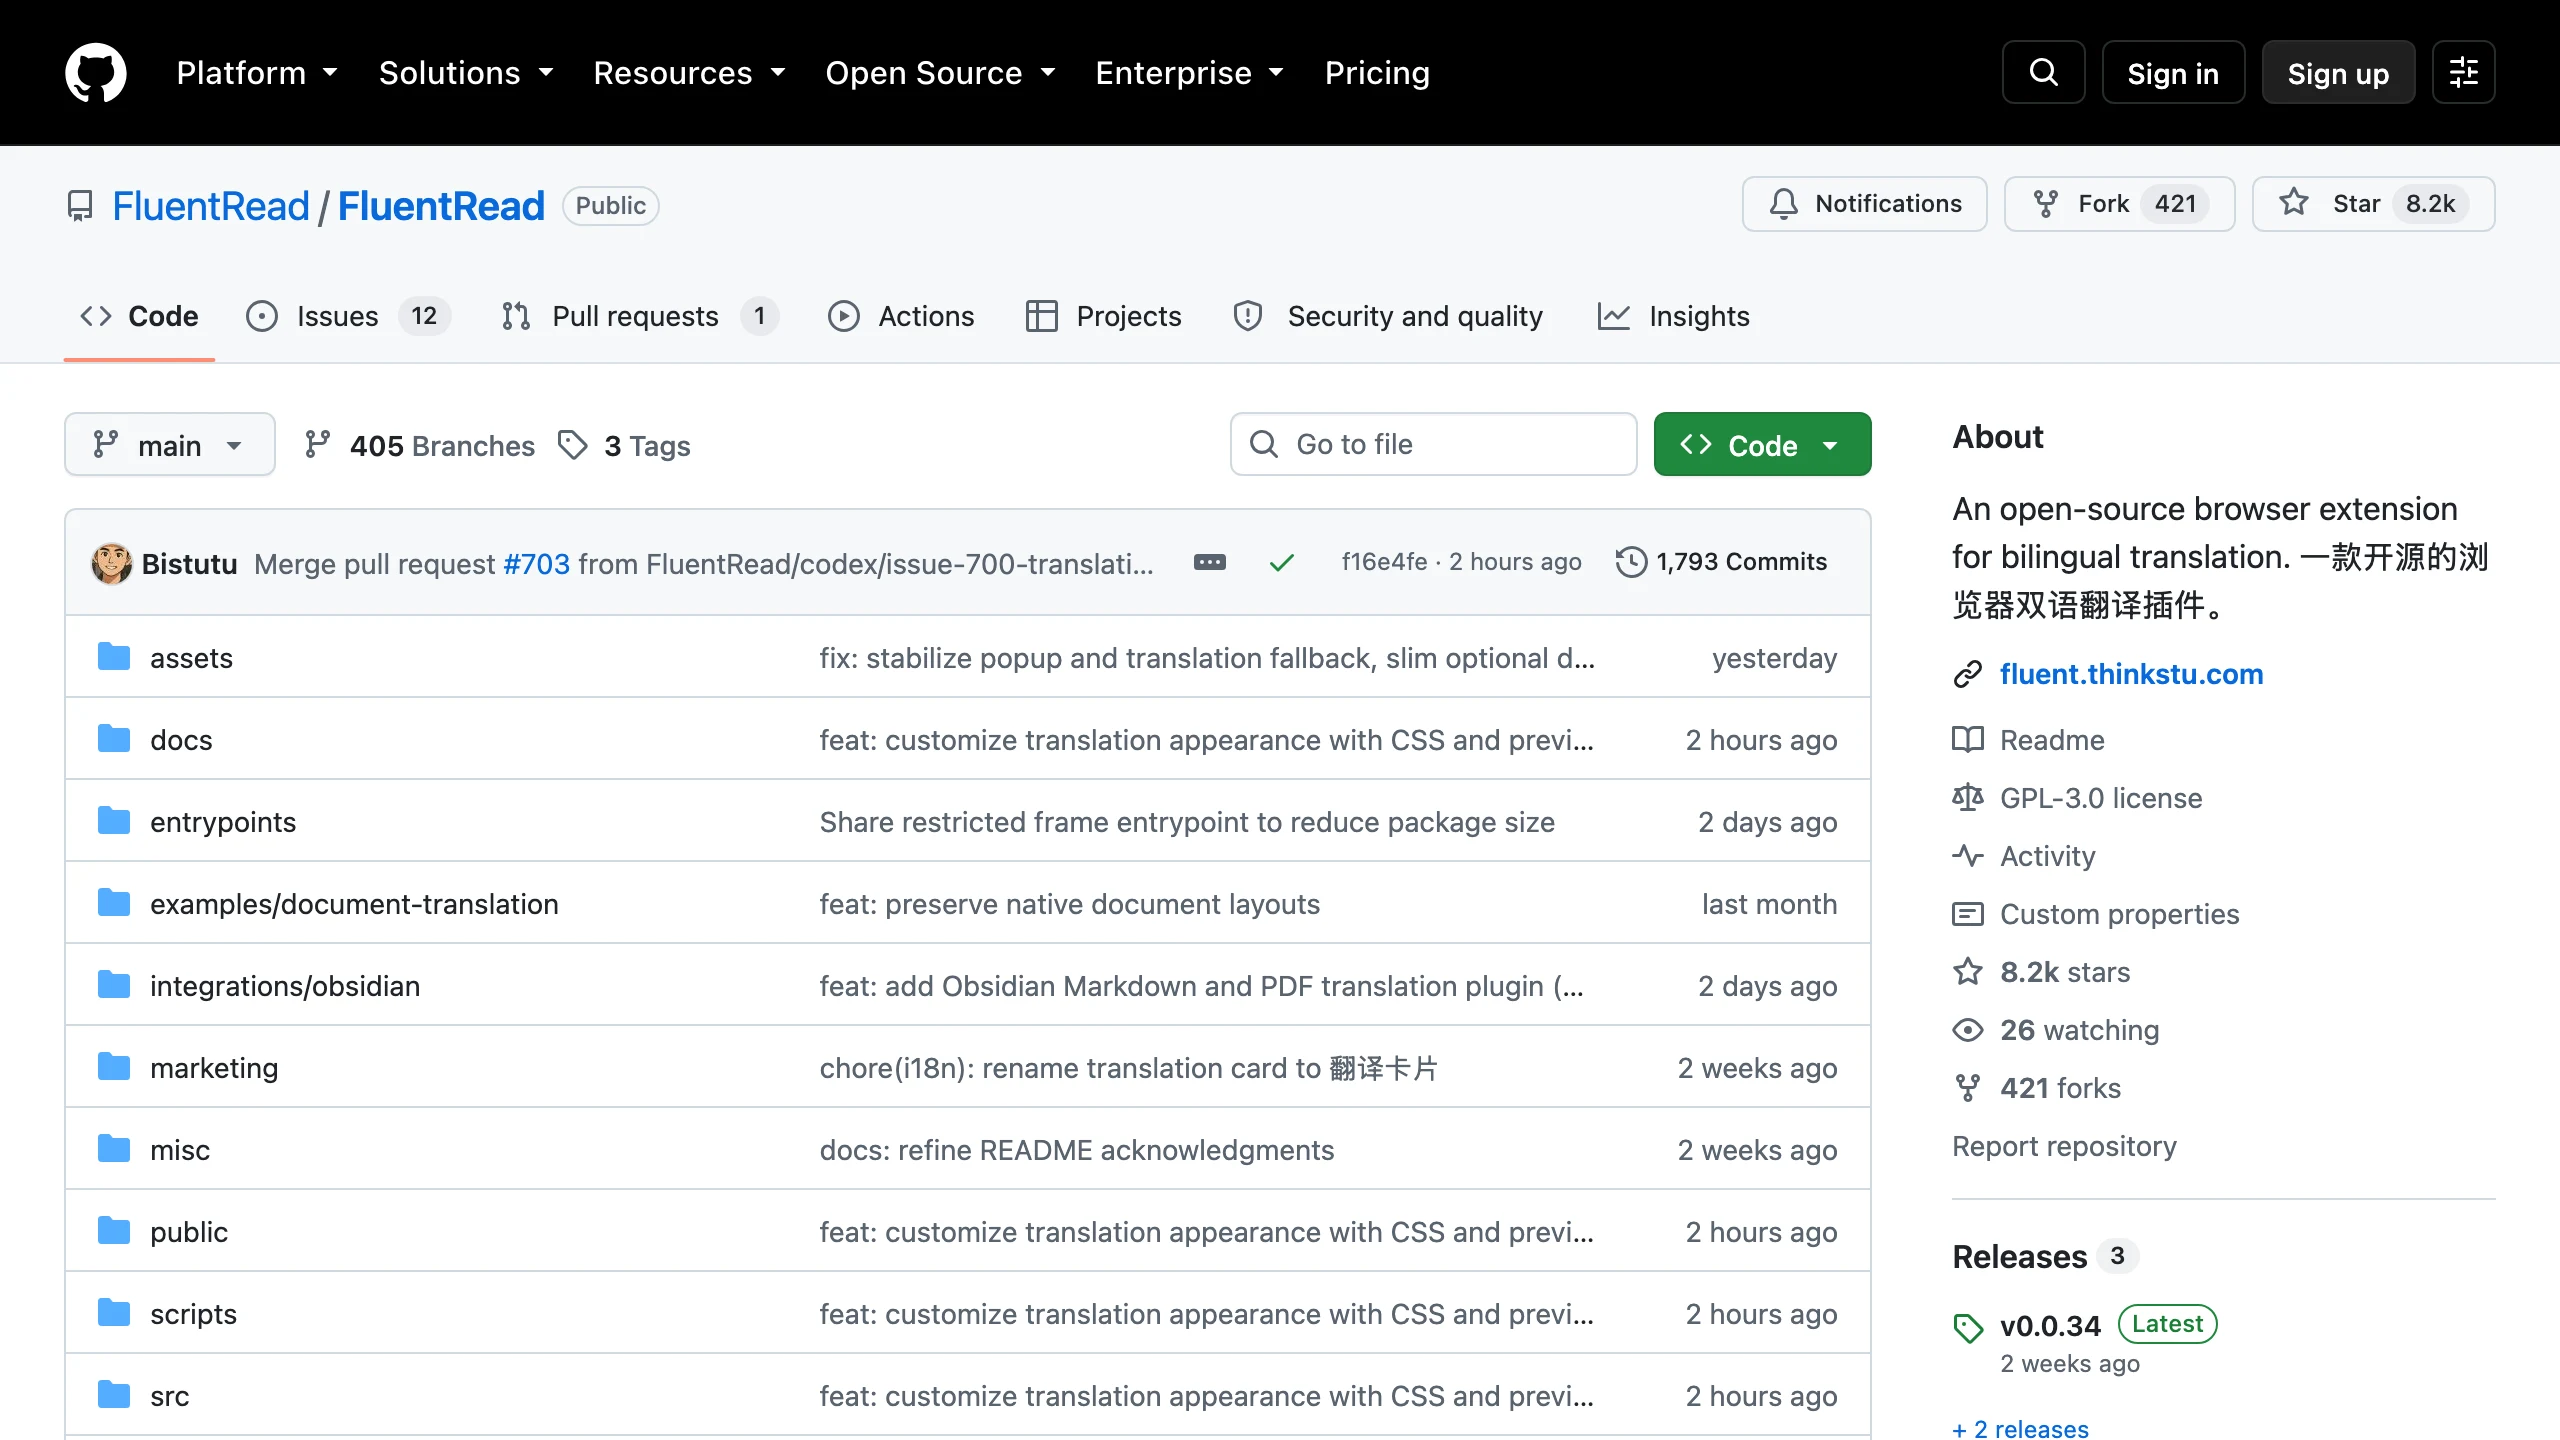
商店版本有時間差:儲存庫裡的版本號已到 0.0.35,Chrome 商店還停在 0.0.34(2026 年 9 月 14 日更新),急著用最新修正得自己從原始碼建置。免費線路的語言偵測偶有怪相,Issue 追蹤區有使用者反映譯文莫名其妙變成日文(該單元已結案),這類毛邊與免費端點的本質同源:你用的是別人網頁的通道,品質控制只能靠備源調度撐著。使用者腳本版則明確標示只提供核心網頁翻譯能力,文件翻譯、字幕這些完整功能要以擴充功能形式安裝。
具體的情境長這樣:讀英文技術文件或論文的人,整頁雙語對照加劃詞追問,比切換到翻譯網站貼來貼去省事;讀 PDF 電子書的人,文件翻譯能讀能校訂再匯出,等於把閱讀器跟翻譯器合在一起;常看國外影片的人,YouTube 與 X 的雙語字幕直接疊在播放器上。這些情境共用同一套引擎設定,調一次到處生效。
適合誰:想在瀏覽器裡做雙語閱讀、不想付訂閱、能接受文字送到翻譯服務商的讀者,它把免費這條路做到目前為止最完整;已經有大模型 API 金鑰的人,把它當統一的雙語閱讀前端也很順。不適合誰:對文字外流極度敏感、又不想忍受本機模式落差的人,自架 MTranServer 那條路會更安心。
實際安裝的建議順序:先從 Chrome 商店或 Firefox 附加元件裝正式版,用預設的免費線路讀幾篇長文感受速度與譯文品質;在意隱私的人接著到設定裡把引擎切到 Chrome 內建翻譯或本機模型,對照看看品質落差能不能接受;有 API 金鑰的人再掛上自己慣用的大模型。原始碼、文件與四個安裝入口都在專案的 GitHub 儲存庫與官網上,GPL-3.0 授權,商用改造前記得看清授權義務。