TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

PhAI Labs 的科研代理工作區 ScienceBuddy 在 X 宣布免費使用 GPT-6 並整合 JEV framework。產品 9 月 16 日上線、需申請存取;技術報告攤開雙層自我改進的三組基準數字,但實驗使用模擬研究者回饋,免費額度與 JEV 角色截至 9 月 24 日尚無文件說明。
用 AI 摘要這篇文章:
9 月 23 日晚間 10 點 46 分(台北時間),AI 研究機構 PhAI Labs 在 X 上發布一則 33 秒的宣傳影片,宣布旗下的科研代理工作區 ScienceBuddy 可以免費使用 GPT-6。貼文寫得相當精簡:免費、GPU 加速、整合 JEV framework,然後用兩行文字交代「雙層自我改進」的內層與外層。額度、期限、型號一概未提,JEV 是什麼也沒有交代。
這則宣布背後其實有一套可以核對的東西。ScienceBuddy 的技術報告 9 月 15 日登上 arXiv,產品 9 月 16 日上線,GitHub 上的實驗程式碼以 MIT 授權公開。論文裡的雙層自我改進有機制、有三組各附實驗條件的數字,repo 裡有可以下載重跑的簡化版本。與此同時,最吸引人的幾個宣稱,包含免費 GPT-6 的細節、JEV 的角色、宣傳影片裡在真實實驗中測試假說的字句,在公開資料裡都找不到對應的文件。
把這兩層分開讀,是判斷現在要不要申請試用的前提。
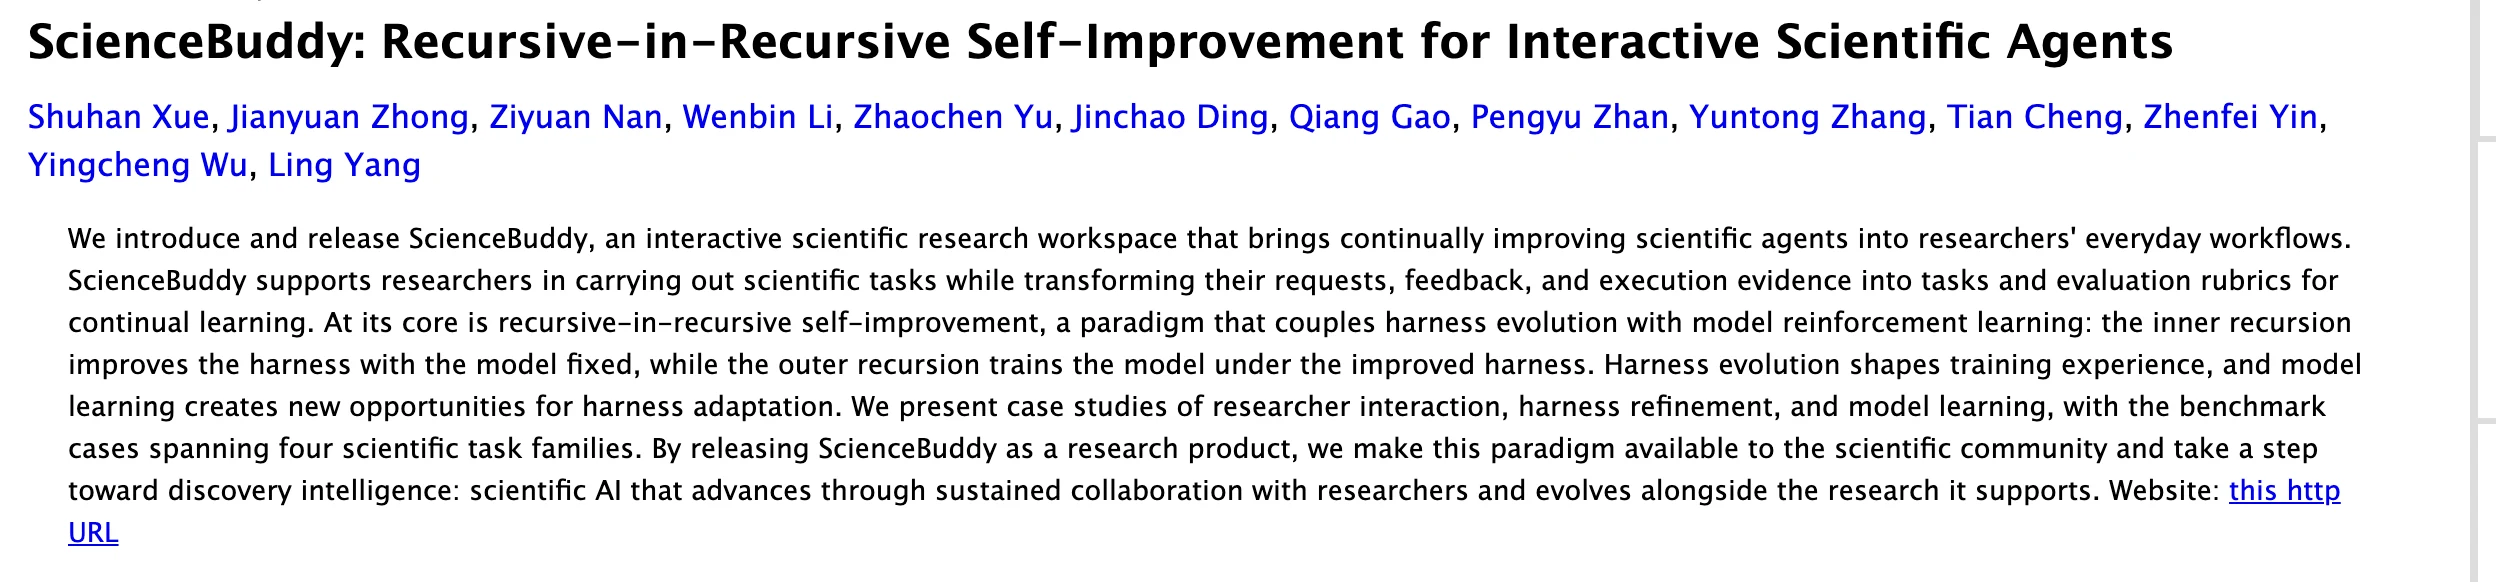
先看時間軸。PhAI Labs 的 X 帳號 9 月 5 日才建立,9 月 15 日提出 DFM 範式的研究文章與 ScienceBuddy 技術報告,9 月 16 日開放產品入口,9 月 17 日與 18 日接連發布 ScienceIDE 與 JEPA-Anything 兩個兄弟專案,9 月 23 日再宣布免費 GPT-6。整個系列在 18 天內密集出貨,節奏更像一場有計畫的發布,而不是單一事件的意外走紅。
那則貼文看得到的全文裡,關鍵句是「Use GPT-6 in ScienceBuddy at no cost」與「fused with the JEV framework」。至於兩層循環的說明,貼文在外層循環的地方被截斷,只留下串文的符號與影片連結,外層循環的具體說明沒有出現在這則貼文裡。宣傳影片則是一支概念片:研究者在筆電上輸入「為什麼有些腫瘤細胞能在化療後存活」,畫面依序出現查詢、實驗、藥物設計的意象,結尾是 PhAI Labs 的標誌。整支影片沒有出現任何模型名稱,也沒有展示實際的產品畫面。
截至 9 月 24 日,這則貼文拿到約一千個讚。免費的消息是真的,但「免費」三個字承載的資訊量,就只有貼文上那一句。
ScienceBuddy 的核心想法,是把代理的進步拆成兩個互相銜接的循環,論文稱為 recursive-in-recursive self-improvement。理解它可以用一本工作手冊來類比:代理做事時遵循的檢查順序、工具用法與回答格式,都寫在這本手冊裡。
內層循環改的是手冊。模型本身不動,系統收集任務互動與回饋,讓一顆輔助模型審視最近的執行軌跡,提出手冊的修改版本,再拿固定的驗證任務比較改前改後的表現,留下比較好的版本。外層循環改的是模型。手冊選定後,讓模型照著它反覆執行任務,用強化學習依照評分規則更新參數,訓好的模型再進入下一輪手冊修改。論文跑了三輪這樣的交替。
實驗裡的三顆模型各司其職,這個分工值得記住。真正執行科學任務的是 Qwen3.5-4B,一顆 4B 參數的小模型;模擬研究者回饋與解讀回饋的是 Qwen3.8-27B;提出手冊修改建議的則是 GPT-6 Astra。也就是說,論文裡的 GPT-6 是躲在幕後當編輯,真正上場答題的是一顆小模型。這與貼文宣傳的「免費用 GPT-6」是兩件事:論文的實驗設定,無法用來推論產品裡每次對話都由 GPT-6 執行。
工作區本身的規格也攤在論文裡:224 個工具分布在 22 個功能模組,涵蓋基因體學、分子與癌症生物學、藥理學、生物影像、文獻檢索與資料庫查詢,執行環境支援 Python、R 與 Bash。目前工具與資料集中在生醫領域,其他科學領域的輸入與文件流程可以處理,但專業工具還沒有跟上。
互動的設計把「檢查」放進介面。README 描述的使用方式是四個面板分工:Chat 放對話,Compute 顯示執行活動,Results 收產出檔案,Trajectory 記錄完整的事件序列,包含每次工具呼叫的輸入、輸出與產生的檔案。研究者可以在對話裡追加一張圖、縮小範圍或要求換一種比較方式,任務的前後文會保留下來。論文開頭引用了 Silver 與 Sutton 的句子,代理將住在經驗的溪流裡,而非互動的碎片中,這個工作區就是這句話的產品化嘗試。
論文給出三組常被引用的數字,它們來自三個不同設定的實驗,不能放在一起比大小。
| 數字 | 實驗條件 | 量的是什麼 |
|---|---|---|
| 31.1% 升到 51.1% | 固定模型,只改工作手冊 | 手冊修改在驗證集上的效益 |
| 48.3% 升到 67.8% | 固定工作手冊,用強化學習訓練模型 | 四次作答內至少答對一題的涵蓋率(pass@4) |
| 42.2% 升到 73.3% | 三輪手冊與模型交替改進後 | 保留測試題的單次作答正確率 |
第三組數字的細節最有參考價值。三輪交替改進後,系統在保留測試題上的單次作答正確率從 42.2% 提高到 73.3%,其中 33.3% 的題目從答錯翻轉為答對,同時有 2.2% 的題目從答對翻成答錯。拆到每一輪看,手冊修改把各自的驗證正確率從 38.9% 推到 44.4%、34.4% 推到 46.7%、61.1% 推到 70.0%,訓練獎勵在三輪的中後段也同步上升,兩個循環各自都有進帳。改善集中在 LAB-Bench 與 Biomni-Eval1 兩套基準的四個任務家族:文獻閱讀、資料庫判斷、實驗流程除錯、基因與變異評估。這些是固定的基準題目,量的是特定題型上的表現,換算成「研究結論更可信」還有一段距離。
另外要留意版本差異。GitHub repo 目前維護的實驗配置與論文案例圖並不同步:repo 用的是凍結的 715 題訓練、90 題驗證、90 題測試切分,每個手冊階段三個步驟、每個強化學習階段 30 次 GRPO 更新;論文圖表記載的則是每輪十個手冊步驟加二十次更新。README 明言,回報這個實驗必須使用現行配置,不能拿論文早期的案例圖替代。重現論文數字之前,先對齊自己跑的是哪一套。
模擬回饋這件事,最容易在轉述中流失,也最影響解讀。
宣傳影片裡出現「Tests them in real experiments」的字句,產品定位也強調與研究者的持續協作。但論文與 README 都明確寫著,基準實驗使用的是有界的、驗證器輔助的模擬回饋,與研究者的工作區展示是分開的兩回事。實驗裡的「研究者」由 Qwen3.8-27B 模擬,288 場調整對話分批餵入手冊修改流程。真正由研究者本人參與的互動,論文記錄了兩個質性案例。
案例的內容倒是具體。一個是 JAK1 研究:研究者要求用公開的單細胞轉錄體資料與 IMpower133 臨床試驗的 bulk RNA 資料,設計一個關於 JAK1、免疫治療成效與免疫微環境的小細胞肺癌研究。系統組出了一份區分治療效果調節與預後的計畫,把 Seurat 與 Scanpy 分給單細胞分析、UCell 與 AUCell 分給簽名評分、CellChat 與 NicheNet 留給後續的細胞通訊分析。另一個是 ARL4C 研究:研究者要求把一篇論文的背景與結果整理成簡報,指定的輸出包含面板選擇、結論、機制示意圖與講稿,系統用 Python 搭配 PyPDF2 從正文與圖說裡把證據連回主張。
兩個案例展示的是「研究者可以追問與修正」的工作方式,沒有量化比較,也沒有臨床或濕實驗室驗證。把模擬回饋測出的基準數字、兩個質性案例、宣傳影片的實驗意象三件事分開陳述,是這份技術報告誠實讀法的基本功。這份報告的出處也值得記住:PhAI Labs Technical Report 編號 PHAI-TR-2026-02,是機構自行發布的版本,尚未經過同儕審查。
GitHub 上的 Gen-Verse/ScienceBuddy(截至 9 月 24 日約 90 顆星)走 MIT 授權,內容分成兩塊:給研究者看的工作區介紹、展示影片與範例流程,以及名為 Simple-SciBuddy 的簡化代理實作,後者包含實驗用的手冊程式、執行代理、驗證器與 SkyRL 轉接器,整個訓練管線建立在開源專案 SkyRL 之上,並保留一個釘選的未修改上游子模組。
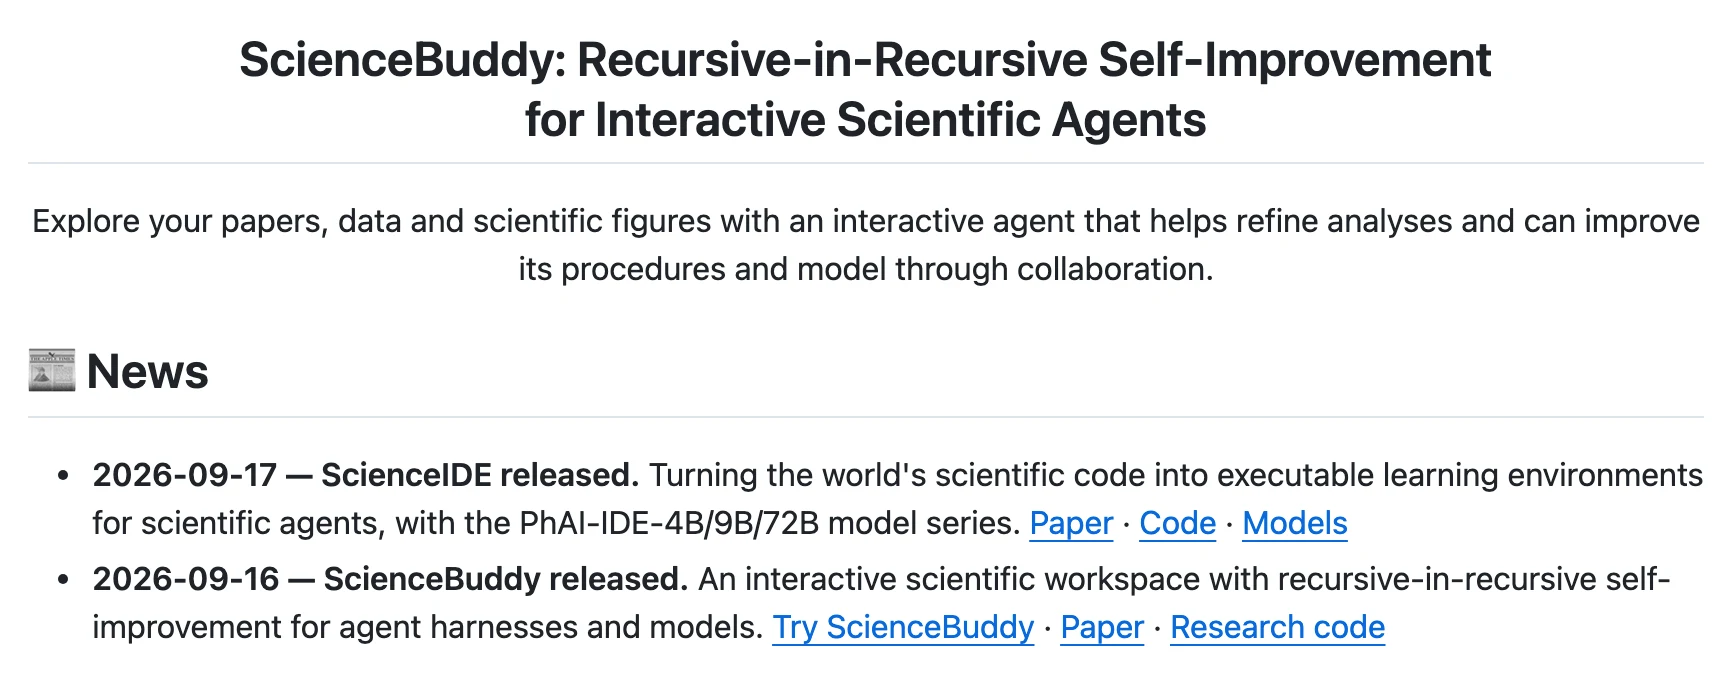
repo 的授權涵蓋範圍有明確邊界: hosted 工作區的前端、帳號系統與產品 API 服務都不在公開範圍裡。想在自家機器重現完整的 ScienceBuddy 服務,現有素材做不到;想重跑簡化版的自我改進實驗,素材是齊的。
作者名單同樣耐人尋味。13 位作者掛了 9 個隸屬單位:PhAI Labs 之外,包含復旦大學附屬中山醫院的肝膽外科與移植部門及肝癌研究所、遺傳與發育複雜表型國家重點實驗室、復旦大學、上海自然科學院、順為資本,以及牛津、史丹佛與普林斯頓大學。創投機構出現在作者隸屬裡並不常見,配合 X 帳號 9 月初才建立的事實,這是一家資金與學術背景都不缺、但公開歷史很短的機構。
回到新聞本體。想要試用的人,實際會碰到幾道牆。
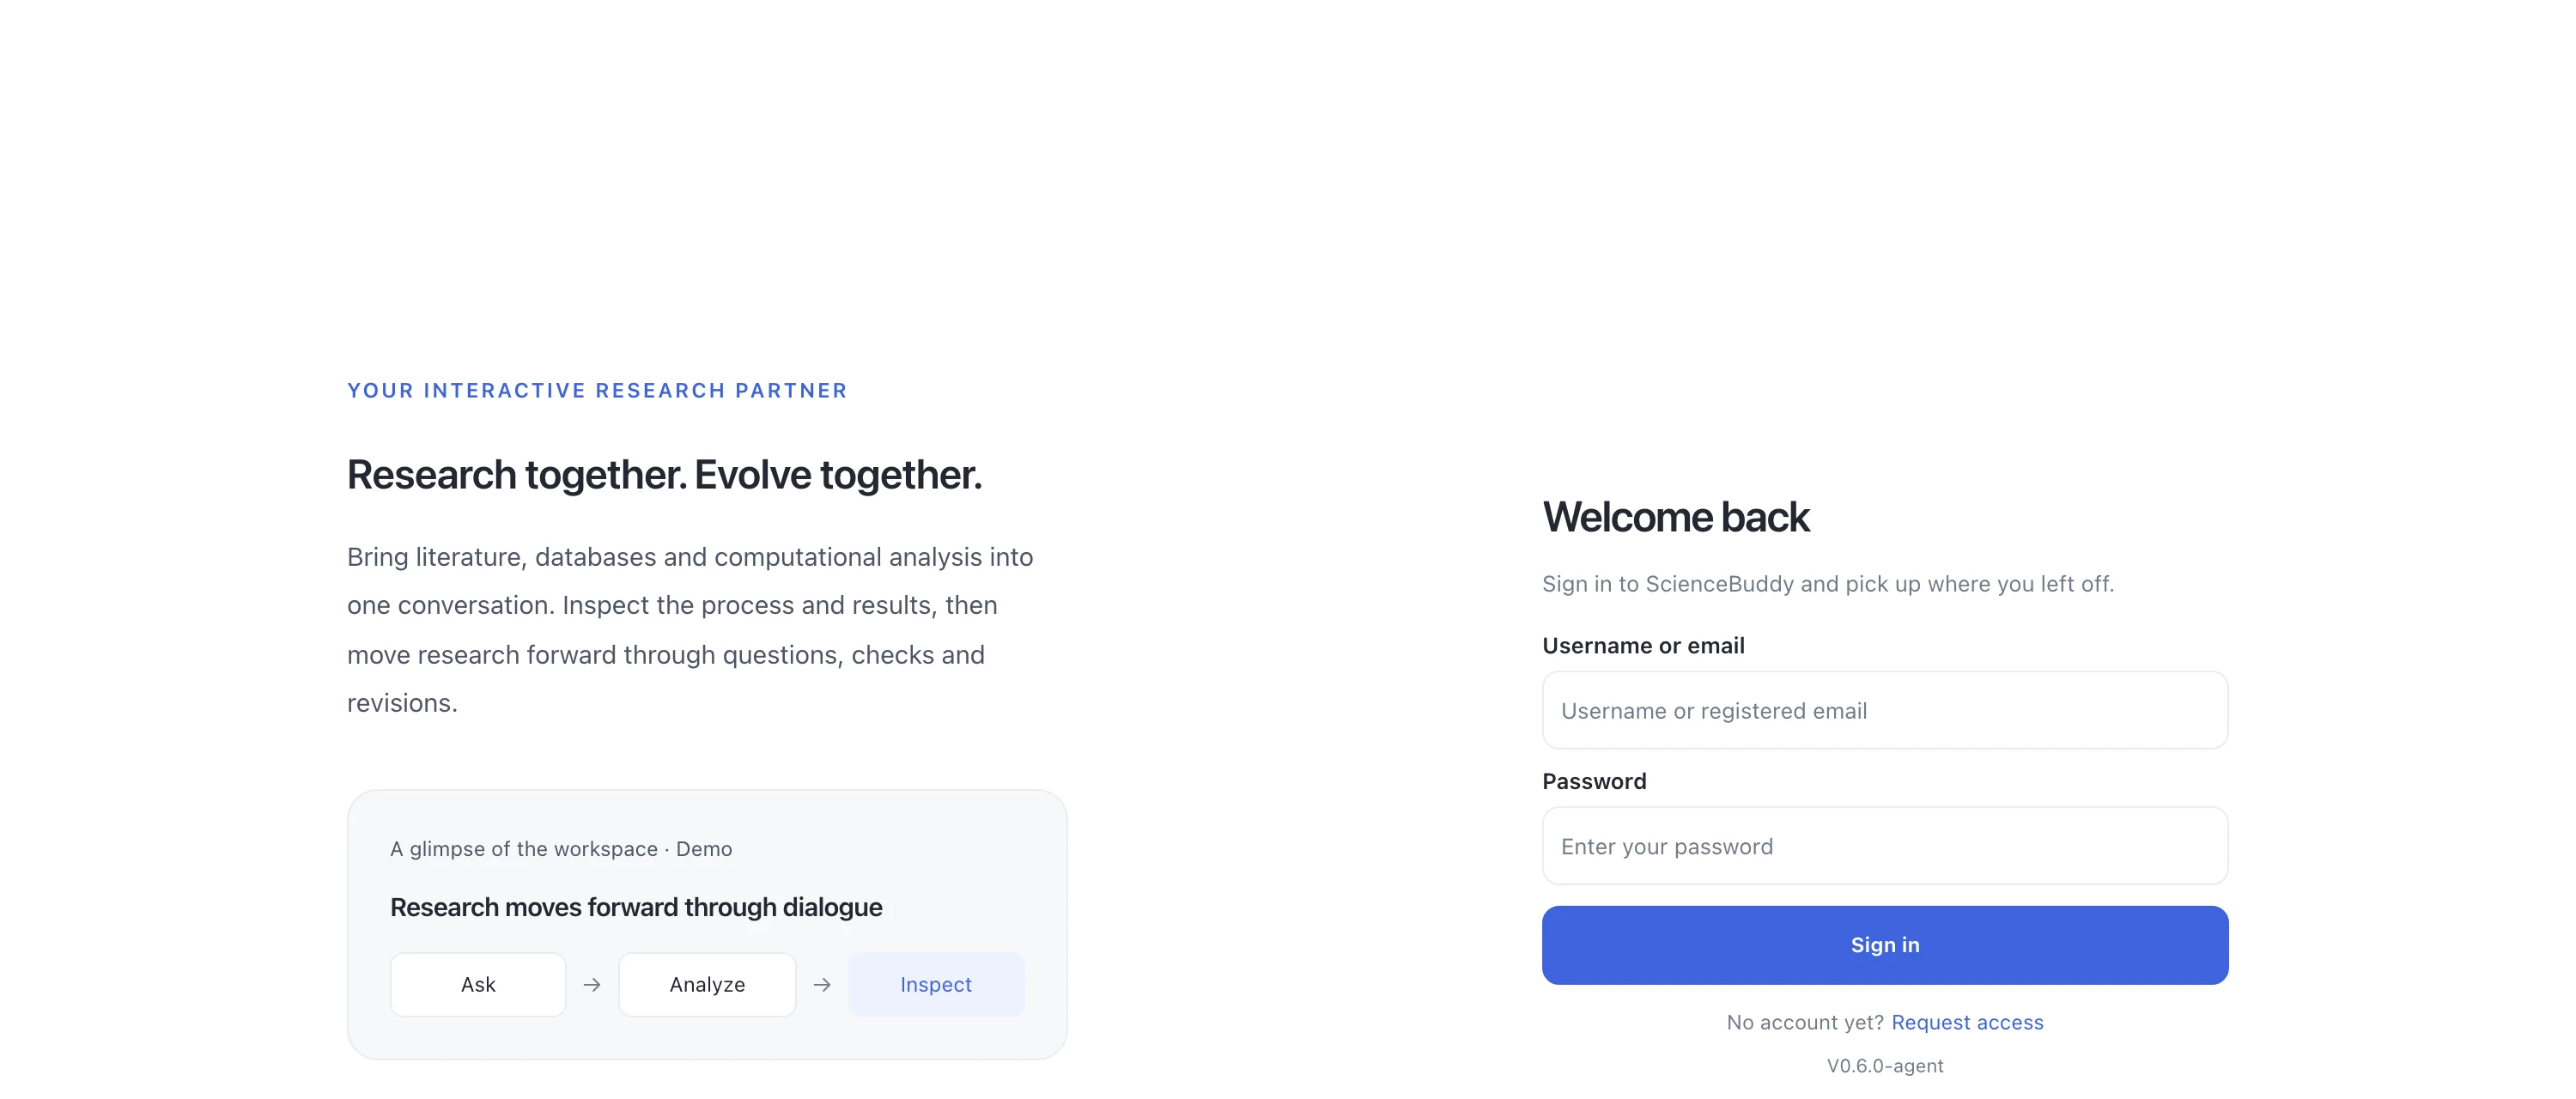
產品入口 science-buddy.io 目前是登入頁,版本號 V0.6.0-agent,沒有帳號的人要按「Request access」申請。也就是說,免費 GPT-6 的消息發布當下,一般訪客連工作區都還進不去。免費的額度上限、使用期限、GPT-6 的具體型號,在貼文、官網公告、論文與產品頁都沒有交代;登入前的頁面原始碼與公開 JS 檔裡,找不到 GPT-6 或 JEV 的字樣,也看不到任何模型清單。
JEV 的情況更空白。貼文寫「fused with the JEV framework」,但論文裡沒有 JEV 這個詞,官網公告與產品頁也沒有。名稱相同的 Jev 模型,本站先前介紹過 TypeSafe 推出的版本,兩者是否為同一事物,現有資料無法確認。在官方補上文件之前,這四個字母只能當成待驗證的行銷詞。
資料治理是另一個空白。工作區的設計鼓勵上傳論文、資料與圖表,並累積互動紀錄,但截至 9 月 24 日,官方公告、論文與登入頁都沒有提供上傳資料如何保存、使用或刪除的說明,也沒有看到獨立的隱私條款頁面。涉及病歷、個人資料、未公開研究結果或商業機密的材料,在條款補齊之前都該先留在自己手裡。介面語言提供英文與中文兩種,中文版的介面字串是簡體中文,還沒有繁體選項。
綜合以上,現階段比較務實的用法,是把它當成一個可以檢查執行過程的研究助理來試:拿公開論文或低敏感度資料跑一個小任務,例如整理證據表、建立資料摘要,或者請它提出一份分析計畫,然後用自己已知答案的題目驗證它的表現,保留原始資料、引用與程式輸出以便核對。研究設計、資料品質與結論,仍然需要領域專家把關。
幾個值得持續追蹤的驗收點:免費 GPT-6 的額度與期限何時寫成文件、JEV 的角色何時獲得說明、隱私條款何時補上,以及這套雙層自我改進有沒有機會在模擬回饋之外,拿到真實研究者參與的量化證據。這幾項一旦更新,判斷就值得重做一次。
同場加映的參考讀物:想理解「從錯誤中學習」在其他代理產品的落地,可以看 Perplexity 把使用者修正變成訓練訊號的做法;想看遞迴自我改進的其他路線,Google DeepMind 的 Dream-RSI 與 智譜的基礎設施代理報告 是兩個對照組;JEV 一詞的來龍去脈,可以先讀 TypeSafe Jev 模型的介紹。