TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

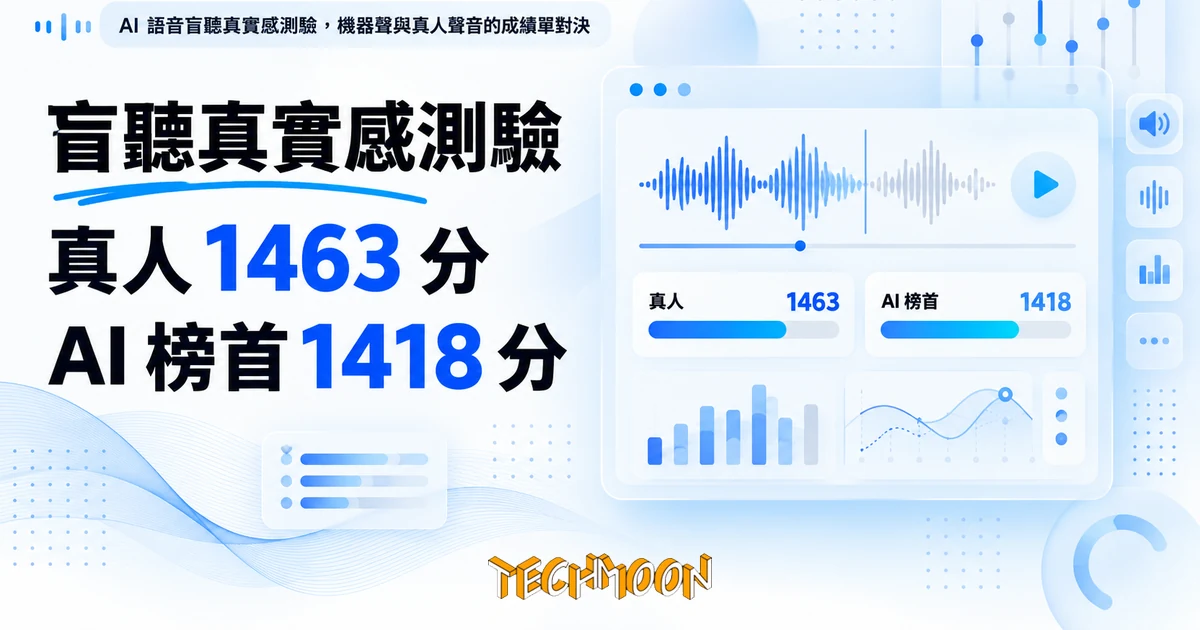
Freya 於 9 月 21 日發表英文 AI 語音 Adam 與 Eve,Adam 在 Design Arena 盲聽真實感榜拿下所有 AI 模型第一、僅次真人錄音。本文核對公開榜單與評測方法,整理這張成績單能證明什麼、還缺哪些證據,以及申請方式與部署選項。
用 AI 摘要這篇文章:
2026 年 9 月 21 日,語音 AI 新創 Freya 的創辦人暨執行長 Tunga Bayrak 在 X 發文,宣布當天推出 Adam 與 Eve 兩款 AI 語音,貼文稱它們是「我們打造過最像真人的 AI 語音」,並補上一句企圖心很強的結論:「我們相信已經跨越了恐怖谷」。支撐這句話的證據放在同一則貼文裡:Adam 在 Design Arena 的 AudioRealismBench 盲聽測驗中,排名所有 AI 模型第一。
先講讀者最需要的判斷。這個第一名是真的:截至 9 月 22 日,Design Arena 的公開資料顯示 Adam 的 Elo 分數為 1418,在全部 23 個條目裡僅次於真人錄音的 1463,領先第三名的 Bland Speech v3 達 49 分。對需要英文語音的產品團隊來說,Freya 值得排進下一輪測試名單。但這張成績單的範圍比「跨越恐怖谷」幾個字窄得多:測的是美式英語、多數約 40 字的短句;同場發表的 Eve 在榜上沒有任何條目;Adam 在電話客服與自然對談兩個分項榜也查無資料。
本文的數字與時間均核對自 Design Arena 公開榜單 API、評測方法頁、Freya 官網與 Y Combinator 公司頁(皆於 2026 年 9 月 22 日查閱),文末附回查期限。
Freya 是 Y Combinator 2025 年夏季梯次的新創,在 YC 目錄上的定位是「企業語音 AI」,2025 年創立,團隊規模 14 人。創辦人 Tunga Bayrak 的背景是視覺語言模型與音訊 Transformer 的研究工程師。公司主業是接聽來電的語音代理(Voice Agent)平台:聽懂來電、生成回答、再把回答說出來。這次發表的 Adam 與 Eve 屬於最後一哩的「怎麼說」環節,也就是文字轉語音(TTS)。聲音像真人,與查對帳單、遵守退費規則是兩件事,榜單也只評前者。
Freya 官網首頁放了一個盲聽小遊戲:同一句話播放兩個版本,一個是真人、一個是 Freya,訪客自己選哪個是人。頁面另一處還預告了一場一百美元挑戰賽,留下信箱等開賽通知。這些設計把「你聽得出來嗎」直接變成行銷本身。
有個名字要先分開:FreyaTTS-small 是這家公司先前公開的土耳其語研究模型,Apache 2.0 授權,論文、權重與評測資料集都開放,音訊輸出取樣率 48 kHz。它與這次申請制的英文商業聲音是不同的產品,看到「Freya 開源」的說法時別混為一談。
官網對新品的說明寫得很直白:兩款英文聲音,Adam 與 Eve,共用一套 API,存取採申請制、分批開放。申請表只要求姓名與電子郵件,公司名稱可選填,送出後由官方回信告知下一步。換句話說,這是正式亮相加早期開放,還不到人人能自助開通、刷卡拿金鑰的階段。
價格也還看不到。Adam 與 Eve 沒有公布獨立費率;企業端的語音代理方案採客製報價,官方列出三個報價輸入:通話量、部署模式與工程需求。部署有兩條路:用 Freya 管理的雲端(機房在土耳其),或把模型裝進自家機房的 on-prem 方案,後者支援氣隙網路安裝,官方頁面明說這是給受監管產業的選項。延遲、同時連線數與服務等級承諾,目前都沒有數字。
誰該留意:聲音自然度會直接影響任務完成的英文產品,例如客服、預約、教學與 Podcast 旁白。誰可以先不動:需要繁體中文的產品(兩款聲音都標示為英文,中文有聲內容可以先看既有的中文文字轉語音實測)、要固定單價才能內部報帳的團隊,以及想立刻自助試用的個人創作者。
Design Arena 的 Audio Realism Benchmark 是一個持續進行的盲聽榜,總榜資料版本更新於 9 月 18 日。前五名如下:
| 名次 | 聲音/模型 | Elo 分數 | 勝率欄位 | 比較場次 |
|---|---|---|---|---|
| 1 | 真人錄音(Humanity) | 1463 | 84.9% | 943 |
| 2 | Freya TTS Adam V1 | 1418 | 77.7% | 314 |
| 3 | Bland Speech v3 | 1369 | 77.7% | 573 |
| 4 | Kalpa TTS Beta V0.1 | 1343 | 71.8% | 471 |
| 5 | Cartesia Sonic 3.6 | 1306 | 64.5% | 152 |
幾個讀法先講清楚。Elo 是把大量兩兩對決的勝負換算成的相對分數,1418 對 1463 的意思是:在這批比較裡,Adam 讓聽眾選它「更像真人」的頻率高於其他所有 AI 模型,但真人錄音仍在前面,差距 45 分。表裡的勝率欄位是該聲音在所有對決中的整體成績,77.7% 不能解讀成「Adam 有七成七的機率騙過真人」;方法頁雖提到可以另外衡量對真人的揀選率,公開榜單目前沒有提供那個分項。
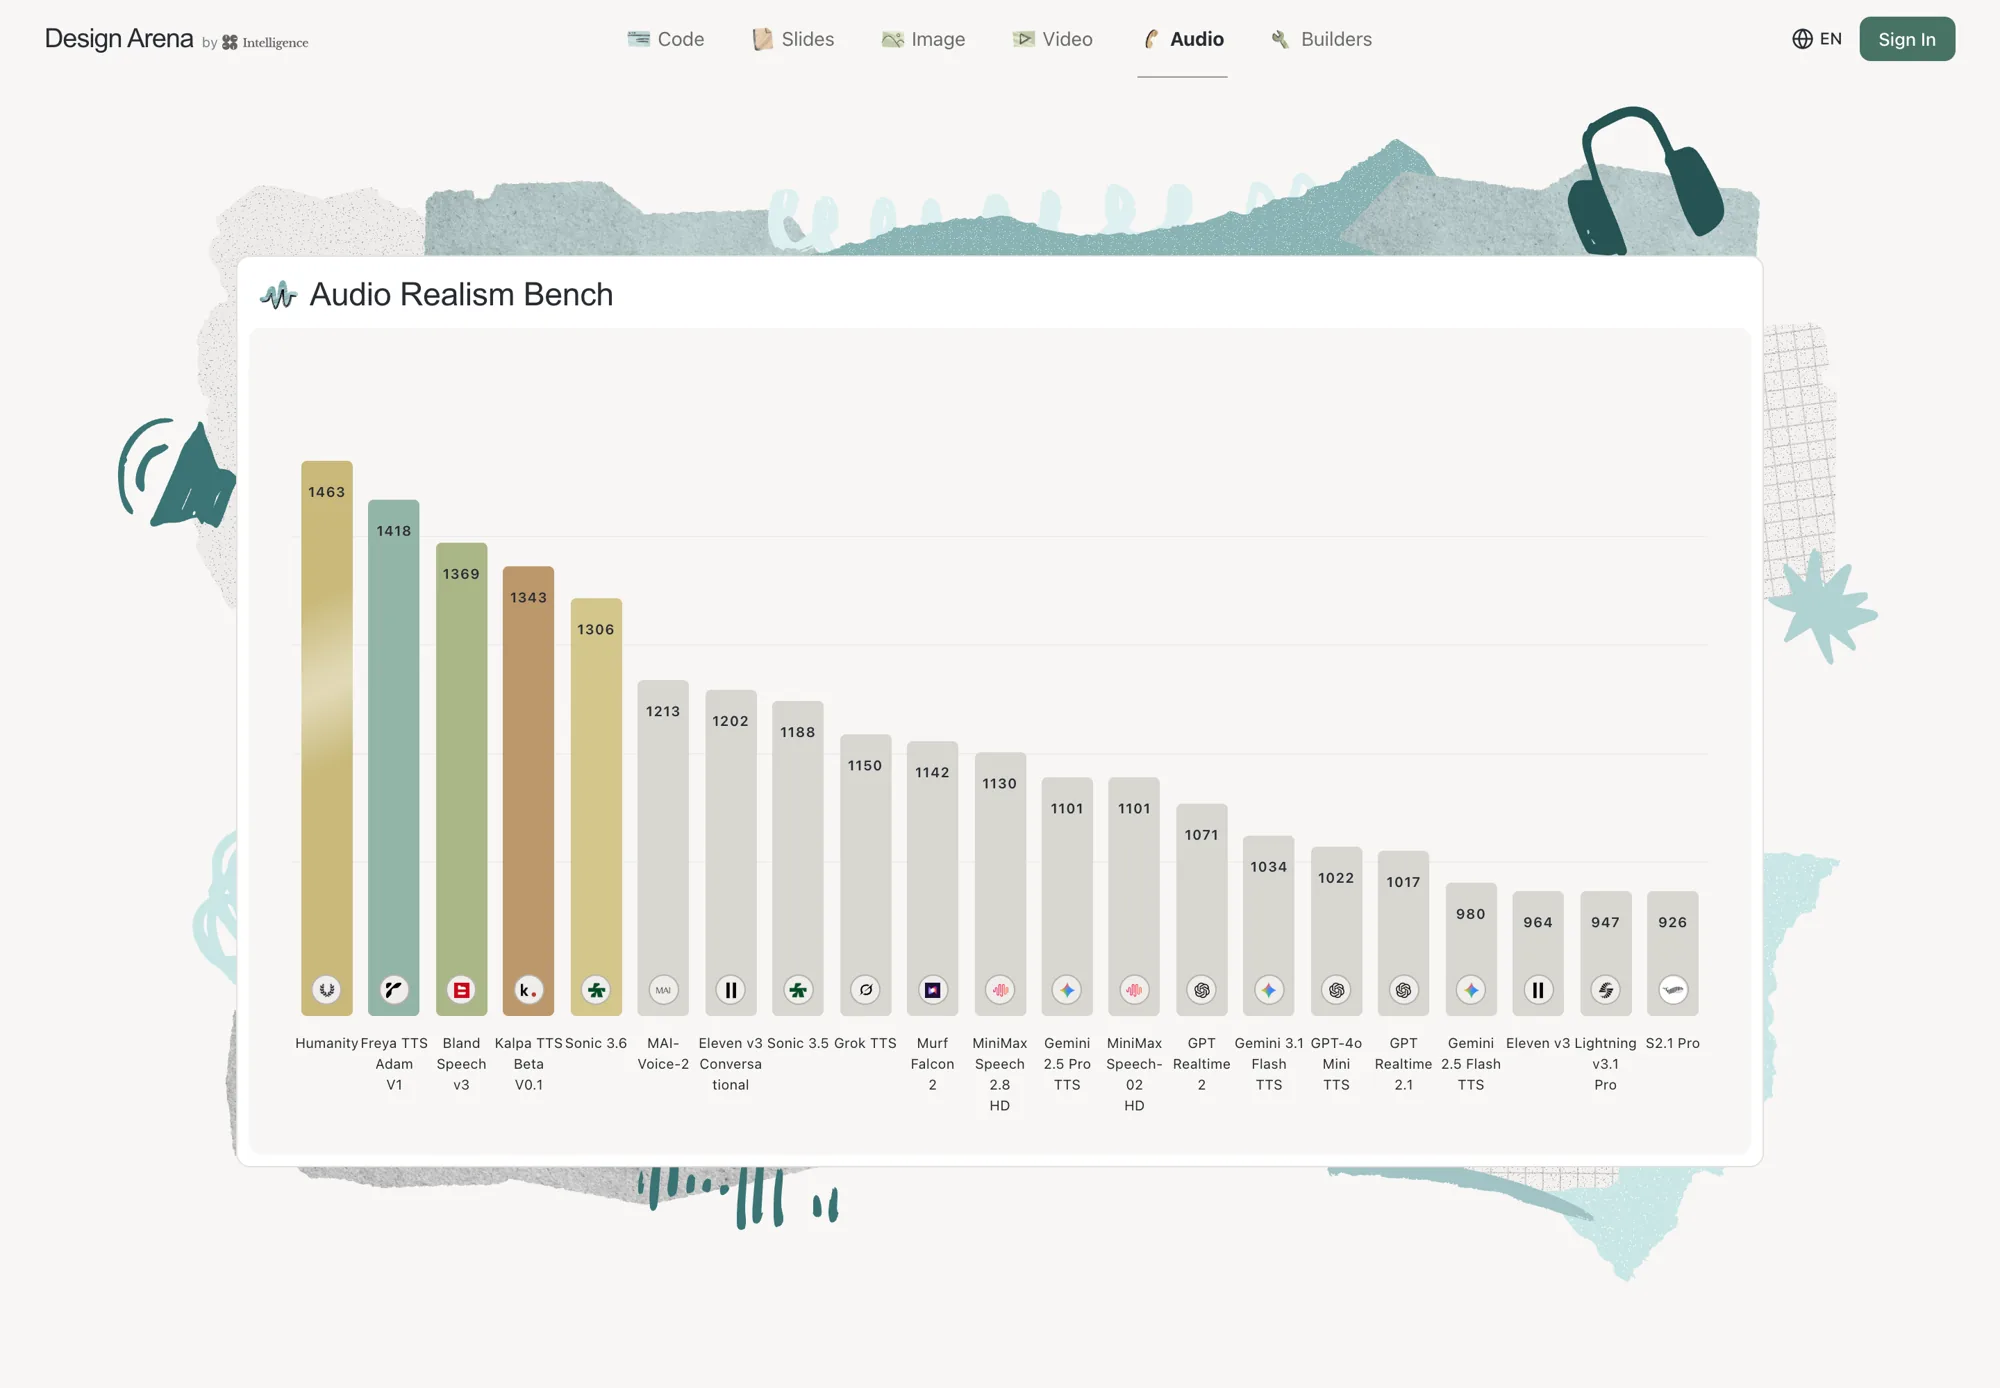
榜單也會動。Freya 官網首頁貼的快照量測於 9 月 16 日,寫的是真人 1462、Adam 1419;兩天後的榜單版本變成 1463 與 1418。這中間沒有誰抄錯,Elo 本來就會隨新增投票漂移,累積投票數在 9 月 18 日版本已達 5,182 次。名次要當時點看,不當永久頭銜看。
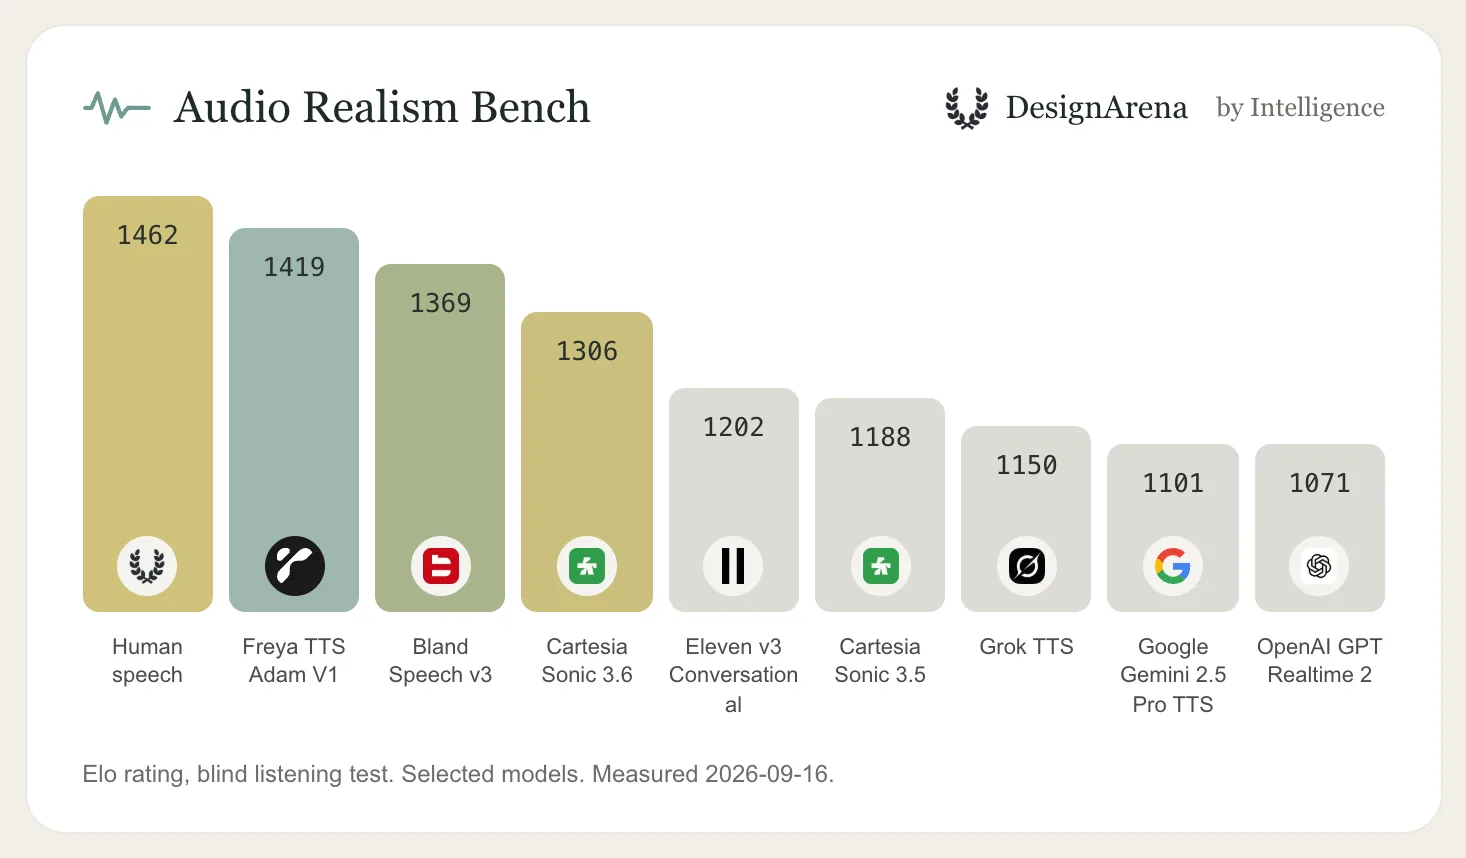
榜上的熟面孔值得認一下。Adam 之下依序是 Cartesia Sonic 3.6(1306)、MAI-Voice-2(1213)、Eleven v3 Conversational(1202)、Cartesia Sonic 3.5(1188)、Grok TTS(1150)與 MiniMax Speech 2.8 HD(1130)。Google 表現最好的語音模型是 Gemini 2.5 Pro TTS,1101 分排在第 12 名;OpenAI 最好的 GPT Realtime 2 拿 1071,排在第 14 名。換句話說,這份榜單上 Freya 領先 Google 與 OpenAI 目前公開參賽的語音模型都超過 300 分。Google 近來把語音代理 API 拆成快聊與深想兩款對外開放,正在比較語音供應商的團隊可以對照著看。
Design Arena 的方法頁寫得比多數 AI 產品公告誠實,重點有五:
邊界也畫得明白:表演性強的語音(遊戲角色、戲劇台詞、陪伴型角色)明確排除在這一版之外,留給日後的表演軌道;評測鎖定美式英語,也不衡量回應速度、長文一致性、打斷後恢復與價格。順帶一提,這個榜單由 Design Arena 經營,方法頁公開語料來源、語料清理流程與收錄標準,也留了信箱讓外界推薦新模型,收錄名單持續在長。對一家 2025 年才成立的新創來說,讓自家聲音進到這種公開、可對照、有真人基準的比賽裡,本身就是一種表態。
總榜之外,三個分項榜的資料也抓下來比對過,結果值得單獨看:
| 分項榜 | 條目數 | Adam 條目 | 該榜 AI 榜首 |
|---|---|---|---|
| 解說(explainers) | 17 | 有,1378 分 | Freya TTS Adam V1 |
| 電話客服(phone agents) | 15 | 查無 | Bland Speech v3(1353) |
| 對談(conversations) | 13 | 查無 | Bland Speech v3(1322) |
Adam 在解說分項是 AI 第一(1378 分,僅次真人的 1451),該分項的勝率欄位 81.5% 還比總榜的 77.7% 高;它的 314 場對決裡,有 189 場來自這個分項。教學與解說類產品因此是現有證據最直接支持的用途。但在電話客服與對談兩個分項,榜上沒有 Adam 的條目,這兩項目前的 AI 榜首都是 Bland Speech v3。
對談分項的榜面還透露一件有意思的事:Google 的 Gemini 2.5 Pro TTS 在那裡排到 AI 第三(1121 分),是它在三個分項裡最好的名次;電話客服分項的第四名則是 Eleven v3 Conversational。不同場景的強弱會洗牌,這正是分項榜存在的理由,也是只看總榜會漏掉的部分。
官方沒有解釋缺席的原因。合理的可能至少有兩個:評測覆蓋還在進行,或者這個聲音尚未送測那兩項。無論是哪一種,結論都一樣:總榜第一不能外推成「打電話也第一」。而電話客服恰恰是 Freya 這類企業語音代理最核心的應用場景。
恐怖谷本來是描述人形角色的詞:越像人、又差一點的東西,反而讓人不舒服。放到語音上,破綻會是過度乾淨的呼吸、突然切換的情緒、奇怪的重音,或長對話中慢慢走音的聲線。打電話到客服的人不會給模型第二次機會,一句語氣不對就可能直接掛斷轉人工,所以「像真人」對這個市場是真需求,也值得用嚴格的標準檢視。用這個標準看,Freya 的宣稱要先補齊四件事。
最先欠的是 Eve 的成績:同場發表的第二款聲音,在榜單裡沒有條目,Adam 的分數延伸不到 Eve 身上。語言範圍也還沒有第二張單:評測鎖定美式英語,繁體中文、台灣口音、中英混讀、人名與地址的唸法全部沒有資料,新品頁也只標英文聲音。完整對話是另一題:使用者真實感受到的是「說完之後等多久、能不能插話、回答對不對」,這些都不在真實感榜的範圍裡。長時間穩定同樣未知:15 秒像真人,與 30 分鐘通話不漂移,中間還有一段距離。
所以我的位置是:Adam 已經拿出比官方精選示範強得多的證據(第三方經營、匿名比較、有真人對照組),值得認真對待;「最像真人」當行銷語可以,當全面結論還早。
英文語音產品團隊:把申請表填了排隊,同時準備一輪公平的對照測試。拿到資格後,用同一批來自真實情境、清掉個資的腳本(量級抓 50 到 100 段就夠做第一輪判斷),讓 Adam、Eve 與現有供應商唸同樣內容。匿名成對比較只回答自然度一件事,旁邊要自己補上幾個欄位:正確性(人名、金額、日期、縮寫有沒有唸錯)、任務合適度(道歉、提醒、確認的語氣對不對)、端到端延遲、重複生成與尖峰時段的穩定性,以及把 TTS、語音辨識與語言模型加總的完整成本。通過條件建議設務實一點:自然度進步的同時任務完成率沒有掉、延遲與成本落在可接受區間,才進下一輪。
採購端還要把資料落地問清楚:雲端方案的機房在土耳其,錄音與逐字稿存在哪裡會直接影響合規判斷;資料不能出境的產業,官方提供了裝進自家機房、支援氣隙網路的 on-prem 選項,這在語音代理採購裡常比榜首名次更有分量。
繁體中文產品:等官方釋出多語言資訊再說。用英文榜單外推中文品質,現在沒有任何依據。
一般讀者:官網的盲聽小遊戲可以直接玩,自己聽一次比看十篇報導準。聲音擬真帶來的風險也提醒在這裡:聲音越難分辨,產品端越該主動揭露「這是 AI」,通話涉及匯款與身分驗證時加上第二道確認。想實際感受聲音複製技術現況的讀者,可以參考我們實測過的免費語音克隆工具。
四件事維持未知:Eve 的品質與評測條目何時出現;Adam 是否會進入電話客服與對談分項;公開費率與延遲數字;以及榜單排名的後續變化(9 月 18 日資料版本之後,每多一場投票都可能改寫名次)。
時效聲明:本文榜單數字以 2026 年 9 月 22 日查閱的公開 API 內容為準(資料版本 9 月 18 日);Freya 公布 Eve 的評測條目、費率或延遲資訊,或 Design Arena 更新分項覆蓋時,本文對應段落即需回查。建議的回查時點是 2026 年 10 月上旬,或任何一方官宣新版本之後。