TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

vLLM v0.34.0(2026-11-16 發布)把 extensible KV cache 設為預設、gpu-memory-utilization 未設時改為 1.0,官方建議多數部署直接刪掉這個參數;本文用官方文件與 Hugging Face 檔案實數重算 24GB 顯卡的容量帳,並按支援矩陣分清 RTX 3090 與 4090 的量化路線。
用 AI 摘要這篇文章:
一張 24GB 的 RTX 4090 要當整個團隊共用的本地推論伺服器,卡住的地方通常不是算力,是記憶體。以 Qwen2.5-14B 為例,原始 BF16 權重在 Hugging Face 上的八個分片加起來有 27.51 GiB,整張卡都塞不進去;量化之後裝得下了,問題接著變成:KV cache 還剩多少空間、同時能服務幾個人。vLLM 在 2026 年 11 月 16 日發布的 v0.34.0(GitHub 於 23:22 UTC 上架、PyPI 於 23:51 UTC 跟上),把這道算術的兩個關鍵預設整個換掉:KV cache 的容量不再靠起跑前的估計,改在暖機之後按實際剩餘的記憶體配置;gpu-memory-utilization 未設定時的預設值改成 1.0。官方在升級說明裡給出的建議很直接:多數情況下,把這個參數從設定裡刪掉。
如果你的部署腳本還留著近年各路教學幾乎都會寫的那行 --gpu-memory-utilization 0.9,升級之後它從穩妥的保險變成會觸發引擎警告的舊習慣。24GB 這個級別的容量帳,可以用官方文件裡能驗證的數字重算;RTX 3090 與 4090 的量化路線,順著官方支援矩陣就能分清楚。目標畫面很具體:一條 vllm serve 指令把模型拉起來,本機多出一個 OpenAI 相容的 API 端點,團隊成員把 client 的 base_url 指過來就能共用,而且你說得清楚這張卡同時撐得住幾個人。
gpu-memory-utilization 控制的是模型執行器可用的 GPU 記憶體比例,範圍 0 到 1,每個 vLLM 實例各自生效。舊機制的問題在時間點:引擎還沒暖機,就要按這個比例先圈出一塊記憶體給 KV cache,圈多了浪費、圈少了中途爆炸。v0.34.0 引入的 extensible KV cache 把時間點往後挪:以裝置端虛擬記憶體先保留 KV cache 的位址範圍,等 CUDA graph 捕捉與暖機都跑完,再按當下實際剩餘的記憶體提交實體頁面,而且這套機制在 CUDA 與 ROCm 上預設開啟。
前後差異在官方文件裡對得起來。參數說明頁現在寫的是:未設定時,extensible KV cache 開啟的情況下預設 1.0,其他路徑 0.92。升級表加了一條新的行為:顯式設定在 0.8 到 1.0 之間、而且因此扣住 1GiB 以上的記憶體,引擎會記一條警告。什麼時候還需要設這個參數?官方給了兩個場景:要與其他行程共享這張 GPU,或者停用 extensible KV cache 時。翻成 24GB 的實際情境:顯卡同時接著螢幕跑桌面的工作站,保留一個低於 1.0 的值仍然合理;純伺服用途的卡,官方的新姿態是把整張卡交給引擎。
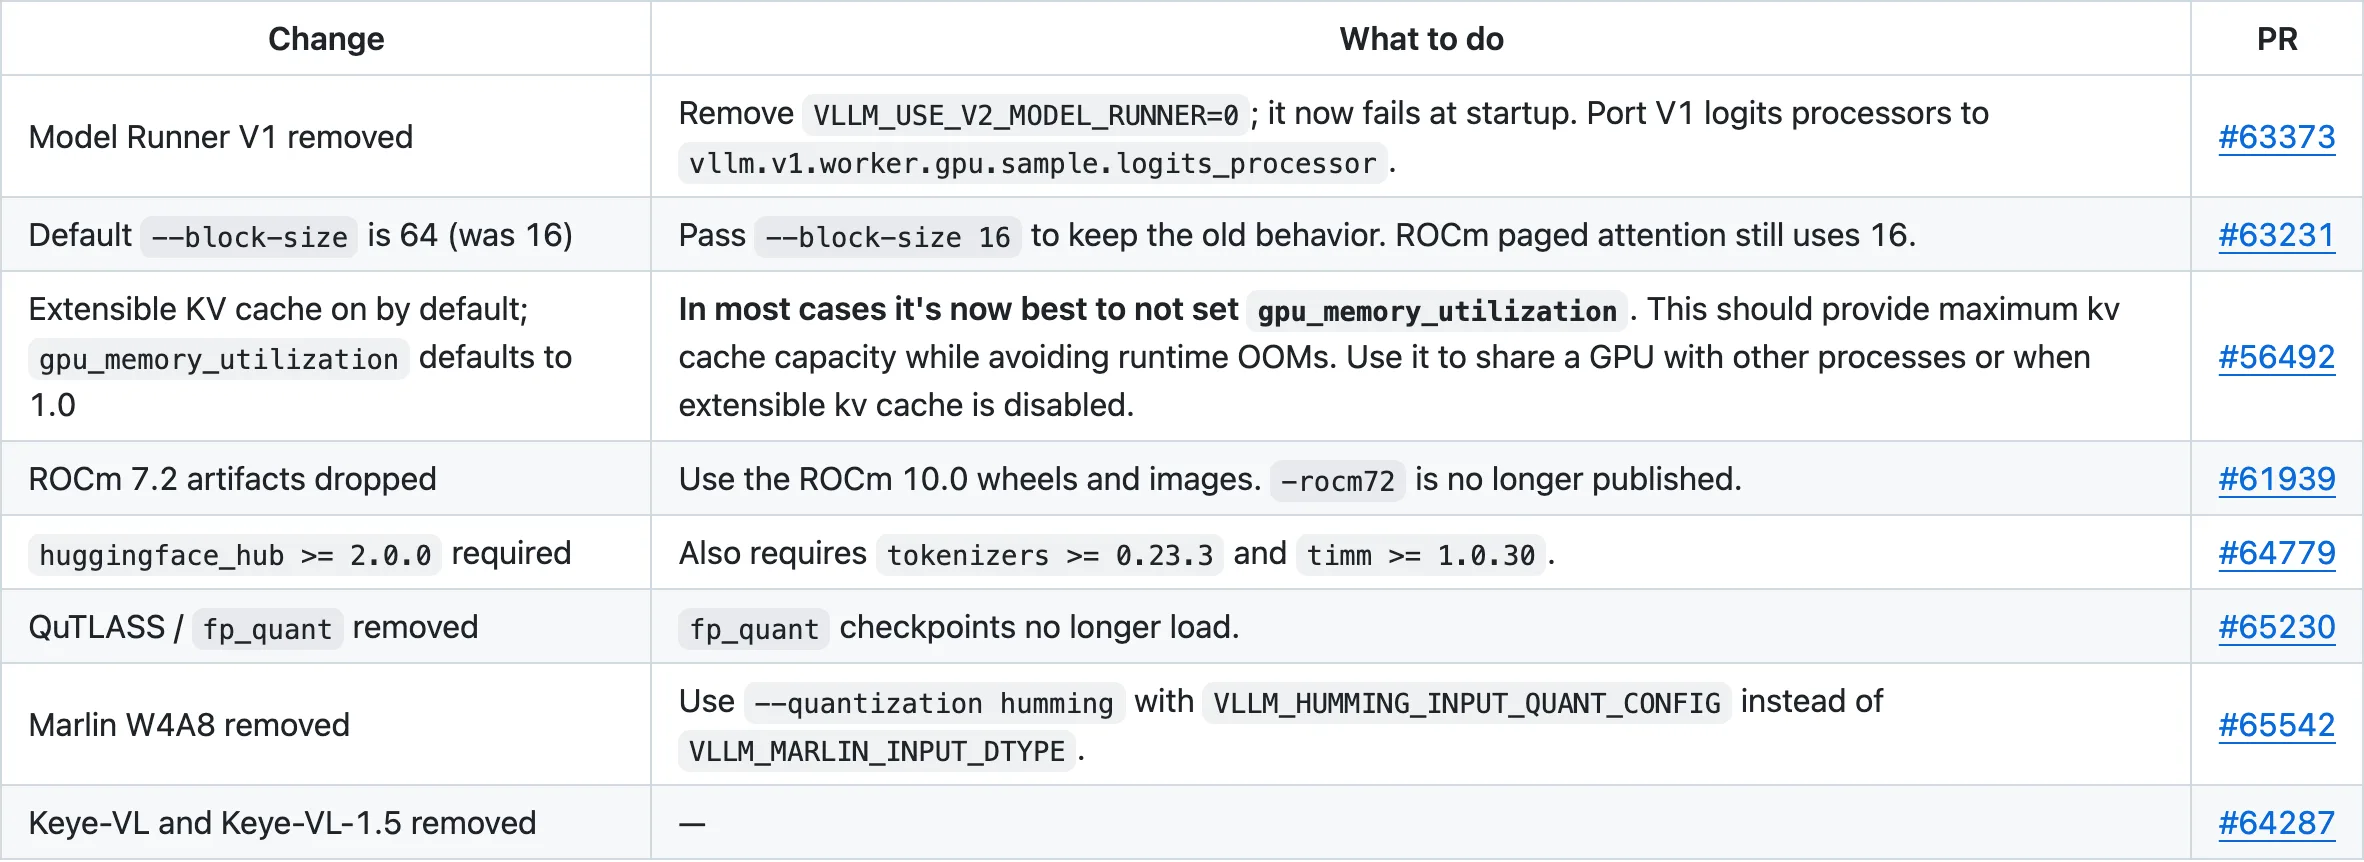
兩個例外順著文件補充。部署若明確設了 kv_cache_memory_bytes,extensible KV cache 不接手,容量照你給的位元組數走,這波預設變更與你無關。而 CUDA 與 ROCm 以外的後端(例如 CPU 推論)走的是估計路徑,參數說明裡的 0.92 就是為那條路保留的值;消費級顯卡上的 NVIDIA 部署,只要驅動支援裝置端虛擬記憶體、又沒設 kv_cache_memory_bytes,這次都落在新機制裡。
同一張升級表還列了幾個會咬到既有部署的變更:KV 區塊的預設大小從 16 token 改為 64(AMD 的 ROCm 分頁注意力維持 16,要舊行為得顯式給 --block-size 16);Model Runner V1 移除,環境變數 VLLM_USE_V2_MODEL_RUNNER=0 現在會直接啟動失敗;相依套件要求 huggingface_hub 2.0.0 以上(連帶 tokenizers 0.23.3 與 timm 1.0.30)。這一版收了 1,061 個提交、來自 412 位貢獻者,其中 120 位是新加入的,量級本身就是 vLLM 這個 Apache-2.0 專案的日常:倉庫 2023 年 2 月建立,到 2026 年 11 月已有超過 9.7 萬顆星。
為什麼暖機後實測比起跑前估計好?CUDA graph 捕捉本身就會佔用記憶體,起跑前的估計抓不到這一塊,只能靠使用者手動預留餘裕,這正是 0.9 這類建議值的由來。官方在發布說明裡給的例證(以下為官方自行量測的數字,案例是 H200):MiniMax-M3 在 H200 上,KV cache 可容納的 token 數從 43.3 萬增到 67.2 萬,高併發下的吞吐與首 token 延遲都受惠。取捨也寫在明處:部分模型在 128 併發下,每 token 的解碼時間(TPOT)上升 6% 到 18%。互動延遲敏感的服務有兩個退出開關:退回 --gpu-memory-utilization 0.9,或用 --no-enable-extensible-kv-cache 整組關掉。
這套容量管理的源頭,是 2023 年 6 月的官方部落格與同年 9 月上傳的論文(arXiv 2309.06180):把每個請求的 KV cache 切成固定大小的區塊,用區塊表映射到不連續的記憶體位置,概念借自作業系統的虛擬記憶體分頁,官方的類比是區塊當頁、token 當位元組、請求當行程。當年部落格量測,既有系統有 60% 到 80% 的 KV 記憶體浪費在碎片與過度預留,PagedAttention 把浪費壓到 4% 以下。v0.34.0 這一步,是把「配置多少」也交給引擎量,不再讓使用者用一個比例去猜。往晶片端看,記憶體架構本來就是推論吞吐的下一個戰場,這個方向可以對照 NVIDIA 對記憶體協同設計的拆解(/nvidia-memory-codesign-kv-cache/)。
TPOT 上升的取捨值得多看一眼,因為它與併發人數是同一枚硬幣的兩面:KV cache 變大讓更多人同時在場,但每個人的解碼步調可能慢一點。對打字補全這類串流場景,6% 到 18% 的每 token 延遲增加會直接疊進體感;對批次處理、摘要生成這類整批交付的場景,吞吐增加通常更划算。官方把退出開關做成兩個粒度,就是讓你按工作負載選,而不是全有全無。同場發布的還有十個新模型的支援(Mistral Large 4、MiniMax-M3.1-Flash 等)與 Blackwell、MI355X 上的加速(官方數字:Step5 在 GB200 上解碼最高 1.95 倍),但那些是新卡的故事,24GB 消費卡能直接受用的,就是記憶體配置這一項。
權重體積不用估,Hugging Face 的檔案清單就是實數。以 2026 年 11 月的清單計算:
| 配置 | 權重體積 | 24GB 剩給其他 | 定位 |
|---|---|---|---|
| Qwen2.5-14B BF16(8 分片) | 27.51 GiB | 裝不下 | 需要雙卡或量化 |
| Qwen2.5-14B FP8(4 分片) | 15.21 GiB | 8.79 GiB | Ada 卡的主力選項 |
| Qwen2.5-14B AWQ(3 分片) | 9.29 GiB | 14.71 GiB | 長上下文與併發優先 |
| Qwen3-32B AWQ(4 分片) | 18.00 GiB | 6.00 GiB | 大模型低併發 |
接著算每個人要的 KV。每 token 的 KV 記憶體有一條可驗算的公式:2(鍵與值)× 層數 × KV 頭數 × 每頭維度 × 每元素位元組。Qwen2.5-14B 是 48 層、8 個 KV 頭、每頭 128 維,FP16 之下每 token 是 2×48×8×128×2 = 196,608 bytes,約 192 KiB。換算成每人用量:8K 上下文每人 1.5 GiB,16K 每人 3.0 GiB。併發人數的估計就是除法:KV 預算除以每人用量。
拿上表做兩個示範(此處分配值僅為算式示範,實際以暖機後引擎配置為準)。14B FP8 權重裝入後剩下 8.79 GiB 要涵蓋 CUDA 圖形、激活與 KV;若 KV 分到 6 GiB,8K 上下文、FP16 KV 約可容納 4 個人同時連線,換成 FP8 KV(每 token 96 KiB,8K 每人 0.75 GiB)約 8 個人。AWQ 版本剩下 14.71 GiB,若 KV 分到 12 GiB,同口徑下 8K 約 8 人、16K 約 4 人,想撐長文檔摘要或 RAG 塞 16K 上下文的團隊,這格數字就是取捨依據。這也正是 v0.34.0 的意義:過去你要先猜一個比例把自己框住,現在引擎暖機後自己量出那個 6 GiB 或 12 GiB。
Qwen3-32B-AWQ 也塞得進 24GB,但每 token KV 是 256 KiB(64 層×8 個 KV 頭×128 維),8K 上下文每人 2.0 GiB,而權重裝完只剩 6.00 GiB 涵蓋所有開銷,定位就是兩三個人的低併發大模型。順帶一提,--max-model-len 不設時會由模型設定推導上限,給 auto 則自動挑選能塞進 GPU 的最大長度;想防單一超長請求吃掉所有人的容量,這是該設的上限。
官方支援矩陣把界線畫得很清楚:llm-compressor FP8(W8A8,FP8 權重加 FP8 激活)標在 Ada 與 Hopper 支援、Ampere 不支援、AMD GPU 支援;AWQ 從 Turing 架構起就支援,GPTQ 甚至連 Volta 都在支援之列。RTX 3090 是 Ampere、RTX 4090 是 Ada,兩張卡在這份矩陣上走向不同的路:4090 跑 14B FP8 原生形態,3090 走 4-bit 權重。
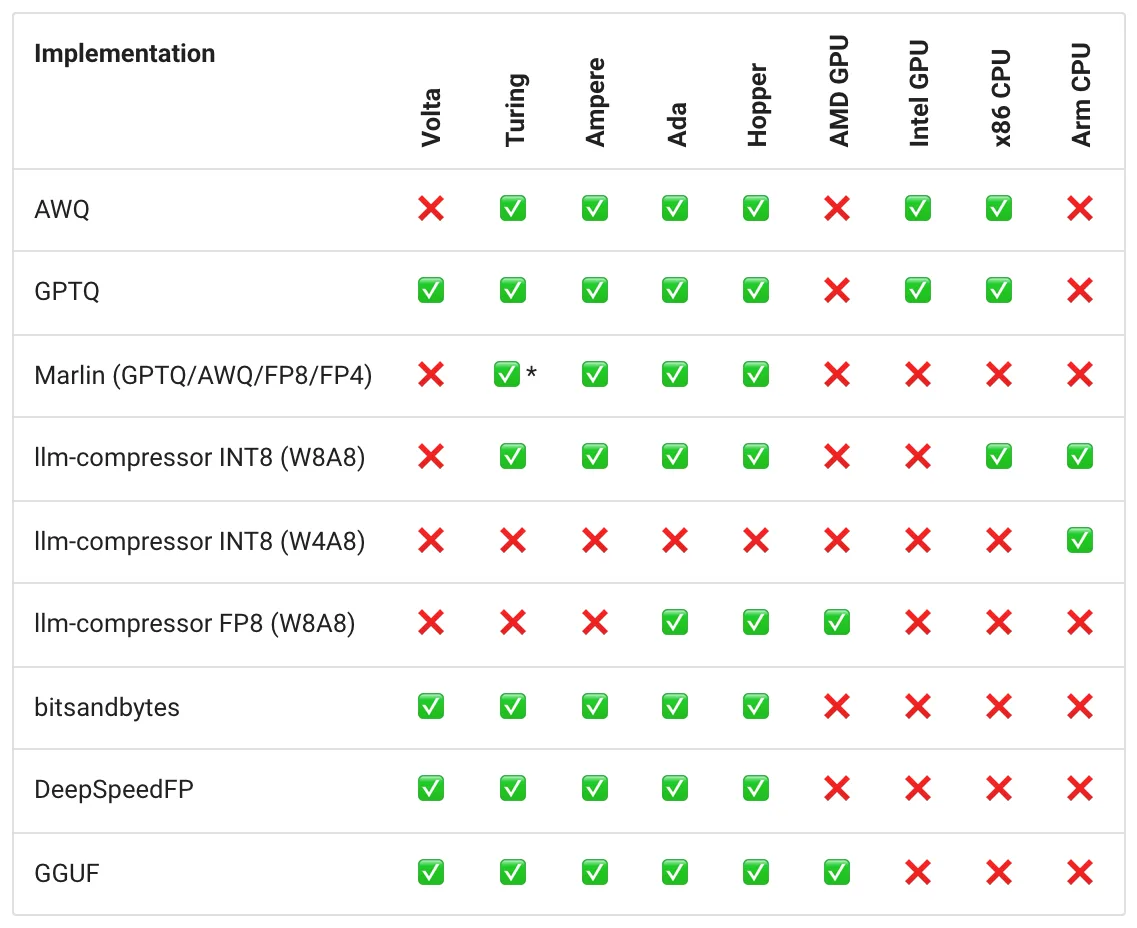
3090 載入 FP8 模型不會直接失敗,但形態會變。文件寫明:核心不支援時,vLLM 預設退回 weight-only 核心(Marlin、Humming 等),權重維持量化、激活改用 16 位元跑,等於 W8A8 變成 W8A16;代價是與 checkpoint 校正時的基準不同,而且啟動時會記一次警告。想把這種自動退回關掉,設 VLLM_STRICT_QUANT_SCHEME=1。換句話說,在 Ampere 上引用 FP8 模型的效能評測前,先確認它跑的是哪一種形態。
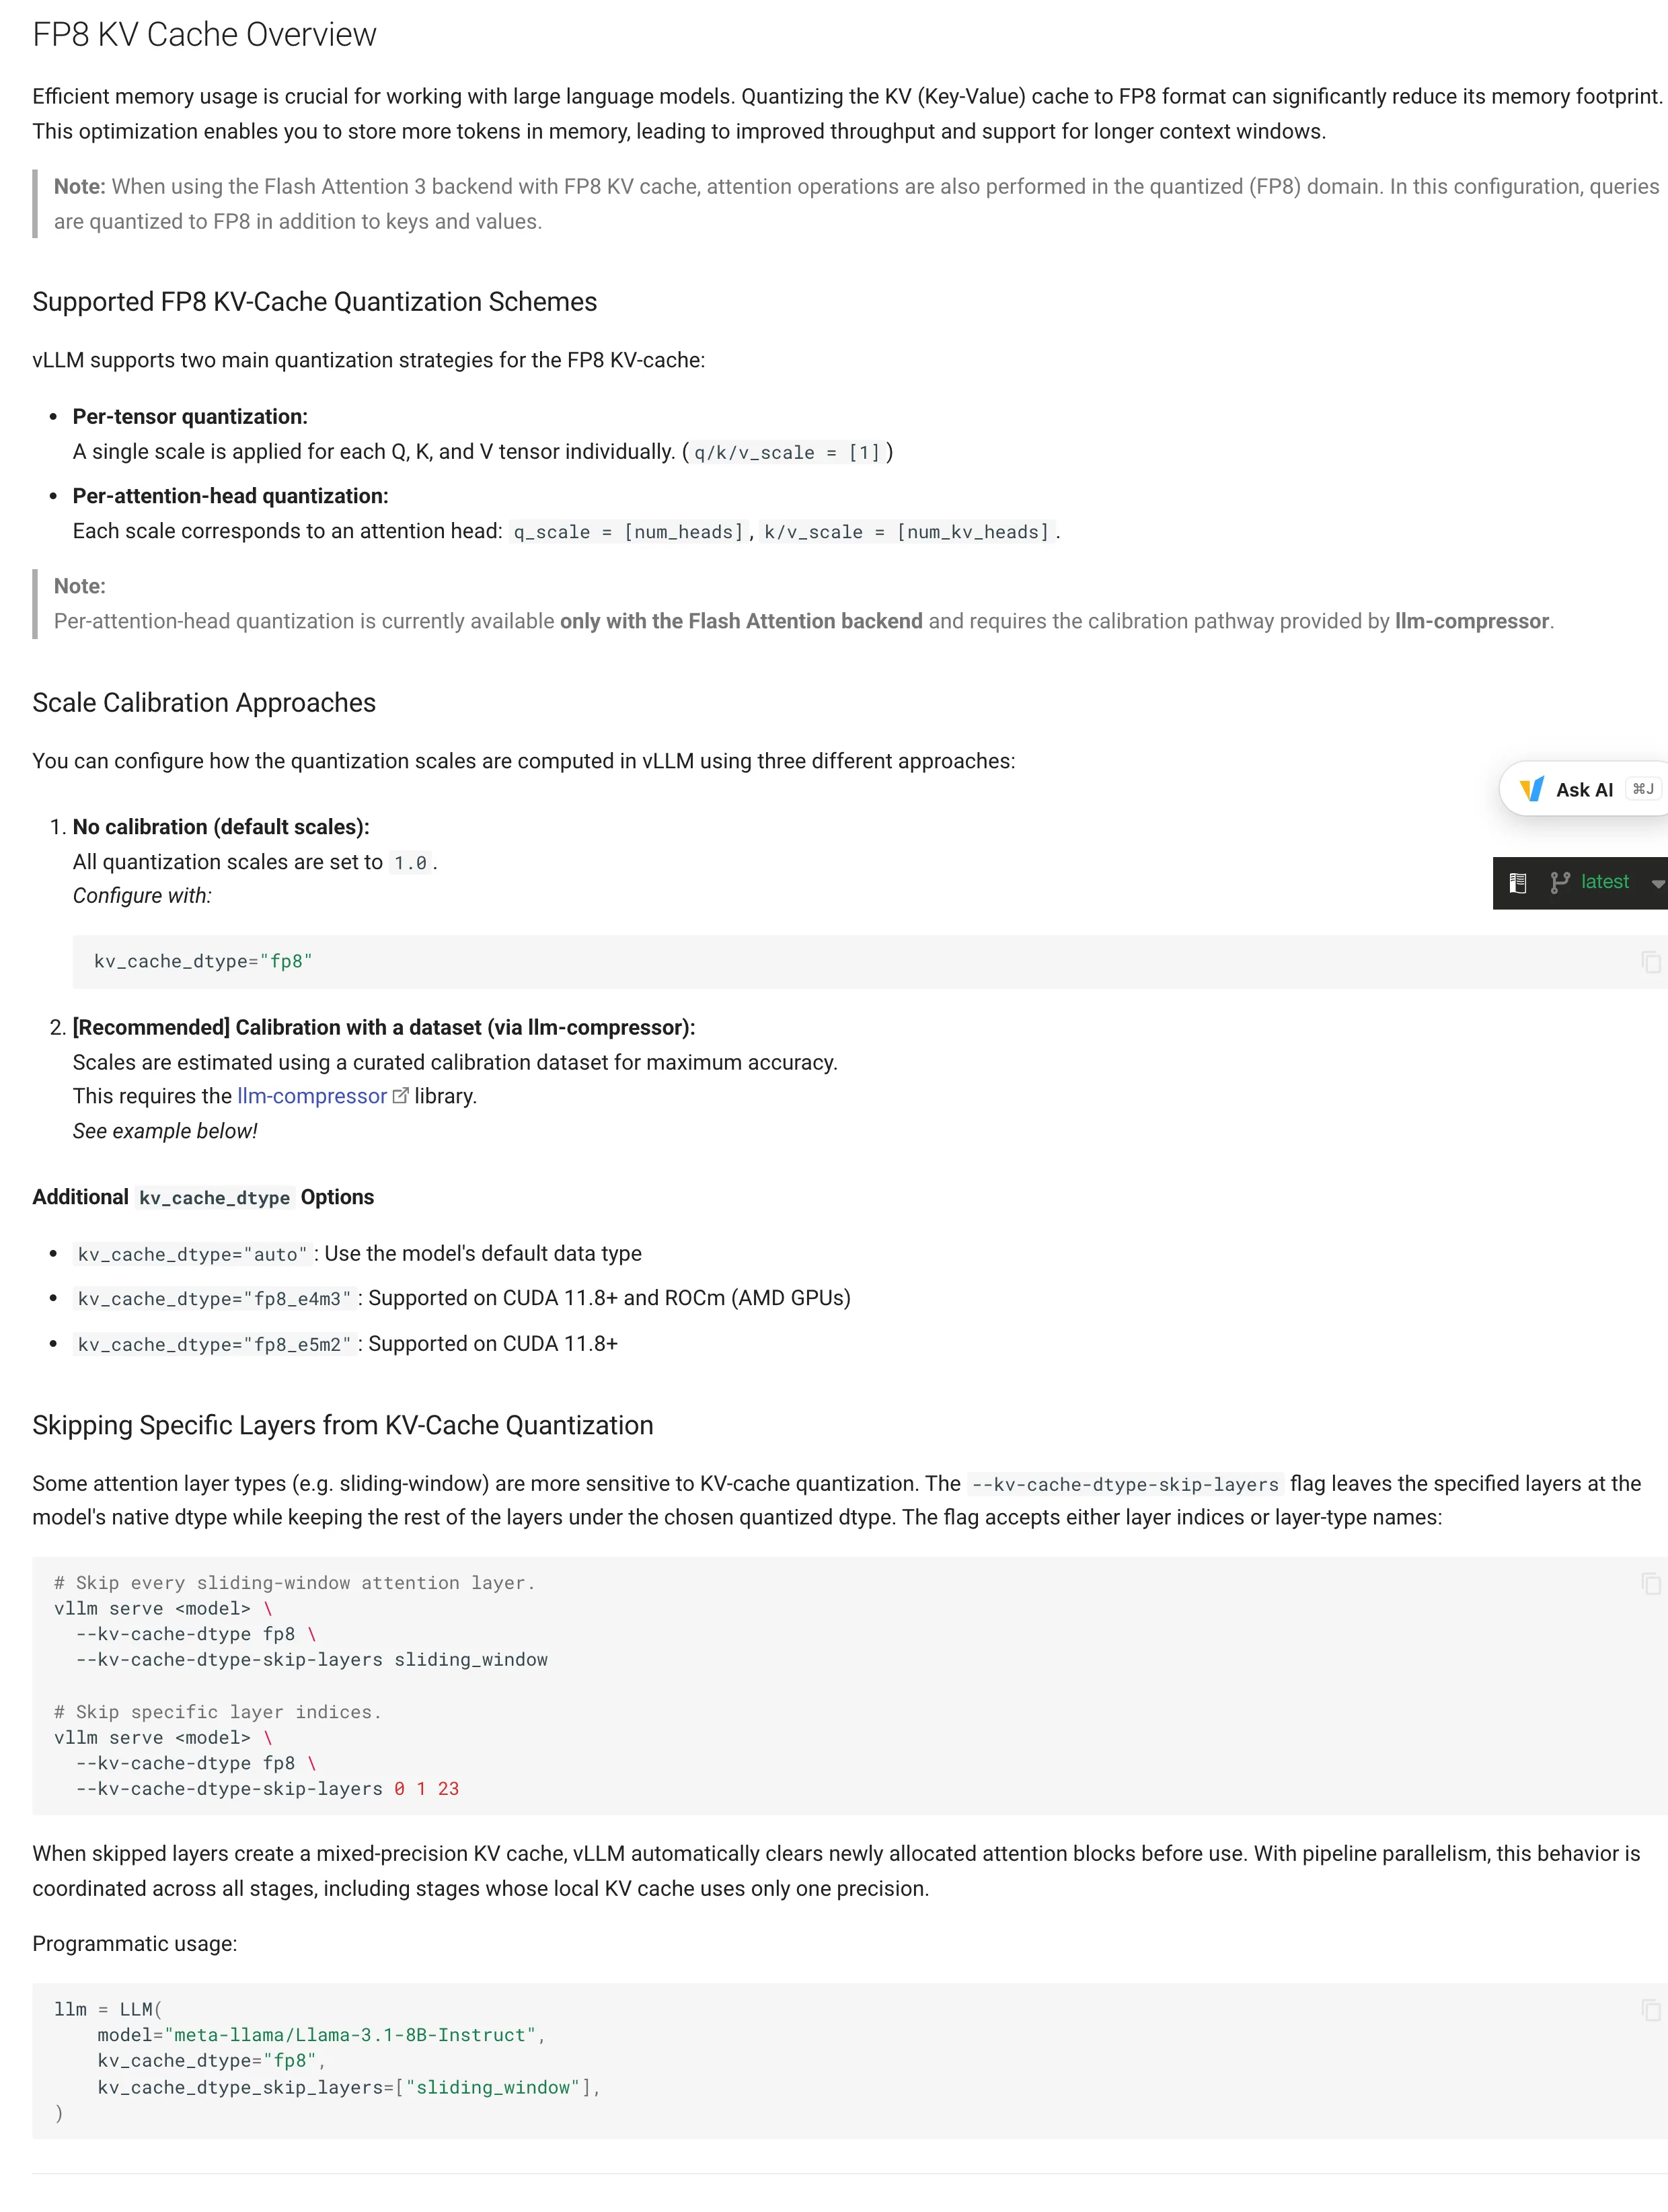
另外一件容易混在一起的事:FP8 權重與 FP8 KV cache 是兩個獨立開關。--kv-cache-dtype fp8_e4m3 的文件寫支援 CUDA 11.8 以上與 ROCm,也就是說 Ampere 的 3090 雖然不能用 FP8 權重的原生路徑,仍然能把 KV 記憶體砍半換併發人數;文件還提供跳過特定層的參數(滑動視窗類的注意力層對 KV 量化比較敏感,可留在原生精度)。3090 上最務實的組合因此是:AWQ 或 GPTQ 權重,加上 FP8 KV cache。矩陣裡 GGUF 也從 Volta 到 Hopper 全線支援,手邊有更舊的卡時還有退路。若要往資料中心等級的 FP8 部署看齊,NVIDIA 用 B200 叢集跑開放模型的部署配方是另一個量級的參考(/nvidia-dynamo-korea-model-recipes/)。
「要多人同時用就得換 vLLM」這句話其實站不住。Ollama 官方文件寫明它有兩層並行:多個模型可同時載入(OLLAMA_MAX_LOADED_MODELS,預設是 GPU 數的三倍),單一模型內也有並行請求(OLLAMA_NUM_PARALLEL)。真正的差異在預設值與記憶體行為:非 Metal 後端的 OLLAMA_NUM_PARALLEL 預設是 1,Mac 上 MLX 後端才會依可用記憶體挑一個保守值;而且並行會放大 context,官方給的例子是 2K context 開 4 個並行,就會變成 8K context 並分配更多記憶體;佇列上限 OLLAMA_MAX_QUEUE 預設 512。vLLM 這邊,分頁 KV、連續批次到這次的實測式配置,全部以 GPU 吞吐為設計中心,並直接暴露 OpenAI 相容的 API 端點,Dify、Open WebUI 或自寫程式只要把 base_url 指向本地主機就能接上。
選擇可以很務實:兩三個人偶爾用、常換模型、在 Mac 上跑,Ollama 的維護成本最低;要把一張 24GB 卡當成團隊常駐的 API 服務、併發需求超過個位數,vLLM 的設計就是為此而來。安裝門檻先記得:vLLM 官方支援的平台是 Linux(Python 3.11 到 3.14、NVIDIA 顯卡架構 compute capability 7.5 以上,T4 與 RTX 20 系列起算),Windows 不原生支援,官方路徑是 WSL 搭配 Linux 發行版。
vLLM 的效能數字在網路上到處有人引用,但官方給的每組數字都寫明了比較對象。論文口徑是:與當時最先進的系統(FasterTransformer、Orca)在同等延遲下,吞吐 2 到 4 倍。部落格口徑是:比 HF Transformers 最高 24 倍、比 HF TGI 最高 3.5 倍,量測環境是 LLaMA-7B 在 A10G、LLaMA-13B 在 A100。這些都是 2023 年的比較,基準寫得清楚;搬到 2026 年引用時把基準拿掉,數字就失去意義。「浪費低於 4%」也一樣,量測的是分頁之後每個請求最後一個區塊的浪費,不是隨便一套系統的通用值。同一套原則也適用在容量計算:權重體積取自 Hugging Face 檔案清單的實數,KV 每 token 量出自模型設定檔的算術,併發分配則標明假設。
-rocm72 的 wheel 與映像檔,改用 ROCm 10.0 的版本,拉新映像檔比修舊的快。24GB 消費級卡的實際增益沒有官方數字,發布說明的例證只給了 H200,消費卡上 KV 容量多出多少、TPOT 上升多少,要等社群量測。官方支援矩陣目前只列到 Hopper,Blackwell 消費卡(RTX 50 系列)的 FP8 欄位要等矩陣更新才能對上。新預設會不會在下一版再調整也值得盯:照 vLLM 近幾版兩週一發的節奏,v0.35 的升級說明很快就會給答案。
升級時機可以按部署形態分流。全新安裝直接從 0.34.0 起,沒有搬遷成本;已經在跑的服務,先在測試機升一版,看啟動警告與 TPOT 體感再上正式環境;顯卡同時跑桌面的工作站,把 gpu-memory-utilization 留著、給一個明確低於 1.0 的值,反而比無腦跟進新預設穩。
回到部署判斷本身,順序其實很短:刪掉 gpu-memory-utilization,讓引擎暖機後自己量;按顯卡架構選量化(4090 走 FP8 權重、3090 走 4-bit 權重加 FP8 KV cache);用權重實數與每 token KV 公式算出這張卡的人數上限,再依警告的長相修正。順帶一個時間註腳:11 月 4 日 Kimi K3.1 Pro 開放權重時,官方文件要求的 vLLM 版本還只能透過 nightly 安裝(/kimi-k31-pro-open-weights-mxfp4/),v0.34.0 在 11 月 16 日轉正,發布說明卻明言 K3.1 的支援屬鋪路階段、這一版還不能上線服務。最新大型權重對引擎版本的門檻,要逐案對官方文件確認。