TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

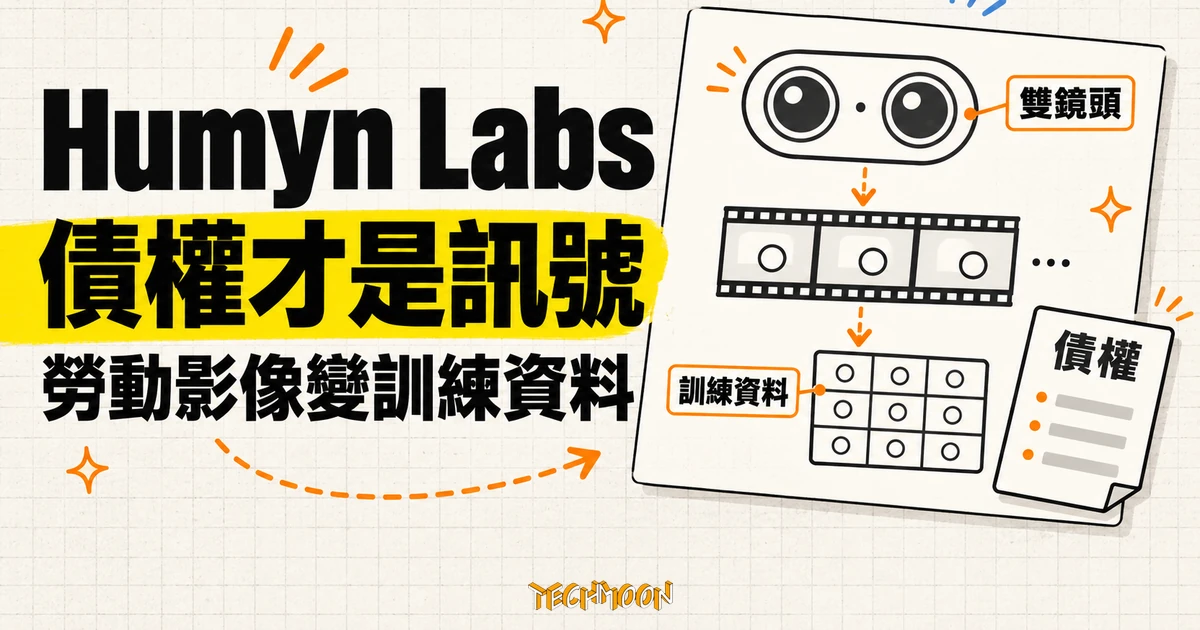
實體 AI 資料新創 Humyn Labs 完成總額 4,700 萬美元 A 輪,其中 2,100 萬美元是創投債權,創辦人解釋債權補的是採集人員週結薪與 AI 實驗室月結貨款之間的現金流缺口。官方宣稱營運六個月年化營收 5,000 萬美元,訪談拆解顯示其中 2,000 萬美元合約還沒簽。
用 AI 摘要這篇文章:
實體 AI 資料新創 Humyn Labs 在 2026 年 11 月 18 日宣布完成 4,700 萬美元 A 輪,同日登上彭博、經濟時報與 SiliconANGLE。這輪融資裡最值得先看的數字是債權那一半:2,600 萬美元股權由 Accel 領投,另外 2,100 萬美元是 Lighthouse Canton 領投、Trifecta Capital 參與的創投債權。一家成立才九個月的新創,為什麼需要把近半資金用借的?共同創辦人 Manish Agarwal 對 TechCrunch 的解釋很直白:採集人員與在地夥伴按日或按週結帳,AI 實驗室客戶卻要 30 到 60 天才付款,債權補的就是這段現金流缺口,而且比再賣股權不稀釋。這句話把這門生意的本質講清楚了:把人類勞動錄影變成可週轉的訓練資料,是勞力密集、先付款後收款的生意,不是純軟體生意。
Humyn Labs 的採集模式,是讓世界各地的工作者戴著自家擷取裝置,在工廠、倉庫、農場與住家裡做原本就在做的工作,錄下第一人稱視角的勞動過程,再交給後端軟體處理、標註,供機器人與實體 AI 模型開發商訓練。TechCrunch 報導指出,公司與在地夥伴合作找採集場域並監督流程,Agarwal 受訪時說,工作者有報酬,但他強調採集現場需要監看與督導,才能得到對的輸入。
這個模式天然吃營運資金。官網 About 頁寫著公司剛創立時,現場採集的原始資料有四成到六成直接棄置不用,所以他們從驗證、處理到標註自建了一整套資料引擎,把人類活動轉成視覺、聽覺、動作與觸覺的訓練訊號。丟掉將近一半的原始素材,等於同一筆收入背後要付出去的採集工時比帳面更多,付款週期錯配也就更明顯。官方公告只說資金要用來擴張巴西、南韓、印度的部署基礎建設、擴大擷取硬體與資料引擎、成長舊金山倫敦首爾團隊;把債權連回現金流缺口的是 Agarwal 的訪談說法,兩個來源剛好互補。
投資人結構也照官方公告為準:股權由 Accel 領投,Prosus Ventures、BeeGlobal、透過 Bajaj Finance 的 Finserv Intelligence、Bajaj Alts AI Opportunities Fund、Dallas Venture Capital、Lighthouse Canton、Jump Trading 參投,外加一位官方只稱「重量級天使」的投資人(Entrackr 與《經濟時報》的報導指名是前 Epic 財務長 Anita Pramoda)。Accel 合夥人 Pratik Agarwal 在公告裡的引述,把押注理由落在團隊與客戶拉力上:他說實體 AI 會是未來十年最重要的技術變革之一,真正的護城河建立在資料與部署這一側。
官方公告開頭寫著「營運六個月,年化營收跨越 5,000 萬美元」。這是公司自己的宣稱,但 TechCrunch 的訪談給出了三個恰好能對上的數字:4 月到 10 月已實現營收 1,000 萬美元、已簽約合約 2,000 萬美元、還沒走完簽約程序的 2,000 萬美元。三段加起來恰好 5,000 萬。
三段的證據地位不一樣。1,000 萬是已入帳的歷史營收;2,000 萬簽約款取決於履約;最後一段連合約都還沒簽。「年化營收」指的是把目前業務量折算成整年的推估值,與已實現營收之間的落差,剛好就是後面兩段。把宣稱還原成這三段,讀者可以自己判斷「六個月做到年化 5,000 萬」的成色,不必照單全收。同樣出自訪談的還有:12 家付費客戶、約九成營收來自美國,客戶涵蓋前沿 AI 實驗室、機器人公司與世界模型開發商,但公司沒有公開任何一家名字。Agarwal 在公告裡則把目標講得更遠:他引用設定的 100 億美元資料基礎設施市場機會,並說要做一家年營收 10 億美元的公司。目標與宣稱都是公司自己的說法,目前沒有外部數字可以核對。Agarwal 另一句受訪說法值得單獨記下:「規模、多樣性與品質都重要,而且要同時成立。」
Humyn Labs 官網首頁對產品本身的交代,比「幫機器人錄人類工作」這句話具體得多。引擎會把每一小時的人類活動拆成 12 類訊號原語:21 點手部關鍵點的逐格追蹤、視角 160 度的第一人稱注視估計、同步立體影像對算出的度量深度圖、物件定位與偵測、在意圖切換處分割的動作分段、reach/grasp/lift/place 這類原子動作標籤、場景幾何、300 Hz 的六軸 IMU 軌跡、帶語意標籤的語音轉錄、逐 token 標記的混合語言(官網示例是印地語與英語交雜的句子)、說話者拓撲與重疊語音的標註、韻律與情感副語言標記。
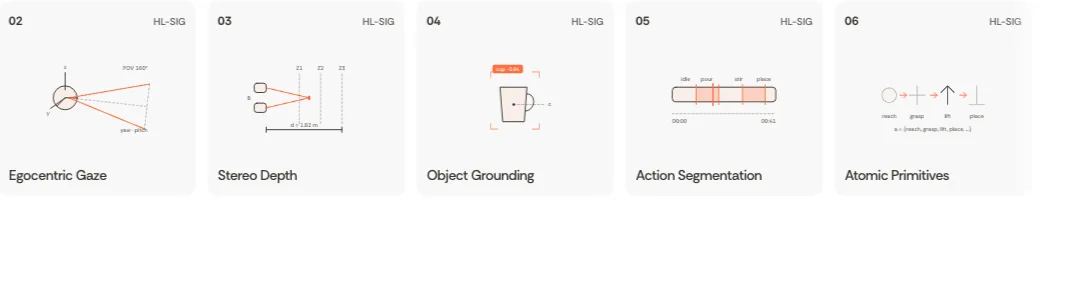
整條管線從驗證、處理、標註到人工覆核都握在自己手裡。進料有四個來源:語音、第一人稱影片、IMU 動作軌跡,以及握力感測(觸覺這一路對應的是握力圖),說明這套裝置記錄的層次已經超過純視覺。輸出格式是 MCAP、RLDS、LeRobot v3 與 ROS Bag,都是機器人訓練生態直接吃的容器;語音這一路另外輸出 WAV、FLAC 與 JSON,連同分離後的人聲音軌一起交貨,方便語音模型直接取用。官網引擎的驗證閘門也具體列了會剔除的素材:光線異常、凍結畫面、遮擋、手部與物件互動異常的片段,另有隱私隔離與 IMU 活體檢查。
TechCrunch 對硬體的描述是「雙鏡頭裝置」,官網規格對應的是 Stereo Depth 這一項:從同步的立體影像對產生度量深度圖。兩個說法指向同一件事:單鏡頭平面影片少了空間深度,立體影像對補上雙眼視差,手與物件接觸時的相對位置才量得出來。對機器人開發商來說,這正是從「看得懂影片」到「學得到動作」的差別,也是 NVIDIA GR00T 2 這類從人類影片學任務的模型真正需要的輸入形態。
融資公告裡有一段常在數字後面隱沒的論述:實體 AI 的瓶頸已經越過模型本身,落在「部署就緒」這一關:一隻在展示影片裡表現正常的機器人,能不能在真實場址、整個班次的變動條件下做同樣的工作。公告寫得直接:這件事模型從網路上學不到,只能向真正做這份工作的人學。
公司把自己拆成三塊對應這個論點:資料引擎把真實工作轉成帶履歷驗證的訓練集;擷取硬體按各實驗室需求打造;部署就緒這一塊則與模型實驗室和場址營運方合作,把機器人放進同一批環境,用人類做事的方式當量尺量每次部署,再把差距回饋給下一版模型。Gupta 的引述把這個循環講得露骨:把模型實驗室與場址營運方帶到同一個現場,讓每次部署都教會下一版模型,世界的工廠、農場與倉庫就成了訓練集。這套說法與機器人業界近期的真機評測趨勢同一個方向:驗收正在從展示影片移向真實場景,而 Humyn Labs 想賣的就是那把量尺背後的資料。
採集網路的地理分布是官方公告與官網一致的數字:20 多個國家,分布在拉丁美洲、東亞、南亞與東南亞,官網頁首另標了 36 種語言。Agarwal 在訪談中點名巴西、印度、南韓是目前的三大樞紐。官方部落格自己的文章標題把動機講得露骨:〈為什麼在西方資料上訓練的機器人會在非西方的家庭與工廠失靈〉。換句話說,環境光線、建築格局、工具樣式與工作習慣的分布差異,就是這家公司賣的東西之一。
創辦人背景也解釋了九個月鋪 20 國的速度。官方 About 頁列出兩位創辦人:Agarwal 曾任 Nazara Technologies 執行長,把這家遊戲公司帶到印度首場遊戲業 IPO,高峰估值超過 10 億美元;Gupta 曾在 AB InBev 負責中亞與南亞業務,規模做到 1.5 億美元以上。TechCrunch 報導,兩人 2026 年 2 月創立 Humyn Labs,先前還共同創辦 Kratos Studios(現名 KGeN),那個平台在新興市場經營貢獻者網路,正是 Humyn Labs 進入家庭採集的通路。公司總部設在班加羅爾,另設美國子公司。官網頁腳的標語寫著「Humyn,為機器而研究人類」,把公司名稱的由來與定位一句話講完。
公司還自稱經營一套獨立評測系列 BRIDGE,官方公告寫的版圖涵蓋語音、視覺與觸覺,官網目前實際發布的是語音版 ASR 2.0。以官網公開內容來看,測的是 20 多個語音模型在真實雙人重疊對話上的表現,指標除了常見的 WER、CER,還有語意相似度、混合語言 F1 等六項。評測語料刻意收錄重疊語音與跨語言混合,正是生產環境裡最容易壞掉的模式;官網另強調從說話者招募到評測管線的每個決策都公開,讓結果可重製、可稽核,也比較難靠針對性調校衝高分數。評測能不能保持獨立、會不會變成自家業務的宣傳品,值得觀察。
這輪融資沒有揭露估值,也沒有公布任何客戶名字,年化營收的三段組成裡還有一段 2,000 萬美元沒簽約。另外有兩個數字對不起來:官網 About 頁寫「25 人,橫跨研究、資料科學、基礎設施、語音與視覺工程、專案管理與現場作業」,TechCrunch 訪談卻引 Agarwal 說全職員工 51 人、多數在班加羅爾。兩個口徑可能一個是特定職能清單、一個是全公司總數,但在官方頁面與訪談並存的情況下,員工規模其實還無法確認。
隱私是更近的壓力。TechCrunch 同篇報導指出,在住家裡錄影的做法已經引發隱私與同意權的疑慮,印度近月也冒出 Human Archive、BuildAI 等同路線公司。Humyn Labs 官網的處理管線裡有隱私隔離等閘門,Agarwal 說他們記錄的是工作者本來就在做的日常工作與家務,不另外安排橋段,但公司沒有公開足夠的文件讓外部驗證同意權怎麼取得、畫面裡入鏡的第三方怎麼處理。
競爭則留在賽道層。Mecka AI、XDOF、MicroAGI 都在做機器人真實世界資料;TechCrunch 也觀察到,印度近幾個月已經成為實體 AI 訓練資料採集的集散地,當地新創靠龐大勞動力把「錄人做事」做成產業。需求側同樣熱,大型機器人新創持續吸金,這條賽道半年內會不會走向價格戰、新興市場採集網路會不會互相搶人,公告裡沒有答案。
對追蹤機器人產業的讀者,這輪融資給了一個比 4,700 萬美元更有用的檢查點:實體 AI 的瓶頸正在從模型移向部署,而部署就緒需要的那種資料,目前只能向真實世界裡的勞動者買。買的方式是現金流錯配的訂製生意,所以債權會是這類公司資本結構裡的常客,Accel 願意在 A 輪就接受這個結構,也等於接受這門生意需要營運資金支撐。接下來值得追蹤的是:12 家客戶會不會有任何一家具名、年化營收裡那 2,000 萬未簽約的成色、南韓樞紐的擴張進度,以及 BRIDGE 評測會不會端出可外部檢驗的結果。官方公告把成長重心放在舊金山、倫敦、首爾三地團隊,也等於把下一階段的賽局放在離客戶更近的地方。這些問題沒有一個能在融資新聞稿裡找到答案,都要等下一季的實際訊號。