TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

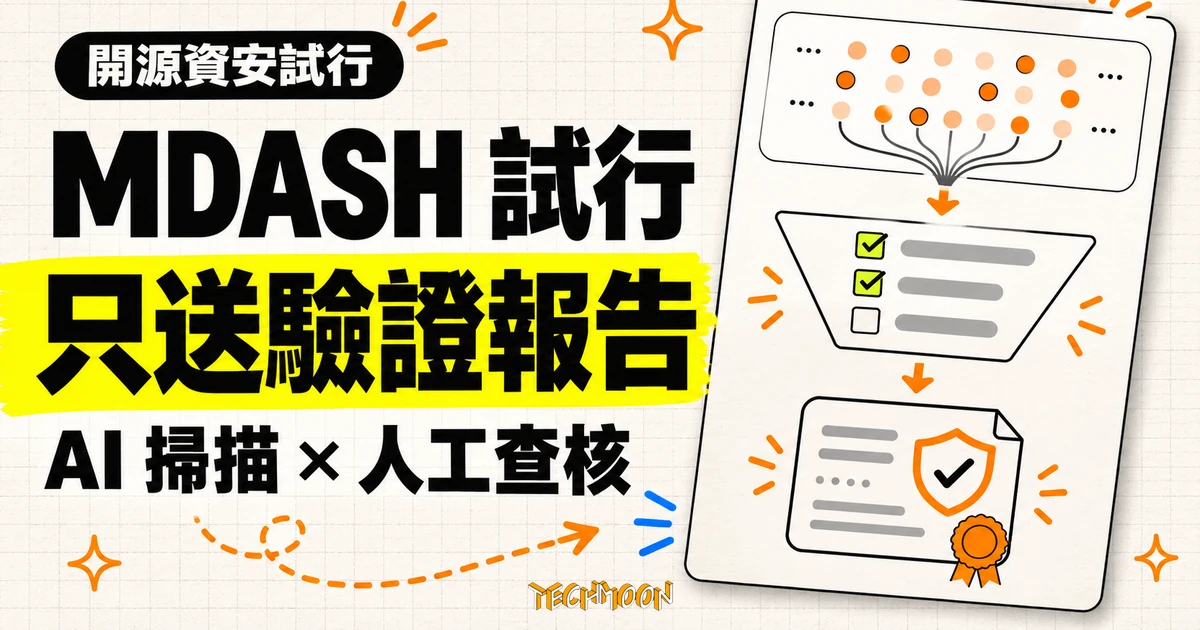
GitHub 與 Microsoft 在 11 月 17 日公開 Codename MDASH 開源試行結果:AI 掃描標記 9,791 筆可能問題,經 GitHub Security Lab 的 AI 篩選與微軟 FORGE Lab 七位研究人員逐項人工查核後,只向六個同意參與的專案送出 99 份私下報告。截至 11 月 15 日維護者已修復 55 項、14 項隨版本發布,本文依官方公告釐清各數字代表的階段與不能推論的結論。
用 AI 摘要這篇文章:
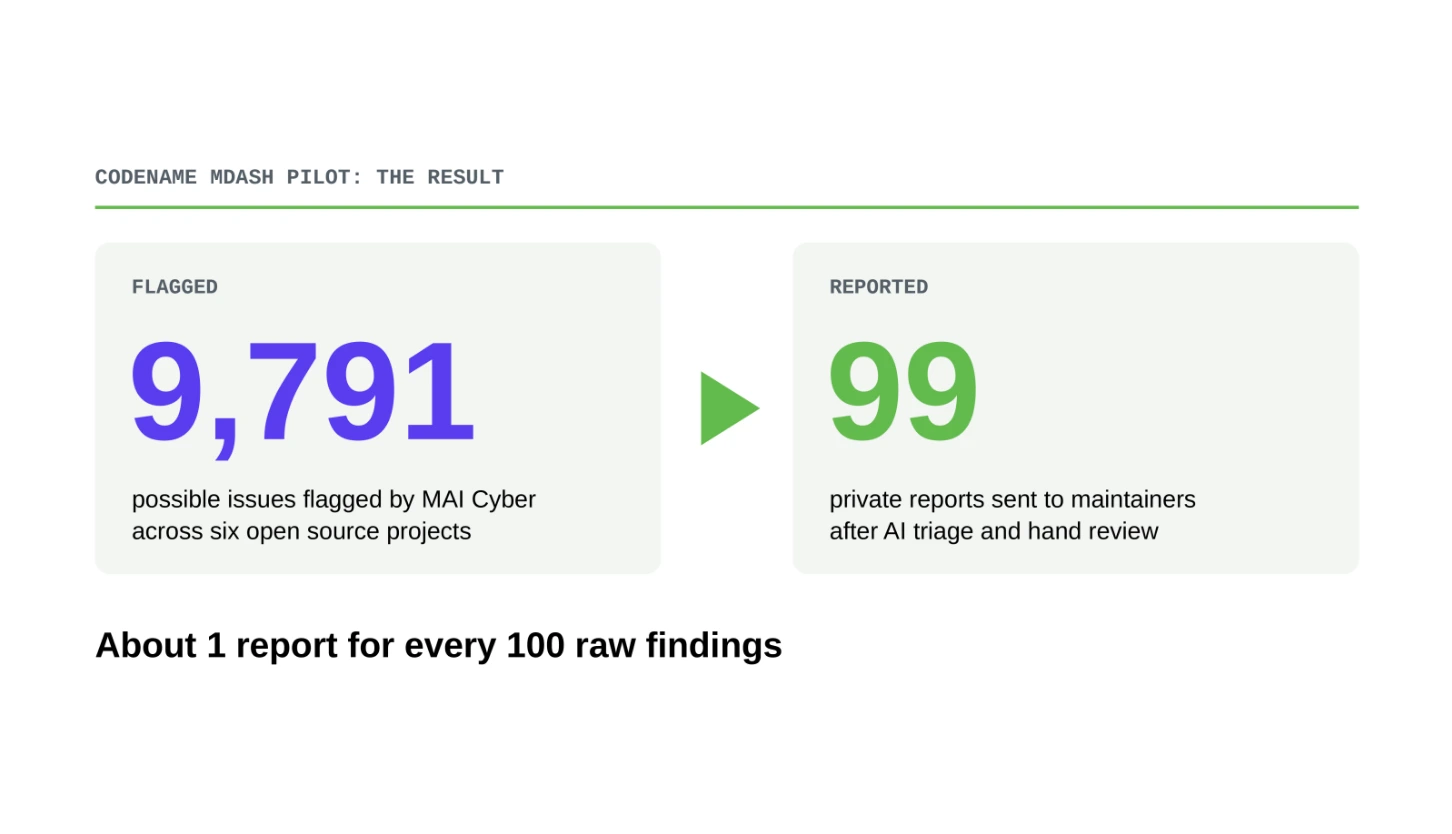
GitHub 與 Microsoft 在 11 月 17 日於官方部落格公開了代號 MDASH 的開源資安試行結果:用 Microsoft 的多模型代理掃描系統檢查六個開源專案,官方結果資訊圖表記錄的原始發現共 9,791 筆,最後真正送進維護者收件匣的是 99 份私下報告。截至 11 月 15 日,這六個專案的維護者已修復其中 55 項,14 項修補已經跟著正式版本發布。
這串數字最容易讀錯的地方,是把 9,791 到 99 之間的落差直接當成模型的誤報。實際流程是三道收縮疊在一起:AI 篩選代理先去重、檢查有效性並聚焦高影響問題,七位 Microsoft FORGE Lab 研究人員再逐項人工查核,確認過的才透過 GitHub 私下漏洞回報機制送出。這次試行值得記住的變化在分工:查核成本被留在掃描方這一端,維護者拿到手的每份報告都附了重現概念與修補建議,而不是一整批等別人證明的猜測清單。
試行的背景是個已經存在的麻煩:AI 讓找潛在漏洞變得又快又便宜,修復仍然吃人力,而這些工作落在經常沒有全職人力配置的開源維護者身上。官方文章引了 Log4j 維護者 Christian Grobmeier 的話:「用 AI 防禦開源軟體,必須強過用 AI 攻擊開源軟體。」重複回報、根本不是漏洞的回報,每天都在進維護者的收件匣,MDASH 試行就是在這個前提下設計的。
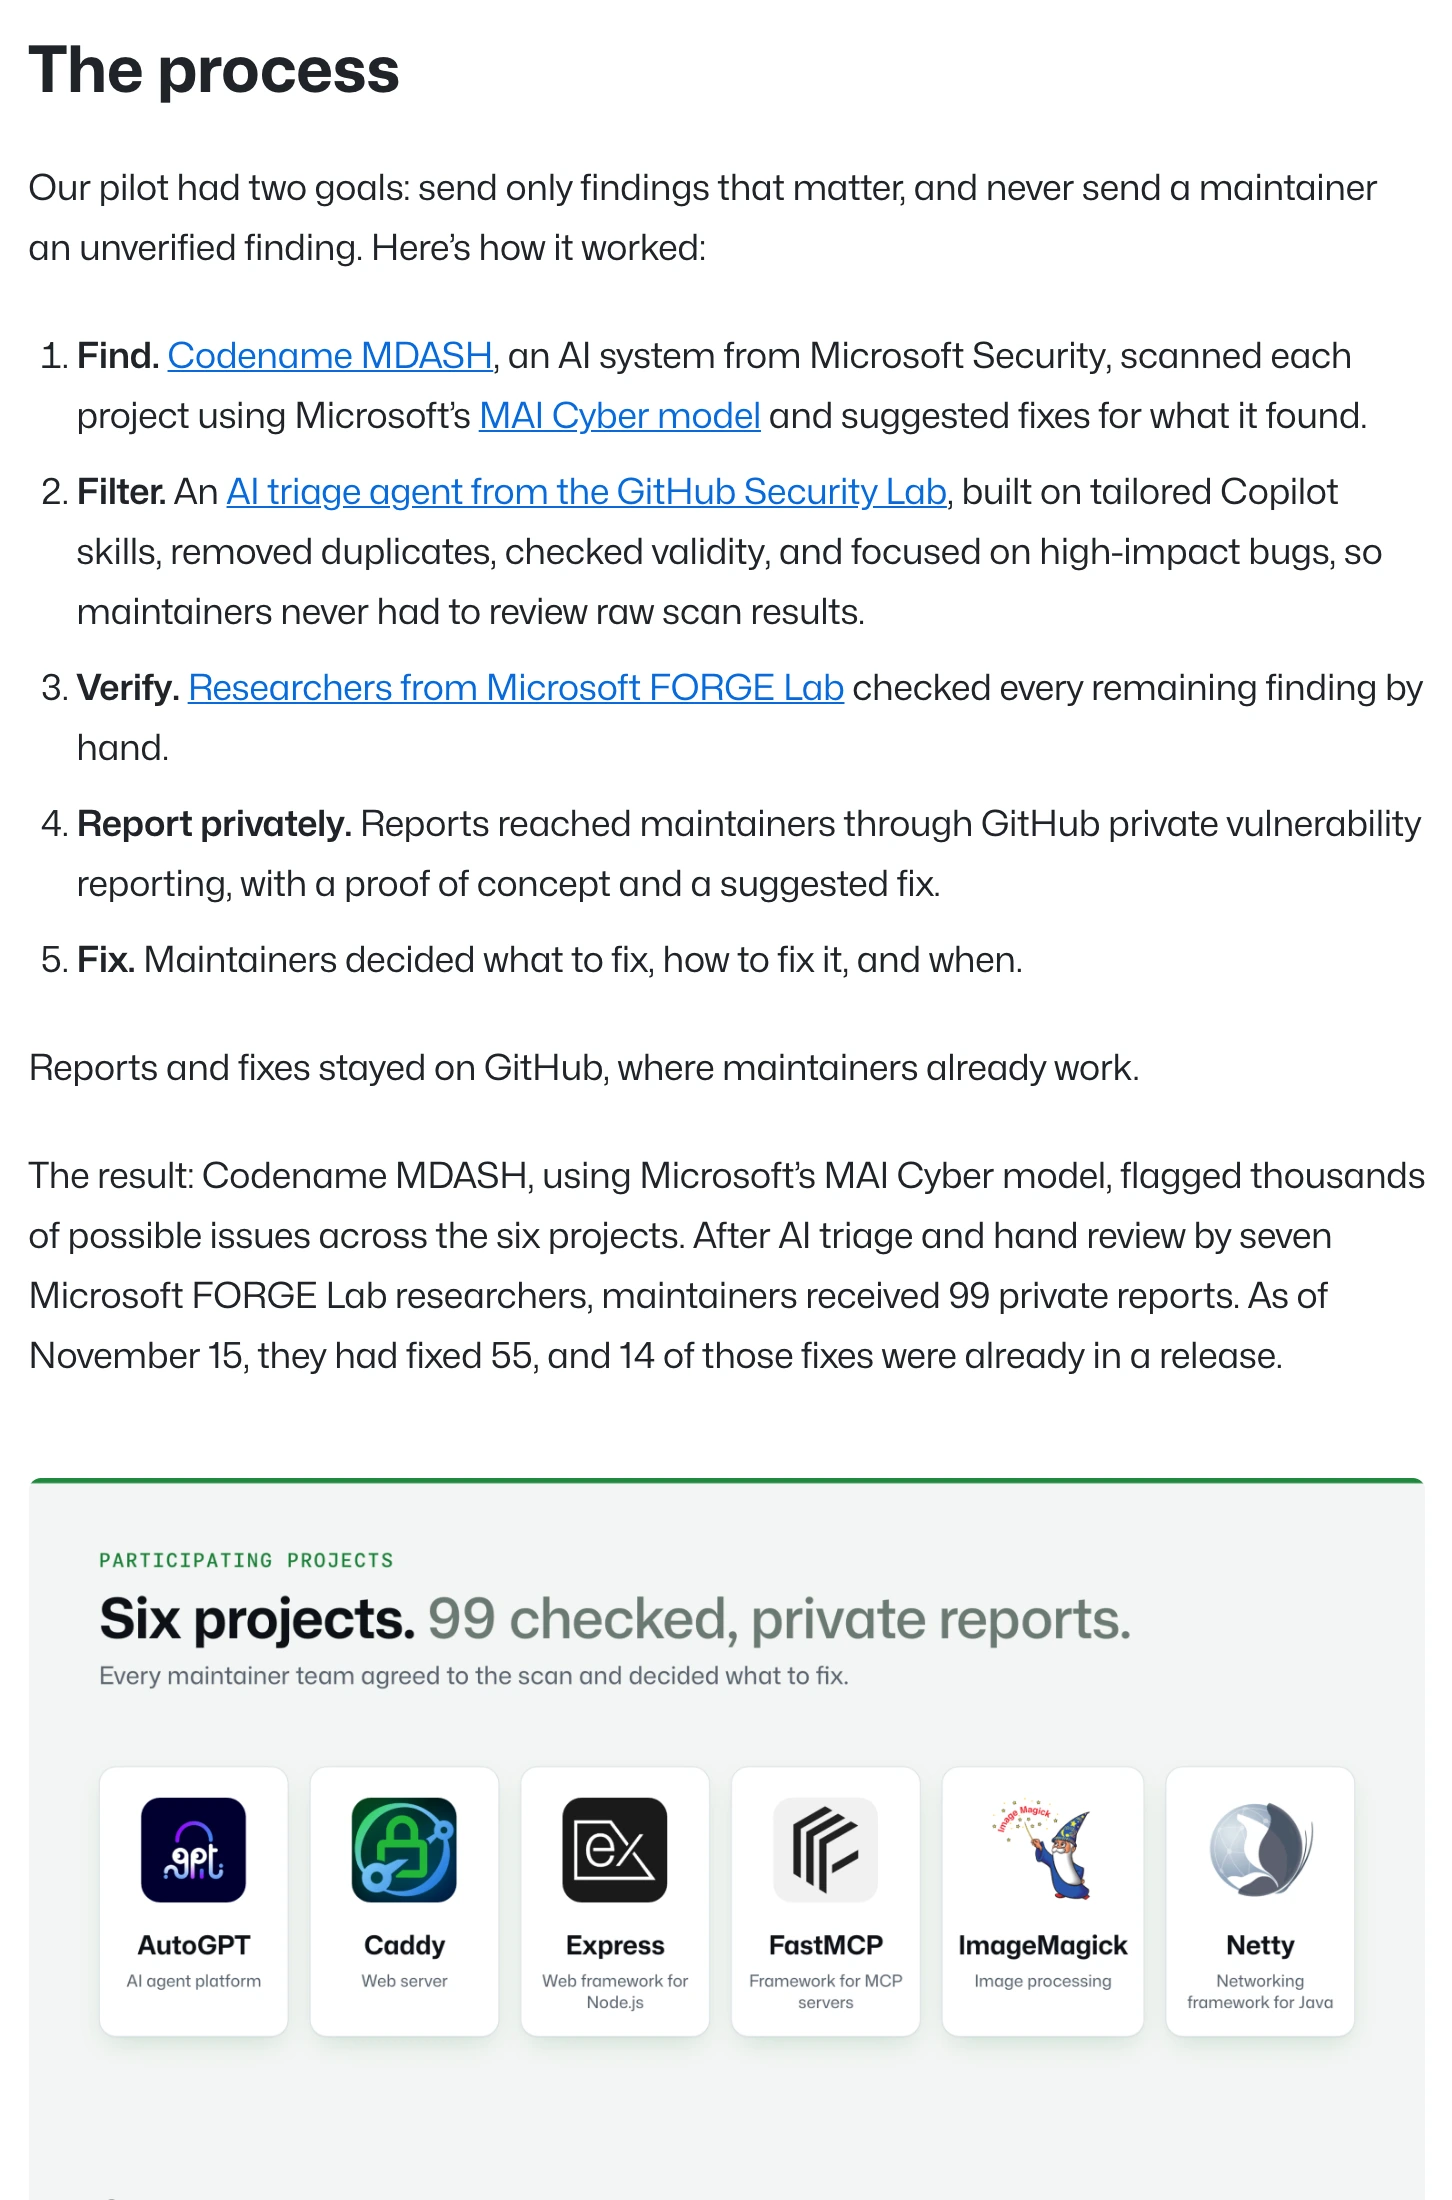
參與的六個專案全部事先同意被掃描:AI 代理平台 AutoGPT、網頁伺服器 Caddy、Node.js 網頁框架 Express、MCP 伺服器框架 FastMCP、影像處理工具 ImageMagick,以及 Java 網路框架 Netty。這份名單本身也說明了試行的性質:它把範圍定在六個有合作基礎的專案上,累積的是早期經驗,還談不上對整個開源生態的普查。
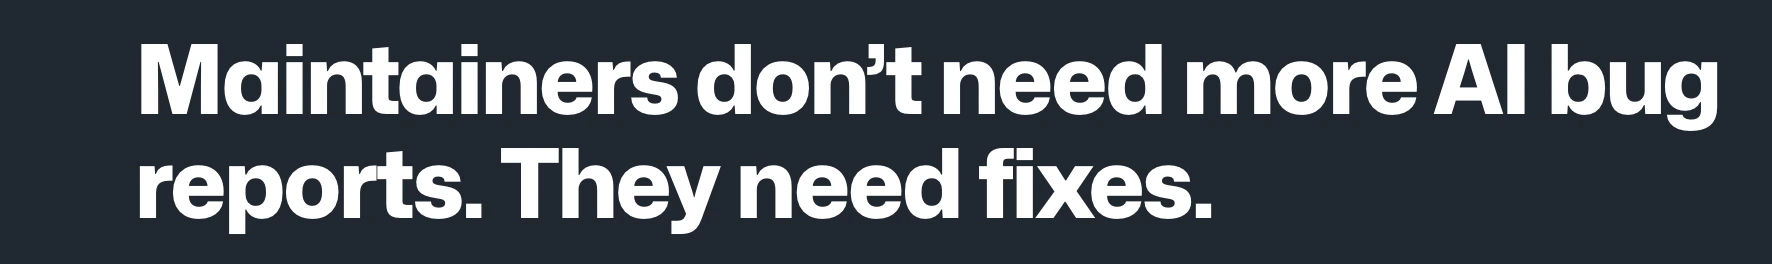
官方文章把這套流程拆成五個動作:找問題、篩選、查核、私下送達、修復。每個動作由不同的人負責,這正是 99 這個數字的來源。
找問題的是 MDASH。這裡要先劃清一個容易混淆的名字:MDASH 是 Microsoft Security 的多模型代理掃描系統(agentic scanning harness),負責驅動整套掃描與建議流程,它本身並不是一個聊天模型。實際找問題、提出修補建議的模型是 Microsoft 的 MAI Cyber。掃描的產出也包含建議修補,從源頭就對準「維護者接下來要動手改什麼」。
接著是篩選。GitHub Security Lab 用客製 Copilot skills 打造了一個 AI 篩選代理,把重複項移除、檢查每項發現的有效性,並聚焦影響較大的問題,讓後段的人員不必從原始清單逐條看起。這一步的效果官方說得很白:維護者永遠不必審原始掃描結果。
再來是查核。Microsoft FORGE Lab 的研究人員對留下的每一項發現人工複核,這一步沒有交給模型。查核不是再看一次模型的結論像不像真的,而是把發現放回專案的脈絡判斷:問題是否真的成立、是否為已知問題、提出的修改會不會破壞原本的設計。通過查核的發現,才透過 GitHub 私下漏洞回報(private vulnerability reporting)送達維護者,每份報告附上重現概念與建議修補。私下送達的意義在時間差:維護者可以在問題公開之前安排測試與修正,尚未修補的使用者不會先拿到可利用的攻擊資訊。
最後一步的主導權在維護者手上:修哪些、怎麼修、什麼時候發布,全由專案自己決定。官方對建議修補的定位也寫得很保守,它是審查的起點,有的維護者照單採用,有的在上面再改。整份報告與後續修復都留在 GitHub 上進行,維護者不必為了處理這批結果切換到別的平台。
模型版本還有一層要分開看。Microsoft 在文章發布同一天另行宣布了 MAI Cyber 2,官方特別交代此次試行跑在較早的 MAI Cyber 模型上。把這次累積的 99 份報告與 55 項修復直接算到新模型頭上,是解讀這則新聞首先要避開的坑。依 Microsoft 模型頁的說法,MAI Cyber 2 Flash 專為安全工作打造,驗證過的防禦方可以透過 MDASH 取得,也就是說模型與掃描系統會繼續搭著走,但新模型的實際成效要等下一次公開資料。
修復與發布是兩個階段,混在一起讀會高興得太早。官方採用的統計截止日是 11 月 15 日,文章在 11 月 17 日發布,所以這組數字是兩天前的快照,讀的時候要把時間差記在心上。55 項是維護者已完成修復的數目;14 項是已經包含在正式發布版本裡的修補。剩下的差距就是版本週期:修補合進程式庫之後,還要排測試、打包、發布,下游的套件管理工具才拿得到。
對使用這六個套件的團隊,這個差距很實際。修補沒進正式版本之前,部署工具裝不到它,資安公告讀完也不等於防護到位。這也提醒一個常見的彙報陷阱:把「有人在處理」回報成「正式環境已修好」,兩者之間隔著測試、版本安排與部署三段工作。實際的行動入口是追蹤各專案的資安公告與版本發布紀錄,確認自己用的版本落在哪個範圍,再安排更新與驗證,並留下哪些服務已換上修補版本的紀錄。
官方分享了幾個專案的處理經驗,每個數字都值得連時間軸一起看。
Caddy 的維護者在一週內修完了收到的全部 22 份報告;整個試行的首波修復,也在初始掃描後約一週就發布。Caddy 維護者的說法是,MDASH 找出了專案裡未知、冷門的安全漏洞,報告精簡,還補上了先前一些沒被注意到的報告缺口。
ImageMagick 由兩人團隊維護,同樣收到 22 份報告。其中一份報告的摘要指出精確的程式行,讓維護者 15 分鐘就推完修補;他們自己補充,平常一份安全公告平均要花 30 分鐘到 1 小時才能讀懂、理解並完成修復。兩人照顧的專案收到 22 份已查核報告還能照節奏消化,靠的是報告直接把問題定位到行,省掉重新理解問題的時間。
AutoGPT 的例子顯示建議修補的另一種用法:維護者收到報告時,專案剛上線的新檢查正好壞掉,報告在三天後送達,直接指向出問題的那一行。他們以建議修補為底再往前修,一天內寫完,不到一週就上了線。Express 維護者的評語則聚焦在訊號與噪音:「對於切開漏洞回報的噪音非常有用」。FastMCP 維護者說,這次掃描對專案安全提供的觀察,超過過去任何 AI 掃描器給過的。Netty 維護者的總結更直接:瓶頸已經從找出漏洞移到修復,而修復取決於維護者。
把四個案例並在一起看,共同點很清楚:報告把問題定位到具體的程式行,維護者省下的是重新讀碼與重現問題的時間。至於修補本身的判斷,各專案走各自的速度,官方也沒有把任何一個案例包裝成平均值的承諾。
這些都是單一專案的經驗,官方也只把它們當早期經驗來講,沒有承諾其他專案能得到相同節奏。六個專案的規模、風險與測試方式各不相同,把「22 份一週修完」外推成常態,就讀得太滿了。
誤報率算不出來。9,791 到 99 之間疊了去重、有效性查核與重要性篩選三種收縮,官方沒有公布逐項分類結果,也沒有給每筆原始發現的判定與排除原因。任何把未送出的項目一律算成誤報、再換算出百分比的推論,都是在沒有資料的地方編數字。官方圖表只給了一個保守的比率描述:約每 100 筆原始發現,對應 1 份送出的報告。
它也不證明 AI 已能自動修復漏洞。這次流程是 AI 找、研究人員查、維護者修,官方自己寫得明白,這套品質仰賴七位研究人員每個專案約兩天的人工投入,而且這種投入還不能規模化。建議修補確實縮短了維護者重新理解問題的時間,但審查、測試與正式發布的工作都還在原地,缺任何一段,修補都到不了使用者手上。
樣本代表性同樣要保留。六個專案都是 GitHub Secure Open Source Fund 的校友,有既有的合作管道,也事先同意被掃描。這與對陌生專案大量寄送自動掃描結果的情境完全不同,後者正是官方文章開頭點名的問題:維護者每天還在收低品質報告,重複的、根本不是漏洞的都有。MDASH 試行是在回答「報告送達前,掃描方該先做完哪些事」。
官方自己還列了開源生態目前補不上的缺口:修補要走私下漏洞回報,維護者需要能在私有 fork 上跑 CI/CD 測試來驗證修補;要拉近防禦方與攻擊方的距離,維護者還需要能拿來驗證攻擊概念的安全模型,在修補前後各確認一次。這些基礎設施到位之前,試行裡的分工方式就是目前最完整的版本。
官方按三種身分給了現行動作。
維護者可以為專案開啟私下漏洞回報,讓研究人員能把安全問題私下送到你手上,問題內容在修補前也不會變成公開 issue;GitHub 也提供 gh-secure 指令,官方說法是約兩分鐘就能把核心安全功能開起來。使用開源套件的團隊,可以開啟 Dependabot alerts,在依賴的套件有安全更新時收到通知;通知只是線索,收到之後仍要自己核對受影響範圍、測試再部署。已採用 GitHub code security 的儲存庫,還能搭配 agentic autofix 讓 Copilot 協助處理警報,這與先前介紹過的 Copilot 安全外掛屬於同一條線,都是把安全工作搬進維護者原本就在用的介面。
如果你是用 AI 對開源專案做資安掃描的人,官方文章給的標準值得抄下來:送出前,對照專案已知問題、威脅模型與安全政策逐項查核;報告走私下管道;附上修補建議,並讓維護者決定處理節奏。同樣把查核做在放行前面的思路,也出現在 AI 技能安裝前先讀安全掃描報告的做法裡。用模型掃完直接寄整包清單,等於把你該做的查核工作,轉嫁給原本就在免費幫全世界修程式的人。
接下來值得回來看幾個點。GitHub 說要把這次經驗帶進私下漏洞回報與 security advisories,降低低品質報告對維護者的負擔;Secure Open Source Fund 的每個校友專案都將獲得送出前已查核的 AI 安全掃描與 GitHub Copilot Max;Microsoft 端的 MAI Cyber 2 已開始透過 MDASH 對驗證過的防禦方供應,成效要看後續公開資料。
背景規模可以幫助判斷這條線的續航力:Secure Open Source Fund 至今涵蓋 216 個專案,每個專案透過 GitHub Sponsors 獲得一萬美元,超過 300 位維護者在其支持下修復了 4,000 多個漏洞,對應軟體的每月下載量超過 200 億次。MDASH 試行是這套機制長出來的具體成果,11 月 25 日前後回來對照各專案的資安公告與發布版本,就能驗證 55 與 14 這兩個數字往哪個方向走。