TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

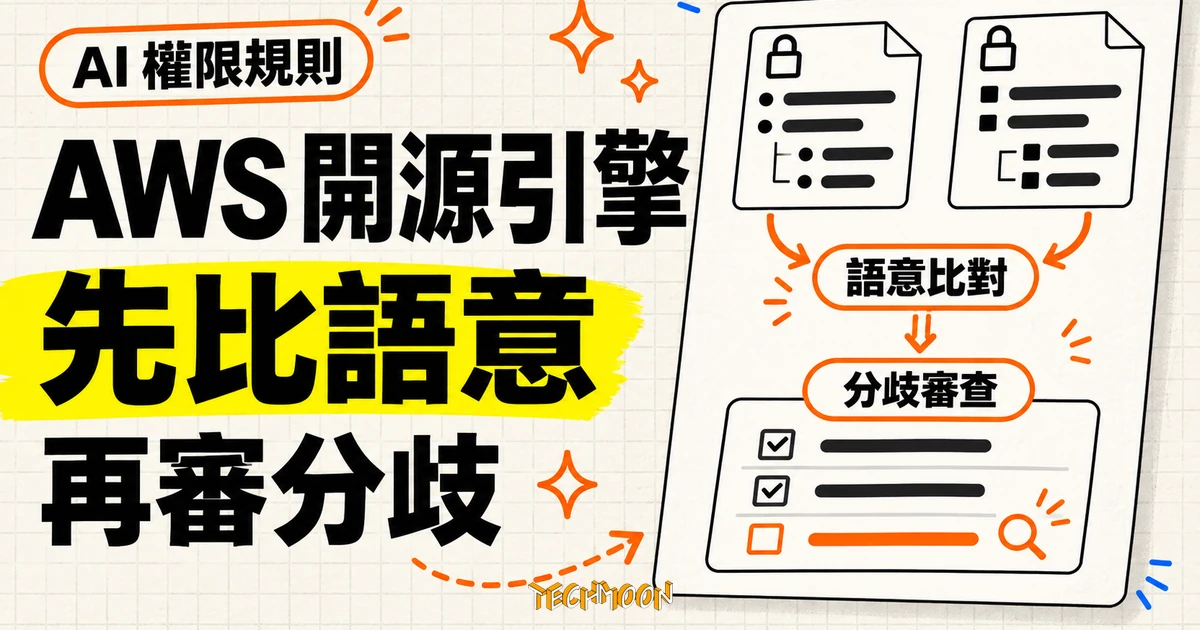
AWS AI Labs 與 Automated Reasoning Group 兩位科學家 11 月 11 日發表以反統一為核心的語意差異比對方法,搭配 Apache-2.0 開源引擎 semi-persistent,把 AI 生成的多份權限規則收斂成少數真正改變行為的分歧點。本文對照官方文章與 GitHub 儲存庫,拆解文字 diff 與語意 diff 的差別、兩個被揪出的政策 bug,以及吃編碼不吃原生政策檔等適用邊界。
用 AI 摘要這篇文章:
AWS 的兩位研究科學家在 11 月 11 日於官方機器學習部落格發表一篇技術文章,把「審查 AI 生成的權限規則」這件令安全團隊頭痛的工作,從逐行比對文字換成比對規則的意思。文章標題是 Semantic diffing of formal policies with anti-unification,作者是 AWS AI Labs 的應用科學家 Ferhat Erata 與 Automated Reasoning Group 的主任應用科學家 Rémi Delmas,搭配的開源引擎叫 semi-persistent。官方給出的對照案例很有說服力:同一份需求、兩份形式化編碼共 28 行,傳統文字 diff 標記了其中 18 行;換成語意差異比對後,只剩 2 個真正改變行為的分歧,而且這 2 個都是官方認定的真 bug。這也是繼 AWS Web Answer 之後,AWS 再次把代理基礎設施的信任問題交給可驗證的機制處理。已經讓 AI 代寫權限政策、或正在評估導入的團隊,是這篇文章直接的受影響者。
看程式碼改版,你會從 diff 開始,沒有人逐行肉眼比對兩份 3 千行的檔案。這是官方文章的起點類比,而權限政策比程式碼更難比:文字 diff 常常標出一些不影響語意的表面差異。把兩個必要條件調換順序、把等號左右兩邊交換、換一個同義的判斷式,整份檔案看起來就面目全非;真正危險的改動,例如把「而且」換成「或者」,反而淹沒在這些雜訊裡。
這個問題在自動形式化(autoformalization)的流程裡被放大。讓大型語言模型把自然語言需求翻成 SMT-LIB、Cedar、Dogwood 或 OpenShell 沙盒政策這類形式語言,同一份需求跑兩次模型,很可能得到兩份不同的形式化結果,而且沒有標準答案可以對照。這正是 AI 代理生態正在逼近的場景:從 AWS 開源的 Claude Code 遠端代理範例到各種沙盒化執行環境,代理拿到什麼權限、能碰哪些資源,最終都要落到一份可以審查的政策檔。官方的設計立場值得先記住:語言模型只負責產生候選,完全參與不了差異的計算。差異運算交給一個以明確宣告規則運行的引擎,這條界線是整個方法可以走進審查流程的前提。換掉模型、提示詞或抽樣溫度可以生成更多候選,互相比對之後,穩定的部分先不看,會變動的部分優先審。
引擎的核心技術是反統一(anti-unification),白話說就是替兩份規則找出最具體的共同樣板。演算法源自 Plotkin 在 1970 年的經典論文,這裡跑在等價圖(e-graph)上:這種資料結構把一個項目與所有已知等於它的形式存在一起,由 egg 論文(POPL 2021)在編譯器最佳化領域推廣,POPL 2023 的 babble 專案也曾用它做抽象學習。共同的結構顯示一次,分歧落在名為 Variants 的節點裡,兩種版本並排供人檢視。如果最後什麼分歧都不剩,兩份政策在宣告的等價律之下就是等價的。
等價律要由團隊自己宣告,這是方法的成本,也是它的誠實之處。把 And 宣告成結合、交換且冪等(:assoc-comm-idem),再給一個中性元素(:identity),調換、重新分組、重複的條件就自動算同一件事;缺少的條件會對到中性元素,整串 And 不會因此對不起來。其他任何等價關係都要寫成明確的改寫規則(rewrite)跑到飽和。文章給了一個小例子:一份規則寫 external(dst),另一份寫成「非 internal(dst)」,兩者表達同一個領域事實,但引擎無法從語法推出來;補上一條改寫規則再比一次,差異分數 :cr 從 0.5 掉到 0.1429,只剩「加密」對「被稽核」這一個真正的分歧。
:cr 是壓縮率的量測,公式為 (s – a) / b,0 分代表在宣告的等價律下完全一致,1 是完全沒有共享結構時的參考值。官方特別提醒這不是上界,某些情況會超過 1。另一個欄位 :completion 會標示 exact 或 budget,前者代表搜尋空間已窮盡,後者代表 anytime 搜尋在預算內收工。還有一句話審查者必須記得:如果等價規則或搜尋不完整,留下來的分歧可能只是引擎還沒找到那條等價關係,不能一概當成漏洞。比對品質,最終取決於團隊提供的規則夠不夠充分。
官方的主要案例是一條跨區複製需求:來源桶需開啟版本控制、目的桶必須在許可區域內;物件標記為機密時,目的與來源帳號必須相同,而且要啟用客戶管理金鑰的伺服器端加密;不超過門檻的物件直接複製,超過門檻要走分段複製。兩份獨立產生的編碼有五處文字差異:三處是表面的(條件順序調換、等號參數交換、許可區域被明確展開成兩個具體區域),兩處是實質的(機密條件的 And 變成 Or,大小判斷的「以下」變成「嚴格小於」)。文字 diff 把 28 行裡的 18 行標成已變更,完全無法告訴你五個差異裡哪兩個才要命。
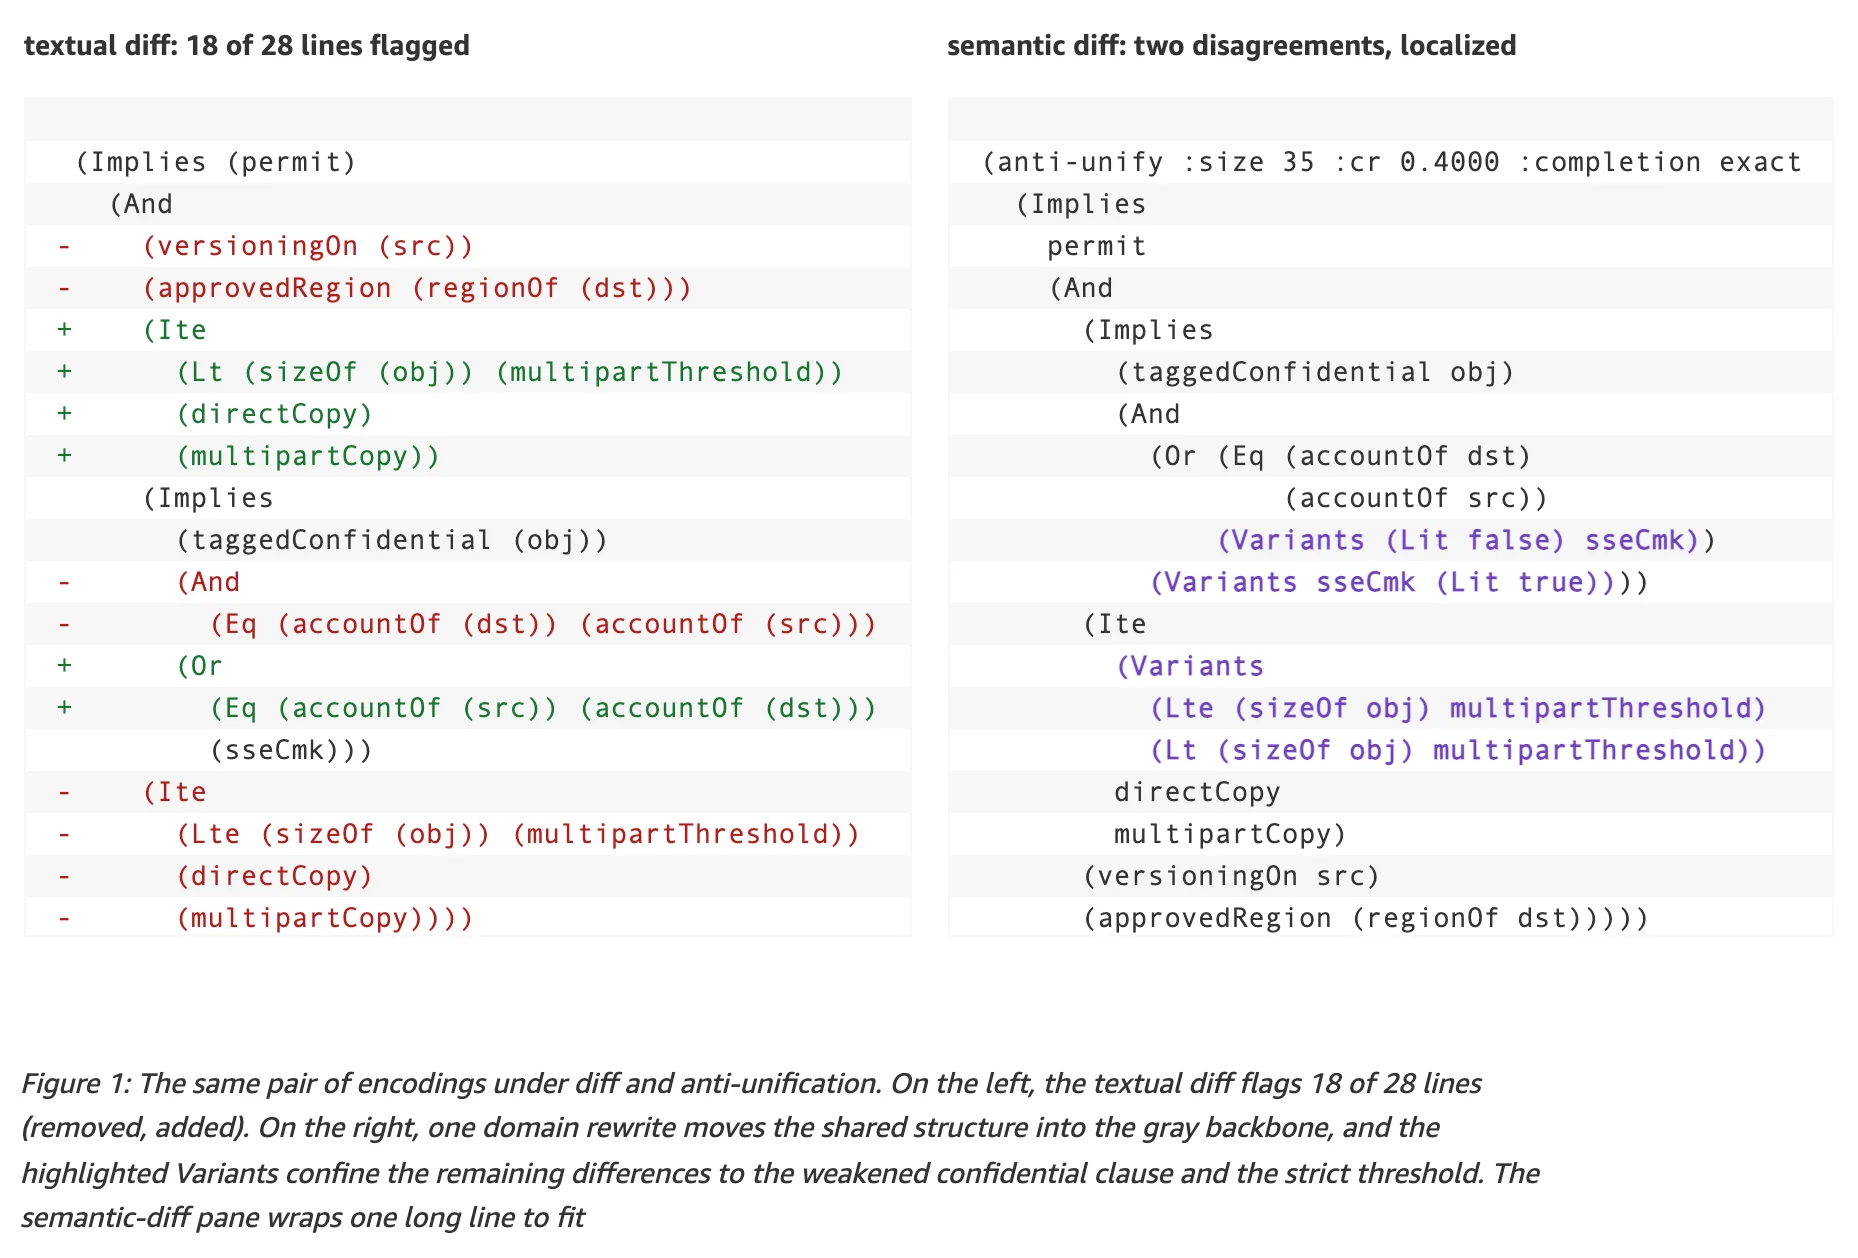
語意 diff 的處理過程分成兩步。結合律、交換律與冪等的宣告吸收了順序差異,等號的交換性吸收了參數對調;接著補一條領域改寫規則,把「許可區域」定義成那兩個具體區域的聯集,區域差異就收進共同骨架,:cr 從 0.5862 降到 0.4000,剩下的剛好是兩個真 bug。
機密條件那個 bug 的後果很具體:「同帳號而且加密」弱化成「同帳號或加密」之後,等於接受單靠加密就能過關,跨帳號複製機密物件因此被放行。大小判斷那個 bug 則卡在邊界:一份編碼用「以下」、一份用「嚴格小於」,剛好等於門檻大小的物件,在兩份編碼下會走不同的複製路徑。官方同場加映的效能宣稱也一併照實轉述:同一支範例程式在 Apple M3 Pro 筆電上暖跑約 50 到 60 毫秒完成,量測方式是 Rust 1.97.1 的 release build,用 shell 的 time 指令跑五次暖跑,另外 anytime 搜尋跑滿 3 千次模擬能得到與精確求解器相同的結果。這些數字是作者自測,本文沒有獨立複驗。
單次比對只是起點。官方建議的管線是:生成 N 份候選形式化,全部載入同一個共享等價圖,在領域規則下跑到飽和,用兩兩等價檢查做聚類,只對各聚類的代表做反統一,再按分歧在共同骨架裡的位置把重複出現的 Variants 分組。最後一步是把每個審查項路由到最便宜的可用檢查:結構描述驗證、事件重播、例題輸入輸出,或者人工審查。
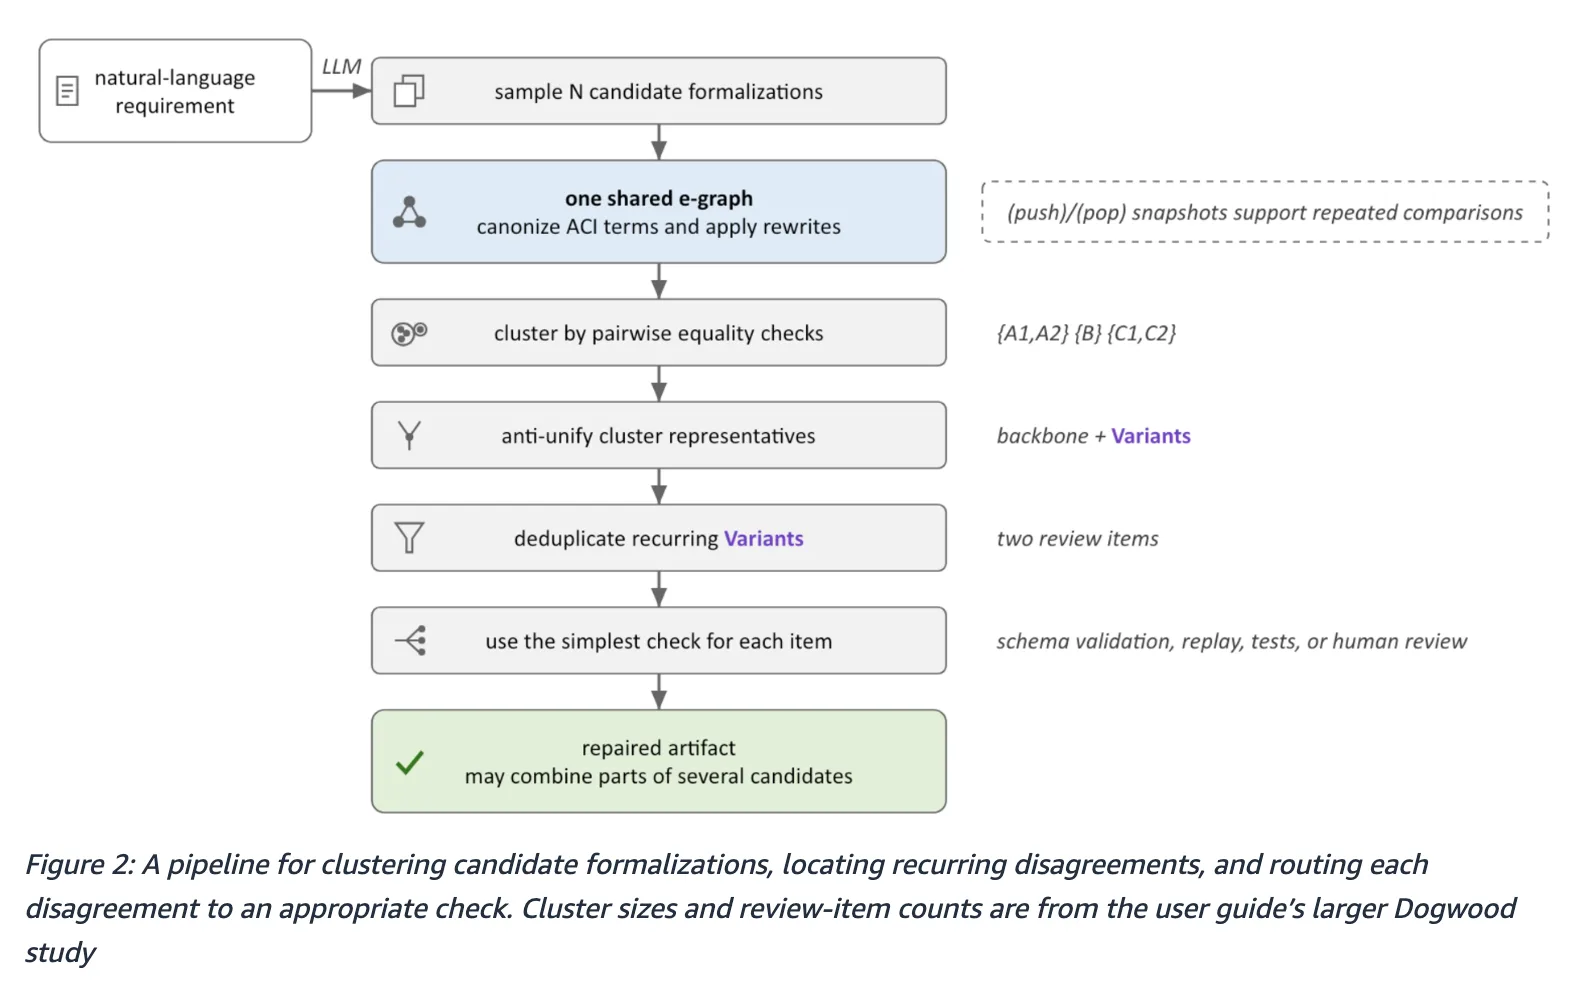
Dogwood 的例子把這套路由演得很好。需求是「代理可以 POST 到 /deploy,但前提是過去 15 分鐘內有一次回傳 200 的健康檢查」。候選 A 用對了兩個請求守門條件,卻從「請求事件」讀狀態碼,而那種事件根本沒有這個欄位,結構描述驗證直接拒絕,不用人看;候選 B 用對了事件種類,卻把 /deploy 路徑守門整個丟掉,健康檢查一通過,連 POST /admin/purge-all 都會被放行。六處表面差異全被代數宣告與三條改寫規則吸收。把 B 的事件種類與 A 的路徑守門組合起來,得到的是兩份候選都沒寫過的正確政策。如果只能在兩份原始候選裡二選一,兩個 bug 一定留下一個。官方使用指南裡規模較大的 Dogwood 研究則宣稱,五份樣本收斂成三個聚類,三個兩兩比對最後只剩兩個審查項;這是官方文件的自述,我沒有逐頁複驗指南內容。
這套輸出也可以接進 CI。checkau 指令給定最大結果大小,超過預算就讓程式失敗退出,官方用它把使用指南與引擎釘在一起,防止文件與實作漂移;同樣的指令可以當回歸閘門,改版後重新生成的形式化若與基準的差異暴增,管線直接擋下。文章還把這個方法與 Nature 2024 的語意熵研究(Farquhar 等人)類比:語意熵對多個自然語言答案聚類後給一個分數,反統一在形式輸出上保留得更多,共同結構與每個分歧都看得到。
文章示範了四種政策語言的適用情境,分歧的樣貌各不相同:
| 語言或格式 | 政策重點 | 文中示範的分歧 |
|---|---|---|
| Cedar | 誰能對資源執行動作、附帶哪些條件 | 一份要求「擁有且經同意」,一份接受「兩者之一」 |
| Dogwood | 涉及當前請求與近期事件歷史的授權 | 一份查先前的成功回應,一份查請求事件 |
| OpenShell 政策 | 代理的檔案與網路存取,含特定執行檔規則 | 一份許可倉庫範圍的 GET,一份許可整個組織的 POST |
| CEL | 由宿主應用供輸入、嵌入式評估的條件 | 一份對兩個埠都要求生產環境,一份只對其中一個 |
四種情境都指向同一個使用前提,而這個前提容易被新聞標題略過。引擎讀的是為範例建立的編碼,官方原文寫得明白:它不匯入這四種格式的原生政策檔。想比對自己的 Cedar 或 CEL 政策,要先把它編碼成引擎的語法並宣告等價律。另外,OpenShell 與 CEL 的兩個例子是作者構造的示意編碼,並非錄得的模型輸出樣本;把它們理解成「AI 實測」會高估現況。
還有兩個正確性前提要交代。Cedar 的 && 會短路,交換它的兩邊只有在都不引發錯誤時才站得住,這個副作用條件引擎不檢查,文章的說法是要靠驗證流程先把與順序相關的錯誤排除。更根本的限制是共同錯誤不可見:兩份候選若一起誤解需求,比對結果就是一致,低 :cr 分不代表正確,這點官方從頭到尾坦白。反統一引擎也不下 SMT 查詢找反例,不裁決哪一份符合需求,那些是求解器、驗證器與人的工作。
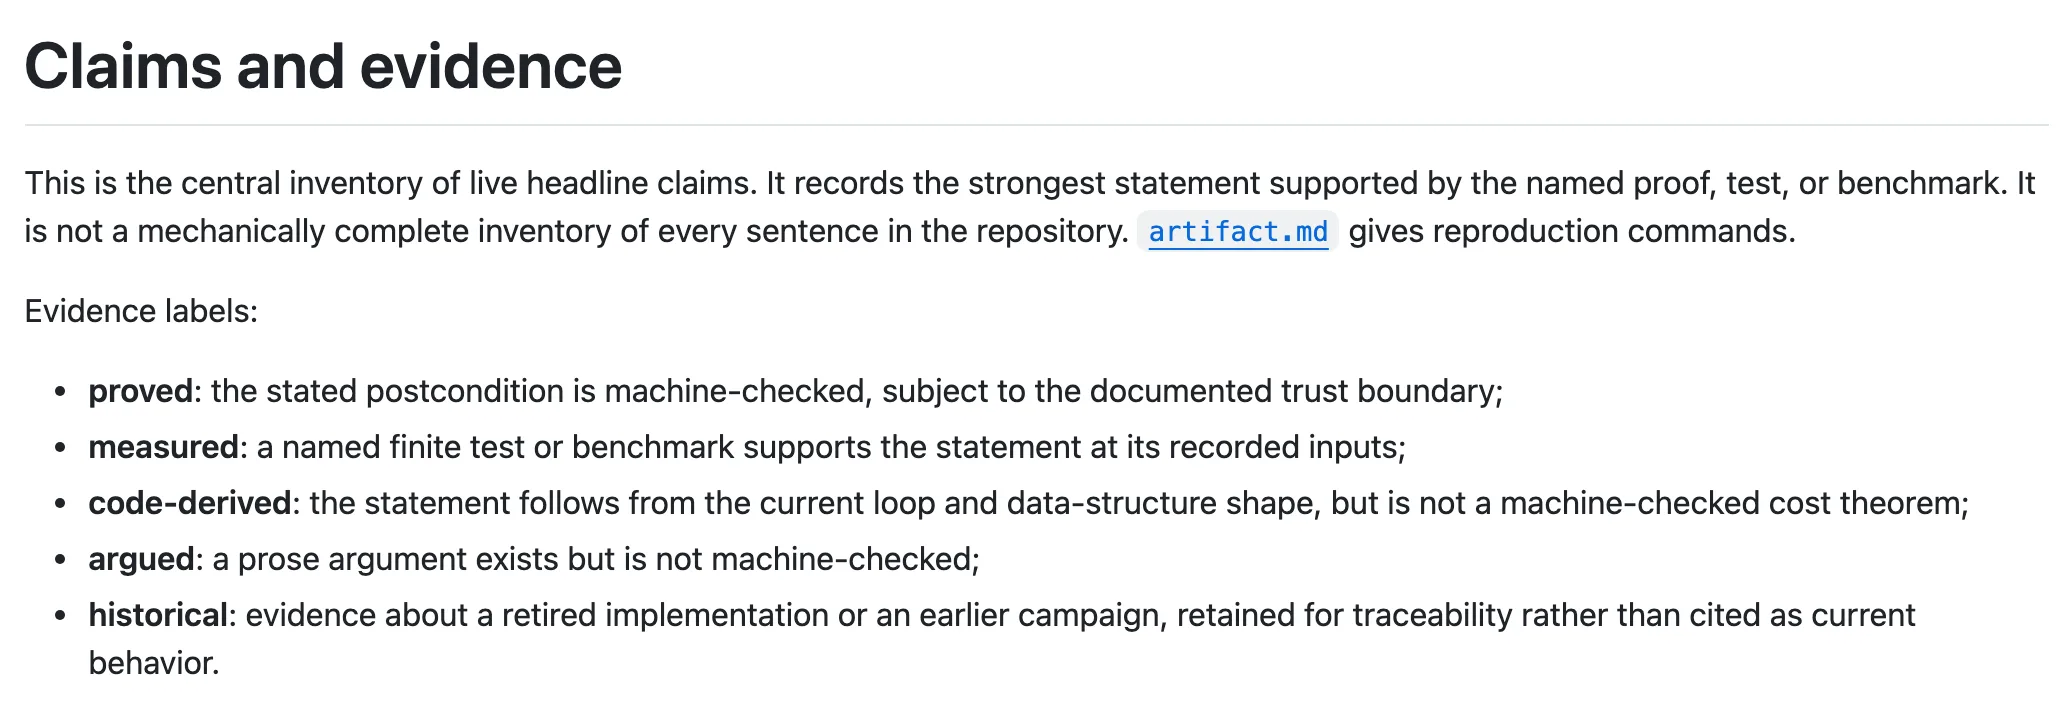
這個 repo 讓我印象最深的部分,是它對自身驗證狀態的分級陳述。儲存庫裡的 claims.md 把每個主張標上證據等級:proved 是機器檢驗過、measured 是有具體測試支撐、code-derived 是從程式結構推得、argued 只有文字論證,historical 則保留已退役實作的紀錄供追溯。等價圖的容器層用 Verus 驗證,主張是快照回復會重現標記當下的狀態,對應 1,703 個驗證條件、0 個錯誤;反統一的運算套件證明了目標排序與下界引理,但整套求解器還沒有端到端的精煉證明。引擎可以開啟 –proofs 為每個推導出的等價記錄理由,官方也自承這些紀錄尚不是可獨立重播的證書。研究成果敢把自己的證明邊界攤開列檔,這在開源研究儲存庫裡少見,值得單獨肯定。
實作層的三個選擇讓次秒級查詢變得可行:交換律與結合律不是改寫規則,直接做進資料結構的標準排序;模式比對只對不重複的子項分支,避免組合爆炸;反統一本身用動態規劃求精確解或用 anytime 的蒙地卡羅搜尋。快照採半持久設計,push 與 pop 記成稀疏差異,回復成本與實際改動量成比例,一張共享圖就能連續比對多個候選。
引擎以 Apache-2.0 授權開源,儲存庫是 yaspar-org/semi-persistent,2026 年 4 月 17 日建立,截至 11 月 15 日查核有 22 顆星,最後推送停留在 11 月 12 日。值得注意的時間線是:這不是一個隨文章首發的新專案,儲存庫存在已超過半年,文章釘選的範例修訂版 5a7969ae 落在 9 月 20 日,也就是已合併的 PR 103「Add OpenShell and CEL policy translation examples」。新聞本體是官方技術文章的發表,把既有引擎與方法整理成可遵循的審查流程。
要動手的人需要一部釘選 Rust 工具鏈的機器:複製儲存庫、取出該修訂版、cargo build –release,然後跑四個範例檔,從文章的主要案例到 Dogwood、OpenShell、CEL 各一個。工具鏈會自動釘選,Verus 驗證非必要。官方對讀者的假設也寫明了:要讀得懂 SMT-LIB 風格的 S 運算式,並且知道授權政策是什麼。動態事實如星數與活躍度會漂移,claims.md 的驗證範圍若從容器層擴大到整套求解器,這篇文章的邊界描述就需要回查更新。
判斷標準可以收斂成三個問題。團隊是否已經有多候選形式化的流程?這套方法比的是候選之間的分歧,只有一份候選時無用武之地。政策語言是否拿得到抽象語法樹並寫得出等價理論?這是把原生政策編碼進引擎的門票。分歧出來之後,手上是否有結構描述驗證或事件重播可以接手裁決?引擎只負責把審查範圍縮小,不替你判斷對錯。三個都是肯定的團隊,今天就能把 checkau 掛進 CI 當回歸閘門;任何一個是否定的,先補那塊再談導入。
就新聞本身而言,這篇文章的價值在於 AWS 把形式方法帶到 AI 生成政策這個高風險環節,而且給出了可以重跑的範例與誠實的證據分級,與稍早 AWS 開源 UAEF 評測框架把代理放上同一把尺的路線一致:先把「怎麼驗」標準化,再談自動化。它同時清楚示範了研究原型與產品之間的距離:吃手工編碼而不吃原生政策檔、驗證只到容器層、共同錯誤不可見。把這些邊界與那兩個被揪出的真 bug 放在一起看,你會知道它值得追蹤,也知道現在還不能把審查權交出去。