TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

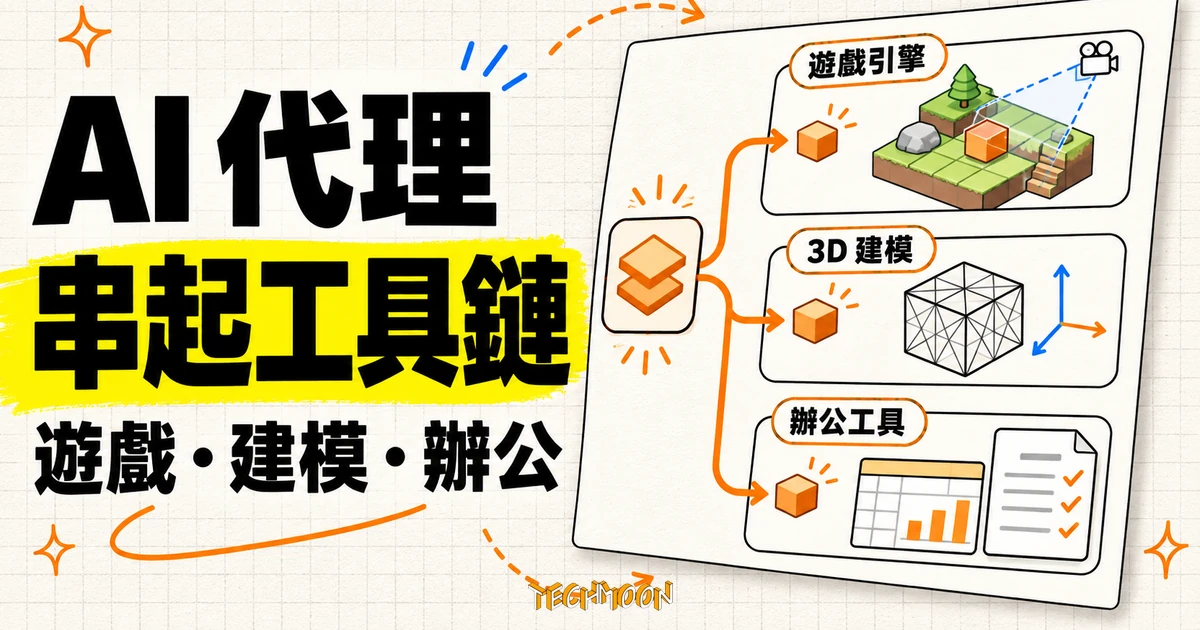
百度 11 月 11 日發布 ERNIE 5.5 Flash Preview,是 11 月 5 日開源底座 ERNIE 5.5 Flash Base 之後的第一個後訓練模型,280B 總參數、14B 啟用、百萬 token 上下文。API 已上千帆平台與 OpenRouter 免費層,權重預計 11 月 25 日前以 Apache 2.0 開源。官方展示遊戲開發、Blender 建模與知識工作成品,但模型本身是純文字模型,畫面與影音產出都靠外部工具完成。
用 AI 摘要這篇文章:
百度在 2026 年 11 月 11 日發布 ERNIE 5.5 Flash Preview,距離 11 月 5 日開放 ERNIE 5.5 Flash Base 底座權重只隔六天。先把讀者最需要的三個答案講清楚:模型 API 現在就能用,百度千帆平台與 OpenRouter 都已上架,OpenRouter 還提供免費層;模型權重目前不能下載,官方承諾 11 月 25 日前以 Apache 2.0 授權開源;定位是後訓練的中間檢查點,訓練還在進行,官方自己也提醒部分能力可能仍不足。
要看懂這次更新,先把兩個版本拆開。11 月 5 日釋出的 ERNIE 5.5 Flash Base 是預訓練結束時的檢查點:模型從頭讀了 33.5 兆 token 的語料,訓練上下文長度 128K,微調與推論可支援到 100 萬 token,但還沒被調整過怎麼回應指令、怎麼操作工具,權重直接開放,適合當作後續研究的共同起點。11 月 11 日登場的 ERNIE 5.5 Flash Preview 則是官方在這個底座上完成的第一個後訓練模型,重點在調整模型接指令、拆任務、呼叫工具、讀完工具回覆再決定下一步的行為。
兩代版本的參數架構相同:總參數 2,800 億,採用稀疏混合專家設計,每個 token 只啟用約 140 億參數,上下文視窗支援 100 萬 token。混合專家(MoE)用一句話講,就是把模型切成很多個專家子網路,每個 token 只動用其中一小群,藉此在大參數量與推理速度之間取平衡。底座的預訓練語料特別著重兩種事後很難補的能力:整個儲存庫規模的程式碼,以及長上下文理解,這兩項正好是代理工作最吃重的輸入。百度在官方 X 貼文中宣稱生成速度超過每秒 200 個 token,這個數字屬於官方宣稱,尚未有獨立驗證。
官方在頁面裡反覆標明這個版本的定位:它是後訓練過程的中間檢查點,訓練沒有結束,部分能力可能仍落後,後續還會依實際使用回饋在正式版改進。換句話說,現在測到的表現不等於最終版表現,研究者做評估時應該把觀察對到這個預覽版本,而不是把它當成定稿。
受影響的族群也因取得方式而不同。走 API 的開發者今天就能把模型接進既有流程,和手邊其他模型跑同一段工作負載比較;等權重自架的研究者要看 11 月 25 日的釋出內容,確認模型卡、推理需求與授權細節;而成品裡最吸引目光的內容創作與 3D 工作,實際採用前還得先盤點自己工作環境裡有沒有對應的工具鏈,因為成果的好壞有很大一部分取決於環境裡的軟體、素材與權限,這些條件官方展示裡都幫忙準備好了,自己的環境未必。
官方頁這次放了四大類成品:遊戲開發、3D 建模與設計、知識工作、影片創作。讀這些成品前有一個官方自己寫明的關鍵條件:ERNIE 5.5 Flash Preview 是純文字模型,看不到螢幕。所有成品都是模型在代理工作環境裡端到端完成,畫面理解、渲染與影音產出依賴外部工具,官方也在每件作品旁逐項標註外部素材來源。這也是今年模型展示的共同走向:代理模型比的是把工具串起來的能力,先前把工具呼叫壓進 8 億參數的 BotPsy 走的是同一條路的縮小版。
遊戲類有兩件。第一件是用 Unreal Engine 5.8 製作的第三人稱武俠遊戲《雲袖行》:單一 11 小時的編碼任務,模型把好幾個世代的 Unreal Engine 資產合併進同一個專案,整款遊戲用 C++ 寫成。因為模型看不到畫面,試玩時發現的角色懸浮在半空、跑步方向不一致、鏡頭位置錯誤,都被轉寫成一個個可測量的程式測試,靠著不斷長大的測試套組加上遊玩回饋推動每次迭代。這套做法等於示範了看不見畫面的模型如何靠測試來驗收畫面相關的工作。第二件從完整的遊戲設計文件出發,做出近百款手機小遊戲,橫跨 Cocos、Unity、LayaAir、PixiJS 與 Canvas 2D 五種技術,影片裡收錄了 24 款;多數遊戲把規則與表現層分開,讓規則以確定性模擬運行,機器試玩與關卡重放可以自動檢查每關都破得掉、數值有沒有失衡。遊戲開發能力的訓練本身也有專屬資料與評測框架,官方點名加強的四個面向是遊戲機制實作、玩法邏輯編排、執行期狀態管理與素材管線,並支援 Unreal Engine、Unity、Godot 三大引擎的工作流程。
3D 與 CAD 類的分工照同樣邏輯。機場與客機影片由兩個代理分工,一個蓋機場、一個造飛機,都是透過 Blender 的 Python API 以程式建模,整個工作被拆成各自推進又互相對齊的子任務,機場的配置向量資料是模型自己在地圖平台找到的,兩邊的成品再由模型對上比例、位置與鏡頭,交給 Cycles 與 OptiX 逐幀渲染、FFmpeg 剪輯;素材授權逐一列出,地圖資料來自 OpenStreetMap,材質來自 Poly Haven,部分模型來自 Sketchfab 與 Tripo API。法隆寺(Hōryū-ji)複刻則由模型自行研究伽藍配置與建築結構,連開放授權的佛像掃描都是自己找來的。另一段科幻電影前置視覺化用程式生成約 2,100 個物件、182 萬個三角面的四個分鏡場景,再拿去引導 Seedance 2.5 生成最終畫面。CAD 類展示用 FreeCAD 寫腳本,做出 W16 引擎、百度國際大廈深圳雙塔與月面探測車概念模型,官方註明成品是可編輯的工程模型,搭配一個 MCP 視覺理解工具補上「看圖」這一步。
知識工作的成品更能直接檢驗。20 頁研究報告《The AI Power Bill》整理美國 AI 資料中心用電爭議,引用勞倫斯伯克利實驗室、EPRI、PJM、ERCOT 等機構的公開資料;24 頁報告《Driverless, by the Numbers》比較 Waymo 與 Tesla FSD,清理了 4,169 份聯邦碰撞報告;財務活頁簿 LIFEWEALTH 用蒙地卡羅模擬跑 1,000 條隨機市場路徑估算退休計畫成功機率;還有一段 6 分 34 秒的原創管絃樂曲以 WAV 檔交付。影片創作類的《The Pelican Test》是 116 秒的 2D 動畫,超過 1 萬行 Python 程式碼驅動,一隻白鵜鶘騎腳踏車穿越 20 種畫風,配樂剪了 22 段選錄音源,概念設計來自一位 Bilibili 創作者。另一支 75 秒的物理解說影片《Flying Roadster》拆解特斯拉 Roadster 飛跳的力學,部分畫面由 Seedance 2.5 生成,官方特別註明影片與 Tesla 無關、受力示意僅供說明,第三方素材的授權邊界在展示裡有被認真對待。
支撐這些能力的訓練環境規模也一併公布:知識工作領域建了 30 萬個工作區、收錄 1,000 萬份參考檔案、涵蓋超過 40 種檔案格式,從 10 到 100 檔的個人工作區到上千檔的企業知識庫都有;影片創作建了超過 15 萬個環境、超過 1,000 種創作技能,累積約 5,300 分鐘成品影片。要留意這些是訓練材料的規模,說明百度把力氣花在哪裡,但不能直接換算成任何一件成品的品質保證。
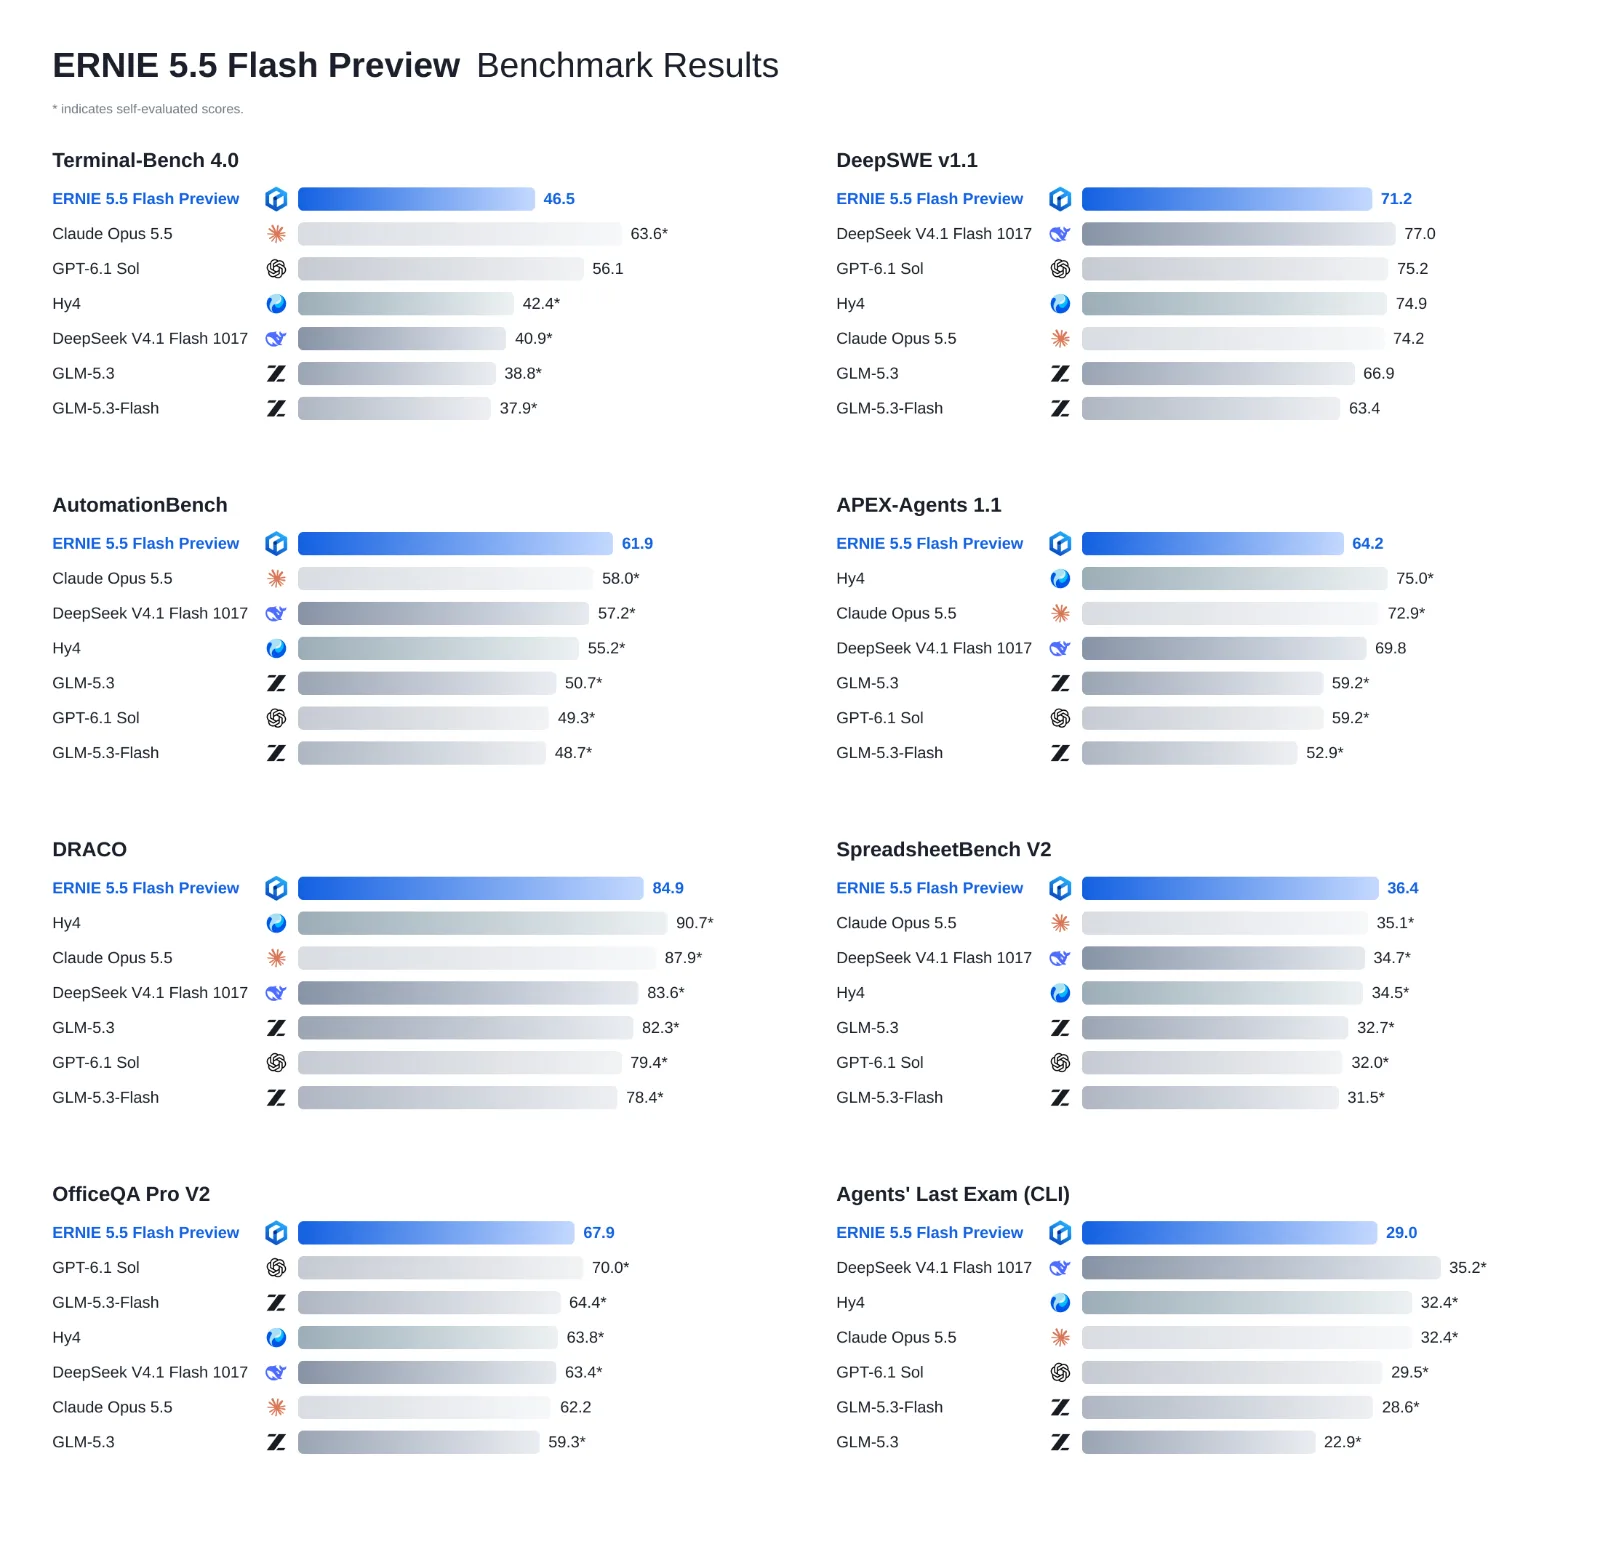
官方頁附了一張 benchmark 成績圖,覆蓋 8 項基準,對照模型包括 Claude Opus 5.5、GPT-6.1 Sol、Hy4、DeepSeek V4.1 Flash 1017、GLM-5.3 與 GLM-5.3-Flash。圖上成績並非一面倒:ERNIE 5.5 Flash Preview 在 AutomationBench 拿 61.9 分、在 SpreadsheetBench V2 拿 36.4 分,這兩項是圖中最高;DeepSWE v1.1 拿 71.2 分,落後 DeepSeek V4.1 Flash 1017 的 77.0 分與 GPT-6.1 Sol 的 75.2 分;DRACO 拿 84.9 分排第二,落後 Hy4 的 90.7 分;OfficeQA Pro V2 拿 67.9 分,略低於 GPT-6.1 Sol 的 70.0 分。
落後幅度較大的項目也寫得清楚。Terminal-Bench 4.0 拿 46.5 分,低於 Claude Opus 5.5 的 63.6 分與 GPT-6.1 Sol 的 56.1 分,而且這三個分數裡唯一掛自評星號的是 Claude Opus 5.5 的 63.6;APEX-Agents 1.1 拿 64.2 分,落後 Hy4 的 75.0 分;Agents’ Last Exam(CLI 版)拿 29.0 分,輸給 DeepSeek V4.1 Flash 1017 的 35.2 分。官方 X 貼文點名 Terminal-Bench 與 AutomationBench 兩項作為賣點,對照圖上成績,後者是榜首、前者排第三,宣傳用語與明細放在一起看會更準。DeepSeek V4.1 Flash 這條產品線今年發表時同樣以代理任務為主打,兩邊的對照分數恰好可以直接互看。
讀分數時也要看每項基準的分數帶。SpreadsheetBench V2 那欄全場都在 31.5 到 36.4 分之間,榜首與末位只差不到 5 分,領先的意義和 AutomationBench 上高出對手 3.9 分不同;Agents’ Last Exam 全場最高也只有 35.2 分,說明這項基準對所有參賽模型都還很難。把名次和分數帶放在一起看,才不會被單一數字誤導。
圖的畫法本身也值得看一眼:每項基準的長條圖都把 ERNIE 5.5 Flash Preview 放在最左邊,視線掃過去容易留下領先的印象,實際名次要回到數字欄位逐項對照才準。
這張圖還有一個更該注意的腳註:星號代表自評分數。逐欄看下來,多數對照模型的分數都掛著星號,也就是百度自己跑出來的成績。這張圖適合當方向參考,看模型的強項集中在自動化與試算表類任務,但不能當成獨立評測結論,實際表現仍要回到自己的工作負載驗證。
想立刻動手的人有兩個官方入口。第一個是百度智能雲的千帆平台,模型已列入內建模型清單,走 API 呼叫,對應的是百度自己的雲端生態。第二個是 OpenRouter,模型以 ernie-5.5-flash-preview 免費層上架,對已經透過 OpenRouter 串接多家模型的團隊來說,試用門檻相當低,免費層的速率與用量細節以平台頁面為準。兩個入口指向的都是這個 Preview 版本,帳號與計費各自獨立。
計畫自行部署的研究者則要再等一下。權重開源是承諾而非現況:官方發布頁寫 Apache 2.0 授權即將開放,官方 X 帳號進一步給出 11 月 25 日前的時間表。Apache 2.0 是商用條件寬鬆的授權;底座版權重用的則是百度自訂的模型授權條款,兩代並不相同。實際下載、部署與硬體需求,要等檔案真正釋出才能確認;以同為混合專家架構的 DeepSeek V4.1 Flash 自架經驗 為參考,先把記憶體與硬碟容量算清楚是必要的前置作業。
想在權重釋出前先做功課的團隊,比較務實的做法是現在就把自己最在意的任務寫成可重複的驗收條件:固定一批輸入素材、寫下評分方式(任務有沒有跑完、輸出對不對、每件成品花多少 token 與時間)、記下工具環境的版本,先用 API 免費層跑一輪,等權重開放、自行部署後用同一組條件再跑一次,兩邊數字才有可比性。只看官方精選影片,容易高估一般任務的穩定度,因為影片裡的素材、引擎與回饋管道都是官方替模型準備好的。
這則新聞有三個尚未落地的變數。最大的是權重釋出:11 月 25 日是官方給的期限,實際檔案內容、模型卡與執行環境需求都要等釋出當天確認,這也是值得回查的時點。再來是最終版表現:後訓練持續進行,正式版與預覽版之間的差異幅度目前沒有任何資料,把產品直接建在預覽檢查點上的團隊,要有版本行為改變的準備。獨立驗證則還缺席:官方分數圖多數對照數字為自評,每秒 200 token 的速度也是宣稱值;OpenRouter 免費層與千帆的供應條件屬於平台政策,正式採用前以兩邊的定價與配額頁面為準。
百度今年的開源動作明顯變密,從文件辨識模型 Unlimited OCR 2 到 ERNIE 5.5 Flash 底座,再到這次掛出明確時間表的後訓練預覽版,節奏是每次釋出都附上可查核的原始文件。對使用者的意義很直接:想試的人今天就有免費入口,想自架的人 11 月 25 日前後盯著 HuggingFace 上的百度組織頁與 ERNIE 官方 X 帳號,兩種路線都不需要先做承諾。