TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

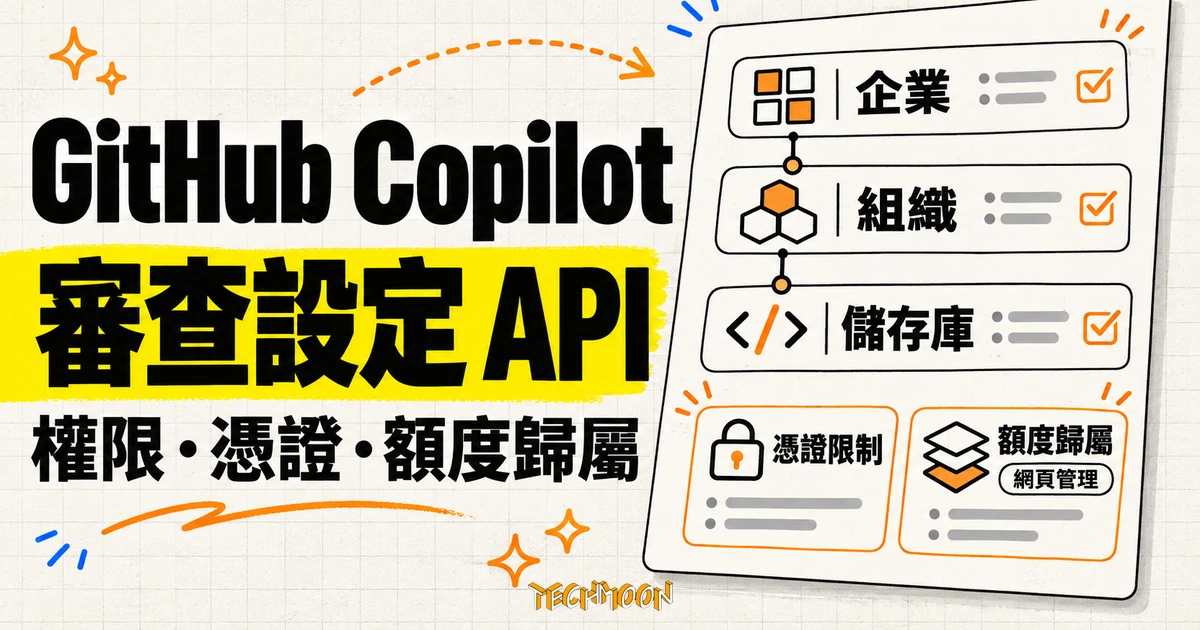
GitHub 於 11 月 6 日把 Copilot 程式碼審查的管理設定搬進 REST 與 GraphQL API,從企業政策、組織預設強度到儲存庫的 MCP 開關都能程式化管理,留言也新增明確歸因與依據來源。最大強度上限、帳務與核准仍只在網頁,企業與組織端點也不收 GitHub App,管理工具要分層準備身分,額度歸屬更決定審查會不會半途失敗。
用 AI 摘要這篇文章:
GitHub 在 2026 年 11 月 6 日把 Copilot 程式碼審查的管理設定搬進 REST 與 GraphQL API,涵蓋 Copilot Pro、Pro+、Max、Business 與 Enterprise 五種方案。細看官方公告之前,值得先把一句邊界記住:最大審查強度上限、帳務歸屬與核准政策,這三個畫出治理框架的設定,官方設定文件明寫不開放 API,仍然只在網頁設定頁。API 收進來的是執行層的開關與預設,決策層的邊界留在原處;再搭配企業與組織端點不收 GitHub App 與細粒度存取權杖的憑證落差,一套管理工具要分層設計,沒辦法用同一個身分打通全公司。
公告也把「本來就有」與「現在才有」分得很清楚:要求審查、指定強度、拿回結果的介面早就存在,本次新增的是設定管理與辨識 Copilot 輸出的欄位。同一次更新還包含審查摘要改版、Balanced 等級改用三個審查模型加一個彙整模型,以及六項修正。下面用管理者最容易踩到的三個問題拆開看:能改什麼、哪種身分會被拒、AI 意見與額度怎麼追。
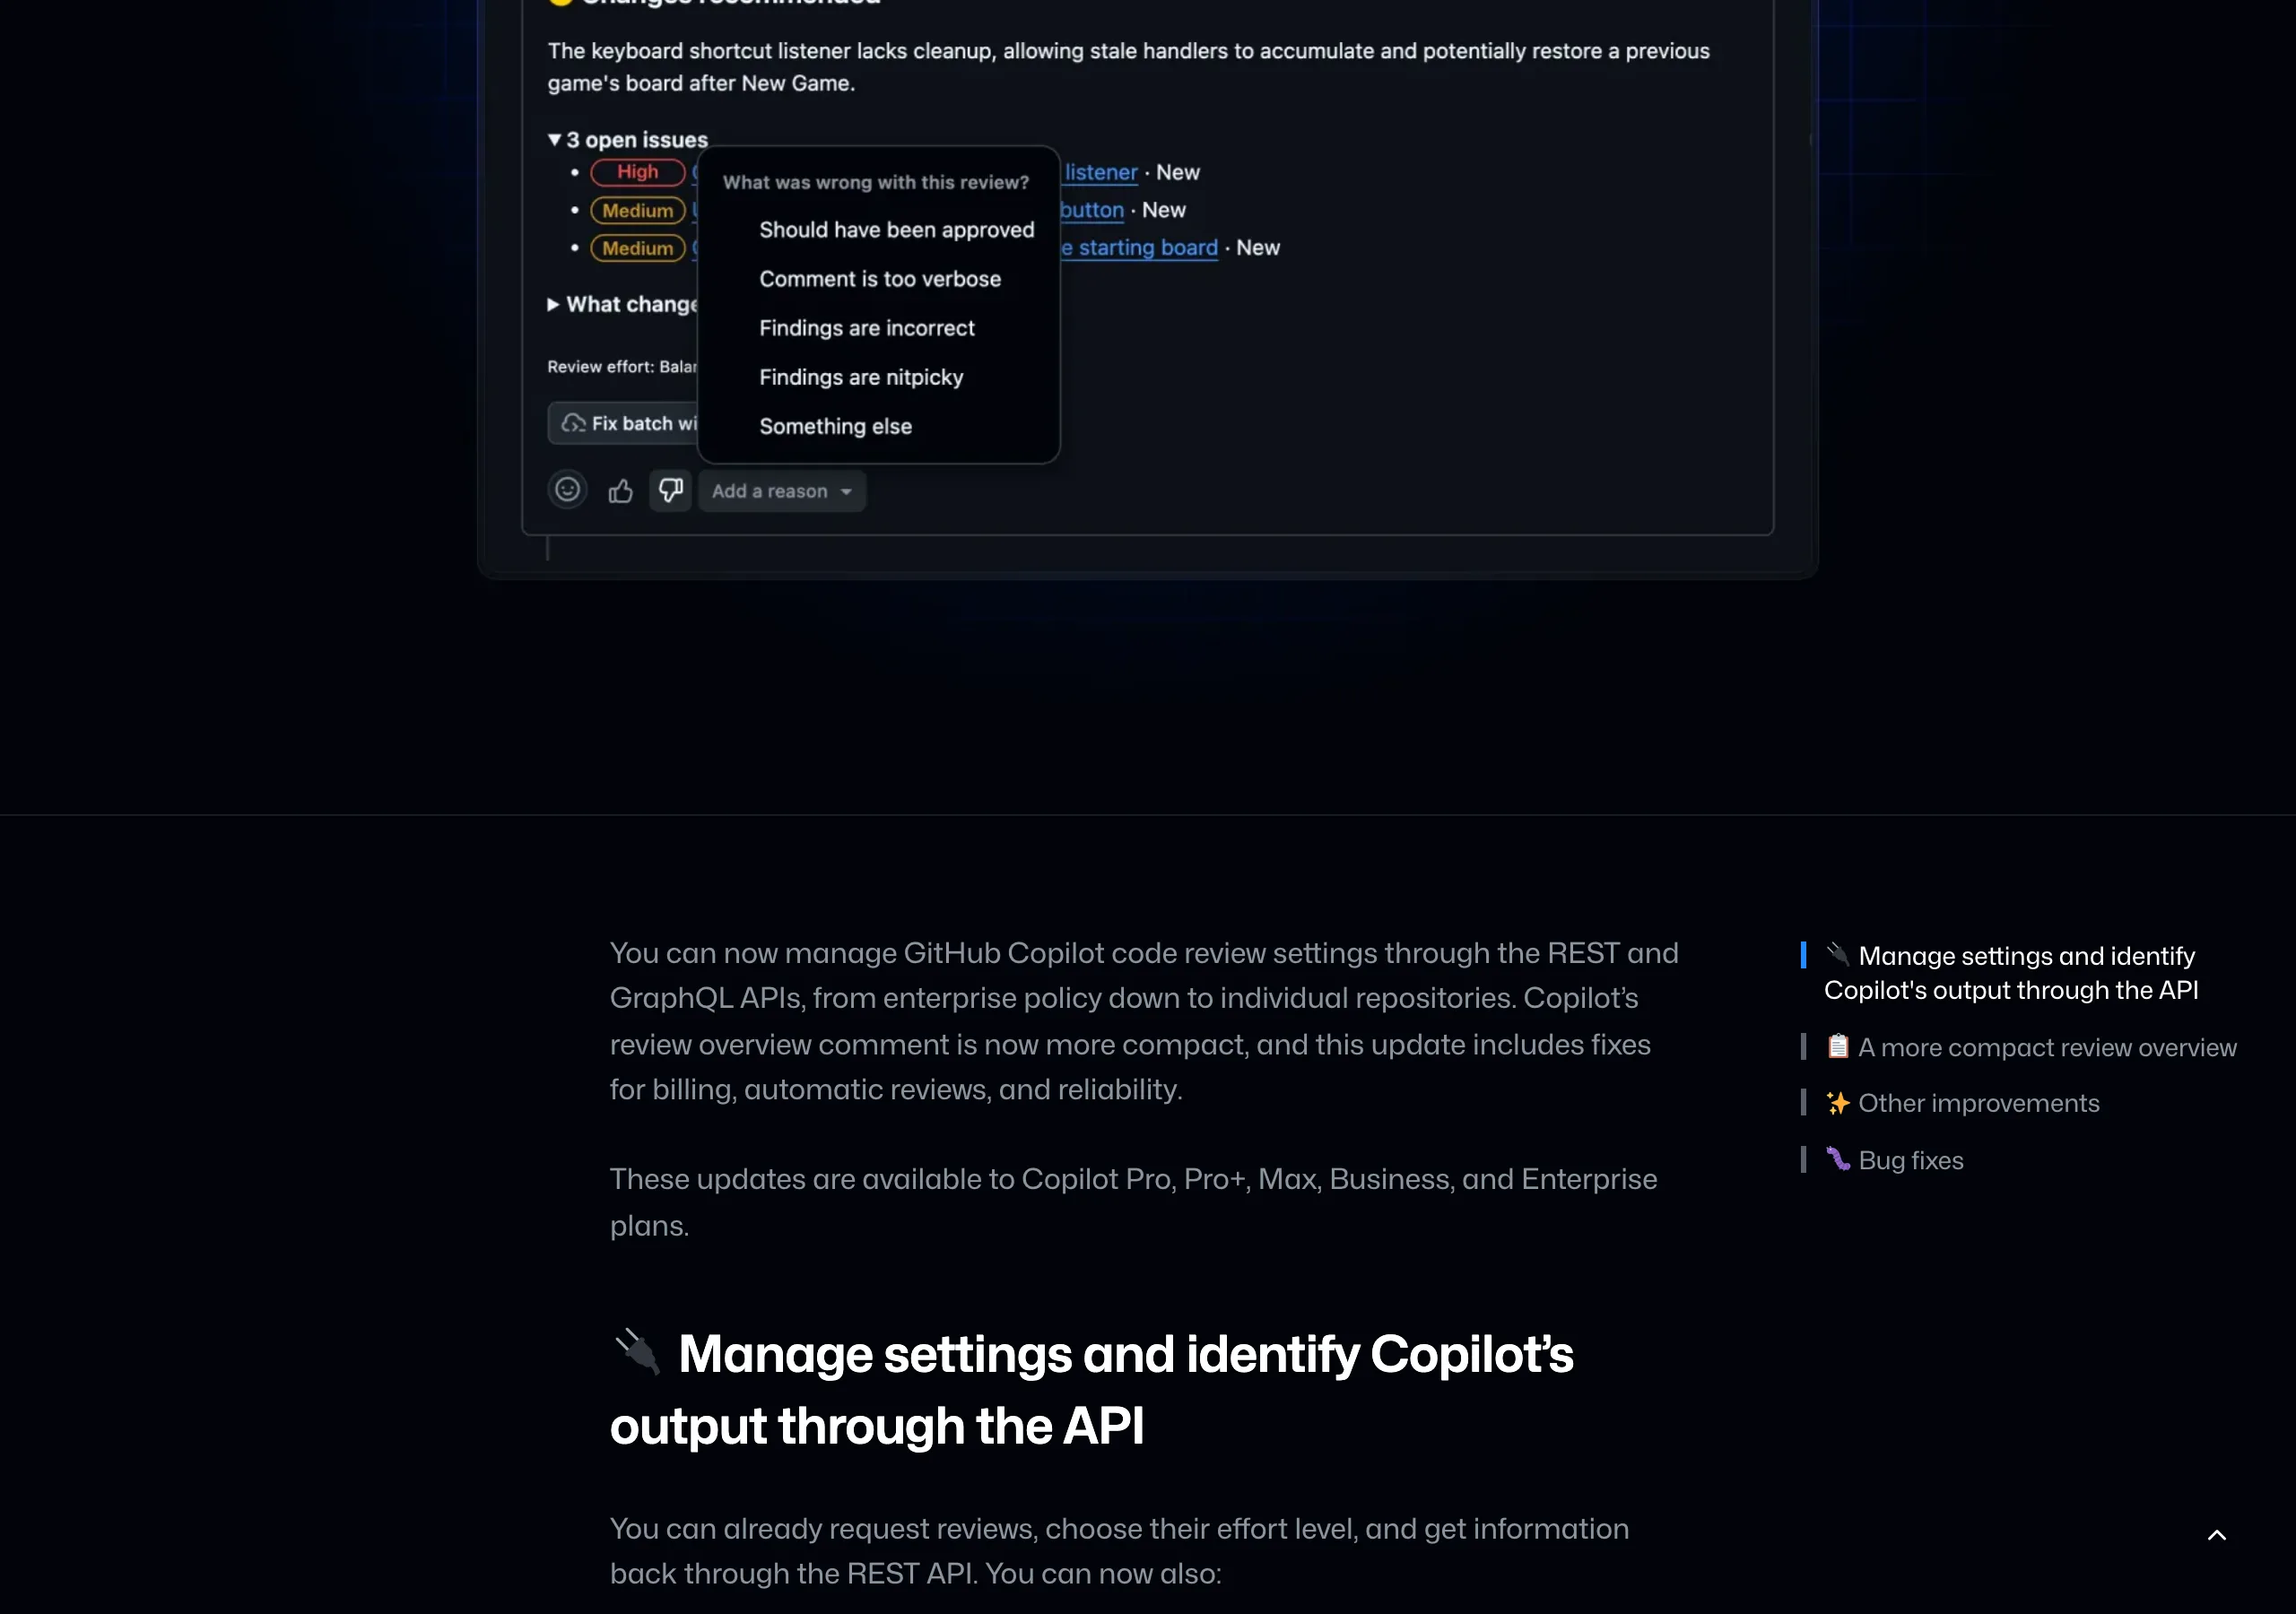
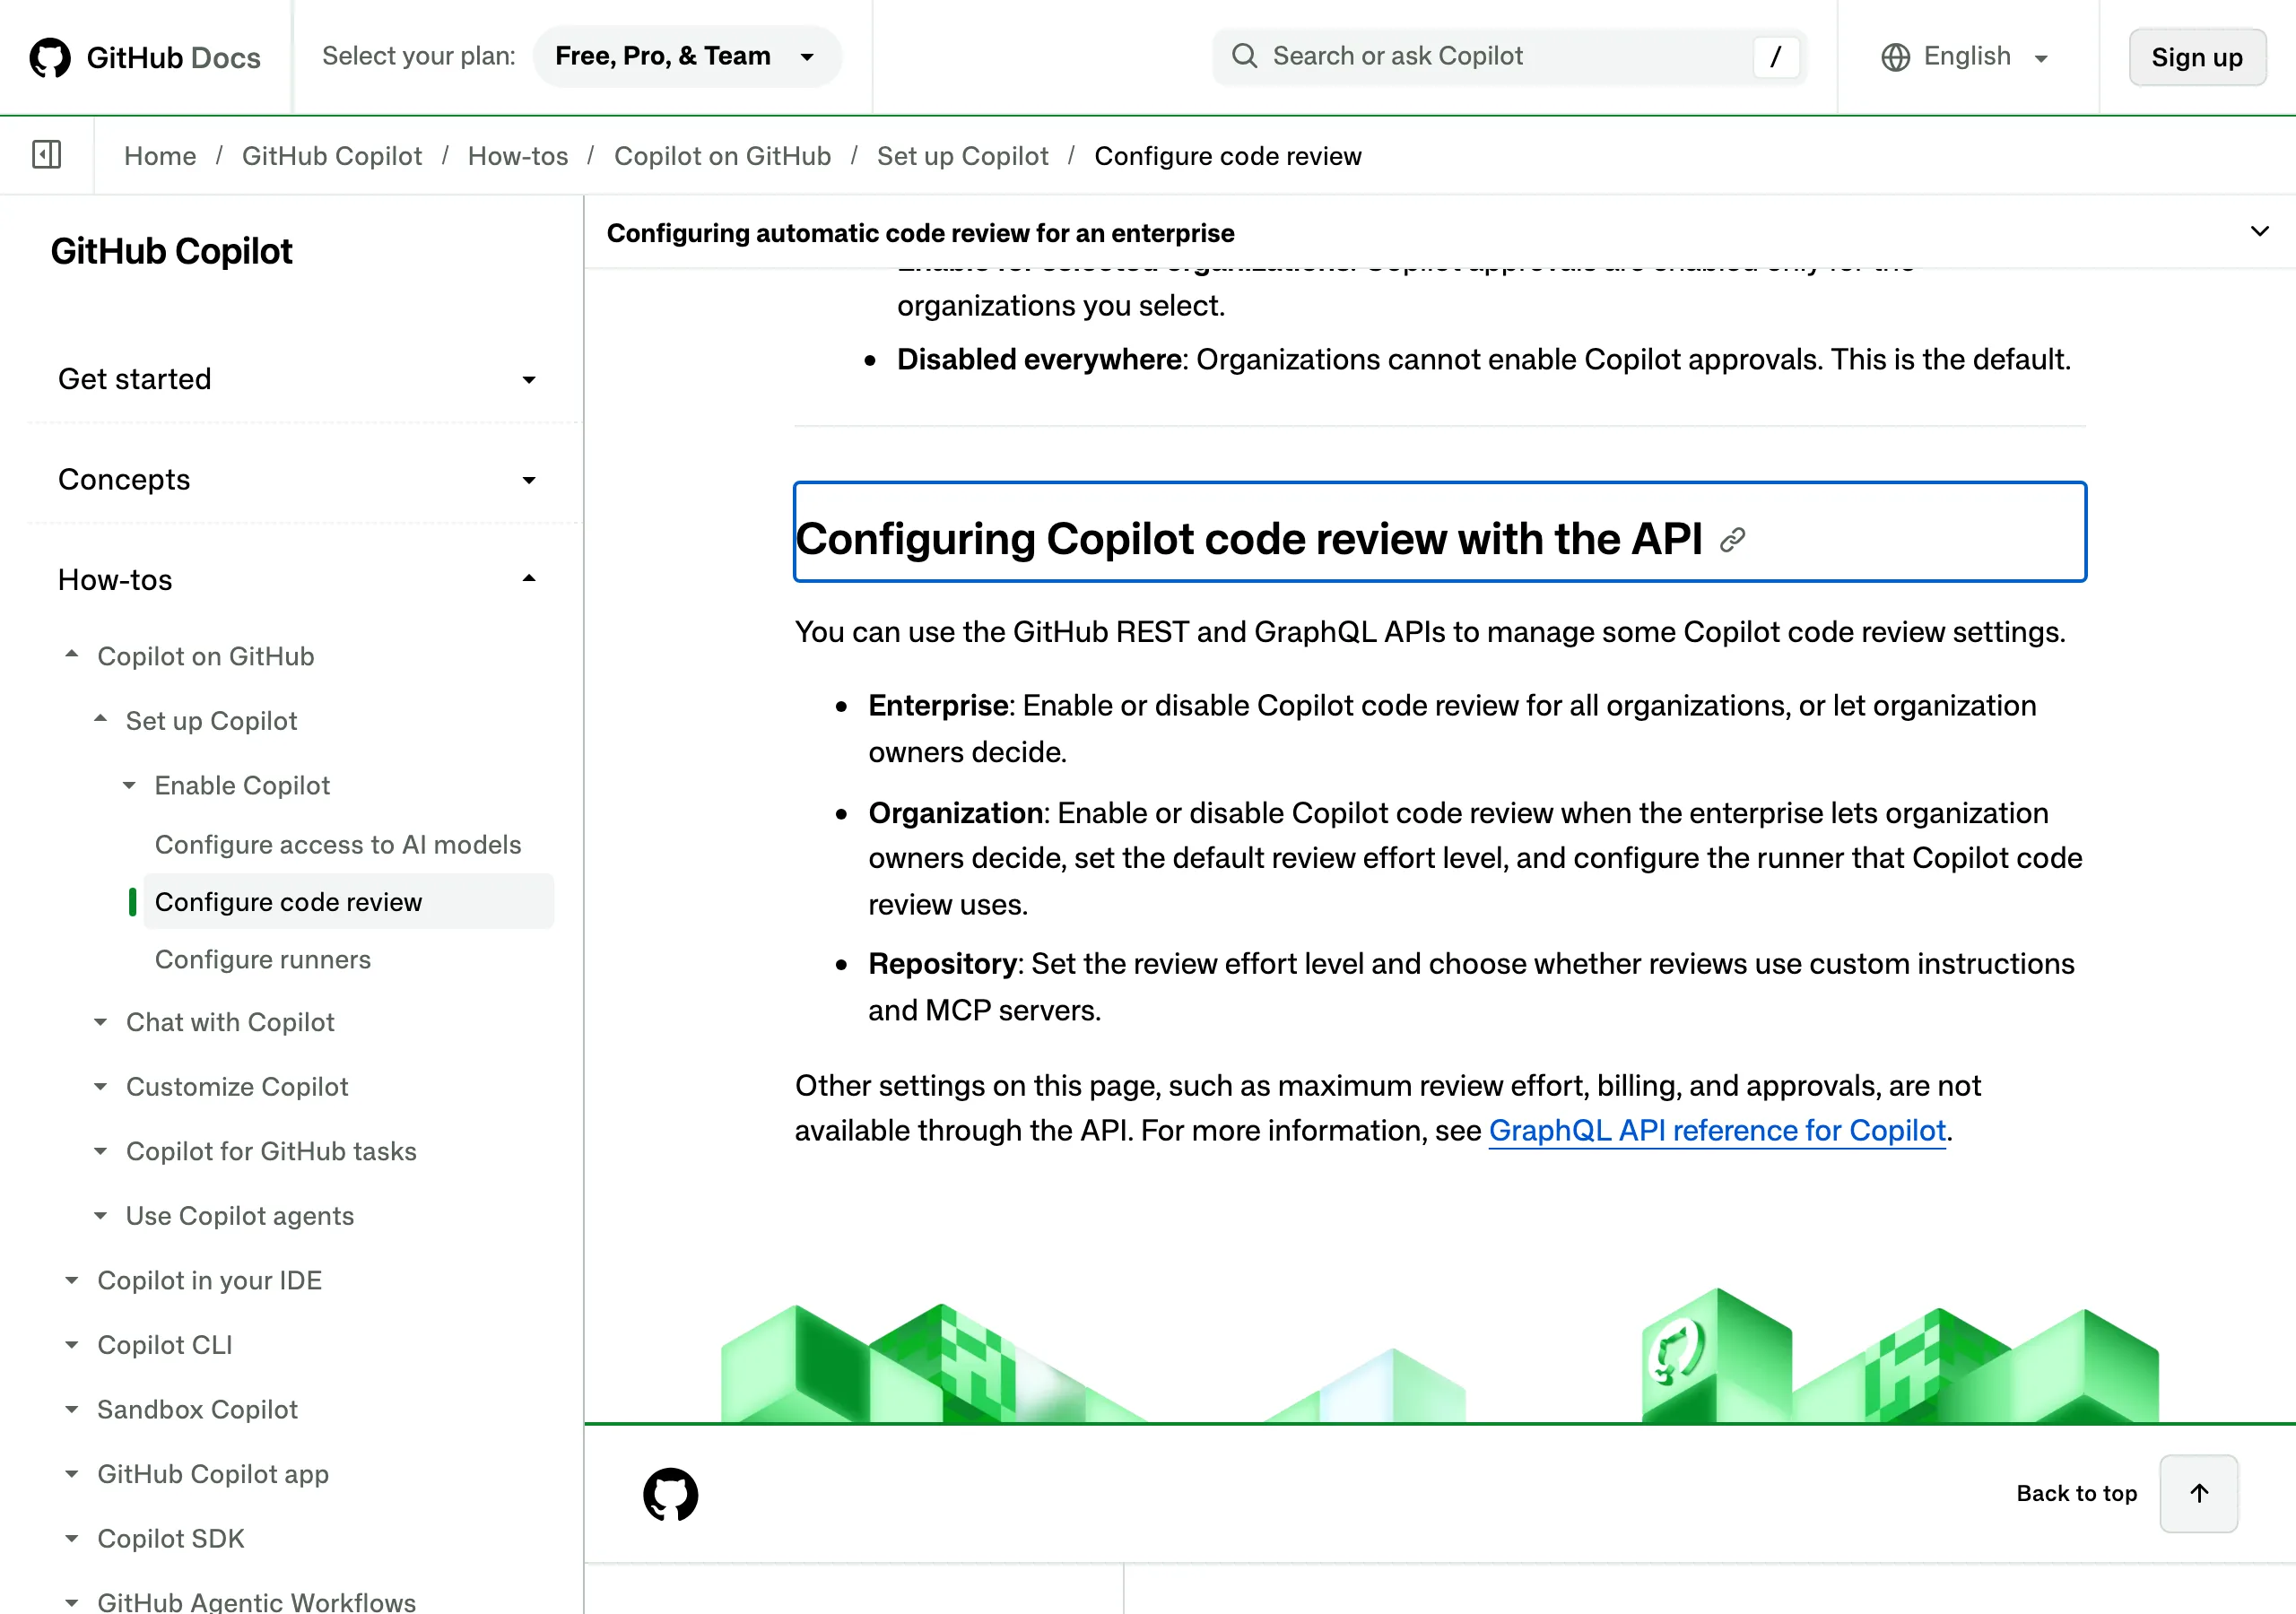
先看能改什麼。GraphQL 參考文件這次多出五個設定用的 mutation:企業層的 updateEnterpriseCopilotCodeReviewPolicy,組織層的 updateOrganizationCopilotCodeReviewPolicy、updateOrganizationCopilotCodeReviewSettings 與 updateOrganizationCopilotCodeReviewRunnerConfiguration,以及儲存庫層的 updateRepositoryCopilotCodeReviewSettings。對應到權限,就是既有的三層分工:
reviewEffort、customInstructionsEnabled、mcpEnabled 與 severityFilter,其中強度填 INHERIT 就會清除自訂值,改繼承組織、企業或 GitHub 的預設;severityFilter 有三個值,分別是不過濾、略過低嚴重度的留言、略過低與中嚴重度的留言,等於把留言噪音的控制也收進同一個端點。兩個細節對批次工具特別有用。設定回應會附上 availableReviewEfforts,按顯示順序列出這個組織或儲存庫目前實際能選的強度,等於官方在回應裡內建了防呆:各組織的管理政策(例如最大強度上限)會讓可用值不同,把強度寫死在腳本裡,遲早和真實政策對不上。另外,強度列舉有 AUTO、LITE、BALANCED、MAX 四個值,AUTO 的語意是 Copilot 逐件 PR 自己挑強度。官方只說 API 與網頁介面接受同樣的強度等級,沒有指明 AUTO 對應網頁選單裡的哪個選項,網頁的內建預設目前顯示為 Default (Balanced)。
runner 也在這次的管理範圍裡。型別有兩種:STANDARD 是標準 GitHub 代管 runner,LABELED 是符合指定標籤或 runner group 的 runner,後者至少要給一個標籤或群組才成立。組織可以決定要不要開放儲存庫用自己的 runner 設定,而設定回應也會標明目前生效的值是繼承自 coding agent 的 runner 設定還是審查自己的設定。
至於大家最想自動化的那幾件事,範圍邊界要再念一次:設定文件的 API 段落明寫,最大審查強度上限、帳務與核准等其他設定,不透過 API 提供。想統一全公司的強度上限、想翻轉額度由誰支付、想調整 Copilot 核准能不能算進合併條件,這三件事仍然要走網頁設定頁。把管理腳本的預期對準這條線,才不會出現「API 都開了,為什麼找不到改上限的端點」的落差。
還有一個容易誤會的點:自動審查的觸發來源是分開判定的。個人設定、儲存庫規則與組織規則各自獨立評估,多個來源同時符合時,Copilot 也只會送出一份審查;而且個人設定關不掉規則啟用的新推送或草稿審查。關掉自己的自動審查,不代表組織規則要求的審查會停,排查「為什麼還在審」時要連規則來源一起看。
憑證是更容易被忽略的坑。公告裡的警告段落值得逐字讀:企業與組織的設定端點,包括組織的 runner 端點,不支援 GitHub App,也不支援細粒度個人存取權杖。儲存庫設定端點則兩者都支援,讀取要 Administration: read 權限,寫入要 Administration: write,讀寫可以分開授權;如果用的是傳統個人存取權杖,呼叫者必須本身就是儲存庫管理員。憑證類型與帳號角色要同時符合,手上有一串能登入的權杖,不代表每個設定請求都會被接受。
這個落差對管理工具的設計有直接影響。同一個 GitHub App 就算裝了整個組織、能操作每個儲存庫,也推不動企業或組織層的設定端點。想往上改政策,呼叫端就必須換成具備對應管理員身分的憑證。比較務實的路徑因此分成兩段:儲存庫端點支援的範圍最廣、權限也最細,適合拿來做全公司的設定盤點與批次微調;企業與組織層的政策變更,交給具管理員身分的流程另外處理。想把所有權限塞進同一個整合身分,在目前的憑證規則下行不通。
失敗也不是黑箱。組織設定更新的回應帶有 conflict 欄位,目前定義了 SETTING_NOT_EDITABLE,也就是說明這個設定由上層管理、組織改不動。管理腳本收到衝突代碼,比猜「為什麼沒生效」省下不少時間。
稽核與成本是另一半重點。過去要辨識「這條審查意見是不是 Copilot 留的」,多半靠顯示名稱或語氣猜。這次更新加了明確的歸因欄位,程式可以直接判斷哪些審查與留言來自 Copilot;在資料可用的情況下,也能看到該次審查實際使用的強度。部分留言還會回報參考過的技能、MCP 伺服器與自訂指示,讓「這個建議是依哪份規則提出的」有跡可循。背後的脈絡值得知道:GitHub 官方的 MCP 伺服器與 Playwright MCP 伺服器預設就是啟用的,技能與指示則是從 PR 的來源分支讀取,不是從主幹分支,所以同一個 PR 可以先用來測指示的修改。不過官方對來源回報的措辭有限定:資訊只出現在部分留言,也沒有宣稱這是完整的推理稽核紀錄。把歸因欄位當穩定的過濾器可以用,把它當完整解釋就過頭了。
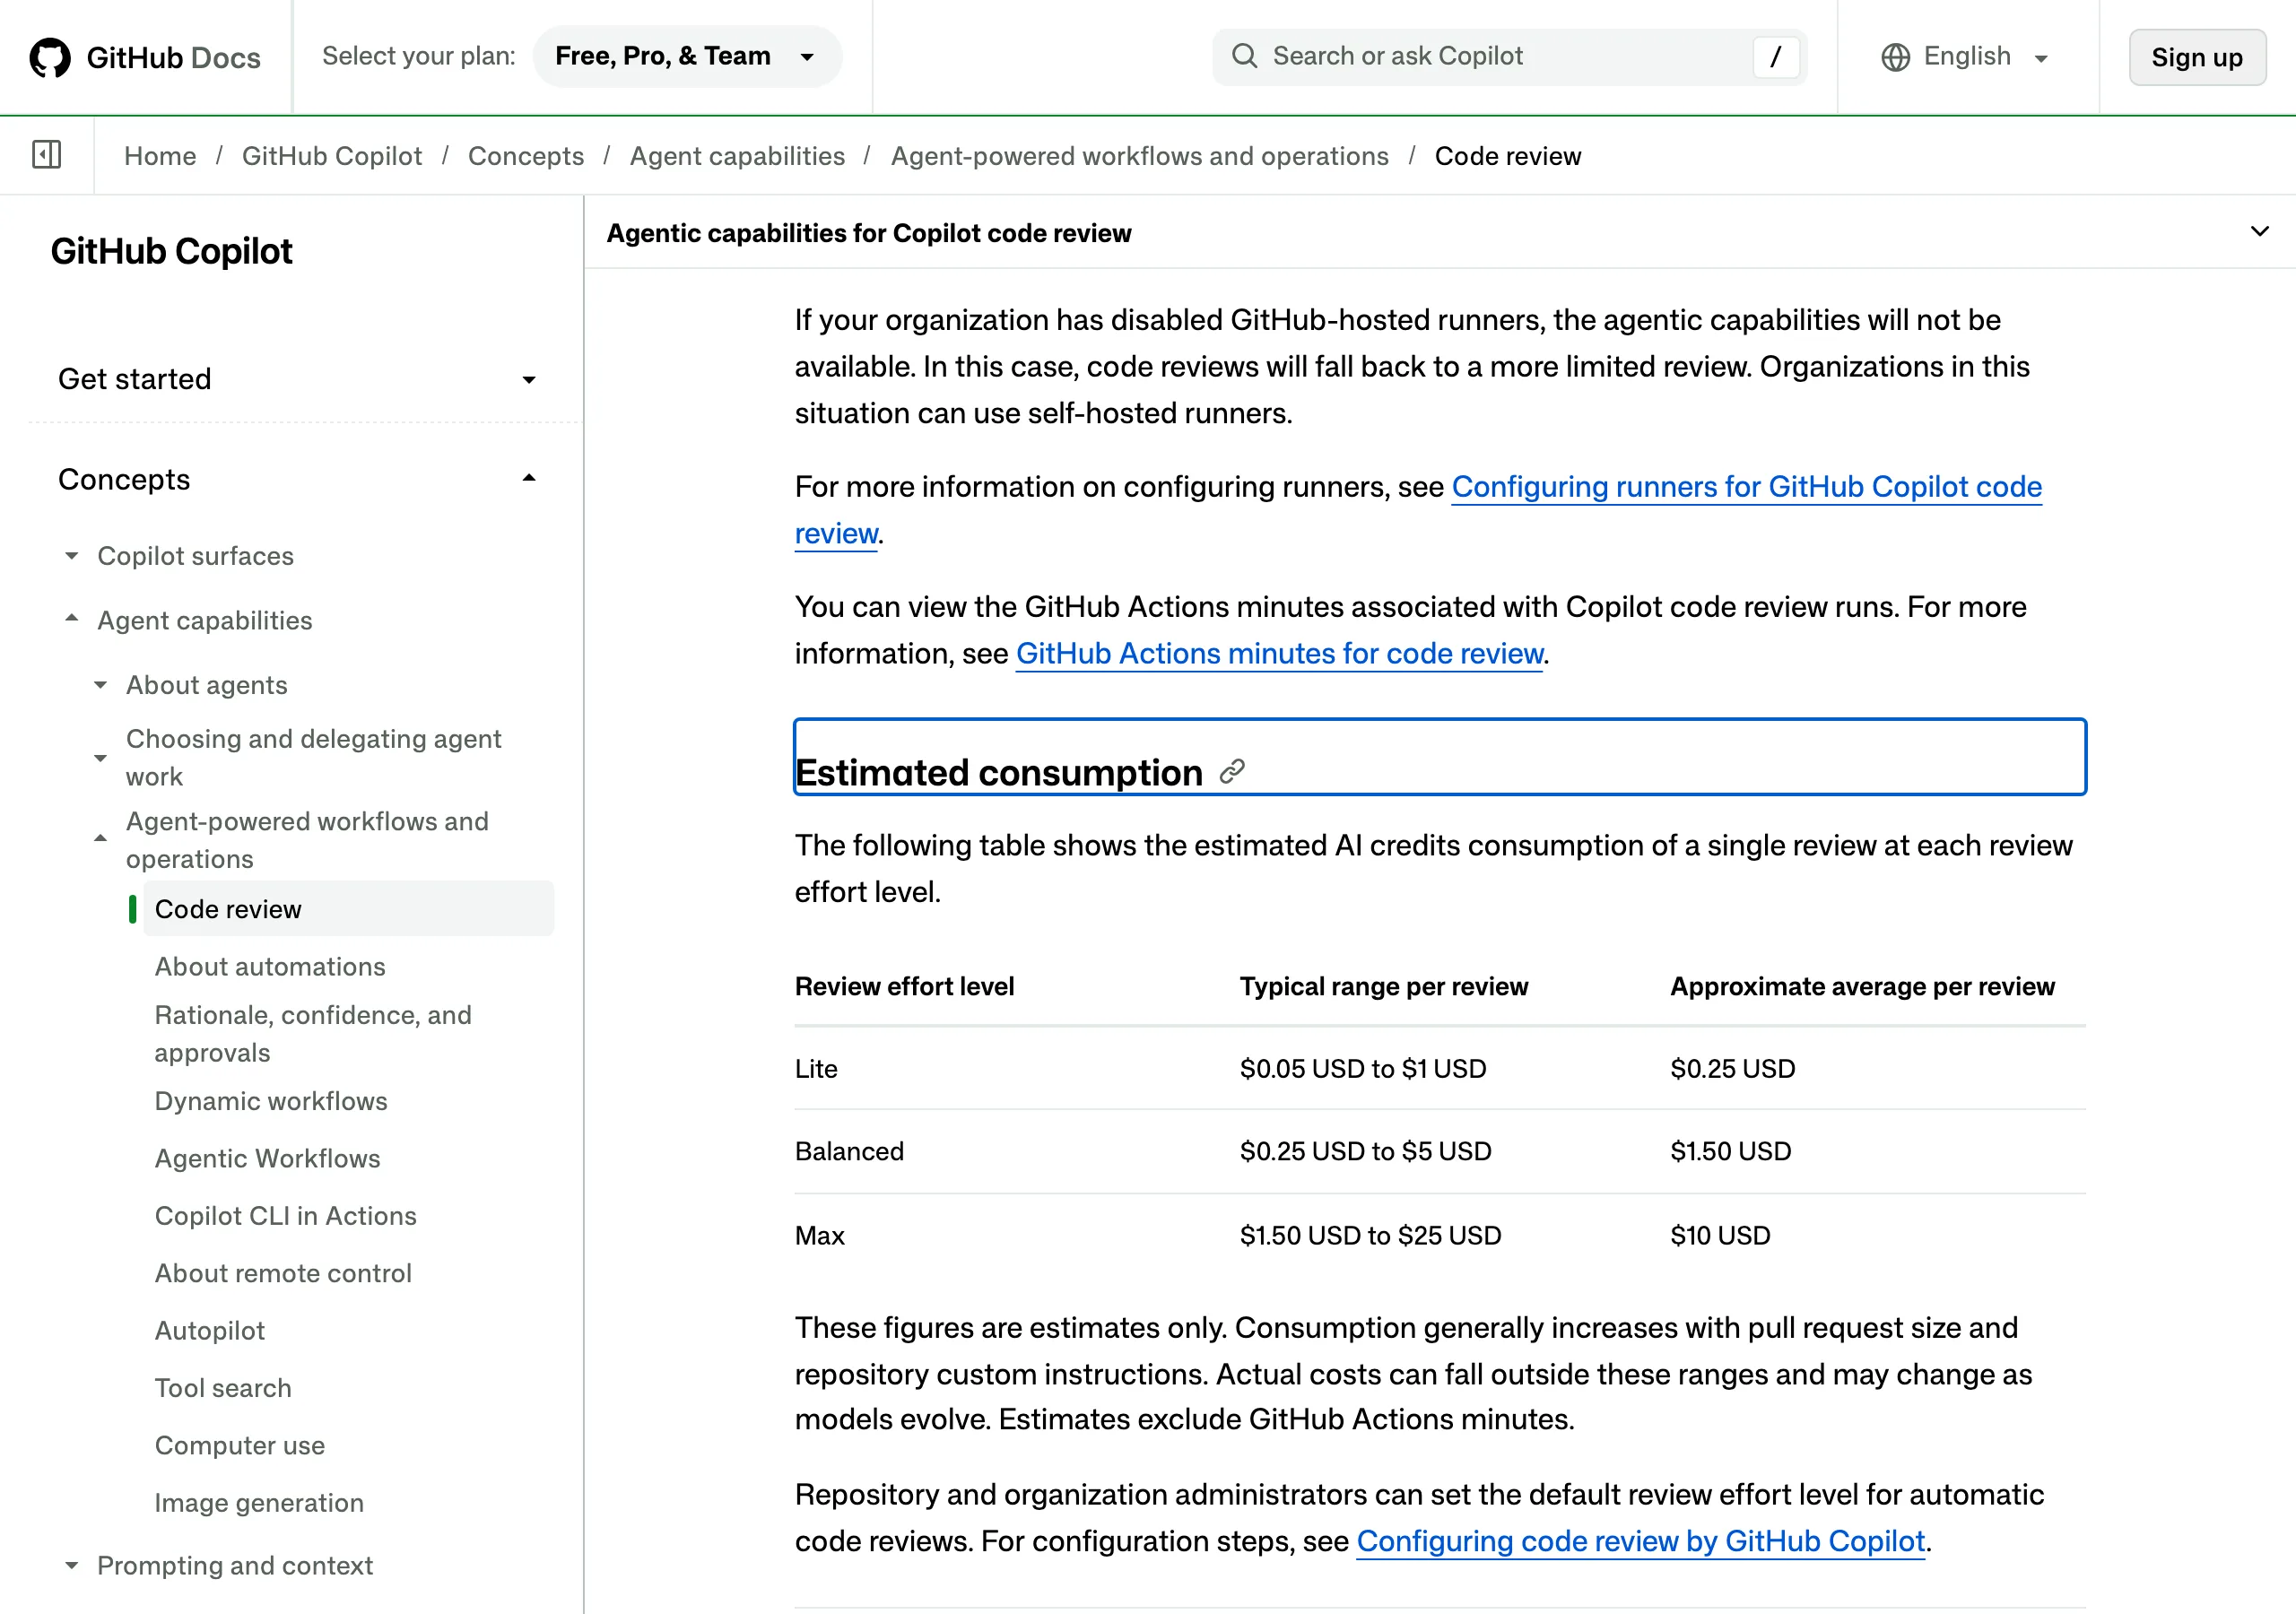
成本這端補上的是能見度。審查代理的工作階段現在會顯示該次審查消耗的 AI credits,單次用量從此有帳可查。量級可以參考官方文件給的估計:Lite 約 0.05 到 1 美元、平均約 0.25 美元;Balanced 約 0.25 到 5 美元、平均約 1.5 美元;Max 約 1.5 到 25 美元、平均約 10 美元。官方同時標明這些只是估計,實際消耗通常隨 PR 大小與自訂指示增加,也不含 GitHub Actions 分鐘數。Balanced 和 Max 本來就吃比較多額度,這次的三模型安排會不會再推高單次成本,公告沒有給新的數字。
額度歸屬是會影響成敗的設定。組織的帳務選項有兩個:Member 是預設值,審查消耗成員自己的 Copilot 額度,額度用完審查直接失敗;Organization 把費用記到組織帳上,前提是組織先啟用 AI credits 付費用量,而且官方特別強調這個選項只改帳務,不會額外授予任何功能存取權,也不分自動或手動請求的審查。企業層還有一個折衷政策,是把帳務決定權交給各組織自己選,但被指定記帳的組織同樣必須先開啟付費用量。同一個儲存庫裡有人審查成功、有人失敗,先查額度歸屬與該成員的餘額,比查規則設定更快定位。歸屬規則在概念文件裡也寫得明白:儲存庫自動請求的審查記在 PR 作者帳上,手動請求的記在請求者帳上;Copilot cloud agent 發的 PR 先找人類共同作者記帳,對方無法計費時改記組織;其他 bot 發的或 bot 請求的審查,直接記組織。
計量軌道可以對照 TechMoon 先前對 GitHub 這套額度體系的整理:共享自動化與 Agentic Workflows 的雙軸計費拆過 AI credits 與 Actions 分鐘怎麼並行,GitHub intelligence 的記憶功能則示範了每次執行都吃額度的另一種形態,Fusion 的逐模型計費更把「用哪個模型」直接變成帳單變數。這次把每次審查的消耗顯示出來,等於把同一本帳往前推到單次審查的顆粒度,也和 Copilot 安全世界掛把瀏覽、修補與解除分開計費的思路對上了。
審查摘要的改版不只因為版面變緊湊。新的摘要把發現集中在上方,強度與問卷移進頁尾;被略過或被內容排除的檔案合併成一個 Files not reviewed 區塊,附上檔名與排除理由的連結;空區塊不顯示,長清單改給溢出計數。對讀者的實際意義在範圍:如果一份修改同時包含應用邏輯與被排除的檔案,Copilot 對前半段的意見,不能自動延伸到後半段。看結論之前先看沒審到什麼,這個區塊比任何效率敘述都值得盯。
同一個 PR 後續再審時,與近期修改無關的舊發現會先收合、再隱藏。頁面乾淨了,但看不見舊問題不代表已經修好,要確認修正狀態還是得回到原始發現對照程式碼。對摘要不滿意可以按倒讚並附原因,例如核准判斷不同意、留言太冗長或發現不正確、太挑剔;官方說這些回饋用來改進 Copilot 的判斷,倒讚本身不會撤銷那份審查。
Balanced 等級的變化是這次唯一觸及審查本身的:三個審查模型各自提出結果,再由另一個模型彙整成一份輸出。官方公告沒有附任何準確率或漏報率的數字,所以模型數量可以當作視角變多的線索,不能直接推論成漏報消失或比人工審查可靠。另外,自動要求審查的儲存庫規則開始支援略過名單,列在名單裡的身分不會再收到自動審查;要用這個豁免機制,先確認免審範圍和原本的管理目的對得上。
可靠度修正有六項,其中三項值得管理者知道。審查失敗或逾時會自動重試一次,偏好模型不可用時可以換用其他符合條件的模型,但重試是延續機制,最終還是要確認有沒有留下真正的審查內容。把程式碼審查關閉再開啟,帳務與預覽設定現在會保留,不會因為切換開關而歸零。在外部授權封鎖開啟的前提下,組織或企業自己擁有的 GitHub Actions、Dependabot 與 app,只要由組織付費,就能再次對 bot 發的 PR 請求審查。其餘三項是體驗修正:審查剛開始不再誤報失敗並丟掉結果,服務更新中的審查拿到更多完成時間,組織退出意見收集後不再出現審查問卷。
有兩件事目前沒有答案。REST 這端:公告說設定管理同時走 REST 與 GraphQL,但截至 11 月 8 日,設定文件的 API 段落唯一連向的參考資料是 GraphQL 文件,REST 的目錄裡也找不到審查設定的端點條目。想先用 REST 的團隊,現在只能對照 GraphQL 的欄位自行摸索,或等官方補上文件。成效那端:Balanced 的三模型安排對審查品質的實際影響,官方沒有提供任何可引用的數字。
要動手的話,順序比範圍重要。先用儲存庫端點對一個專案做完整盤點:讀回生效的強度、可用的強度清單、自訂指示與 MCP 開關,比對組織層的預設與上限,把「實際生效的設定」和「以為生效的設定」對齊。確認無誤再往大批次推進,上層政策另走管理員身分。API 範圍與額度數字都屬於會變動的內容,官方補上 REST 端點文件或調整費用估計時,記得回頭核對手上的設定與數字。